Ce qu'il faut rechercher dans un service managé Postgres : une liste de contrôle pour l'acheteur technique
Le Postgres géré traditionnel excelle dans les charges de travail transactionnelles mais fait des compromis sur les requêtes analytiques, et la plupart des listes de contrôle d'évaluation oublient cet écart. Si vous évaluez Postgres en tant que moteur...
- Un service Postgres géré doit être évalué sur sa résistance aux pannes, sa récupération et sa charge de production, et pas seulement sur les fonctionnalités qu'il affiche.
- Les vérifications clés incluent la haute disponibilité, la reprise après sinistre, la compatibilité PostgreSQL, la sécurité, la mise à l'échelle, le coût total, le contrôle opérationnel et la portabilité.
- Un flux de travail de production doit tester les affirmations du fournisseur avec des tests de basculement, de récupération à un moment précis, de charge et de migration avant d'adopter le service.
- Lakebase Postgres propose un service Postgres géré et sans serveur avec une haute disponibilité automatique, une mise à l'échelle automatique et les fonctionnalités de sécurité et de gouvernance de Databricks.
"Géré" est un label, pas une spécification. Évaluez un service de base de données géré dans le cloud sur ce qu'il démontre en cas de panne et de récupération, plutôt que sur ce que sa page de fonctionnalités liste.
Un service géré Postgres est une base de données PostgreSQL où le fournisseur gère l'infrastructure sous-jacente et automatise l'administration de la base de données, telle que l'application de correctifs, les sauvegardes, le basculement et la mise à l'échelle. La part réellement gérée par le fournisseur varie selon les services, ce qui fait de "géré" un label plutôt qu'une spécification complète. Les principaux fournisseurs cloud, notamment AWS, Microsoft Azure et Google Cloud, proposent des services PostgreSQL gérés, tout comme les fournisseurs spécialisés dans les bases de données.
Un fournisseur peut vanter une haute disponibilité, des sauvegardes automatisées ou une sécurité d'entreprise, mais ces promesses n'indiquent pas aux ingénieurs de plateforme ou aux administrateurs de base de données ce qui se passe lorsqu'une instance principale tombe en panne, avec quelle rapidité une base de données peut être restaurée, ou si une extension PostgreSQL requise est prise en charge. Lorsqu'un problème survient en production, ce qui compte, c'est la rapidité avec laquelle l'équipe peut le détecter et le résoudre.
Ingénieurs de plateforme, administrateurs de base de données, architectes de données et responsables techniques évaluant un service géré Postgres pour la production. Il couvre les domaines qui posent généralement des problèmes après la migration, tels que le contrôle opérationnel, la haute disponibilité, la reprise après sinistre, la mise à l'échelle, etc. Chaque section examine ce que le fournisseur doit prendre en charge, les questions à poser lors d'une évaluation et la manière de tester les réponses dans le cadre d'un projet pilote. Si vous êtes administrateur de base de données ou ingénieur de plateforme et que vous prévoyez une migration, utilisez cet article comme une liste de contrôle de travail plutôt que comme une lecture unique.
Aperçu de la liste de contrôle pour les services gérés Postgres
L'évaluation d'un service Postgres géré doit aller au-delà du provisionnement de la base de données et de l'administration quotidienne. Le tableau ci-dessous offre aux équipes un point de départ pour identifier les fonctionnalités à vérifier et les réponses qui doivent déclencher un examen plus approfondi.
| Domaine | Éléments à vérifier | Point de vigilance |
|---|---|---|
| Périmètre opérationnel | Qui gère les correctifs, les mises à niveau et le réglage, et quels contrôles de base de données restent disponibles | "Géré" couvre uniquement la machine virtuelle et le système d'exploitation |
| Haute disponibilité | Basculement automatique, garanties sur les transactions validées et fonctionnement du basculement entre les zones de disponibilité | Aucun objectif de point de récupération (RPO) déclaré ou promotion manuelle |
| Sauvegardes et reprise après sinistre | Restauration à un moment précis (PITR), options de restauration, conservation, récupération inter-région et objectifs de récupération | La reprise après sinistre est uniquement disponible sur demande de support, sans RPO ni objectif de temps de récupération (RTO) déclaré |
| Mise à l'échelle et performances | Comportement lors du redimensionnement, réplicas en lecture, mise en commun des connexions, stockage et modèle d'opérations d'entrée/sortie par seconde (IOPS) | La mise à l'échelle verticale nécessite une indisponibilité prolongée |
| Sécurité et conformité | Connectivité privée, contrôles des accès et des identités, clés gérées par le client, journaux d'audit et périmètre de conformité | Une connectivité publique est requise ou les clés de chiffrement ne peuvent être contrôlées que par le fournisseur |
| Compatibilité et extensions | Versions de PostgreSQL prises en charge, extensions, pilotes, paramètres et restrictions de superutilisateur | Une extension critique ou une fonctionnalité PostgreSQL requise n'est pas prise en charge |
| Migration | Chemins de migration pris en charge, réplication logique et options de capture de données modifiées (CDC) | Les grandes bases de données ne peuvent être migrées que par le biais d'un vidage et d'une restauration |
| Tarification et coût total | Calcul, stockage, IOPS, sauvegardes, réplicas, trafic réseau sortant et coûts de support étendu | Seul le prix du calcul est clair |
| Opérations | Métriques de base de données, journaux, alertes et accès au support de niveau PostgreSQL | Observabilité limitée de la base de données ou absence d'escalade vers les experts PostgreSQL |
| Portabilité et sortie | Exportations standard et réplication logique vers un autre environnement PostgreSQL | Les données ne peuvent sortir que via un format propriétaire ou une demande de support |
1. Périmètre opérationnel et contrôle
La première chose à vérifier est l'endroit où s'arrête la responsabilité du fournisseur et où commence celle de l'équipe de base de données. Un service géré doit prendre en charge l'infrastructure et les opérations de routine de la base de données sans supprimer les contrôles PostgreSQL dont dépend une charge de travail de production. Les fournisseurs qui qualifient un service de entièrement géré n'entendent pas toujours la même chose par cette expression.
Commencez par la maintenance. Demandez si les mises à jour des versions mineures sont automatiques, si les équipes peuvent choisir une fenêtre de maintenance, le délai de prévenance accordé par les fournisseurs avant les changements, et si les mises à jour nécessitent un redémarrage ou un basculement. Les mises à niveau des versions majeures méritent une attention particulière. PostgreSQL prend en charge chaque version majeure pendant cinq ans ; les équipes doivent donc comprendre pendant combien de temps le fournisseur prend en charge chaque version et ce qui se passe lorsque ce support prend fin. Demandez la date de fin de vie utilisée par le fournisseur pour chaque version. En règle générale, moins le fournisseur accorde de préavis avant de mettre à jour une base de données, plus il est difficile de s'organiser.
L'accès à la configuration est une autre source fréquente de surprises. Les services gérés restreignent souvent l'accès superutilisateur et limitent les paramètres ou les commandes susceptibles d'affecter l'infrastructure sous-jacente. Avant de migrer, vérifiez quels rôles sont disponibles, quels paramètres peuvent être modifiés, si ALTER SYSTEM est pris en charge, et quelles commandes PostgreSQL sont restreintes. Par exemple, certains services vous permettent de modifier un ensemble de paramètres via une console ou une API, mais bloquent complètement la commande ALTER SYSTEM.
- Demandez comment fonctionnent les mises à niveau des versions mineures et majeures, y compris les fenêtres de maintenance, les notifications et les politiques de fin de support.
- Demandez quels rôles, paramètres et commandes PostgreSQL sont restreints.
- Démontrez-le en appliquant une mise à jour mineure dans le cadre du projet pilote et en mesurant son effet sur les connexions actives et le trafic de l'application.
- Un point de vigilance est un service qui se qualifie de entièrement géré tout en laissant la gestion des correctifs, des mises à niveau ou des tâches de maintenance critiques à l'équipe de base de données, ou un service qui ne peut pas documenter clairement ses limites de configuration et de mise à niveau.
2. Haute disponibilité et basculement automatique
Le basculement automatique dans les bases de données Postgres signifie que le service peut promouvoir automatiquement une instance de secours dans une autre zone de disponibilité et indiquer clairement ce qu'il advient des transactions validées lors du basculement. La haute disponibilité protège contre les pannes au sein d'une région, mais ce n'est pas la même chose que la reprise après sinistre.
Demandez si l'instance de secours utilise une réplication synchrone ou asynchrone, quel point de récupération le fournisseur prend en charge et si l'adresse de la base de données reste la même après la promotion. Les applications devront généralement se reconnecter après la chute des connexions existantes ; le fournisseur doit donc documenter le comportement attendu. Dans un cluster à plusieurs nœuds, confirmez quels nœuds peuvent être promus et comment les applications trouvent la nouvelle instance principale. Assurez-vous que vos pools de connexions et vos pilotes, qu'ils soient en Java, Python ou dans un autre langage, gèrent proprement les reconnexions.
- Demandez si la haute disponibilité utilise la réplication synchrone et si l'instance de secours s'exécute dans une zone de disponibilité distincte.
- Demandez combien de temps prend généralement le basculement et si les transactions validées sont préservées.
- Démontrez-le en déclenchant un basculement, en chronométrant la récupération et en vérifiant les erreurs de l'application, les écritures validées et le comportement de réplication.
- Un point de vigilance est une promotion manuelle ou l'absence de garantie claire concernant les transactions validées.
3. Sauvegardes, restauration à un moment précis et reprise après sinistre
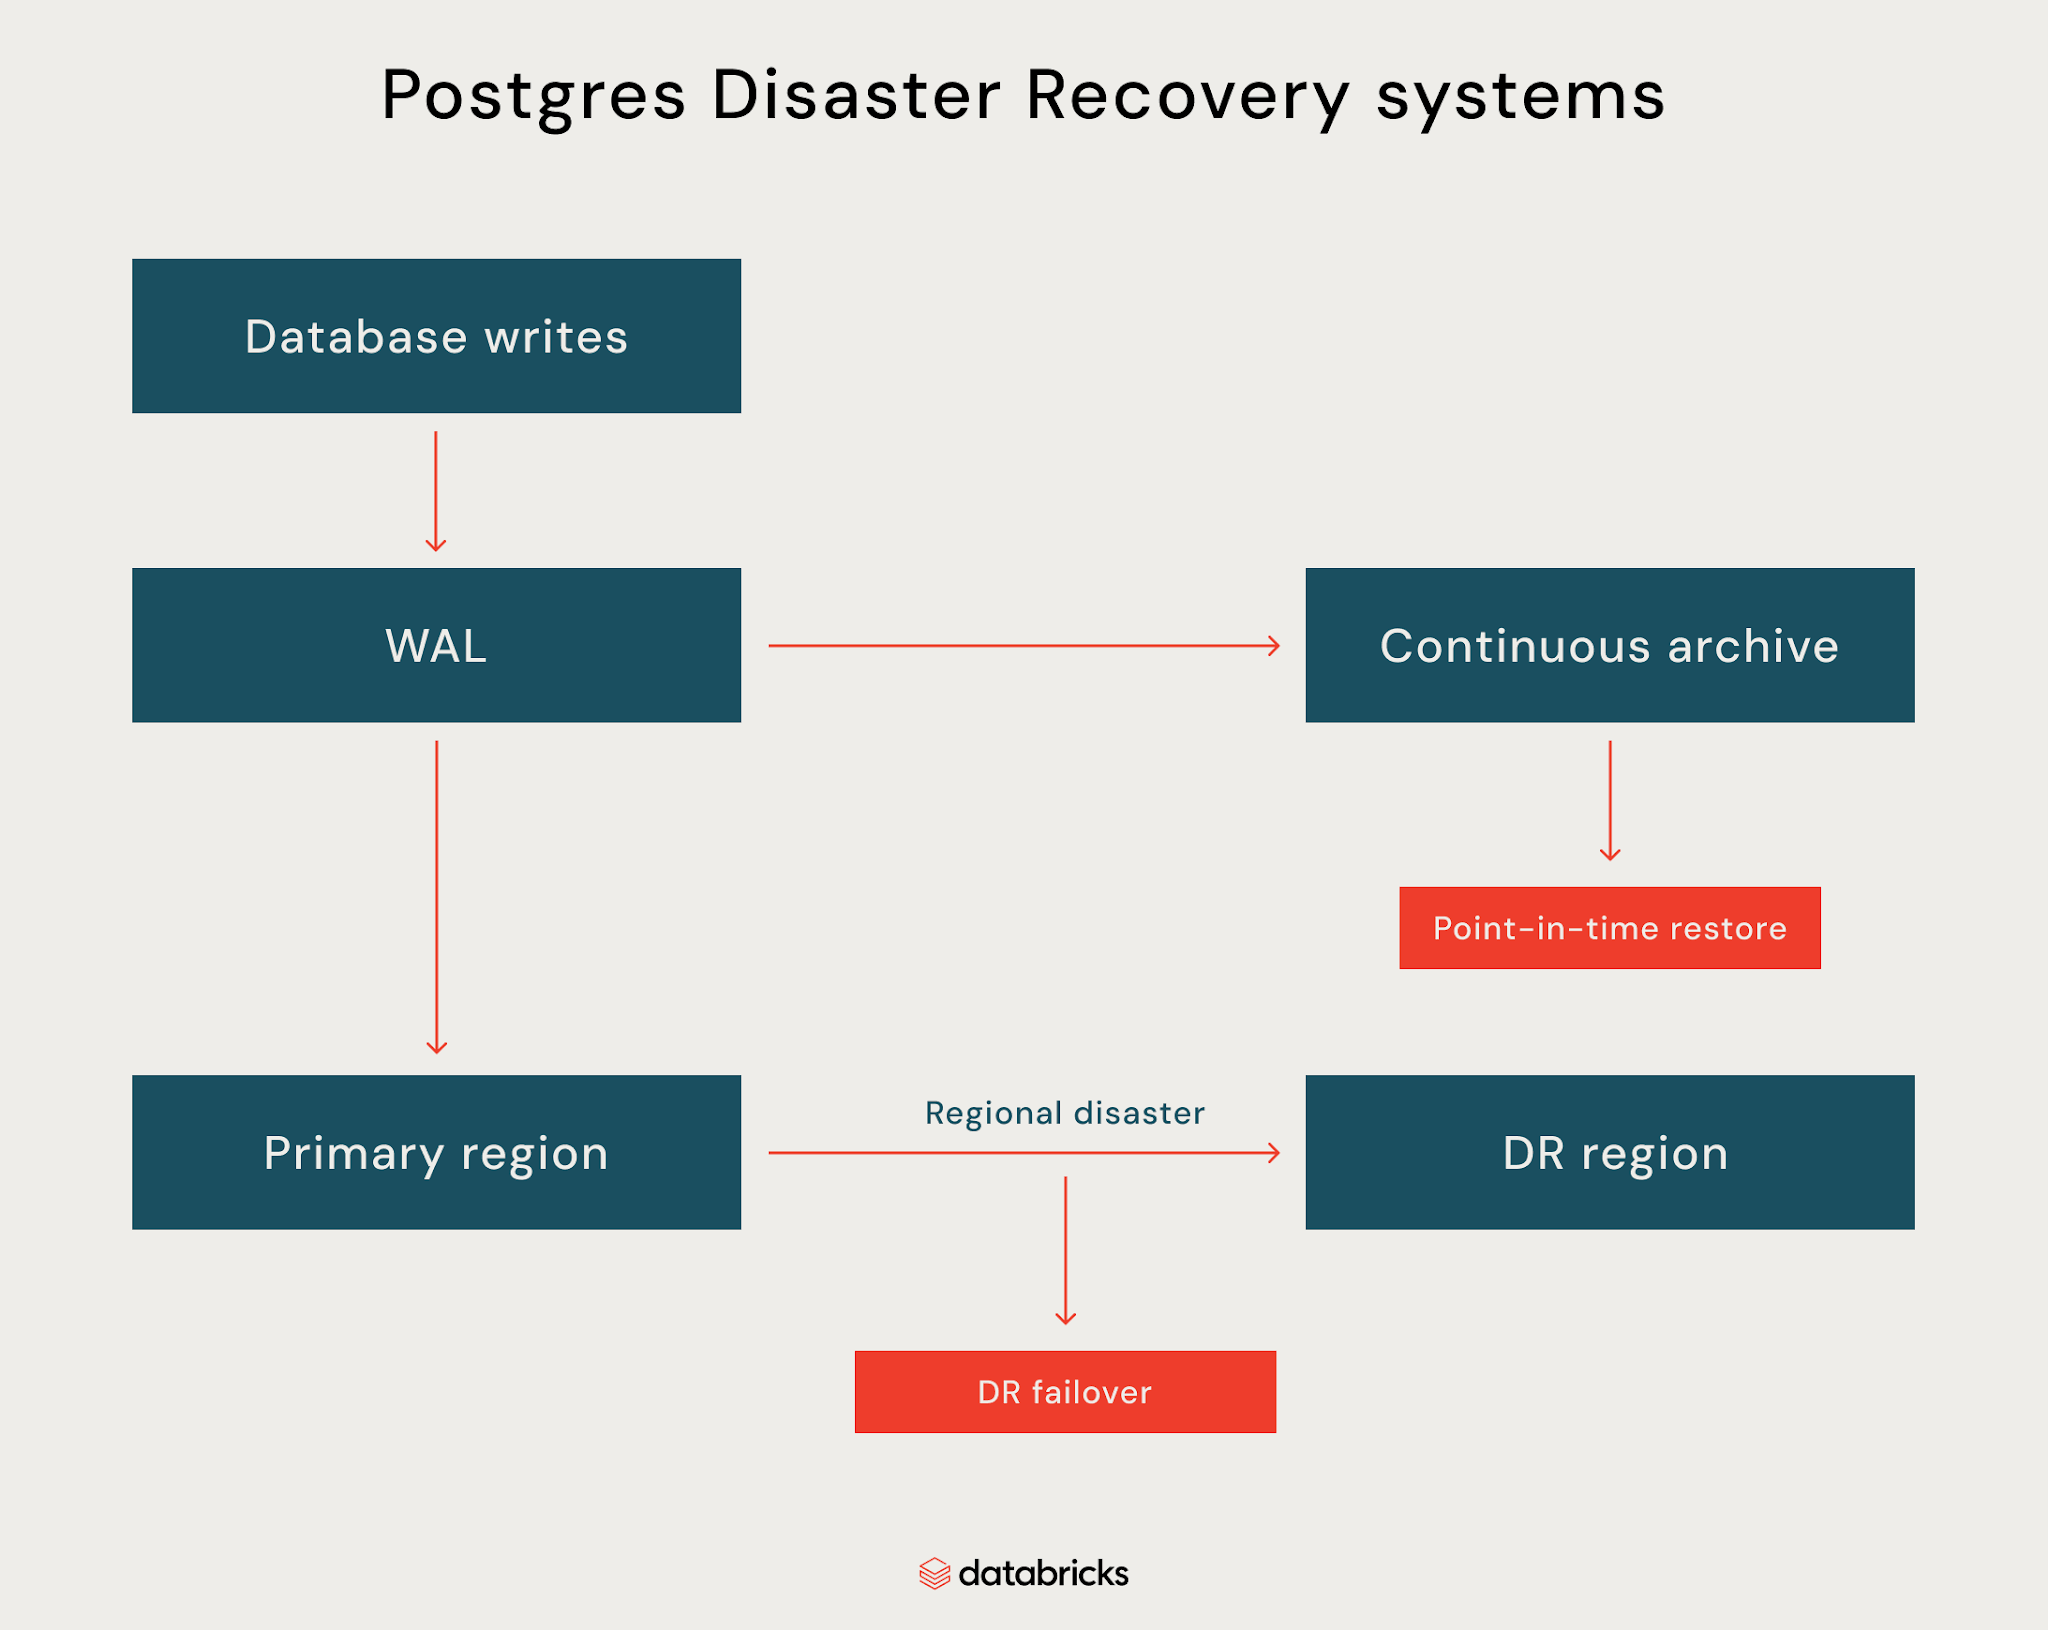
Les sauvegardes et la reprise après sinistre (DR) sont importantes pour les bases de données. Vérifiez que les sauvegardes peuvent restaurer la base de données à un moment précis connu et que le fournisseur énonce clairement ses objectifs de récupération. Le RPO définit le volume de données qu'une charge de travail peut se permettre de perdre. Le RTO définit la durée pendant laquelle la base de données peut rester indisponible.
Demandez si le service archive en continu le journal des transactions (WAL), pendant combien longtemps la restauration à un moment précis reste disponible et si les restaurations sont en libre-service. Pour la reprise après sinistre, vérifiez si la réplication inter-région est continue ou périodique, si le basculement est automatique ou manuel, et si le fournisseur publie des objectifs de RPO et de RTO. Des sauvegardes automatisées combinées à l'archivage continu du journal WAL permettent d'effectuer une restauration à un moment précis et de récupérer les données en toute fiabilité.
- Demandez si vous pouvez restaurer la base de données à un horodatage spécifique et combien de temps prend généralement le processus.
- Validez les enregistrements critiques et les lectures d'applications après la restauration.
- Exécutez un exercice de reprise après sinistre si le fournisseur en prend un en charge et documentez les étapes de récupération.
- Un signal d'alerte correspond à une reprise après sinistre uniquement disponible via une demande de support ou dépourvue de RPO ou RTO publiés.
4. Mise à l'échelle et performances
Vérifiez comment le service gère la croissance du calcul, du stockage, des connexions et du trafic de lecture. La mise à l'échelle ne doit pas introduire de temps d'arrêt imprévu ni vous obliger à gérer l'infrastructure manuellement.
Demandez si le calcul peut être mis à l'échelle verticalement, si des réplicas de lecture sont disponibles, comment le stockage et les opérations d'entrée/sortie par seconde (IOPS) évoluent, et si le regroupement de connexions est intégré. Pour les services dotés de la mise à l'échelle automatique, vérifiez ce qui déclenche la mise à l'échelle, la rapidité des changements de capacité et si la mise à l'échelle affecte les connexions ou les transactions actives. Sur la plupart des services managés, la mise à l'échelle du processeur et de la RAM nécessite généralement quelques clics ou un seul appel API, ce qui permet aux équipes d'adapter la capacité à la croissance des utilisateurs plutôt que de lancer une nouvelle infrastructure.
- Demandez si la mise à l'échelle verticale nécessite un redémarrage ou un basculement.
- Demandez comment le stockage augmente et s'il existe des limites sur les connexions, les IOPS ou les réplicas.
- Prouvez-le en exécutant une charge de production représentative et en testant une mise à l'échelle pendant le trafic actif.
- Mesurez la latence des requêtes, les erreurs de connexion et le comportement de l'application avant et après la mise à l'échelle.
- Un signal d'alerte est une mise à l'échelle qui nécessite un temps d'arrêt prolongé ou qui présente des limites de capacité non documentées.
5. Sécurité, conformité et contrôle d'accès
Validez la manière dont le service protège les données en transit et au repos, contrôle l'accès aux bases de données et se connecte au réseau. Les fonctionnalités de sécurité doivent correspondre aux exigences existantes de l'organisation en matière d'identité et de conformité plutôt que de nécessiter un modèle d'exploitation distinct.
Demandez si la connectivité privée est prise en charge, comment Identity and Access Management (IAM) s'intègre aux rôles de base de données et si des clés gérées par le client (CMK) sont disponibles. Vérifiez également la journalisation des audits, les contrôles de chiffrement et le périmètre de conformité du fournisseur. Demandez si les applications peuvent se connecter via une adresse IP privée, publique ou les deux. La plupart des fournisseurs managés appliquent automatiquement le chiffrement au repos et en transit et déploient régulièrement des correctifs de système d'exploitation et des mises à jour de sécurité ; confirmez donc les cadres de conformité pris en charge par le service, tels que HIPAA ou GDPR.
- Demandez si les bases de données peuvent s'exécuter sans accès à Internet public.
- Demandez comment l'activité de la base de données, les actions administratives et les événements d'authentification sont enregistrés.
- Vérifiez que les clés de chiffrement peuvent être pivotées ou révoquées sans perturber la base de données.
- Prouvez-le en vous connectant via le chemin de réseau privé prévu et en testant l'accès avec différents rôles.
- Un signal d'alerte est un service qui nécessite une connectivité publique, offre une visibilité d'audit limitée ou ne prend pas en charge les contrôles de sécurité requis par l'organisation.
6. Compatibilité et extensions Postgres
Vous devez vérifier que le service prend en charge les versions, extensions, pilotes et options de configuration PostgreSQL sur lesquels la charge de travail s'appuie. La compatibilité doit être testée sur l'application réelle plutôt que déduite de la revendication du fournisseur selon laquelle il prend en charge PostgreSQL.
Vérifiez quelles versions de PostgreSQL sont disponibles, la rapidité de prise en charge des nouvelles versions majeures et les extensions activées. Vérifiez la prise en charge des extensions telles que pgvector, PostGIS et toutes les dépendances spécifiques à l'application. Confirmez également les paramètres, rôles et commandes PostgreSQL restreints. Vérifiez si les restrictions de superutilisateur affectent les tables, fonctions ou extensions existantes, et si les objets présents dans votre base de données actuelle devraient être modifiés. Les équipes autogérées exécutent souvent PostgreSQL sur Ubuntu ou une autre distribution Linux avec un accès complet au système d'exploitation ; les dépendances liées au système d'exploitation doivent donc être identifiées rapidement.
- Demandez la liste complète des extensions prises en charge et les limitations spécifiques aux versions.
- Demandez si les pilotes d'application, les ORM et les outils PostgreSQL standard fonctionnent sans modification.
- Testez toutes les extensions requises et les paramètres de base de données avant la migration.
- Prouvez-le en restaurant un schéma représentatif et en exécutant les migrations et les tests d'intégration de l'application.
- Un signal d'alerte est une extension critique non prise en charge ou une compatibilité dépendant de solutions de contournement non documentées.
Pour les charges de travail d'IA, la prise en charge de pgvector est importante pour la recherche vectorielle en plus des charges de travail transactionnelles.
Le guide pratique de l'IA agentique pour l'entreprise

7. Chemins de migration depuis Postgres et d'autres bases de données
Vérifiez comment le fournisseur prend en charge à la fois la migration initiale des données et la transition finale. Une méthode de migration qui fonctionne pour une petite base de données peut s'avérer peu pratique pour un système de production qui doit continuer à servir du trafic pendant le déplacement.
Demandez si le service prend en charge la réplication logique, Change Data Capture (CDC), les outils PostgreSQL natifs et les services de migration tiers. Pour les migrations à partir d'autres moteurs de base de données, vérifiez quels systèmes sources sont pris en charge et comment la conversion de schéma, la validation des données et les modifications d'application sont gérées. Le déplacement d'une base de données de production à partir d'autres bases de données telles qu'Oracle ou SQL Server nécessite également une conversion de schéma et des tests d'application.
- Demandez si de grandes bases de données peuvent être migrées sans temps d'arrêt prolongé.
- Demandez comment les modifications en cours sont répliquées pendant la fenêtre de migration.
- Prouvez-le en migrant un ensemble de données représentatif, en exécutant des contrôles de validation et en mesurant le temps de basculement final.
- Un signal d'alerte est un processus de migration qui dépend entièrement d'une opération de vidage et de restauration ou qui nécessite un temps d'arrêt prolongé de l'application.
Votre solution de migration doit prendre en compte les dépendances dans l'ensemble de votre environnement de données et minimiser les perturbations.
8. Tarification et coût total de possession
Un service managé peut engendrer des coûts supplémentaires pour le stockage, les sauvegardes, la haute disponibilité, les réplicas, le transfert réseau et d'autres ressources basées sur l'utilisation. Une grande partie des économies réalisées par rapport aux déploiements autogérés provient de l'élimination du matériel sur site et de la maintenance ; déterminez donc quelles fonctionnalités sont incluses dans le prix de base et lesquelles constituent des options payantes.
Vérifiez comment le calcul, le stockage, les IOPS, les sauvegardes, les réplicas et le trafic réseau sortant sont facturés. Vérifiez si la tarification change avec la mise à l'échelle automatique, la capacité de secours ou des configurations de haute disponibilité accrues.
- Modélisez l'utilisation normale et de pointe, y compris la croissance du stockage et la rétention des sauvegardes.
- Calculez le coût total de possession (TCO) sur la période de contrat prévue.
- Prouvez-le en créant un modèle de TCO sur 12 mois couvrant le calcul, la capacité de secours en haute disponibilité, les IOPS, les sauvegardes, les réplicas et le trafic réseau sortant pour votre charge de travail prévue. Ne vous basez pas uniquement sur la ligne de calcul.
- Un signal d'alerte est une tarification qui n'affiche que le calcul de la base de données tout en laissant de côté les coûts de stockage, de sauvegardes, de réplicas ou de réseau.
La tarification basée sur l'utilisation peut faciliter l'alignement des coûts sur la demande de la charge de travail, mais les équipes doivent tout de même modéliser des schémas de trafic réalistes avant de s'engager.
9. Opérations, surveillance et dépannage
Un service de production nécessite une visibilité suffisante pour permettre aux équipes de base de données de comprendre ce qui se passe lorsque les performances ou la fiabilité se dégradent. Les métriques d'infrastructure seules suffisent rarement à diagnostiquer les problèmes PostgreSQL.
Demandez si le service expose des métriques de base de données, des journaux et des informations au niveau des requêtes, et si les équipes peuvent configurer des alertes pour les conditions importantes. Découvrez quel accès possèdent les ingénieurs du support en cas d'incident et si des spécialistes PostgreSQL sont disponibles pour les escalades. Recherchez des tableaux de bord offrant une visibilité en temps réel sur les métriques système, et vérifiez si les journaux peuvent être filtrés par base de données ou par utilisateur, et si vous pouvez trier les événements par heure ou par gravité. Considérez également si votre équipe possède les compétences nécessaires pour résoudre les problèmes PostgreSQL en utilisant uniquement les outils du fournisseur.
- Demandez quelles métriques, journaux et statistiques de requêtes PostgreSQL sont disponibles.
- Demandez si les données de surveillance peuvent être exportées vers la plateforme d'observabilité existante de l'organisation.
- Prouvez-le en générant un problème de performance contrôlé et en utilisant les outils disponibles pour identifier la cause racine.
- Un signal d'alarme est une visibilité limitée au niveau de la base de données ou un modèle de support qui ne peut pas enquêter sur les problèmes spécifiques à PostgreSQL.
Pour les grands déploiements, demandez si les outils du fournisseur peuvent faire surface des modèles sur toutes vos bases de données, et pas seulement des métriques par instance.
10. Portabilité et sortie
Un service Postgres géré doit permettre de déplacer des données et des applications vers un autre environnement PostgreSQL sans dépendre de processus d'exportation propriétaires.
Demandez si les outils PostgreSQL standard et la réplication logique peuvent être utilisés pour extraire des données. Découvrez si des extensions, des API ou des formats de stockage spécifiques au fournisseur rendraient une sortie plus difficile. Plus une application dépend de fonctionnalités uniques spécifiques au fournisseur, plus la sortie devient difficile.
- Demandez comment fonctionne une exportation complète de base de données et si elle peut s'exécuter sans le support du fournisseur.
- Demandez si la réplication logique peut diffuser des données vers un autre environnement PostgreSQL.
- Prouvez-le en restaurant une exportation dans un environnement PostgreSQL séparé et en exécutant des tests d'application.
- Un signal d'alarme est constitué de données qui ne peuvent être exportées que par le biais d'une demande de support ou d'un format propriétaire.
Comment exécuter un projet pilote avant de vous engager
Un projet pilote doit tester les affirmations du fournisseur par rapport à une charge de travail qui ressemble à la production. Une liste de contrôle des fonctionnalités peut montrer ce qu'un service offre, mais des tests de défaillance et de récupération contrôlés montrent si ces capacités fonctionnent quand elles comptent.
Commencez par une base de données représentative, le trafic des applications et les extensions PostgreSQL requises par le système de production. Testez ensuite les domaines les plus susceptibles d'influencer la décision. Si vous préférez une approche par phases, commencez par une charge de travail non critique et étendez le projet pilote petit à petit.
- Exécutez un basculement et mesurez le temps de récupération, la récupération de connexion et les transactions perdues.
- Restaurez la base de données à un moment précis dans le temps et comparez le résultat avec le RPO et le RTO attendus.
- Appliquez une charge de pointe représentative et testez la mise à l'échelle pendant que l'application reste active.
- Exécutez des tests de migration et de restauration, y compris toutes les extensions requises et les modifications d'application.
- Testez la surveillance et l'escalade du support.

Enregistrez les résultats par rapport aux exigences initiales et traitez les tests échoués comme des points de décision. La bifurcation de base de données peut également aider les équipes à créer des environnements isolés pour les tests de migration et d'application. Capturez les résultats sous une forme cohérente afin que la discussion post-pilote entre les équipes d'ingénierie, de sécurité et de finance reste objective.
Comment Lakebase s'associe à cette liste de contrôle
Lakebase s'associe bien à plusieurs des domaines couverts par cette liste de contrôle. Le tableau ci-dessous montre où ses capacités s'alignent sur les exigences de production courantes, ainsi que les domaines qui nécessitent encore une évaluation plus approfondie.
| Domaine de la liste de contrôle | Comment Lakebase s'associe |
|---|---|
| Opérations | Postgres géré et sans serveur avec des opérations d'infrastructure automatisées. |
| Haute disponibilité | Promotion automatique entre les zones de disponibilité tout en préservant les transactions validées. Les connexions existantes doivent se reconnecter après le basculement. |
| Mise à l'échelle | Mise à l'échelle automatique avec le calcul séparé du stockage, permettant d'ajuster la capacité en fonction de la demande de la charge de travail. |
| Sécurité | Prend en charge la mise en réseau privée et les clés gérées par le client, ainsi que les capacités de gouvernance Databricks. |
| Compatibilité PostgreSQL | Prend en charge les outils et extensions PostgreSQL, y compris pgvector. |
| Reprise après sinistre | La reprise après sinistre inter-région est actuellement en version préliminaire privée sur AWS avec basculement manuel. Si la reprise après sinistre régionale est une exigence stricte, contactez votre équipe de compte pour plus d'informations. |
| Coût | La tarification basée sur l'utilisation peut aligner les coûts sur la demande de la charge de travail, mais les équipes doivent modéliser leur charge de travail et leurs modèles d'utilisation prévus. |
| Portabilité | La compatibilité PostgreSQL standard fournit une base pour les tests de migration et de sortie, mais les dépendances spécifiques au fournisseur doivent toujours être évaluées. |
La liste de contrôle offre aux équipes un moyen cohérent de comparer Lakebase, d'autres services Postgres gérés et des déploiements autogérés par rapport à leurs exigences de production.
Pour les équipes évaluant Postgres géré, la question importante est de savoir quelle part du travail opérationnel leur est réellement retirée. Lakebase gère la majeure partie de ce travail au sein d'une région, tandis que la reprise après sinistre inter-région reste un domaine où les équipes ont encore des responsabilités.
Lakebase Postgres promeut automatiquement le calcul secondaire dans toutes les zones de disponibilité tout en préservant les transactions validées et en maintenant la chaîne de connexion inchangée. Les connexions existantes doivent toujours se reconnecter.

Lakebase documente la reprise après sinistre inter-région en tant que version préliminaire privée sur AWS avec basculement manuel, ce qui doit être pris en compte lorsque la récupération régionale est une exigence de production.
Lakebase sépare également le calcul du stockage et prend en charge la mise à l'échelle automatique, permettant d'ajuster la capacité en fonction de la demande de la charge de travail plutôt que de dépendre uniquement d'un dimensionnement fixe de la base de données.
Pour les équipes utilisant Databricks, la mise en réseau privée et les clés gérées par le client offrent des contrôles supplémentaires pour sécuriser les déploiements Lakebase.
Foire aux questions
Que dois-je rechercher dans un service Postgres géré ?
Concentrez-vous sur les fonctionnalités qui affectent la fiabilité et les opérations de production. La haute disponibilité, les sauvegardes, la récupération à un moment précis, la reprise après sinistre, la mise à l'échelle, la sécurité, la compatibilité PostgreSQL, la migration, le coût et la portabilité doivent tous avoir des réponses claires. Les fournisseurs doivent également être en mesure de démontrer des revendications importantes grâce à la documentation et à un projet pilote semblable à la production. Chaque sujet de cette liste de contrôle doit avoir une réponse documentée avant de vous engager.
Quels sont les avantages d'un service Postgres géré ?
Un service géré peut réduire le travail opérationnel lié à l'exécution de PostgreSQL en prenant la responsabilité de l'infrastructure, de la maintenance, des sauvegardes et d'autres tâches de routine. Il peut également fournir des fonctionnalités intégrées pour la disponibilité, la mise à l'échelle, la sécurité et la surveillance. La valeur dépend de la part de responsabilité opérationnelle que le fournisseur assume réellement et de savoir si le service fournit toujours les contrôles requis par la charge de travail.
Quelle est la différence entre Postgres géré et Postgres autogéré ?
Postgres géré transfère une grande partie du travail d'infrastructure et d'administration de base de données au fournisseur. Postgres autogéré donne aux équipes d'ingénierie un plus grand contrôle sur l'infrastructure, la configuration, les extensions et les mises à niveau, mais les rend également responsables de l'exploitation de ces composants. Le bon choix dépend de la capacité opérationnelle de l'organisation, des exigences de contrôle et de la charge de travail.
Comment tester un service Postgres géré avant la migration ?
Utilisez une charge de travail représentative et testez les fonctionnalités qui comptent le plus pour la production. Exécutez des tests de basculement, de récupération à un moment précis, de mise à l'échelle, de migration et de restauration. Mesurez les temps de récupération, le comportement des connexions, l'intégrité des données et les performances des applications. Le projet pilote doit également couvrir la surveillance, l'escalade du support et l'exportation de données. Toute fonctionnalité qui ne peut pas être démontrée doit rester un risque ouvert.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.