Annuncio della disponibilità generale del calcolo serverless per notebook, flussi di lavoro e Spark Declarative Pipelines
Un compute veloce e senza pensieri per eseguire notebook, processi e pipeline è ora generalmente disponibile su Azure e AWS
di Bilal Aslam e Lucian Popa
Siamo felici di annunciare la disponibilità generale (GA) del compute serverless per notebook, job e Spark Declarative Pipelines (SDP) su AWS e Azure. I clienti di Databricks apprezzano già un compute serverless veloce, semplice e affidabile per Databricks SQL e Databricks Model Serving. La stessa funzionalità è ora disponibile per tutti i carichi di lavoro ETL sulla Data + AI Platform, inclusi Apache Spark e Spark Declarative Pipelines. Tu scrivi il codice e Databricks offre un avvio rapido dei carichi di lavoro, il ridimensionamento automatico dell'infrastruttura e aggiornamenti di versione fluidi del Databricks Runtime. Aspetto importante, con il compute serverless paghi solo per il lavoro effettivo svolto invece del tempo impiegato per acquisire e inizializzare le istanze dai provider cloud.

La nostra attuale offerta di compute serverless è ottimizzata per avvio rapido, scalabilità e prestazioni. Gli utenti potranno presto esprimere altri obiettivi come costi inferiori. Offriamo attualmente uno sconto promozionale di lancio sul compute serverless, disponibile da ora fino al 31 gennaio 2025. Ottieni una riduzione del prezzo del 50% sul compute serverless per Workflows e SDP e una riduzione del prezzo del 30% per Notebooks.
"L'avvio dei cluster è una priorità per noi e i Notebooks e i Workflows serverless hanno fatto una grande differenza. Il compute serverless per i notebook rende tutto semplice con un solo clic; otteniamo un compute serverless che si integra perfettamente nei flussi di lavoro. In più, è sicuro. Questa funzione tanto attesa cambia le carte in tavola. Grazie, Databricks!" - Chiranjeevi Katta, Data Engineer, Airbus
Esploriamo le sfide che il compute serverless aiuta a risolvere e i vantaggi unici che offre ai team di dati.
L'infrastruttura di calcolo è complessa e costosa da gestire
Configurare e gestire il compute come i cluster Spark è da tempo una sfida per data engineer e data scientist. Il tempo dedicato alla configurazione e alla gestione del compute è tempo sottratto alla creazione di valore per il business.
Scegliere il tipo e la dimensione di istanza giusti richiede tempo ed esperimenti per determinare la scelta ottimale per un determinato carico di lavoro. Capire le policy dei cluster, l'auto-scaling e le configurazioni Spark complica ulteriormente questo compito e richiede competenze. Una volta configurati e avviati i cluster, devi comunque dedicare tempo alla manutenzione e all'ottimizzazione delle loro prestazioni e all'aggiornamento delle versioni di Databricks Runtime per poter beneficiare delle nuove funzionalità.
Il tempo di inattività, ovvero il tempo non speso per elaborare i carichi di lavoro ma che continui a pagare, è un altro risultato costoso della gestione autonoma dell'infrastruttura di calcolo. Durante l'inizializzazione del compute e lo scale-up, le istanze devono avviarsi, il software incluso Databricks Runtime deve essere installato e così via. Paghi il tuo provider cloud per questo tempo. In secondo modo, se esageri con il provisioning del compute usando troppi cluster o tipi di istanze con troppa memoria, CPU ecc., il compute sarà sottoutilizzato ma pagherai comunque per l'intera capacità di calcolo di cui è stato fatto il provisioning.
Osservare questo costo e questa complessità in milioni di carichi di lavoro dei clienti ci ha spinto a innovare con il compute serverless.
Il compute serverless è veloce, semplice e affidabile
Nel compute classico, concedi a Databricks un permesso delegato tramite policy e ruoli cloud complessi per gestire il ciclo di vita delle istanze necessarie per i tuoi carichi di lavoro. Il compute serverless elimina questa complessità poiché Databricks gestisce una flotta vasta e sicura di compute per conto tuo. Puoi semplicemente iniziare a usare Databricks senza alcuna configurazione.
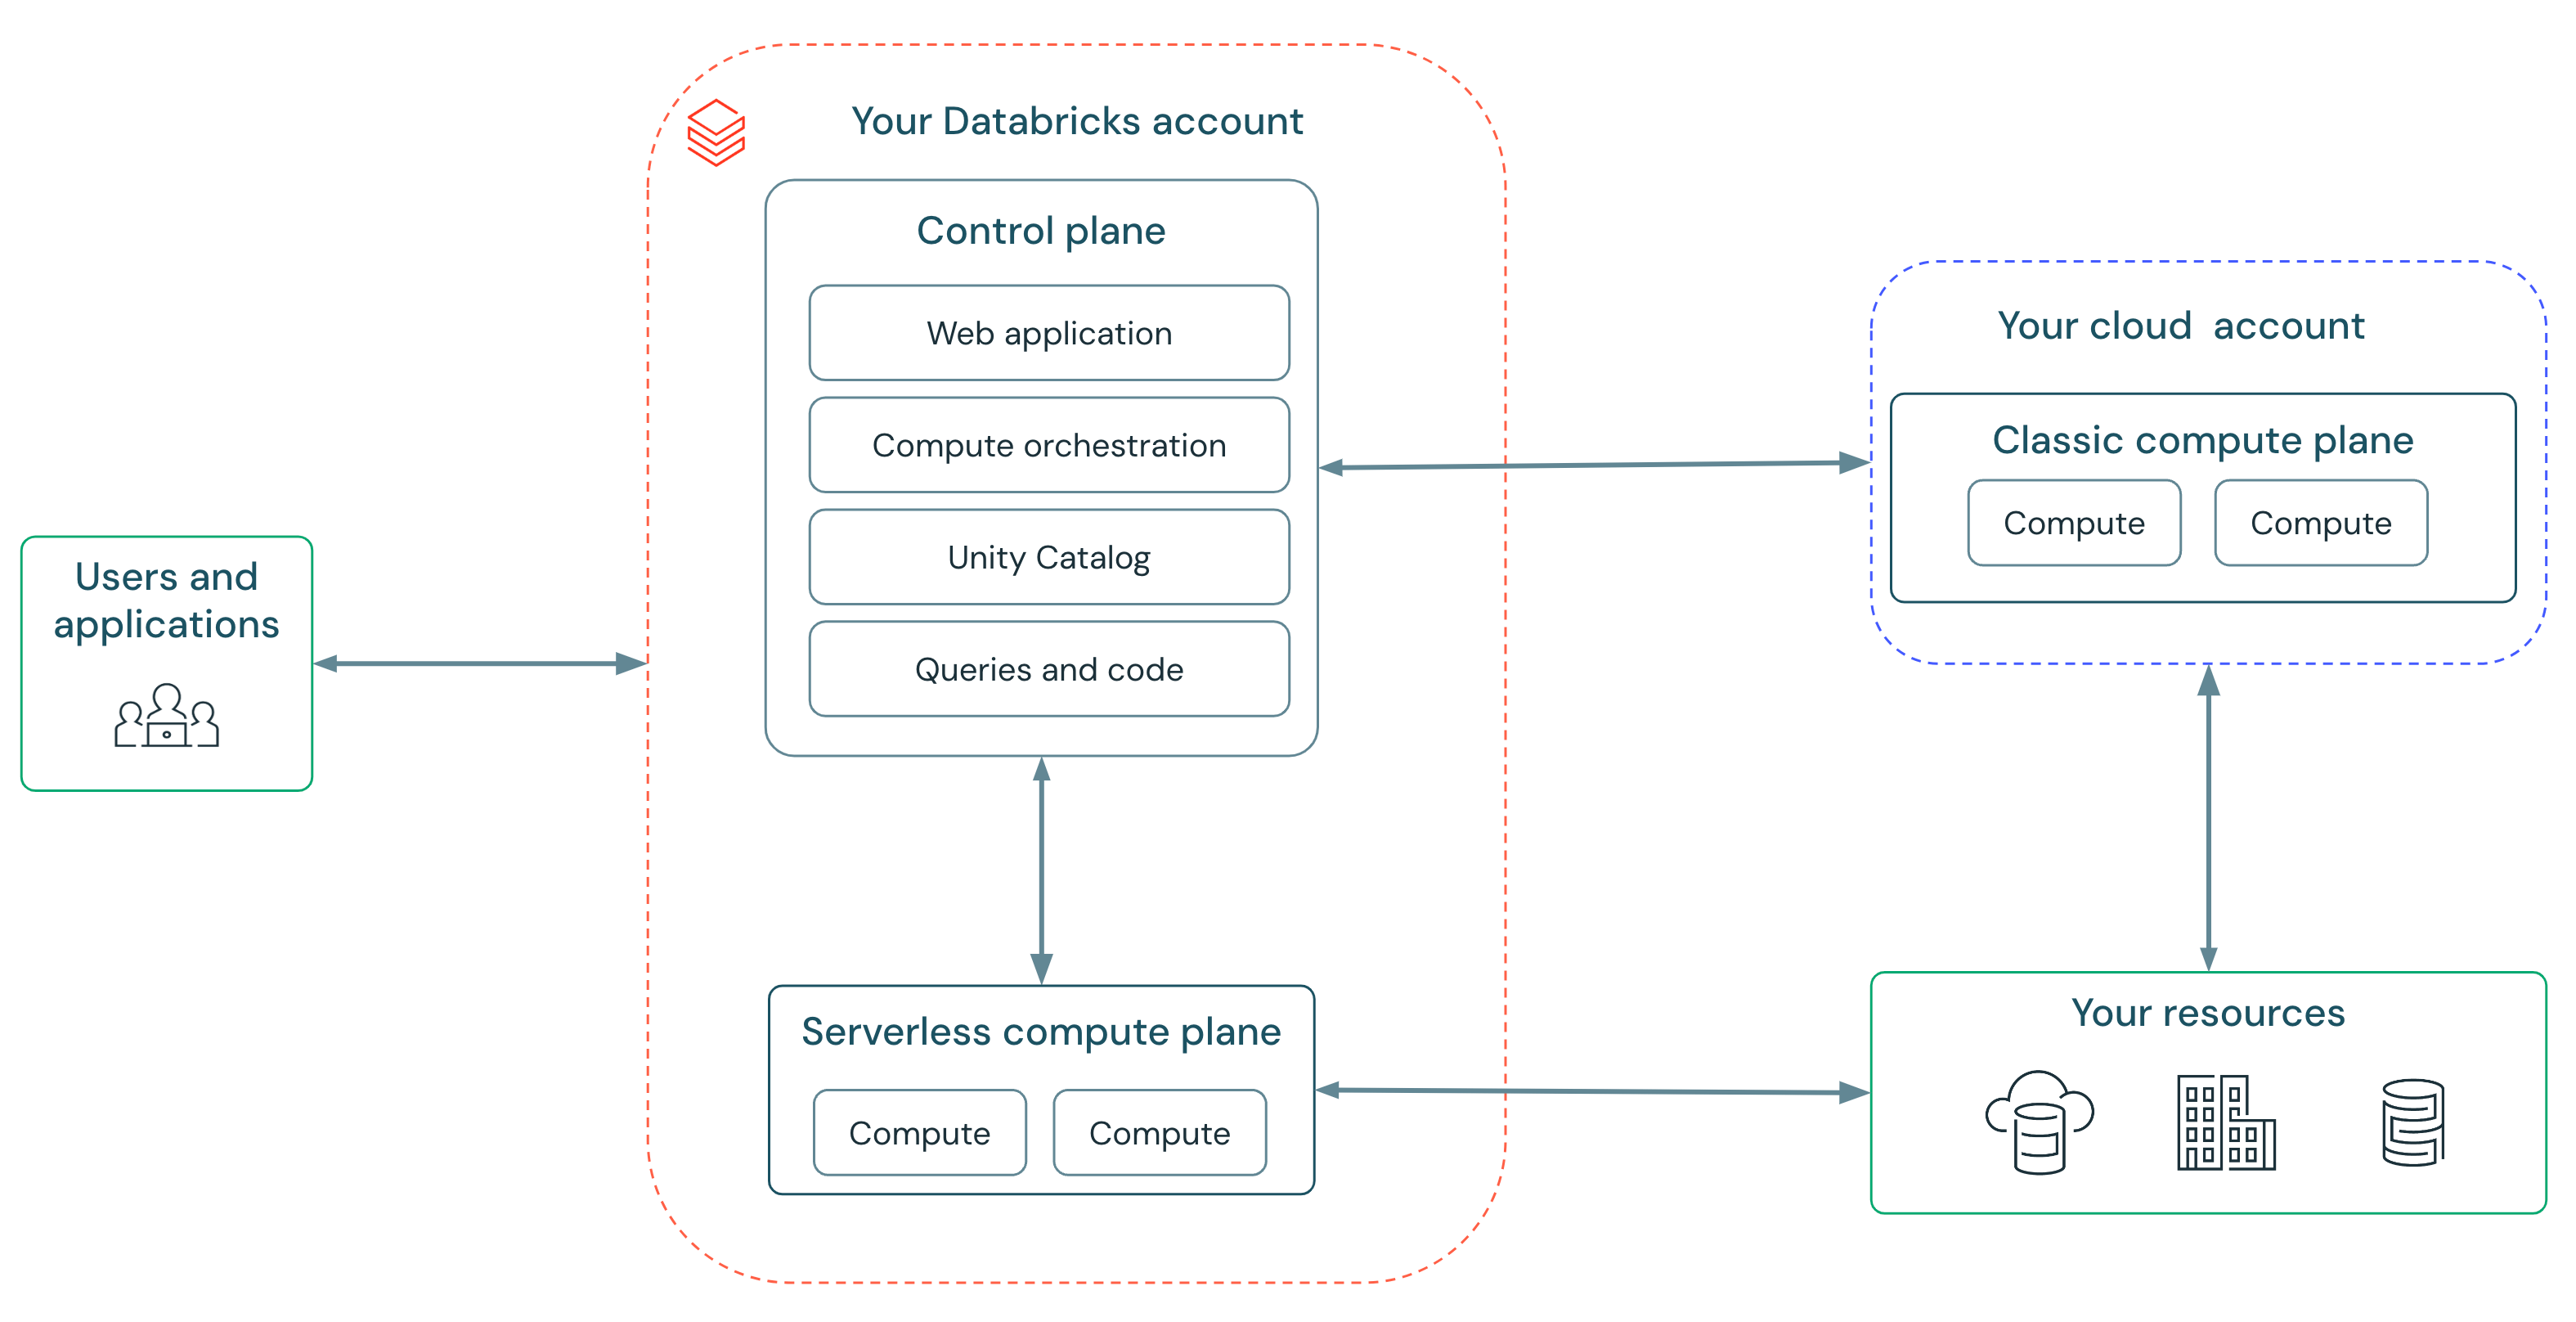
Il compute serverless ci consente di offrire un servizio che è veloce, semplice e affidabile:
- Veloce: Basta attese per i cluster; il compute si avvia in secondi, non minuti. Databricks gestisce "pool caldi" di istanze in modo che il compute sia pronto quando lo sei tu.
- Semplice: Niente più scelta dei tipi di istanza, dei parametri di scalabilità del cluster o impostazione delle configurazioni Spark. Il serverless include un nuovo autoscaler che è più intelligente e reattivo alle esigenze del tuo carico di lavoro rispetto all'autoscaler del compute classico. Ciò significa che ogni utente è ora in grado di eseguire carichi di lavoro senza la supervisione di esperti di infrastruttura. Databricks aggiorna automaticamente i carichi di lavoro e passa in sicurezza alle versioni Spark più recenti, assicurandoti di ottenere sempre i vantaggi più recenti in termini di prestazioni e sicurezza.
- Affidabile: Il compute serverless di Databricks protegge i clienti dalle interruzioni del cloud con il failover automatico del tipo di istanza e un "pool caldo" di istanze che fa da cuscinetto contro la carenza di disponibilità.
"È molto semplice spostare i flussi di lavoro da Dev a Prod senza dover scegliere i tipi di worker. Il notevole miglioramento del tempo di avvio, combinato con una ridotta configurazione e manutenzione di DataOps, migliora notevolmente la produttività e l'efficienza." - Gal Doron, Head of Data, AnyClip
Il compute serverless fattura il lavoro svolto
Siamo entusiasti di introdurre un modello di fatturazione elastica per il compute serverless. Ti viene addebitato un costo solo quando il compute viene assegnato ai tuoi carichi di lavoro e non per il tempo necessario per acquisire e configurare le istanze di calcolo.
L'autoscaler serverless intelligente garantisce che il tuo workspace abbia sempre la giusta quantità di capacità di cui è stato fatto il provisioning, in modo da poter rispondere alla domanda, ad esempio quando un utente esegue un comando in un notebook. Aumenterà e ridurrà automaticamente la capacità del workspace in passaggi graduali per soddisfare le tue esigenze. Per garantire che le risorse siano gestite con saggezza, ridurremo la capacità di cui è stato fatto il provisioning dopo pochi minuti quando l'autoscaler intelligente prevede che non sia più necessaria.
"Il compute serverless per SDP è stato incredibilmente semplice da configurare e avviare, e stiamo già vedendo importanti miglioramenti delle prestazioni dalle nostre viste materializzate. Storicamente, passare dai dati grezzi al layer silver richiedeva circa 16 minuti, ma dopo il passaggio al serverless, ci vogliono solo circa 7 minuti. Il risparmio di tempo e costi sarà immenso" - Aaron Jepsen, Director IT Operations, Jet Linx Aviation
Il compute serverless è facile da gestire
Il compute serverless include strumenti per gli amministratori per gestire costi e budget. Dopotutto, la semplicità non deve significare sforamenti di budget e fatture a sorpresa!
I dati sull'utilizzo e sui costi del compute serverless sono disponibili nelle tabelle di sistema. Forniamo dashboard predefinite che consentono di ottenere una panoramica dei costi e di approfondire carichi di lavoro specifici.
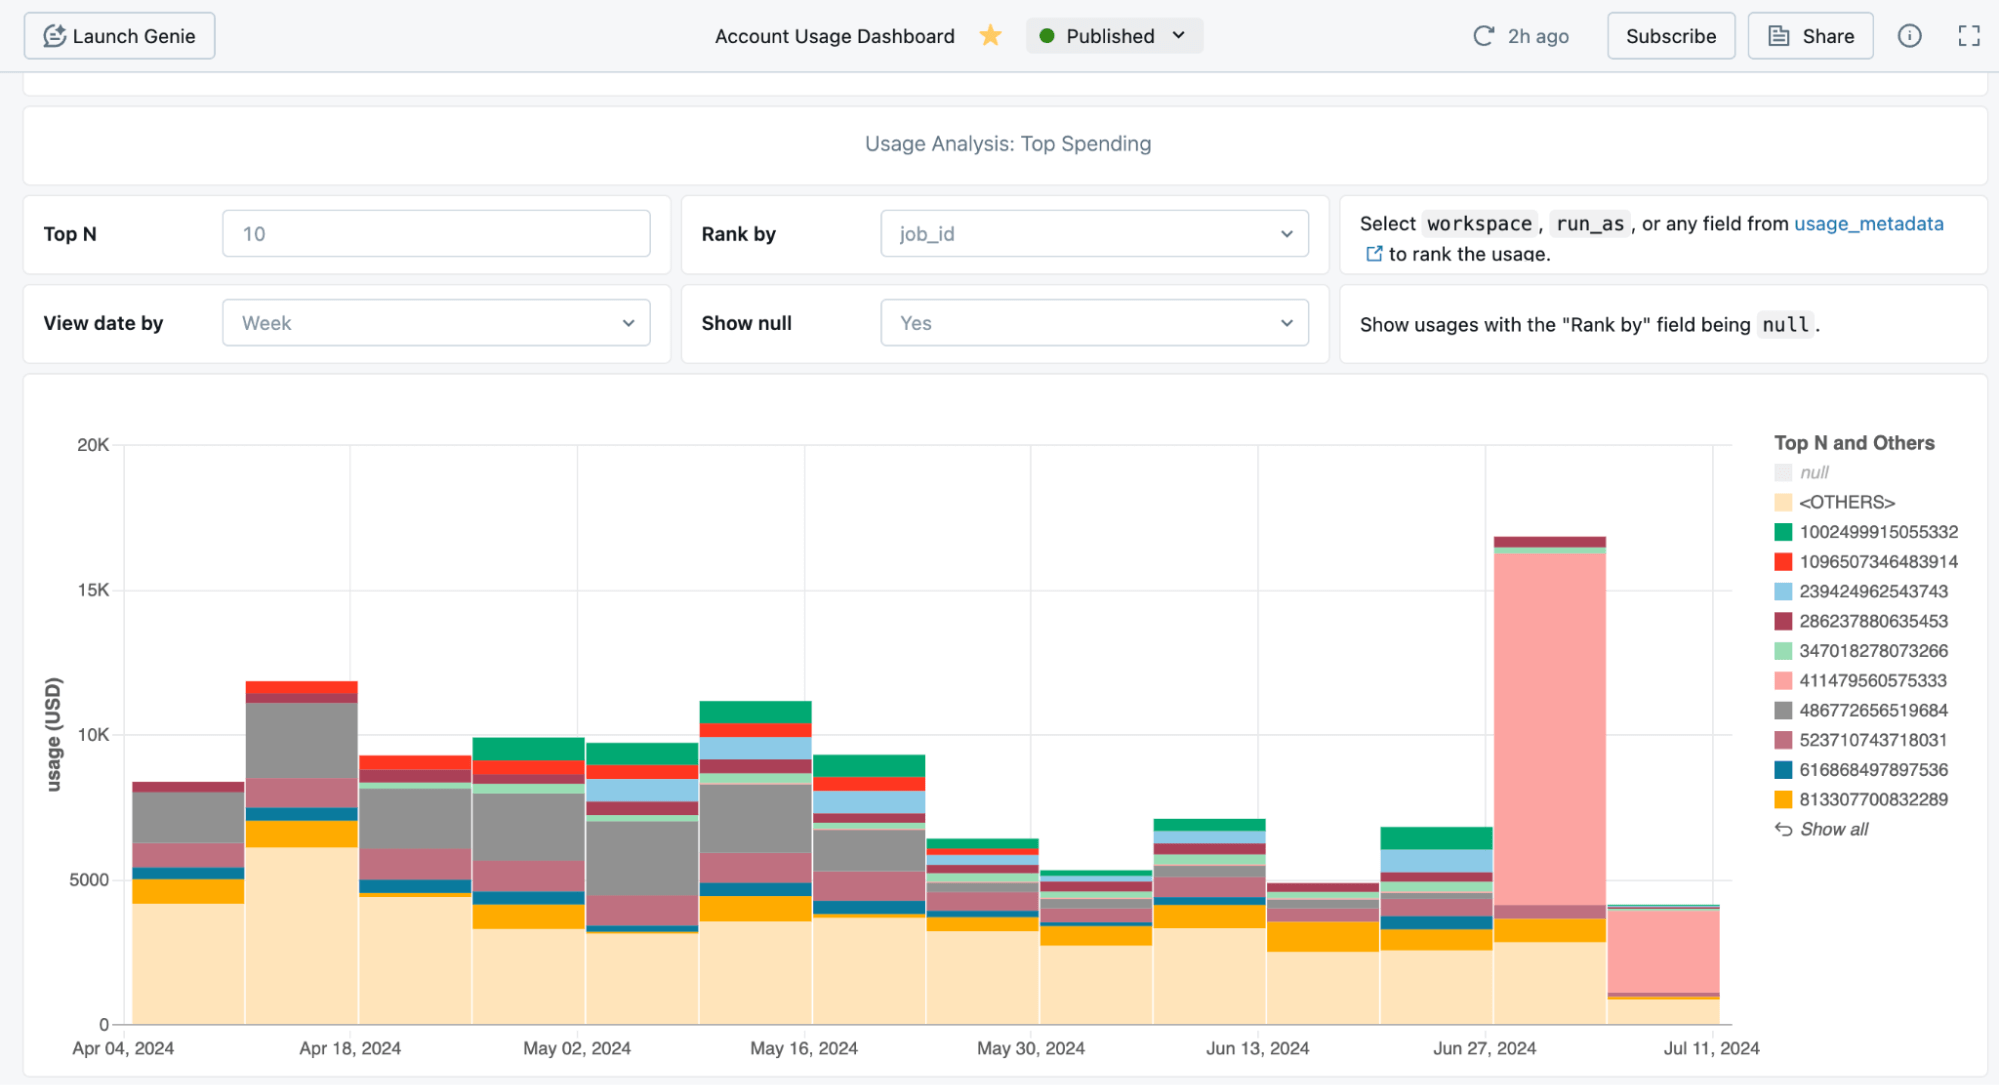
Gli amministratori possono utilizzare gli avvisi di budget (Anteprima) per raggruppare i costi e impostare avvisi. È disponibile un'interfaccia utente intuitiva per la gestione dei budget.

Il compute serverless è progettato per i moderni carichi di lavoro Spark
Dietro le quinte, il compute serverless utilizza Lakeguard per isolare il codice utente utilizzando tecniche di sandboxing, una necessità assoluta in un ambiente serverless. Di conseguenza, alcuni carichi di lavoro richiedono modifiche al codice per continuare a funzionare sul serverless. Il compute serverless richiede Unity Catalog per l'accesso sicuro agli asset di dati, pertanto i carichi di lavoro che accedono ai dati senza utilizzare Unity Catalog potrebbero richiedere modifiche.
Il modo più semplice per verificare se il tuo carico di lavoro è pronto per il compute serverless è eseguirlo prima su un cluster classico utilizzando la modalità di accesso condiviso su DBR 14.3+.

Il compute serverless è pronto per l'uso
Stiamo lavorando duramente per rendere il compute serverless ancora migliore nei prossimi mesi:
- Supporto GCP: Stiamo iniziando un'anteprima privata del compute serverless su GCP; restate sintonizzati per i nostri annunci di anteprima pubblica e GA.
- Networking privato e controlli di egress: Collegati alle risorse all'interno della tua rete privata e controlla ciò a cui le tue risorse di calcolo serverless possono accedere su Internet pubblico.
- Attribuzione applicabile: Assicurati che tutti i notebook, i flussi di lavoro e le pipeline SDP siano etichettati in modo appropriato per poter assegnare i costi a centri di costo specifici, ad esempio per gli addebiti interni.
- Ambienti: Gli amministratori potranno impostare un ambiente di base per l'area di lavoro con accesso a repository privati, versioni specifiche di Python e di librerie e variabili d'ambiente.
- Costi rispetto alle prestazioni: Il calcolo serverless è attualmente ottimizzato per un avvio rapido, la scalabilità e le prestazioni. Gli utenti potranno presto esprimere altri obiettivi, come costi inferiori.
- Supporto per Scala: Gli utenti potranno eseguire carichi di lavoro Scala su calcolo serverless. Per prepararti a passare senza problemi al serverless non appena sarà disponibile, sposta i tuoi carichi di lavoro Scala sul calcolo classico con modalità di accesso condiviso.
Per iniziare a usare il calcolo serverless oggi stesso:
- Abilita il calcolo serverless nel tuo account su AWS o Azure
- Assicurati che la tua area di lavoro sia abilitata all'uso di Unity Catalog e si trovi in una regione supportata in AWS o Azure.
- Per i carichi di lavoro PySpark esistenti, assicurati che siano compatibili con la modalità di accesso condiviso e DBR 14.3+
- Segui le istruzioni specifiche per Notebooks, Workflows, Spark Declarative Pipelines
- Usa il calcolo serverless da qualsiasi sistema di terze parti con Databricks Connect, ad esempio durante lo sviluppo in locale dal tuo IDE o quando integri le tue applicazioni con Databricks in modo nativo in Python.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.