Model Serving
Implementazione e governance unificate per tutti i modelli e agenti di AI

Che cos'è Databricks Model Serving?
Databricks Model Serving offre alle aziende una soluzione solida per l'implementazione di modelli di ML classici, modelli di AI generativa e agenti di AI. Supporta modelli proprietari come Azure OpenAI, AWS Bedrock e Anthropic, nonché modelli open source come Llama e Mistral. I clienti possono anche servire modelli open source ottimizzati o modelli ML classici addestrati sui propri dati. I clienti possono utilizzare facilmente i modelli forniti come endpoint nei loro flussi di lavoro, ad esempio per l'inferenza in batch su larga scala o applicazioni in tempo reale. Model Serving include anche funzionalità integrate di governance, derivazione e monitoraggio per garantire risultati di alta qualità.
Cosa dicono i clienti di Databricks Model Serving
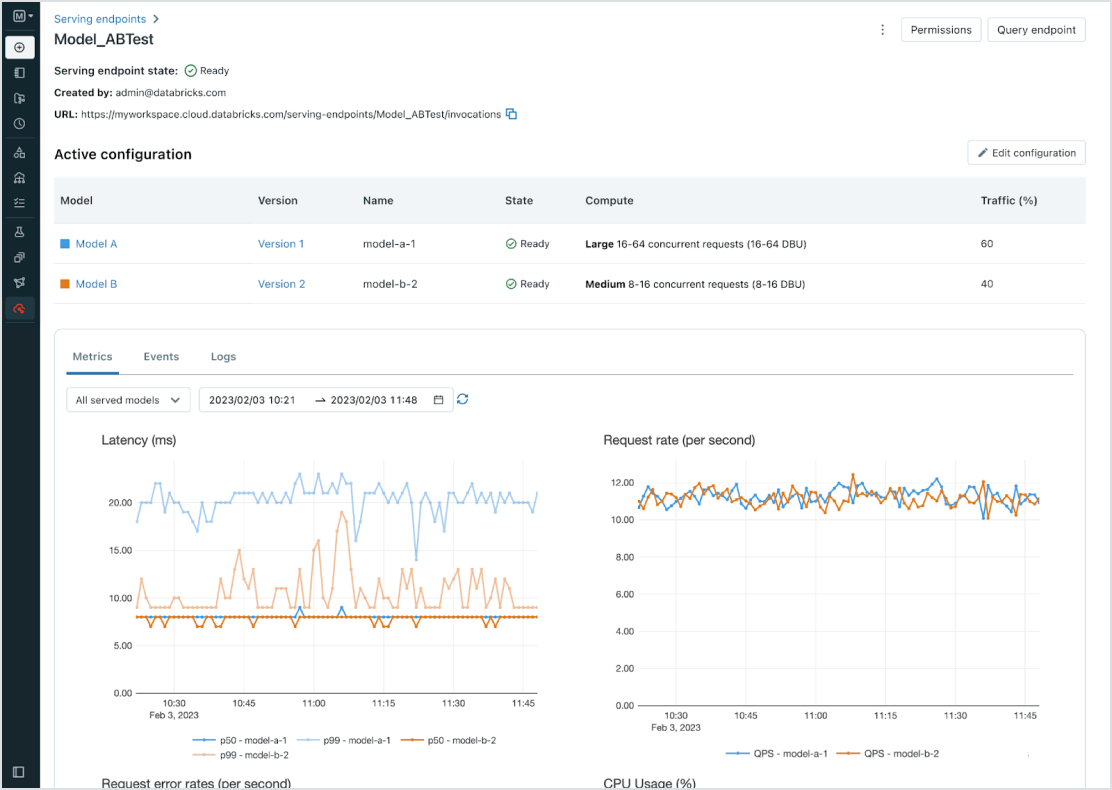
Distribuzione semplificata per tutti i modelli e agenti di AI
Distribuisci qualsiasi tipo di modello, dai modelli open-source preaddestrati ai modelli personalizzati costruiti con i tuoi dati, su CPU e GPU. La creazione di container e la gestione dell'infrastruttura automatizzate riducono i costi di manutenzione e velocizzano la distribuzione, consentendo di concentrarsi sulla costruzione di sistemi di agenti di AI e sulla creazione di valore aggiunto per l'attività in tempi più rapidi.
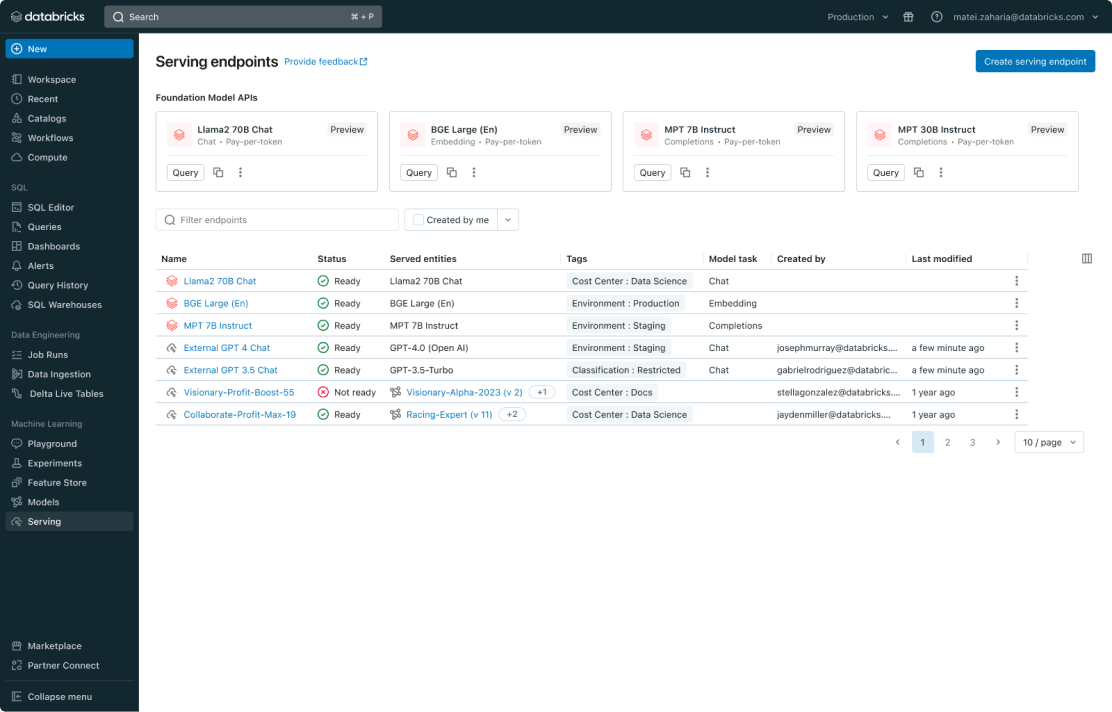
Gestione unificata per tutti i modelli
Gestisci tutti i modelli, inclusi modelli ML personalizzati come PyFunc, scikit-learn e LangChain, modelli di base (FM) su Databricks come Llama 3, MPT e BGE e modelli di base ospitati altrove come ChatGPT, Claude 3, Cohere e Stable Diffusion. Model Serving rende accessibili tramite un'interfaccia utente e un'API unificata tutti i modelli, inclusi quelli ospitati da Databricks o da altri fornitori su Azure o AWS.
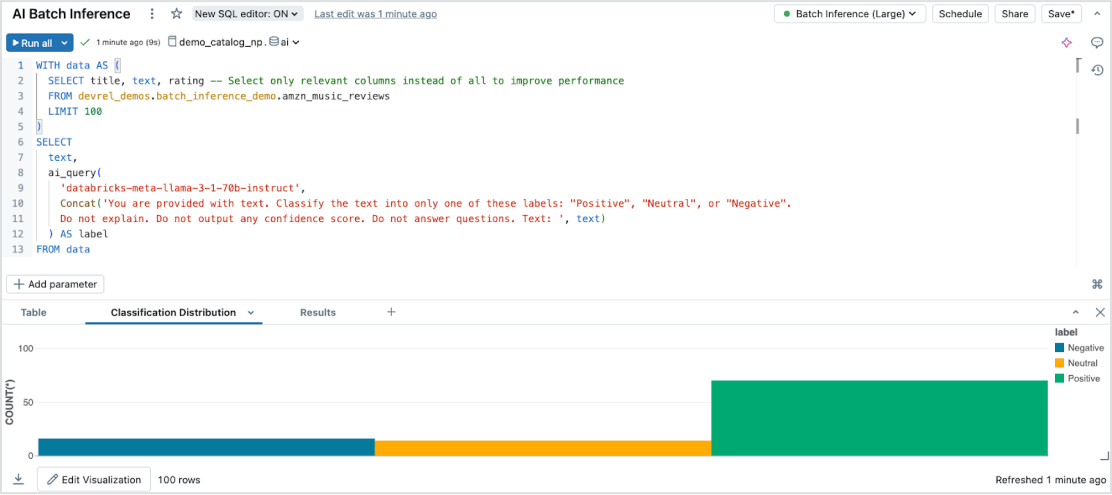
Inferenza in batch con Funzioni AI
Model Serving consente inferenze AI efficienti e serverless su set di dati di grandi dimensioni su tutti i tipi di dati e modelli. Integra perfettamente con Databricks SQL, Notebooks e Workflows per applicare l'AI su larga scala. Grazie a Funzioni AI, permette di eseguire inferenze in batch su vasta scala in modo immediato, senza gestione dell'infrastruttura, garantendo velocità, scalabilità e governance.
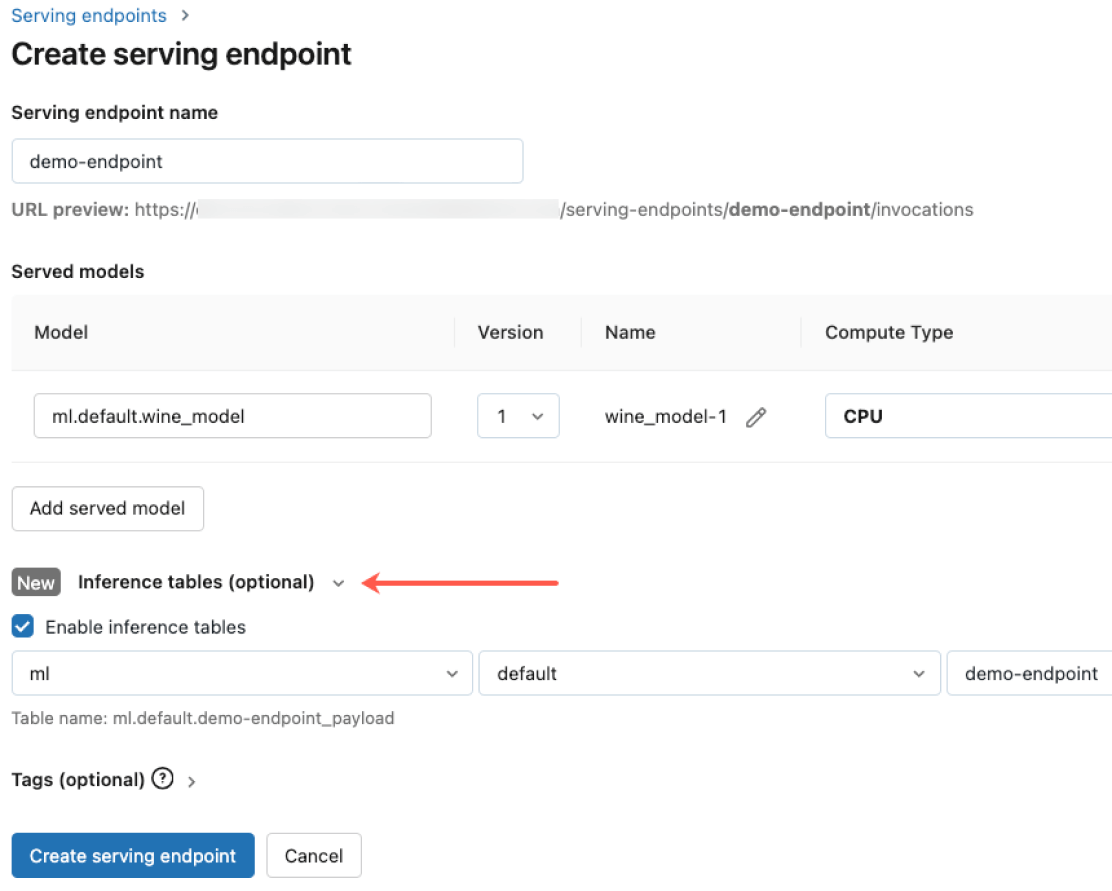
Governance integrata con Unity Gateway
Integra con Unity Gateway per soddisfare rigorosi requisiti di sicurezza e governance avanzata. Puoi applicare permessi specifici, monitorare la qualità dei modelli, impostare limiti di utilizzo e tracciare la derivazione su tutti i modelli, indipendentemente dal fatto che siano ospitati da Databricks o da altri provider.
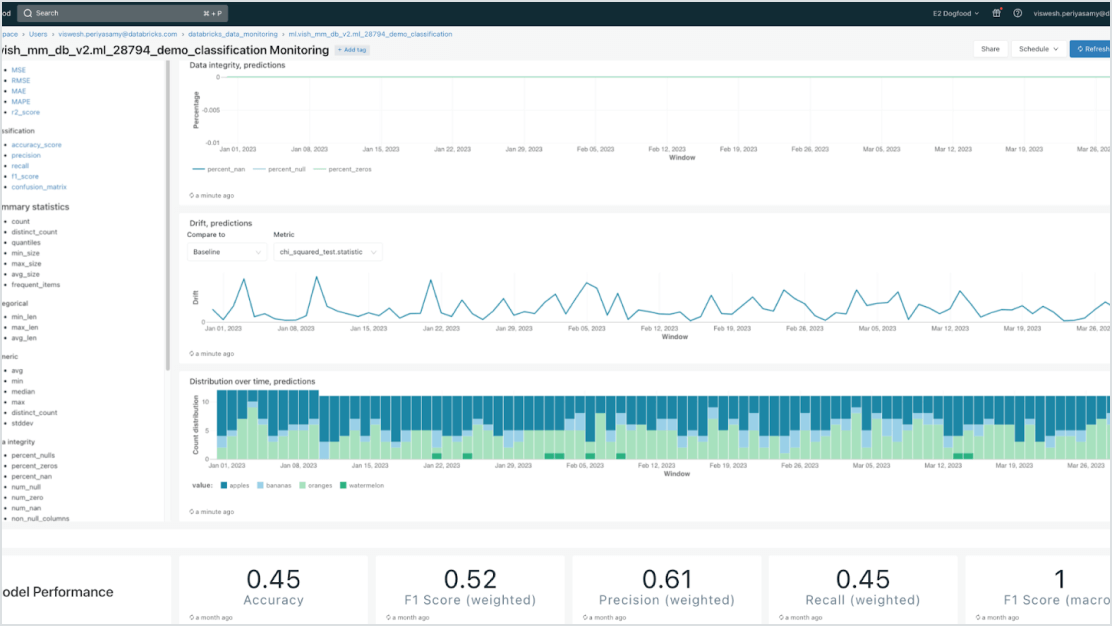
Ospita modelli ottimizzati e RAG basati sui tuoi dati
Accelera le implementazioni e riduci gli errori grazie alla profonda integrazione con la Data + AI Platform. Puoi ospitare facilmente modelli di ML classici e AI generativa, di generazione aumentata (RAG) o ottimizzati con i dati aziendali. Model Serving offre funzionalità automatizzate di ricerca, monitoraggio e governance lungo tutto il ciclo di vita dell'AI.
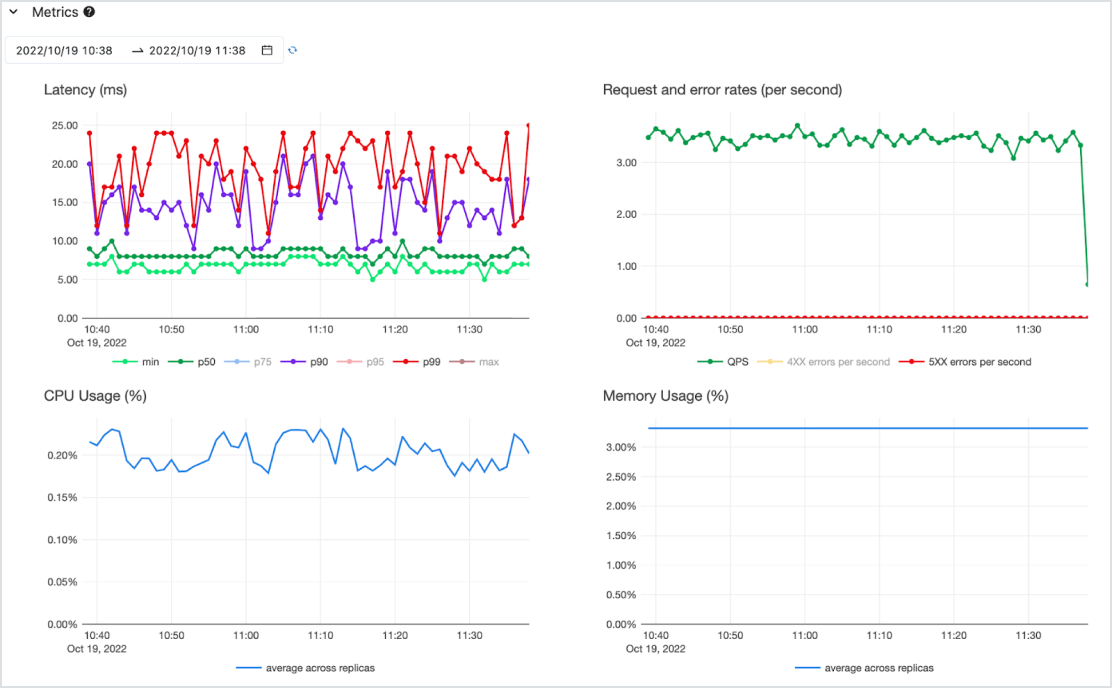
Prezzi pay-per-token o per throughput provisioned
Distribuisci modelli come API a bassa latenza su un servizio serverless altamente disponibile con supporto sia per CPU che per GPU. La soluzione può essere espansa senza fatica partendo da zero per soddisfare le esigenze più critiche (ed eventualmente ridimensionata secondo necessità). Puoi iniziare rapidamente con uno o più modelli pre-distribuiti e scegliere tra il pagamento a consumo (pay-per-token, su richiesta senza impegni) o il pagamento per carichi di lavoro di calcolo provisioned per una velocità di trasmissione garantita. Databricks si farà carico della gestione dell'infrastruttura e dei costi di manutenzione, così la tua azienda potrà concentrarsi sulla generazione di valore.
Comincia a lavorare con queste risorse
Post sul blog relativi a Databricks Model Serving
Documentazione di Databricks Model Serving
eBook su MLOps, RAG e ottimizzazione di LLM
Domande frequenti
Databricks Model Serving è una soluzione di distribuzione e governance unificata per modelli di ML classici, modelli di AI generativa e agenti di AI. Supporta modelli proprietari come Azure OpenAI, AWS Bedrock e Anthropic, nonché modelli open source come Llama e Mistral, e consente di utilizzare modelli open source ottimizzati o modelli ML classici addestrati sui propri dati. I modelli serviti possono essere utilizzati come endpoint per applicazioni in tempo reale o inferenze in batch su larga scala, con governance, derivazione e monitoraggio integrati per garantire output di alta qualità.