Branching dei database: una guida per sviluppatori ai workflow in stile Git
Scopri come il branching dei database introduce workflow in stile Git, utilizzando il copy-on-write per creare ambienti isolati e usa e getta per sviluppatori, CI e agenti AI.
- Il branching dei database crea ambienti isolati tramite copy-on-write, condividendo i dati non modificati e memorizzando solo le differenze, senza richiedere copie complete.
- Supporta test simili alla produzione, l'isolamento della CI per ogni PR e un ripristino semplice, con le migrazioni (non i merge) come fonte di verità.
- È fondamentale per gli agenti AI che eseguono molti branch a breve termine; un utilizzo sicuro richiede parent protetti, dati mock, TTL e controlli di accesso.
Git ha reso lo sviluppo isolato uno standard per i team di sviluppo software. Ogni sviluppatore può creare un branch, lavorare in modo indipendente e unire le modifiche quando è pronto.
Il branching del database porta questo stesso isolamento nel database. Consente agli sviluppatori, ai job di continuous integration (CI) e agli agenti AI di creare ambienti di database isolati a partire da uno stato del database condiviso e di apportare modifiche senza influire sul database principale o l'uno sull'altro.
Ciò significa meno tempo ad attendere ambienti condivisi, meno fallimenti dei test causati dalle modifiche di altri e un feedback più rapido sulle migrazioni dello schema. Quando qualcosa va storto, puoi eliminare il branch invece di riparare o ripristinare un database condiviso.
TL;DR
- Il branching del database crea ambienti isolati senza copie complete del database. Il copy-on-write rende tutto questo possibile condividendo i dati non modificati e memorizzando solo ciò che cambia.
- Il branching del database è sempre più importante per gli agenti AI. Offre agli agenti ambienti isolati per testare le modifiche e sperimentare senza mettere a rischio il database principale.
- Gestire i branch del database in modo sicuro richiede controlli chiari. Proteggi i branch principali, limita l'accesso ai dati sensibili, automatizza la pulizia e mantieni riproducibili gli ambienti usa e getta.
Cos'è il branching del database?
Il branching del database ti offre un ambiente di database isolato basato sullo stato di un altro database in un momento specifico. Il branch inizia con lo schema del database principale e i relativi dati, ma le modifiche apportate al branch non influiscono sul database principale o su altri branch correlati.
Se hai familiarità con Git, l'idea di base dovrebbe esserti nota. Un branch di codice ti offre una linea di sviluppo privata a partire da un commit noto. Un branch di database ti offre un ambiente di database isolato a partire da uno stato noto del database.
Un'importante differenza è che di solito non si esegue il merge delle modifiche da un branch di database nel database principale. Al contrario, i file di migrazione rimangono la fonte di verità duratura. Puoi testare una migrazione sul tuo branch, assicurarti che funzioni con dati realistici e poi lasciare che la tua pipeline di deployment applichi la stessa migrazione al database di destinazione. In questo modo, il branching del database rende pratiche consolidate come il design evolutivo del database, gli ambienti di database per sviluppatore e le migrazioni controllate dalla versione pratiche anche quando si lavora con dati su scala di produzione.
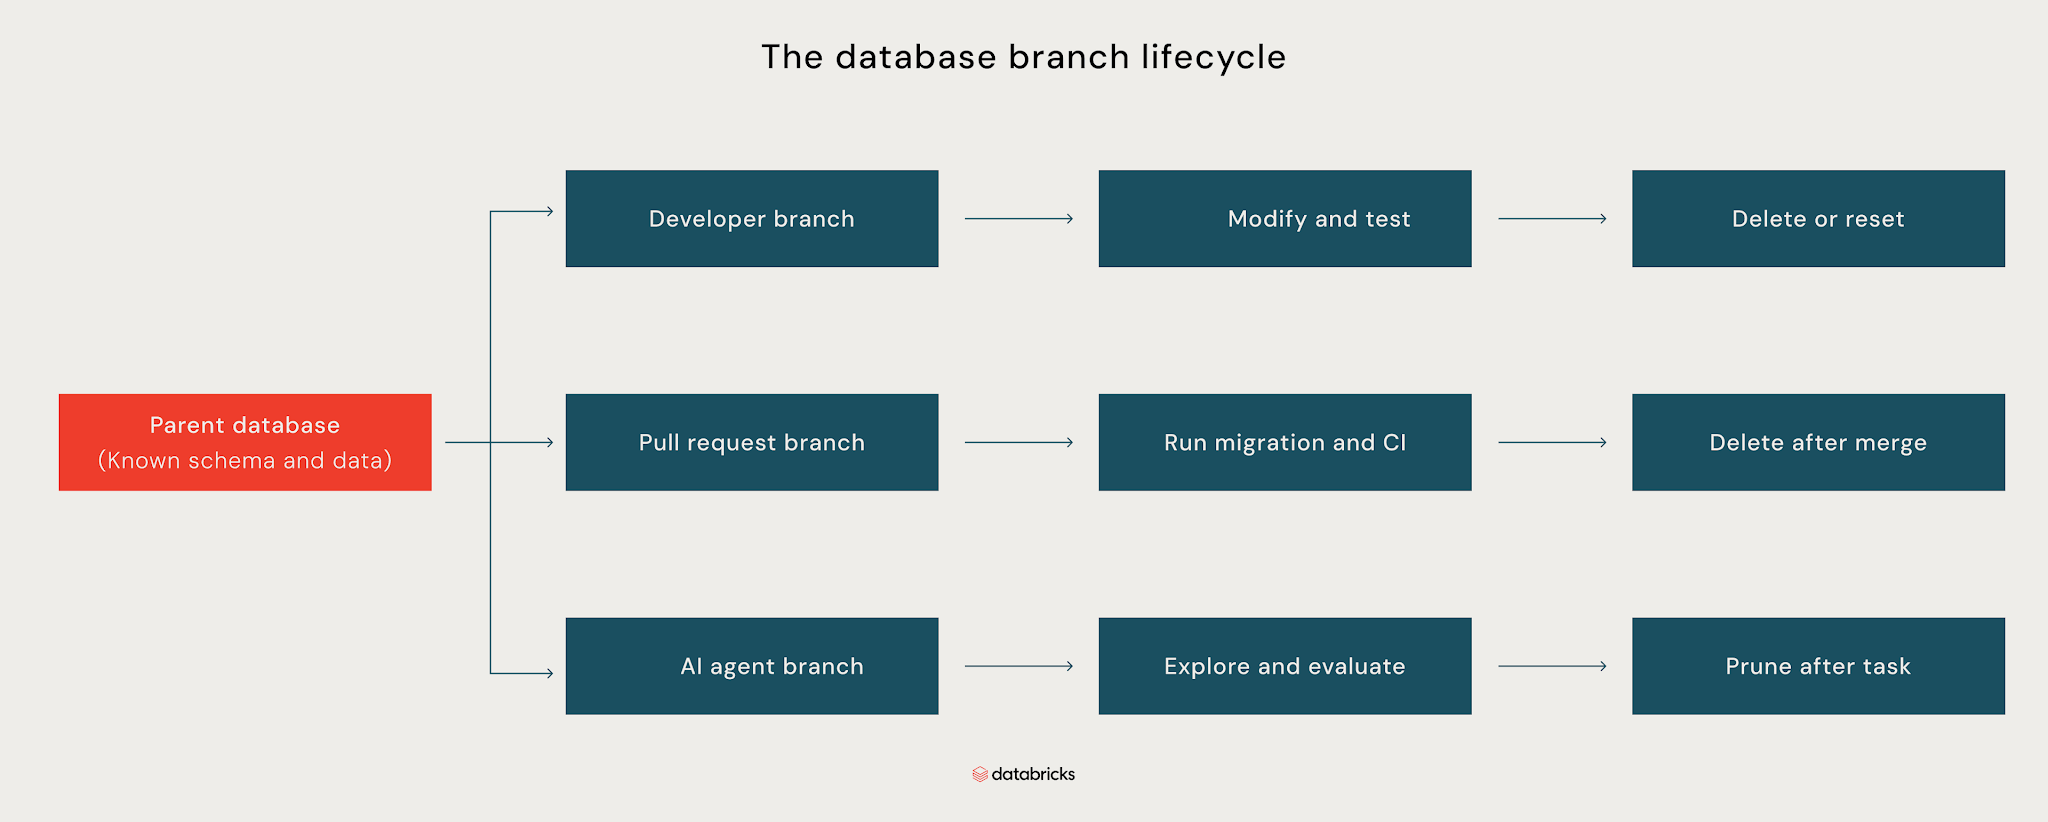
Come mostrato sopra, un database principale fornisce lo schema e i dati noti per più branch isolati. Puoi utilizzare un branch di sviluppo per modificare e testare le modifiche, un branch di pull request per eseguire migrazioni e CI, o un branch di agenti per esplorare e valutare le modifiche. Al termine del lavoro, ogni branch può essere ripristinato, eliminato o rimosso senza influire sul database principale o sugli altri branch. Il branching del database rende possibile questo livello di isolamento tramite il copy-on-write.
Come funziona il branching del database Copy-on-Write
Il copy-on-write (CoW) rende pratico il branching del database evitando una copia completa preventiva del database. Quando crei un branch, inizialmente condivide i dati esistenti del database principale invece di duplicarli. Entrambi possono leggere gli stessi dati sottostanti, mentre le modifiche apportate a uno rimangono isolate dall'altro. Ma quando il branch modifica i dati, il livello di archiviazione crea una nuova versione dei dati interessati per quel branch, mentre i dati non modificati rimangono condivisi con il database principale.
Lakebase utilizza questo approccio copy-on-write per creare branch di database senza duplicare l'intero database principale. Di conseguenza, ogni branch richiede spazio di archiviazione aggiuntivo solo per i dati che divergono dal database principale.
Considera un database da 40 GB. Con una copia completa tradizionale, la creazione di un branch di sviluppo e di un branch di pull request richiede altri 80 GB di spazio di archiviazione. Tuttavia, con il copy-on-write, entrambi i branch inizialmente condividono i dati del database principale e consumano spazio di archiviazione aggiuntivo solo quando divergono.
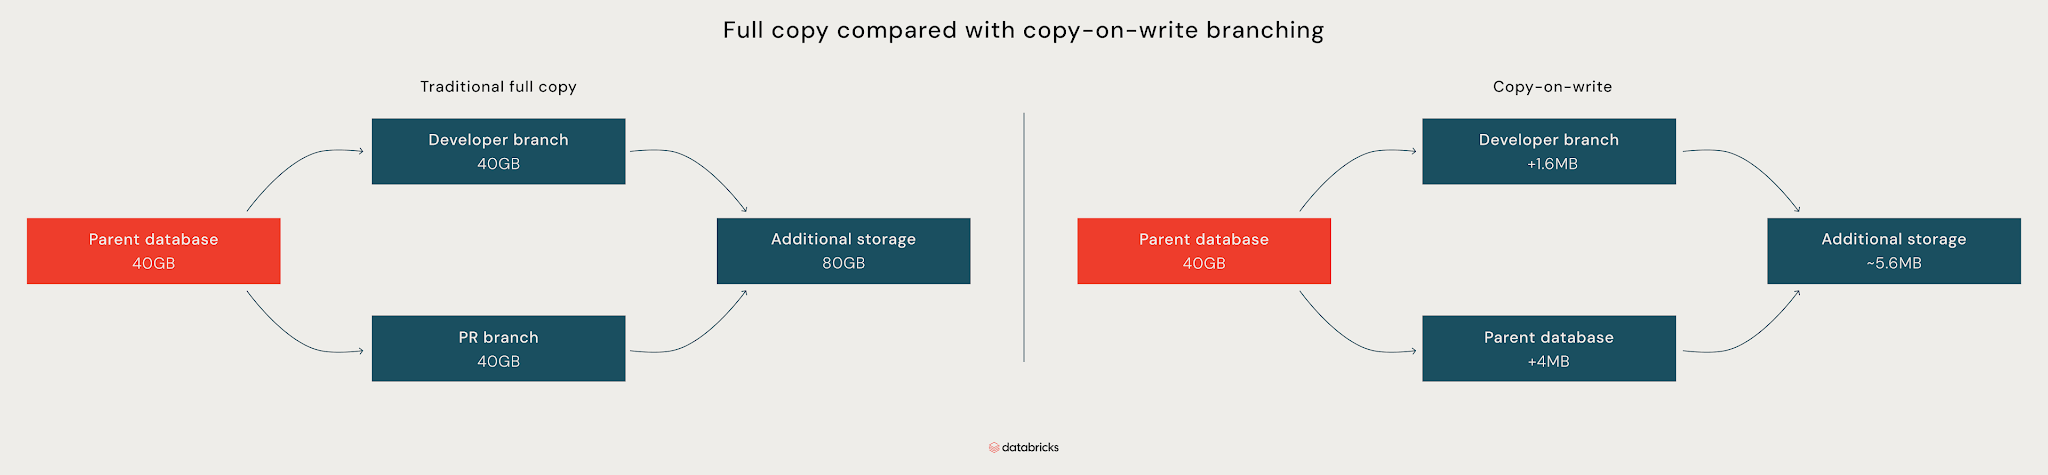
Come mostrato nel diagramma sopra, se le modifiche nel branch di sviluppo sono di soli 1,6 MB e le modifiche nel branch PR sono di soli 4 MB, i due branch aggiungono solo circa 5,6 MB di spazio di archiviazione. Le copie tradizionali duplicano l'intero database per ciascun branch, mentre i branch copy-on-write condividono i dati non modificati e memorizzano solo le proprie modifiche.
Lo stesso principio si applica quando il database principale cambia dopo la creazione di un branch. Il branch continua a fare riferimento alla versione originale dei dati non modificati, mentre il database principale scrive nuove versioni delle pagine che modifica. Ciò consente ai due branch di cambiare in modo indipendente senza duplicare i dati non modificati.
Cosa rende possibile il branching del database
Una volta implementato il branching del database, diversi flussi di lavoro di sviluppo diventano molto più facili da realizzare:
Baseline simili alla produzione
Puoi creare branch di database da uno snapshot di produzione protetto, in modo che ogni sviluppatore e job di CI parta dallo stesso stato noto. Ciò ti consente di testare le migrazioni con dati realistici, vincoli esistenti e tabelle su scala di produzione, anziché con un database locale vuoto o un ambiente di staging obsoleto.
For example, a migrazione come ALTER TABLE orders ADD COLUMN customer_id UUID NOT NULL potrebbe funzionare su un database vuoto ma fallire su milioni di ordini esistenti. Testarla su un branch simile alla produzione espone questo problema prima che la migrazione raggiunga lo staging o la produzione. Quando il branch diventa obsoleto, puoi eliminarlo e crearne uno nuovo dalla stessa baseline.
Isolamento per PR
Puoi assegnare a ogni pull request il proprio ambiente di database. La CI crea il branch all'apertura della PR, applica le migrazioni proposte ed esegue test di integrazione su di esso. Quando la PR viene chiusa, la pipeline elimina il branch.
Ciò significa che due sviluppatori possono apportare modifiche allo schema in conflitto senza influire sui test reciproci. Una PR che aggiunge una colonna, modifica un vincolo o modifica un indice ottiene il proprio stato del database, in modo che la CI testi la modifica in isolamento anziché rispetto a ciò che un altro sviluppatore sta facendo in staging.
Ripristino dei guasti più semplice
I branch facilitano anche l'isolamento di migrazioni ed esperimenti falliti. Se un backfill produce risultati imprevisti, un test corrompe i dati o una migrazione lascia un branch in uno stato non valido, puoi scartare il branch interessato e crearne uno nuovo dal database principale invece di continuare a lavorare con un ambiente di sviluppo contaminato.
Ad esempio, puoi testare in sicurezza un'operazione distruttiva come DELETE FROM orders WHERE created_at < ... su un branch, ispezionare i risultati e scartare il branch al termine. Il database principale rimane intatto per tutto il tempo.
Per gli sviluppatori e i team DevOps, questi vantaggi sono già convincenti. Tuttavia, se stai creando o eseguendo agenti AI, il branching del database diventa importante su una scala completamente diversa.
Il playbook sull'AI agentiva per l'enterprise

Perché gli agenti AI rendono il branching critico per l'infrastruttura
Gli agenti AI potrebbero aver bisogno dei propri ambienti di database per testare diversi approcci a un'attività. Possono creare un branch per ciascun approccio, confrontare i risultati e scartare quelli che non servono. In una flotta di agenti, ciò può significare centinaia o migliaia di ambienti di breve durata in esecuzione contemporaneamente.
A questa scala, le copie complete del database diventano costose e lente da predisporre. Il branching del database evita questo sovraccarico, rendendo pratico per gli agenti creare e scartare ambienti mentre lavorano.
Il branching può anche ridurre il raggio d'azione degli errori degli agenti fornendo loro un ambiente isolato per testare le modifiche. Invece di concedere a un agente l'accesso in scrittura a un database di produzione, puoi concedergli l'accesso a un branch in cui può testare operazioni distruttive senza influire sul database principale.
Come gestire i branch del database in modo sicuro
I branch del database sono più facili da gestire quando vengono trattati come ambienti usa e getta e se ne automatizza il ciclo di vita. Alcune pratiche mantengono questo flusso di lavoro sicuro e prevedibile:
- Proteggi i branch di produzione e principali: limita chi può scrivere, ripristinare o eliminare i branch di produzione e altri branch principali importanti. Gli agenti e gli sviluppatori dovrebbero invece lavorare su branch secondari.
- Utilizza dati sicuri per i branch effimeri: evita di copiare dati di produzione sensibili in branch di sviluppo o di agenti di breve durata, a meno che non sia necessario e opportunamente protetto. Ove possibile, utilizza dati fittizi in modo che gli ambienti usa e getta non diventino un canale per esporre informazioni di produzione.
- Imposta un time to live (TTL) per i branch: assegna una scadenza ai branch a breve termine, in modo che le PR abbandonate, le esecuzioni CI non andate a buon fine e i task degli agent interrotti non lascino gli ambienti attivi a tempo indeterminato.
- Mantieni le migrazioni come unica fonte di verità: gestisci i file di migrazione come unica fonte di verità. Testa le migrazioni su un branch, esaminale nel controllo di versione e applica la migrazione approvata al database di destinazione, anziché promuovere le modifiche apportate direttamente su un branch.
- Rendi gli ambienti riproducibili: considera i branch come usa e getta anziché come ambienti a lungo termine che richiedono interventi manuali di ripristino. Mantieni la configurazione necessaria per ricreare un ambiente nel controllo di versione, in modo che un branch obsoleto o danneggiato possa essere eliminato e ricreato a partire dal relativo parent.
- Controlla l'accesso e l'utilizzo delle risorse: concedi a sviluppatori e agent solo le autorizzazioni necessarie e monitora l'età dei branch, il compute, lo storage e il numero di ambienti attivi. Utilizza strumenti come Unity Catalog per gestire l'accesso ai dati disponibili all'interno di questi ambienti.
Con queste linee guida implementate, i team possono utilizzare i branch di database come ambienti usa e getta per lo sviluppo, l'integrazione continua e la distribuzione continua (CI/CD) e i workflow degli agent. Ogni branch offre un ambiente isolato per testare le modifiche e può essere rimosso automaticamente al termine del lavoro.
Conclusioni
Il branching dei database offre un modo pratico per creare ambienti di database isolati senza i costi e i sovraccarichi (overhead) delle copie complete. Puoi utilizzare i branch per testare le migrazioni con dati realistici, assegnare a ogni pull request un proprio database, eseguire il ripristino da esperimenti non andati a buon fine ed eseguire in parallelo carichi di lavoro (workload) basati su database.
Inizia con un workflow semplice, ad esempio un branch per ogni pull request, e automatizza la creazione e la pulizia. Da lì, potrai estendere il branching agli ambienti di sviluppo e ai workload degli agent man mano che le tue esigenze crescono. Vuoi fare una prova? Esplora il branching dei database con Databricks Lakebase o segui un tutorial pratico per implementare il branching dei database in Postgres.
Domande frequenti
Che cos'è il branching dei database?
Il branching dei database crea un ambiente di database isolato da un database parent in un momento specifico. Il branch inizia con lo schema e i dati del parent, ma le modifiche apportate al branch rimangono isolate. Con il copy-on-write, i branch condividono i dati non modificati con il parent, il che li rende veloci da creare ed economici da eliminare.
In cosa differisce il branching dei database dal branching di Git?
L'idea è simile: entrambi consentono di creare un ambiente isolato a partire da uno stato noto e di apportare modifiche senza influire sull'originale. I branch di Git isolano il codice sorgente, mentre i branch di database isolano lo schema e i dati del database.
Successivamente, i workflow differiscono. I branch di Git vengono in genere sottoposti a merge nel branch principale, mentre i branch di database di solito no. Al contrario, testi la migrazione sul branch del database e poi applichi la migrazione esaminata al database di destinazione tramite il processo di deployment.
Qual è lo scopo del branching dei database?
Il branching dei database offre a sviluppatori, job CI e agent AI ambienti isolati per testare le modifiche senza influire sulla produzione o su altri workload. Puoi utilizzare i branch per testare le migrazioni con dati realistici, creare ambienti per ogni PR, eseguire il ripristino da esperimenti non andati a buon fine ed eseguire in parallelo più workload basati su database.
Quali sono i due tipi di branching dei database?
I due approcci comuni sono il branching full-copy e il branching copy-on-write. Il branching full-copy duplica il database per ogni branch, pertanto i tempi di creazione e i requisiti di storage aumentano con le dimensioni del database. Il branching copy-on-write condivide i dati non modificati con il parent e memorizza solo le modifiche apportate a ciascun branch.
Quali tipi di database supportano il branching?
Il branching dipende più dall'architettura di storage del database che dal suo modello di dati. I database relazionali, a documenti, chiave-valore e a grafi possono teoricamente supportare tutti il branching, ma l'implementazione e le funzionalità variano a seconda della piattaforma.
Come si implementa il branching dei database?
L'implementazione dipende dalla piattaforma del database e dall'architettura di storage. In generale, hai bisogno di un database parent e di un modo per creare branch isolati da uno stato del database noto. Databricks Lakebase fornisce il branching dei database per i workflow di sviluppo, CI e agent, con branch che possono essere creati e rimossi in base alle esigenze. Per un'implementazione pratica, consulta il tutorial sullo sviluppo basato su branch di Databricks.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.