Database per agenti AI: 5 criteri di valutazione
Scopri i 5 criteri per valutare un database per agenti AI: isolamento dei branch, scalabilità serverless, ricerca ibrida, garanzie ACID e accesso unificato.
- Gli agenti AI hanno bisogno di un database che supporti letture e scritture continue e simultanee su più tipi di memoria, anziché il modello a singola richiesta alla volta utilizzato dalle app tradizionali.
- Cinque criteri definiscono un database per agenti pronto per la produzione: isolamento dei branch per singolo agente, computazione scale-to-zero, ricerca ibrida in una singola query, garanzie ACID in regime di concorrenza e una piattaforma unificata senza latenza ETL.
- Lakebase di Databricks soddisfa ciascun criterio, con convalide nel mondo reale da parte di Superhuman ed easyJet.
I cinque criteri per valutare un database per gli agenti AI sono l'isolamento dei branch, la scalabilità serverless, la ricerca ibrida, le garanzie ACID e l'accesso a una piattaforma unificata. Insieme, questi criteri aiutano gli sviluppatori e i team di dati a stabilire se un database è in grado di supportare gli agenti nel passaggio dai prototipi alla produzione, quando iniziano a gestire attività simultanee, dati operativi in tempo reale e stato persistente.
Un database per agenti AI è un sistema progettato per memorizzare lo stato, la memoria, i risultati degli strumenti e i dati operativi di cui un agente ha bisogno per completare attività in più passaggi e sessioni. A differenza di un database al servizio di un'applicazione convenzionale, deve supportare letture e scritture ripetute, attività simultanee degli agenti, il recupero tra diversi tipi di memoria e l'accesso a dati operativi aggiornati.
L'ascesa degli agenti AI rende questi requisiti ancora più importanti. Quando gli sviluppatori eseguono agenti di codifica, agenti di assistenza clienti o piattaforme multi-tenant, gli agenti fanno molto di più che recuperare informazioni. Scrivono lo stato, riprendono le attività, coordinano le chiamate agli strumenti e agiscono su dati operativi in continua evoluzione. Quando i team di dati portano gli agenti in produzione, i limiti del database possono causare memoria obsoleta, conflitti di scrittura, latenza e costi di calcolo non necessari.
Perché un database per agenti AI è un problema diverso
Un agente pronto per la produzione deve ricordare ciò che ha già fatto, riprendere un'attività da dove l'aveva interrotta e acquisire il contesto corretto prima di agire. Se lo si associa al database sbagliato, quella memoria può diventare obsoleta, incompleta o incoerente.
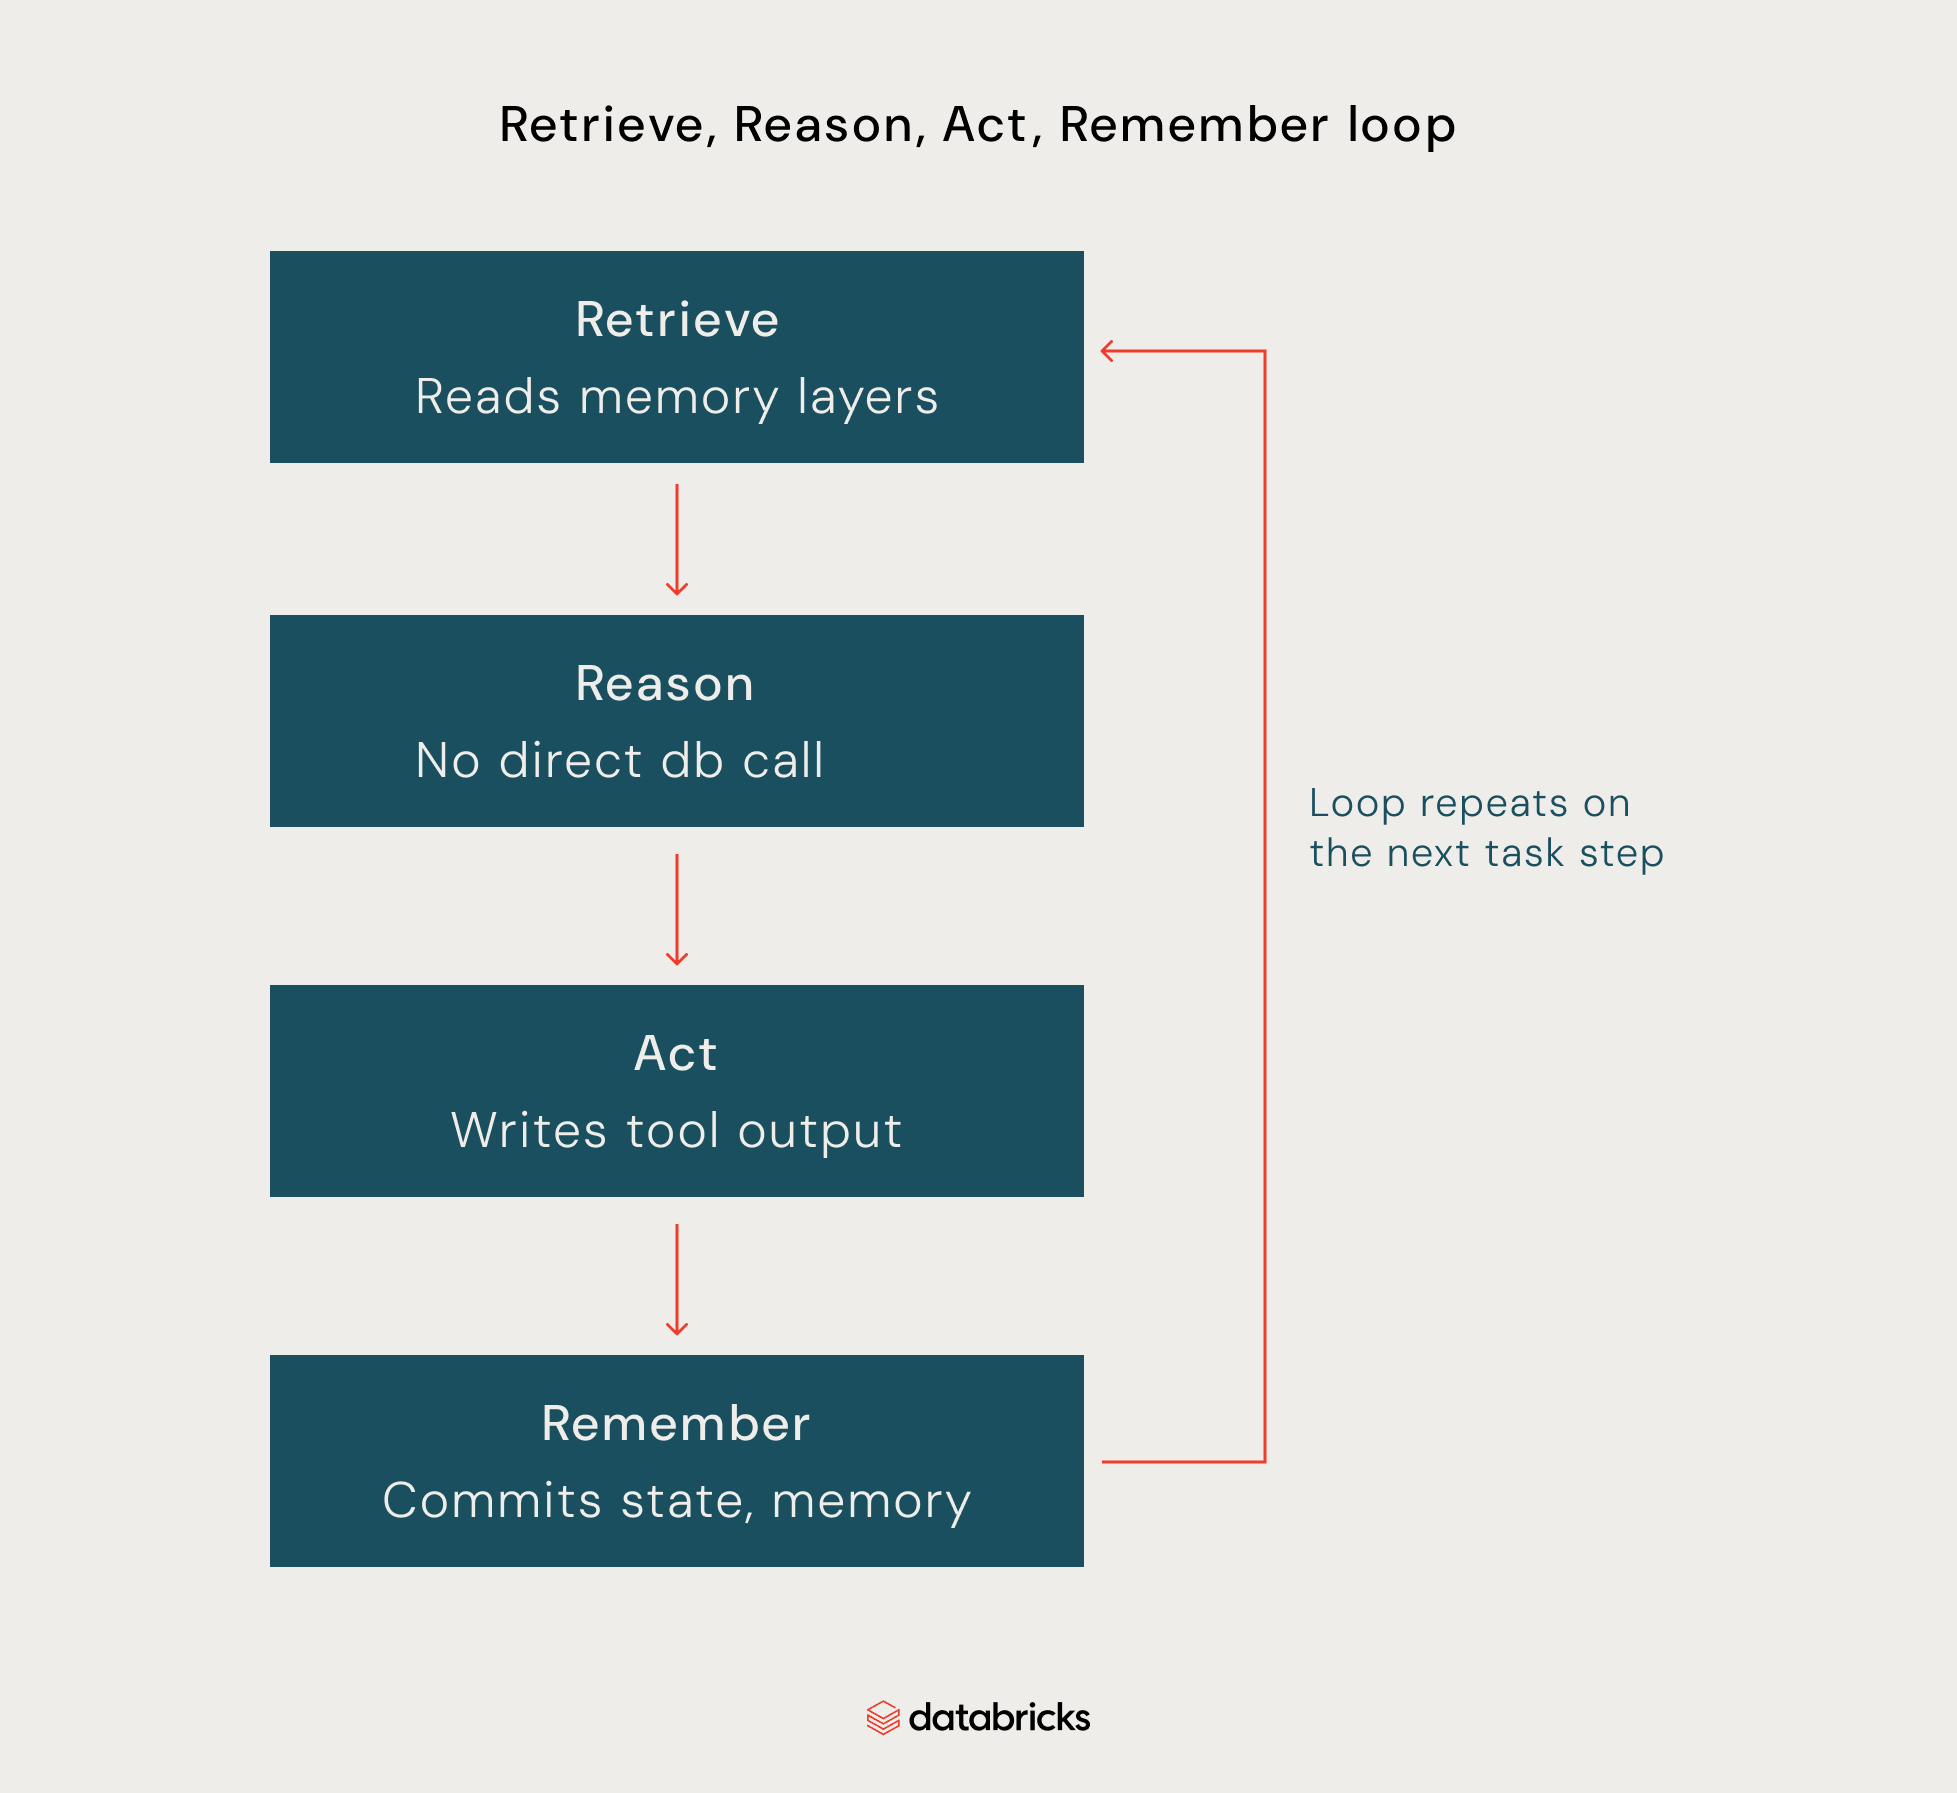
Per riuscirci, gli agenti in produzione si affidano a quattro livelli di memoria:
- Memoria a breve termine: la memoria di lavoro nel contesto disponibile durante l'interazione corrente, inclusi i messaggi recenti, le informazioni recuperate e i risultati degli strumenti.
- Memoria episodica: interazioni passate che consentono a un agente di ricordare conversazioni precedenti, preferenze dell'utente e attività completate.
- Memoria procedurale: i flussi di lavoro, le definizioni degli strumenti e le istruzioni che guidano l'esecuzione delle attività, indipendentemente dal fatto che siano memorizzati esternamente o integrati nel modello.
- Stato operativo: lo stato in tempo reale dell'attività, inclusi i passaggi completati e in sospeso, i risultati degli strumenti e i checkpoint per riprendere il lavoro in un secondo momento.
Si tratta di un carico di lavoro più complesso rispetto a quello di una tipica applicazione, che invia una query al database e passa oltre. La maggior parte dei database di produzione sono database operativi, chiamati anche sistemi di elaborazione delle transazioni online (OLTP), costruiti attorno allo stesso modello di una richiesta alla volta. Un agente non funziona così. Esegue letture su letture e scritture su scritture all'interno di una singola attività, senza pause umane tra l'una e l'altra, mentre centinaia di altri agenti fanno la stessa cosa.
I 5 criteri per valutare qualsiasi database per i carichi di lavoro degli agenti AI
Quando si seleziona un database per agenti AI, diversi criteri sono importanti, ma questi cinque sono quelli che vale la pena valutare indipendentemente dal fornitore preso in considerazione, gestito o self-hosted.
Branch per agente: test sicuri su dati reali
Testare un agente solo su dati sintetici è come testare un sistema di assistenza con una manciata di account cliente formattati alla perfezione. Potrebbe comportarsi esattamente come previsto, ma gli account reali sono sempre più disordinati. I team di dati finiscono per imbattersi in campi mancanti, record incoerenti, dati obsoleti e casi limite che non sono mai stati inclusi nei loro test case.
Ecco perché consigliamo di considerare i test isolati su dati reali come un criterio di valutazione del database. L'obiettivo è far sì che l'agente lavori con uno stato simile a quello di produzione, senza consentirgli di modificarlo. Un modo per ottenere questo isolamento è il branching zero-copy, che consente agli sviluppatori di creare un ambiente separato senza dover mantenere una seconda copia completa del database.
Lakebase Projects è progettato per gestire questo tipo di sviluppo e test isolati, consentendo agli sviluppatori di creare branch dai dati di produzione senza copiare i dati sottostanti. La creazione del branch di un database di produzione su scala terabyte richiede circa un secondo, senza costi di archiviazione aggiuntivi finché il branch non diverge dal genitore.
Scale to zero: come i prezzi serverless cambiano l'economia degli agenti
Il 27% della spesa cloud viene sprecato ogni anno, e le risorse di calcolo inattive e sottoutilizzate ne sono costantemente la causa principale. I database degli agenti ne sono un chiaro esempio. La maggior parte degli agenti non viene eseguita continuamente. Si attivano, eseguono un'attività, scrivono i risultati e poi rimangono inattivi fino alla richiesta successiva. Pagare per risorse di calcolo dedicate 24 ore su 24 significa pagare per lo stesso problema di calcolo inattivo per ogni database di agenti eseguito da un team.
Un modello serverless scale-to-zero risolve questo problema sospendendo il calcolo dopo un periodo senza connessioni attive e riprendendolo all'avvio di un nuovo lavoro. In questo modo, i costi seguono l'effettivo utilizzo anziché il tempo di inattività. Tuttavia, la velocità di avvio è importante tanto quanto il risparmio. Un agente che attende 20 o 30 secondi per l'attivazione del proprio database non è pratico, soprattutto quando risponde a un utente o attende la chiamata successiva a uno strumento.
Lakebase utilizza questo modello per Postgres, con il ripristino del calcolo entro poche centinaia di millisecondi da una nuova query. Ciò riduce il ritardo di avvio a tal punto da consentire allo scale-to-zero di funzionare con carichi di lavoro interattivi degli agenti.
Ricerca ibrida: recupero in tutti e quattro i livelli di memoria in un'unica query
La sola ricerca vettoriale è come un bibliotecario che sa cercare solo in base a "ciò che sembra simile", mai in base a una collocazione esatta. Chiedigli di trovare documenti sull'architettura dei database e se la caverà bene. Chiedigli il record con ID account 48291 e non avrà un modo affidabile per trovarlo. La somiglianza semantica non è progettata per corrispondenze esatte.
Questo è il divario in cui si imbattono molte pipeline di generazione aumentata dal recupero (RAG) quando si affidano solo alla ricerca vettoriale. La ricerca ibrida lo colma combinando somiglianza vettoriale, corrispondenza delle parole chiave e filtraggio dei metadati in un'unica query, invece di unire i risultati provenienti da sistemi separati. Se si suddivide questo processo tra un indice vettoriale e un archivio relazionale, l'agente effettua due chiamate anziché una. I sistemi possono desincronizzarsi e ogni passaggio aggiuntivo aggiunge una latenza che il ciclo di un agente non sempre può assorbire. Il recupero deve avvenire ben al di sotto dei 100 millisecondi per rimanere utilizzabile all'interno di un ciclo di ragionamento serrato.
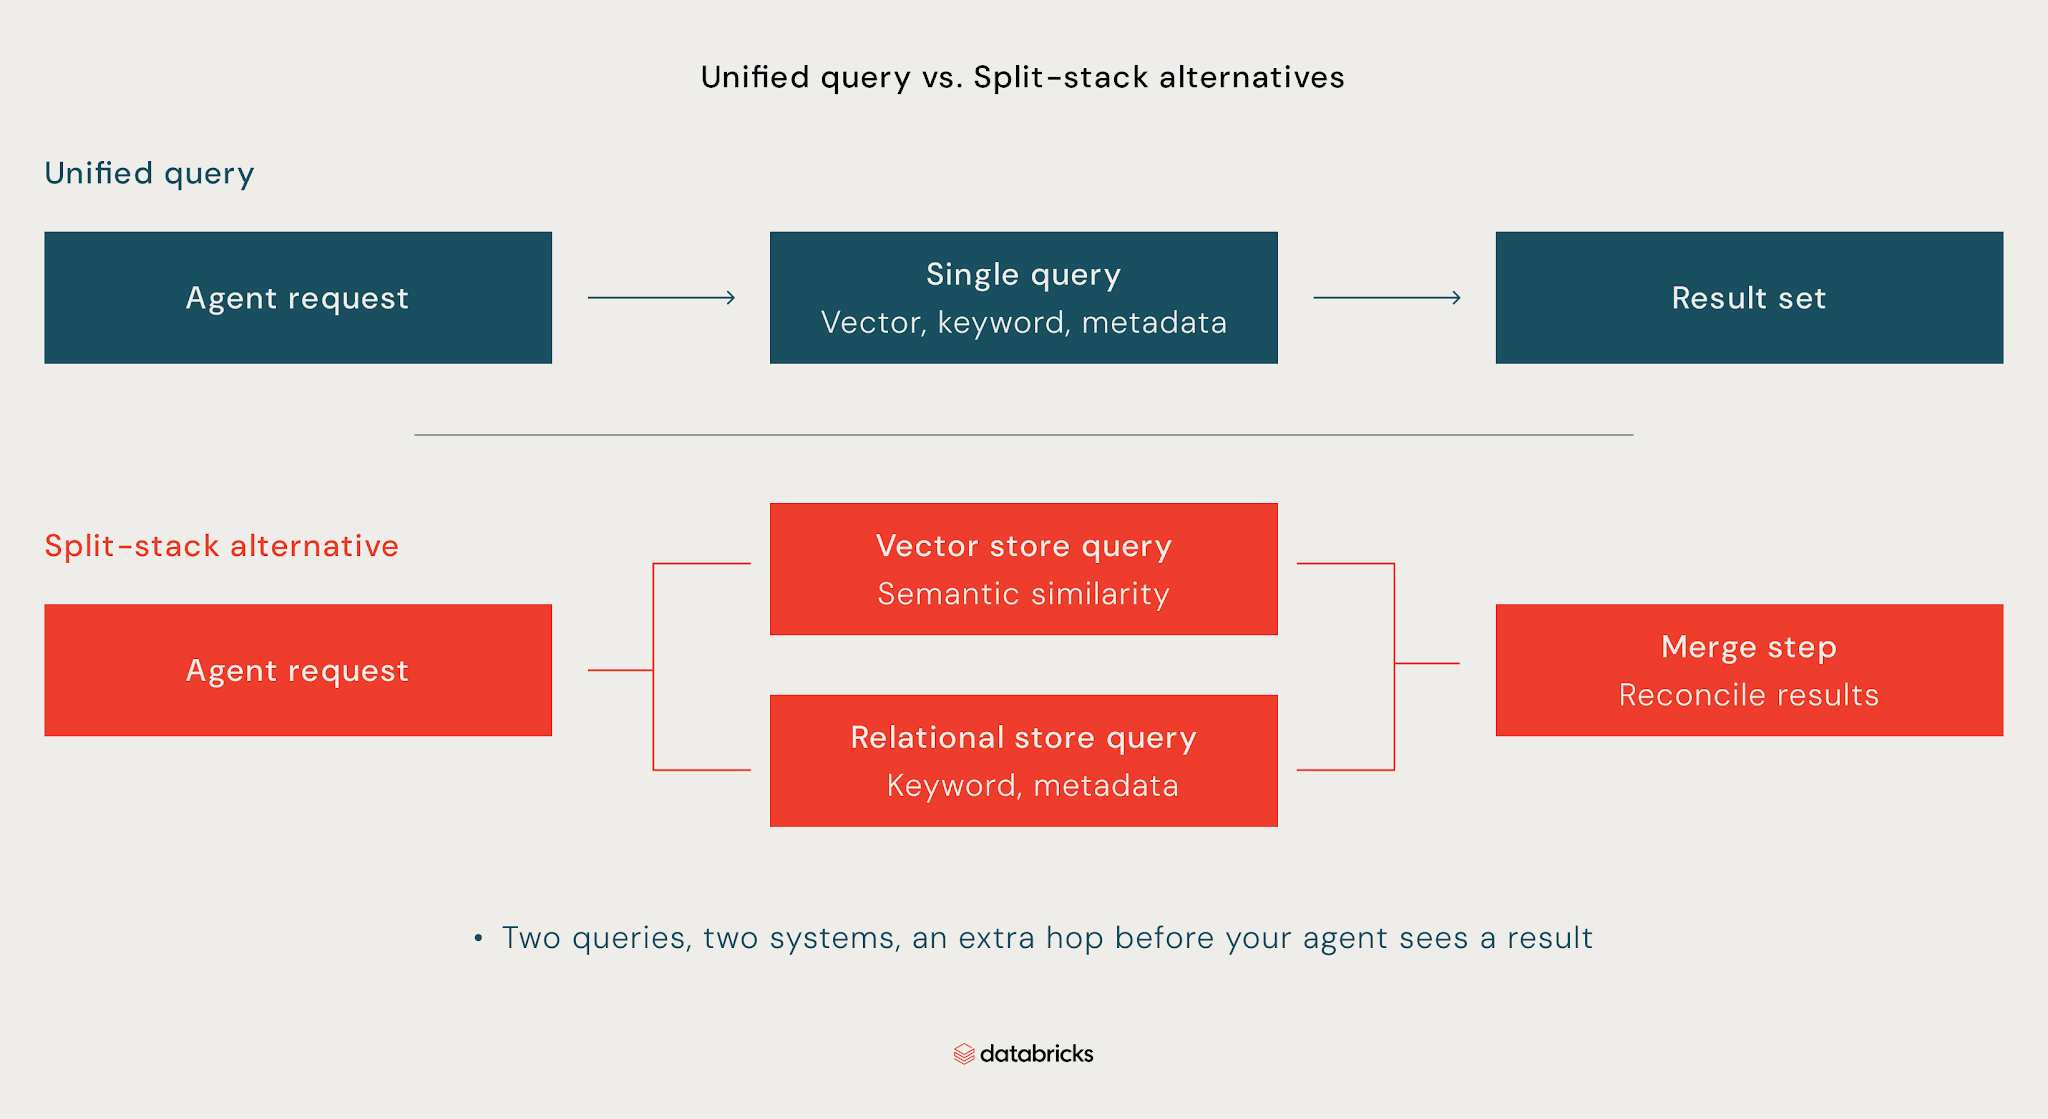
Lakebase Search esegue query vettoriali, di parole chiave e di metadati sulle stesse tabelle Postgres in cui risiedono già i dati operativi, quindi non c'è un secondo sistema che rischia di desincronizzarsi. La sua architettura LTAP è ciò che mantiene aggiornati i dati, con prestazioni di scrittura fino a 5 volte più veloci rispetto a Postgres standard. Ciò significa che quanto appena scritto da un agente può essere disponibile per il recupero quasi immediatamente.
Garanzie ACID per sistemi multi-agente
Immagina due agenti di assistenza che aggiornano contemporaneamente lo stesso record cliente. Uno sta risolvendo un problema di fatturazione e modificando il livello di abbonamento, mentre l'altro sta registrando un rimborso. Senza un adeguato isolamento, un aggiornamento può sovrascrivere l'altro, lasciando il record in uno stato che nessuno dei due agenti desiderava.
Ecco perché le garanzie transazionali dovrebbero essere un criterio fondamentale nella valutazione di un database per carichi di lavoro multi-agente. L'ACID offre agli sviluppatori quattro proprietà da verificare:
- Atomicità: una transazione viene completata interamente o per nulla.
- Coerenza: il database rimane valido prima e dopo ogni transazione.
- Isolamento: le transazioni simultanee non interferiscono con il lavoro reciproco in modi imprevisti.
- Durabilità: una scrittura confermata sopravvive a un arresto anomalo o a un riavvio.
Per i sistemi multi-agente, le domande pratiche contano più dell'acronimo. Il commit dell'output di uno strumento può avvenire in modo atomico, in modo che un'azione completata a metà non venga mai considerata completa? Cosa succede quando due agenti aggiornano lo stesso record? Quali livelli di isolamento supporta il database? Un agente può riprendere l'attività dopo un riavvio senza perdere lo stato confermato?
Quando si confrontano i database, consigliamo di verificare i livelli di isolamento e la semantica dei commit effettivamente supportati, e non solo se dichiarano di "supportare le transazioni". Una volta che più agenti condividono i dati operativi, sono questi dettagli a determinare se il lavoro simultaneo rimane prevedibile.
Piattaforma unificata: dati operativi nello stack AI senza ETL
Un agente che attende l'allineamento di una pipeline prende decisioni su dati obsoleti. Quando la pipeline viene eseguita, il record su cui sta agendo potrebbe essere già cambiato di nuovo. Quando si valuta un database, occorre considerare quanto strettamente colleghi i dati operativi con i sistemi di analisi e AI che dipendono da essi.
Una piattaforma unificata mantiene le scritture operative e le letture analitiche sugli stessi dati, senza una pipeline di estrazione, trasformazione e caricamento (ETL) separata tra di esse. I tuoi agenti possono lavorare con dati aggiornati, mentre i tuoi modelli possono utilizzare risultati in tempo reale invece di attendere un job batch. I team di dati mantengono anche la governance e i percorsi di audit nella stessa piattaforma, anziché spostare i carichi di lavoro degli agenti in un sistema separato più difficile da tracciare. Unity Catalog è ciò che applica questo livello di governance sia ai dati operativi che a quelli analitici in Databricks. L'esperienza di Superhuman mostra come si presenta questo scenario nella pratica: la sostituzione delle pipeline di sincronizzazione personalizzate verso un livello di caching e un archivio NoSQL gestito con una piattaforma unificata ha ridotto i tempi di integrazione dei dati da quasi tre mesi a circa due settimane.
easyJet ha adottato un approccio simile nel suo stack di gestione dei ricavi. Da quando è passata a Lakebase, la compagnia aerea ha acquisito attività di prenotazione e tariffazione in tempo reale insieme all'analisi sugli stessi dati del lakehouse, ha consolidato più di 100 repository Git in due e ha ridotto i cicli di sviluppo delle app da sei-nove mesi a circa quattro.
Lakebase mantiene i dati operativi nel lakehouse di Databricks, in modo che gli stessi dati possano supportare carichi di lavoro transazionali e analisi a valle senza una pipeline ETL separata.
Il playbook sull'AI agentiva per l'enterprise

Scheda di valutazione del database per agenti AI
Sottoponi qualsiasi candidato a questi cinque controlli e saprai in pochi minuti dove regge e dove no, indipendentemente dal vendor che stai confrontando.
| Criterio | Cosa testare | Soglia minima | Segnali d'allarme | Comportamento di Lakebase |
|---|---|---|---|---|
| Branch per agente | È possibile creare un branch isolato a partire da dati di produzione reali senza effettuare una copia completa? | La creazione del branch si completa in pochi secondi, non in minuti | Richiede una copia completa del database o richiede più tempo del ciclo di test | Crea branch di un database su scala terabyte in circa un secondo, senza costi di archiviazione fino a quando non diverge |
| Scalabilità a zero | La risorsa di calcolo si sospende dopo un periodo di inattività e si riavvia abbastanza rapidamente da rimanere utilizzabile? | La risorsa di calcolo si riavvia in meno di un secondo, senza passaggi di riattivazione manuale | L'avvio a freddo richiede più di 10 secondi o i database inattivi continuano a essere fatturati a tariffa piena | Si riattiva entro poche centinaia di millisecondi e non addebita nulla durante la sospensione |
| Ricerca ibrida | Una singola query può combinare somiglianza vettoriale, corrispondenza di parole chiave e un filtro strutturato? | Query singola, inferiore a 100 ms | Richiede chiamate separate a un vector store e a un archivio relazionale, quindi un'unione manuale | Esegue query vettoriali, di parole chiave e di metadati sulle stesse tabelle Postgres |
| Garanzie ACID | Due agenti possono scrivere sullo stesso record contemporaneamente senza perdere nessuna delle due scritture? | Nessuna scrittura persa; l'isolamento regge sotto carico simultaneo | Sovrascritture silenziose o isolamento che si degrada in caso di concorrenza | Garanzie transazionali Postgres standard, non influenzate dal carico simultaneo degli agenti |
| Piattaforma unificata | Quanto tempo impiega una nuova scrittura a diventare disponibile per l'analisi? | Nessun passaggio ETL o latenza misurata in secondi, non in ore | Richiede una pipeline pianificata prima che i dati siano interrogabili altrove | Ogni scrittura diventa interrogabile nel lakehouse di Databricks senza una pipeline separata |
Un database che non supera più di una di queste soglie minime rappresenta un rischio per la produzione una volta che si eseguono agenti su scala, non solo un piccolo compromesso che si può aggirare in seguito.
Conclusioni
La scelta di un database per agenti AI si riduce all'adeguatezza al carico di lavoro, non all'elenco delle funzionalità. I cinque criteri di questa guida offrono a sviluppatori e team di dati un framework pratico per valutare qualsiasi database prima di implementarlo in produzione. Se un candidato non soddisfa questi requisiti oggi, gli agenti in produzione finiranno per evidenziare le lacune man mano che gestiscono più utenti, più attività e più lavoro simultaneo.
Se stai valutando un database per agenti AI, esplora Lakebase per vedere come Databricks supporta carichi di lavoro transazionali, branching, scalabilità serverless, ricerca ibrida e accesso unificato ai dati operativi.
Domande frequenti
Gli agenti AI hanno bisogno di un database?
Sì. La maggior parte delle implementazioni di agenti non conserva il contesto a breve termine, la cronologia episodica, la conoscenza procedurale o lo stato delle attività in tempo reale tra le chiamate, a meno che non vengano esplicitamente salvati e ricaricati. Senza un database di supporto, l'agente in genere perde quel contesto nel momento in cui termina una sessione e non può riprendere un'attività da dove l'aveva interrotta.
Un database vettoriale è sufficiente per gli agenti AI?
Non da solo. Un database vettoriale gestisce bene il recupero semantico, ma l'agente deve anche scrivere e aggiornare lo stato operativo, garantire l'integrità transazionale tra scritture simultanee e filtrare su campi strutturati che una ricerca per somiglianza non è in grado di rilevare in modo affidabile. La ricerca semantica copre solo una parte di ciò di cui un agente ha bisogno, non l'intero carico di lavoro.
Qual è il miglior database per la RAG negli agenti AI?
Non esiste un'unica risposta corretta. Per la RAG negli agenti AI, il miglior database è quello in grado di eseguire una ricerca ibrida in una sola query, mantenere il recupero abbastanza veloce per il ciclo dell'agente e rimanere sufficientemente aggiornato da evitare una memoria obsoleta.
In che modo i sistemi multi-agente modificano i requisiti del database?
Quando più agenti scrivono contemporaneamente su dati condivisi, l'integrità transazionale smette di essere opzionale. Il database deve isolare le scritture simultanee in modo che l'aggiornamento di un agente non sovrascriva silenziosamente quello di un altro, e deve eseguire il commit degli output degli strumenti in modo atomico, in modo che un'azione completata a metà non venga mai considerata come completata.
Qual è la differenza tra OLTP e OLAP per gli agenti AI?
Le azioni in tempo reale dell'agente, la scrittura degli output degli strumenti, l'aggiornamento dello stato e il checkpointing dei progressi sono carichi di lavoro OLTP. La reportistica e l'addestramento dei modelli su tali dati sono carichi di lavoro OLAP. Gli agenti in genere hanno bisogno di entrambi per lavorare sugli stessi dati senza una pipeline tra di essi. Ecco perché i criteri di questa guida si concentrano su database in grado di gestire sia il lavoro degli agenti ad alta intensità di transazioni sia le analisi a valle a partire dagli stessi dati.
Postgres è adatto per gli agenti AI?
Postgres standard fornisce solide garanzie ACID e un ecosistema maturo, coprendo parte di ciò di cui l'agente ha bisogno. Non fornisce di per sé branching zero-copy, calcolo scale-to-zero o accesso operativo e analitico unificato; questi aspetti dipendono dalla piattaforma creata attorno ad esso.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.