Postgres gestito: cosa ti risparmia effettivamente Lakebase
Scopri cosa automatizza effettivamente Lakebase nel Postgres gestito — applicazione di patch, scalabilità, failover e backup — e quali responsabilità rimangono a tuo carico.
- Postgres gestito dovrebbe sollevare il team del database dalle operazioni di routine come l'applicazione di patch, la scalabilità, il failover e i backup.
- Lakebase esegue PostgreSQL su un'infrastruttura serverless con scalabilità automatica, scale-to-zero, point-in-time recovery, branching, pgvector e PostGIS.
- Lakebase gestisce la maggior parte delle operazioni di Postgres gestito all'interno di una regione, mentre il disaster recovery cross-region richiede ancora procedure di ripristino gestite dal cliente.
Ogni fornitore di Postgres si definisce "gestito". Pochi di essi concordano su ciò che questo termine copra. Alcuni intendono che applicano le patch al sistema operativo (OS) e lasciano il resto al team del database. Altri intendono che il database si scala, gestisce i guasti ed esegue il backup autonomamente senza che nessuno nel team debba toccare un file di configurazione.
Il Postgres gestito è un servizio di database in cui il fornitore gestisce l'infrastruttura sottostante e si occupa delle operazioni principali del database, come l'applicazione di patch, la scalabilità, il failover e i backup, in modo che il team del database dedichi meno tempo alla manutenzione e più tempo alla creazione dell'applicazione che vi viene eseguita sopra. Più operazioni sono a carico del fornitore, meno amministrazione del database rimane al cliente.
Questa distinzione diventa ancora più importante con il passaggio di Postgres alle applicazioni di AI. Il database può ora contenere lo stato dell'applicazione, la cronologia delle conversazioni, gli embedding e i dati degli agenti insieme ai tradizionali carichi di lavoro transazionali, quindi la superficie operativa si estende oltre il semplice mantenimento in funzione del database.
Lakebase Postgres applica questo approccio gestito al Postgres serverless, combinando scalabilità automatica, compatibilità con PostgreSQL, ripristino e integrazioni con Databricks. La domanda è quanto lavoro operativo elimini effettivamente.
TL;DR
- Il Postgres gestito dovrebbe sollevare il team del database dalle operazioni di routine come l'applicazione di patch, la scalabilità, il failover e i backup.
- Lakebase esegue PostgreSQL su un'infrastruttura serverless con scalabilità automatica, scale-to-zero, snapshot automatici, point-in-time recovery, branching e supporto per estensioni popolari come pgvector e PostGIS.
- Lakebase gestisce la maggior parte delle operazioni di Postgres gestito all'interno di una region.
Cosa significa effettivamente Postgres gestito
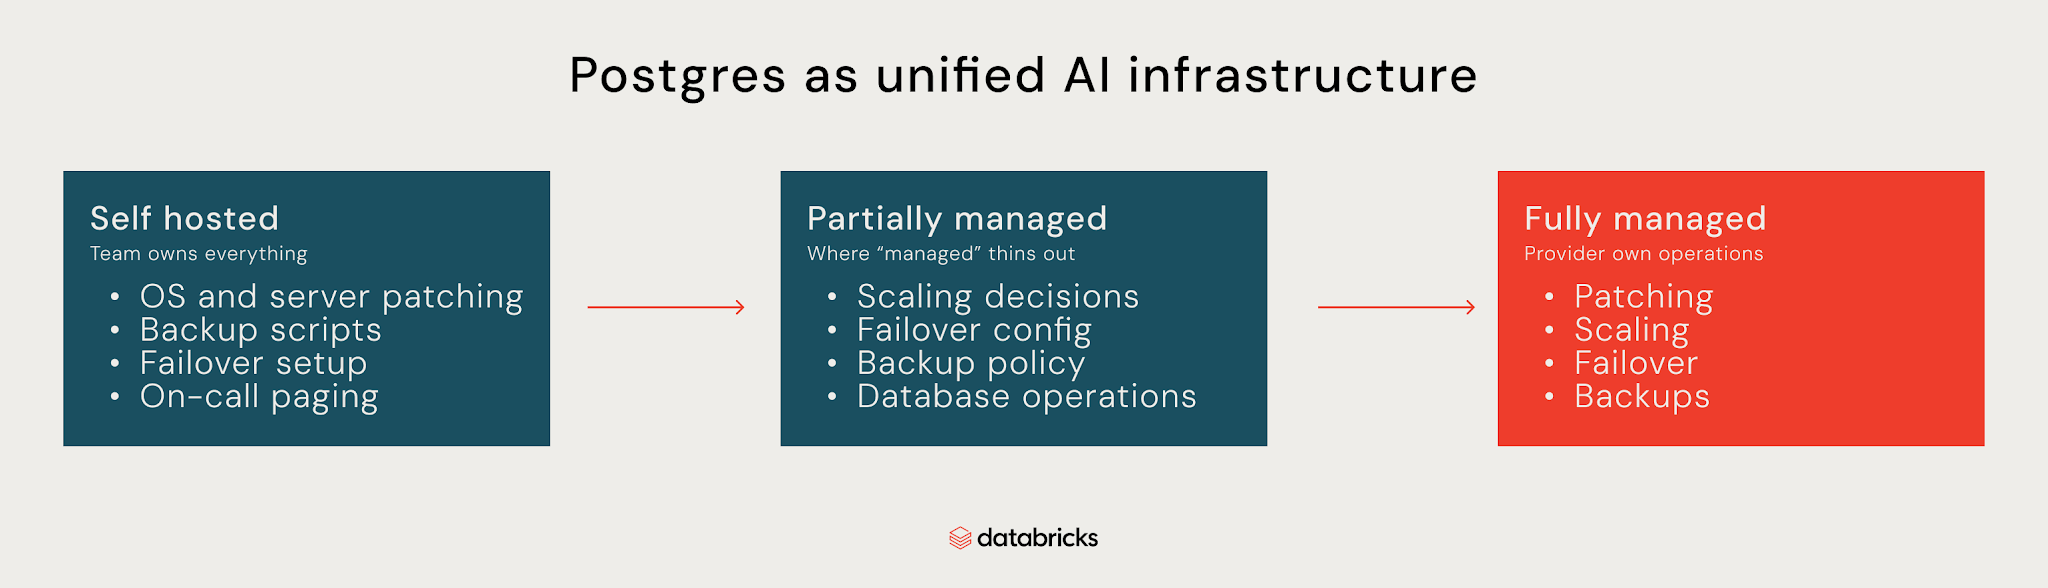
Pensa al Postgres gestito come alla consegna delle chiavi di un database. La quantità di responsabilità che un team affida dipende dal fornitore. Da un lato, il team del database gestisce ancora il server, i backup, il failover e la scalabilità. Dall'altro, un servizio completamente gestito si fa carico del lavoro operativo per il team, non solo dell'infrastruttura sottostante. La maggior parte dei fornitori si colloca in una via di mezzo, gestendo la VM e la rete e lasciando al team alcune operazioni del database, le decisioni di scalabilità, la configurazione del failover e le policy di backup.
Un fornitore può applicare patch all'OS e definire il database come gestito, mentre il team rimane comunque responsabile del lavoro necessario a mantenerlo disponibile e ripristinabile.
L'applicazione di patch, la scalabilità, il failover e i backup sono un buon punto in cui tracciare questa linea. Un servizio gestito determina anche quanta parte della sicurezza, del ripristino, della migrazione, dei carichi di lavoro di AI e degli strumenti di sviluppo relativi a Postgres debba rimanere sotto la responsabilità del tuo team.
Il Postgres gestito è un servizio in cui il fornitore gestisce l'infrastruttura del database e si occupa delle attività operative principali come l'applicazione di patch, la scalabilità, il failover e i backup. Un servizio completamente gestito si assume la responsabilità di queste operazioni, consentendo al tuo team di concentrarsi sullo sviluppo con Postgres anziché sulla sua gestione.
Cosa dovrebbe gestire il Postgres gestito
La prova più evidente di dove si collochi un servizio in questo spettro è se solleva o meno il team da queste quattro attività operative:
Manutenzione e applicazione di patch
Un fornitore gestito dovrebbe applicare le patch dell'OS, le versioni secondarie di PostgreSQL ed eseguire la manutenzione ordinaria come il vacuum tuning senza che il team del database debba pianificare o eseguire nulla manualmente, al contrario del Postgres self-hosted, in cui tutto questo è a carico del team. Gli aggiornamenti delle versioni principali richiedono comunque una pianificazione, poiché le estensioni e il comportamento dell'applicazione possono cambiare, ma un buon fornitore riduce al minimo questo coinvolgimento e rende chiaro il percorso di aggiornamento.
Scalabilità
La capacità dovrebbe adattarsi al carico di lavoro senza che i platform engineer debbano ridimensionare manualmente l'infrastruttura: scalabilità verticale per ottenere più potenza di calcolo o memoria, repliche di lettura per il traffico di lettura e, idealmente, una scalabilità serverless che elimini del tutto la necessità di decidere. L'autoscaling di Lakebase è un esempio in produzione, che consente scritture su Postgres 5 volte più veloci rispetto al Postgres standard. La vera prova è un picco di traffico: se il team del database sta monitorando l'utilizzo e aspettando un ridimensionamento, la scalabilità è ancora un loro compito.
Alta disponibilità e failover
Il database dovrebbe rimanere attivo in caso di guasto dell'infrastruttura, senza che un ingegnere reperibile debba promuovere manualmente una replica alle 2 del mattino. Alcuni fornitori gestiscono questo aspetto con istanze di standby che subentrano automaticamente; altri, come Lakebase, sostituiscono direttamente l'istanza di calcolo guasta poiché non contiene alcuno stato locale persistente. Tuttavia, non tutti i fornitori eseguono il failover alla stessa velocità o con la stessa perdita di dati. Alcuni perdono secondi di scritture nel processo; altri non ne perdono affatto. Questo è il dettaglio che vale la pena verificare prima di fidarsi dell'etichetta, incluso se il failover esiste e cosa succede alle scritture in corso quando si attiva.
Backup e ripristino
I backup automatici e un processo di ripristino che i team possono eseguire senza aprire un ticket di supporto sono la base. Il point-in-time recovery (PITR) consente di ripristinare il database a un momento specifico invece che solo all'ultimo snapshot, il che è fondamentale quando una migrazione errata corrompe i dati a metà pomeriggio. L'interruzione di un'intera region è un problema più grande, misurato dal Recovery Time Objective (RTO), ovvero la durata del downtime, e dal Recovery Point Objective (RPO), ovvero la quantità di dati che ci si può permettere di perdere; un fornitore che non definisce i valori per entrambi non ha un piano di disaster recovery, ma solo un'ipotesi.
In che modo il Postgres gestito protegge i tuoi dati
Un database gestito dovrebbe crittografare i dati a riposo e in transito, controllare chi può accedervi e offrire ai data team visibilità sulle attività del database. Ciò significa:
- Crittografia: I dati devono essere protetti a riposo e in transito, sul disco e durante il trasferimento tra l'applicazione e il database. Il dettaglio da verificare è chi controlla le chiavi, poiché alcuni fornitori gestiscono la crittografia interamente dal loro lato, il che diventa un problema nel momento in cui un requisito di conformità o una policy interna stabilisce che l'organizzazione debba possederle. Le chiavi gestite dal cliente (customer-managed keys) ti offrono questo controllo, lasciando al fornitore le operazioni del database sottostante.
- Controllo degli accessi: Il controllo degli accessi basato sui ruoli gestisce gli aspetti fondamentali, assegnando privilegi diversi a utenti e servizi differenti, ma i sistemi di produzione spesso richiedono di più, e i settori che gestiscono dati di pagamento devono inoltre soddisfare standard come il Payment Card Industry Data Security Standard (PCI DSS). Il controllo degli accessi basato sugli attributi tramite Unity Catalog estende ulteriormente queste policy prendendo in considerazione le proprietà dell'utente, della risorsa o della richiesta, anziché affidarsi esclusivamente ai ruoli.
- Audit logging: Senza visibilità su chi ha fatto cosa e quando, investigare su un incidente diventa più difficile, così come dimostrare la conformità. L'audit logging dovrebbe offrire ai data team visibilità sulle attività amministrative e del database per impostazione predefinita, senza che debbano configurarlo, gestirlo e mantenerlo come una pipeline separata sopra il database.
Cosa considerare quando si migra un database PostgreSQL esistente
Una migrazione può sembrare semplice finché il nuovo database non supporta un'estensione, una configurazione o una funzionalità di PostgreSQL da cui dipende un'applicazione. Verifica le dipendenze dell'applicazione prima di spostare qualsiasi cosa. Ecco gli aspetti chiave da considerare quando si migra un database PostgreSQL esistente:
- Compatibilità: Verifica se la configurazione attuale si comporta allo stesso modo sulla nuova piattaforma: supporto della versione di PostgreSQL, configurazioni personalizzate e presupposti a livello di applicazione che potrebbero non essere più validi una volta modificata l'infrastruttura. La compatibilità con il protocollo wire standard di Postgres significa che le stringhe di connessione esistenti, gli object-relational mapper (ORM), i driver e gli strumenti hanno un'ottima possibilità di funzionare senza modifiche al codice.
- Estensioni: La migrazione è il momento in cui i team scoprono se tutte le estensioni da cui dipende il database sono state trasferite correttamente, quindi verifica l'elenco di quelle supportate dal fornitore rispetto a quelle effettivamente in uso prima di impegnarti. Vale la pena verificare pgvector per i carichi di lavoro di AI o di embedding, PostGIS è importante per i dati geospaziali, e ogni altra estensione da cui dipende un'applicazione va verificata singolarmente anziché dare per scontato che sia presente solo perché è popolare.
- Metodi di migrazione: La migrazione basata su dump, ovvero l'esportazione e il ripristino sulla nuova piattaforma, è semplice e funziona per database di dimensioni ridotte o finestre di manutenzione pianificate. La replica logica mantiene attiva la sorgente mentre trasmette le modifiche alla destinazione, consentendo ai team di effettuare il passaggio con un'interruzione molto più breve una volta sincronizzati i due sistemi; la scelta giusta dipende dalle dimensioni del database, dal volume di scrittura e dalla quantità di downtime che l'azienda può tollerare.
- Validazione e cutover: Una migrazione non è completata solo perché i dati sono stati trasferiti. Esegui l'effettivo carico di lavoro delle query sul nuovo database e confronta i risultati e le prestazioni con la sorgente, poiché il semplice conteggio delle righe non è sufficiente; i piani di query, i tempi di risposta e il comportamento dell'applicazione devono essere tutti all'altezza. Pianifica il cutover pensando a un percorso di rollback, in modo che il team sappia come reindirizzare il traffico in caso di problemi, anziché doverlo capire nel bel mezzo di un incidente.
Il playbook sull'AI agentiva per l'enterprise

Postgres è adatto per le applicazioni AI?
Postgres può essere un'ottima soluzione per le applicazioni AI quando un'applicazione ha bisogno di uno stato transazionale e di una ricerca vettoriale nello stesso sistema. Questo si riduce a quattro elementi: pgvector come estensione che lo rende possibile, la ricerca vettoriale per il recupero, la memoria dei modelli linguistici di grandi dimensioni (LLM) per mantenere lo stato tra le richieste e i carichi di lavoro degli agenti che richiedono entrambi contemporaneamente.
pgvector
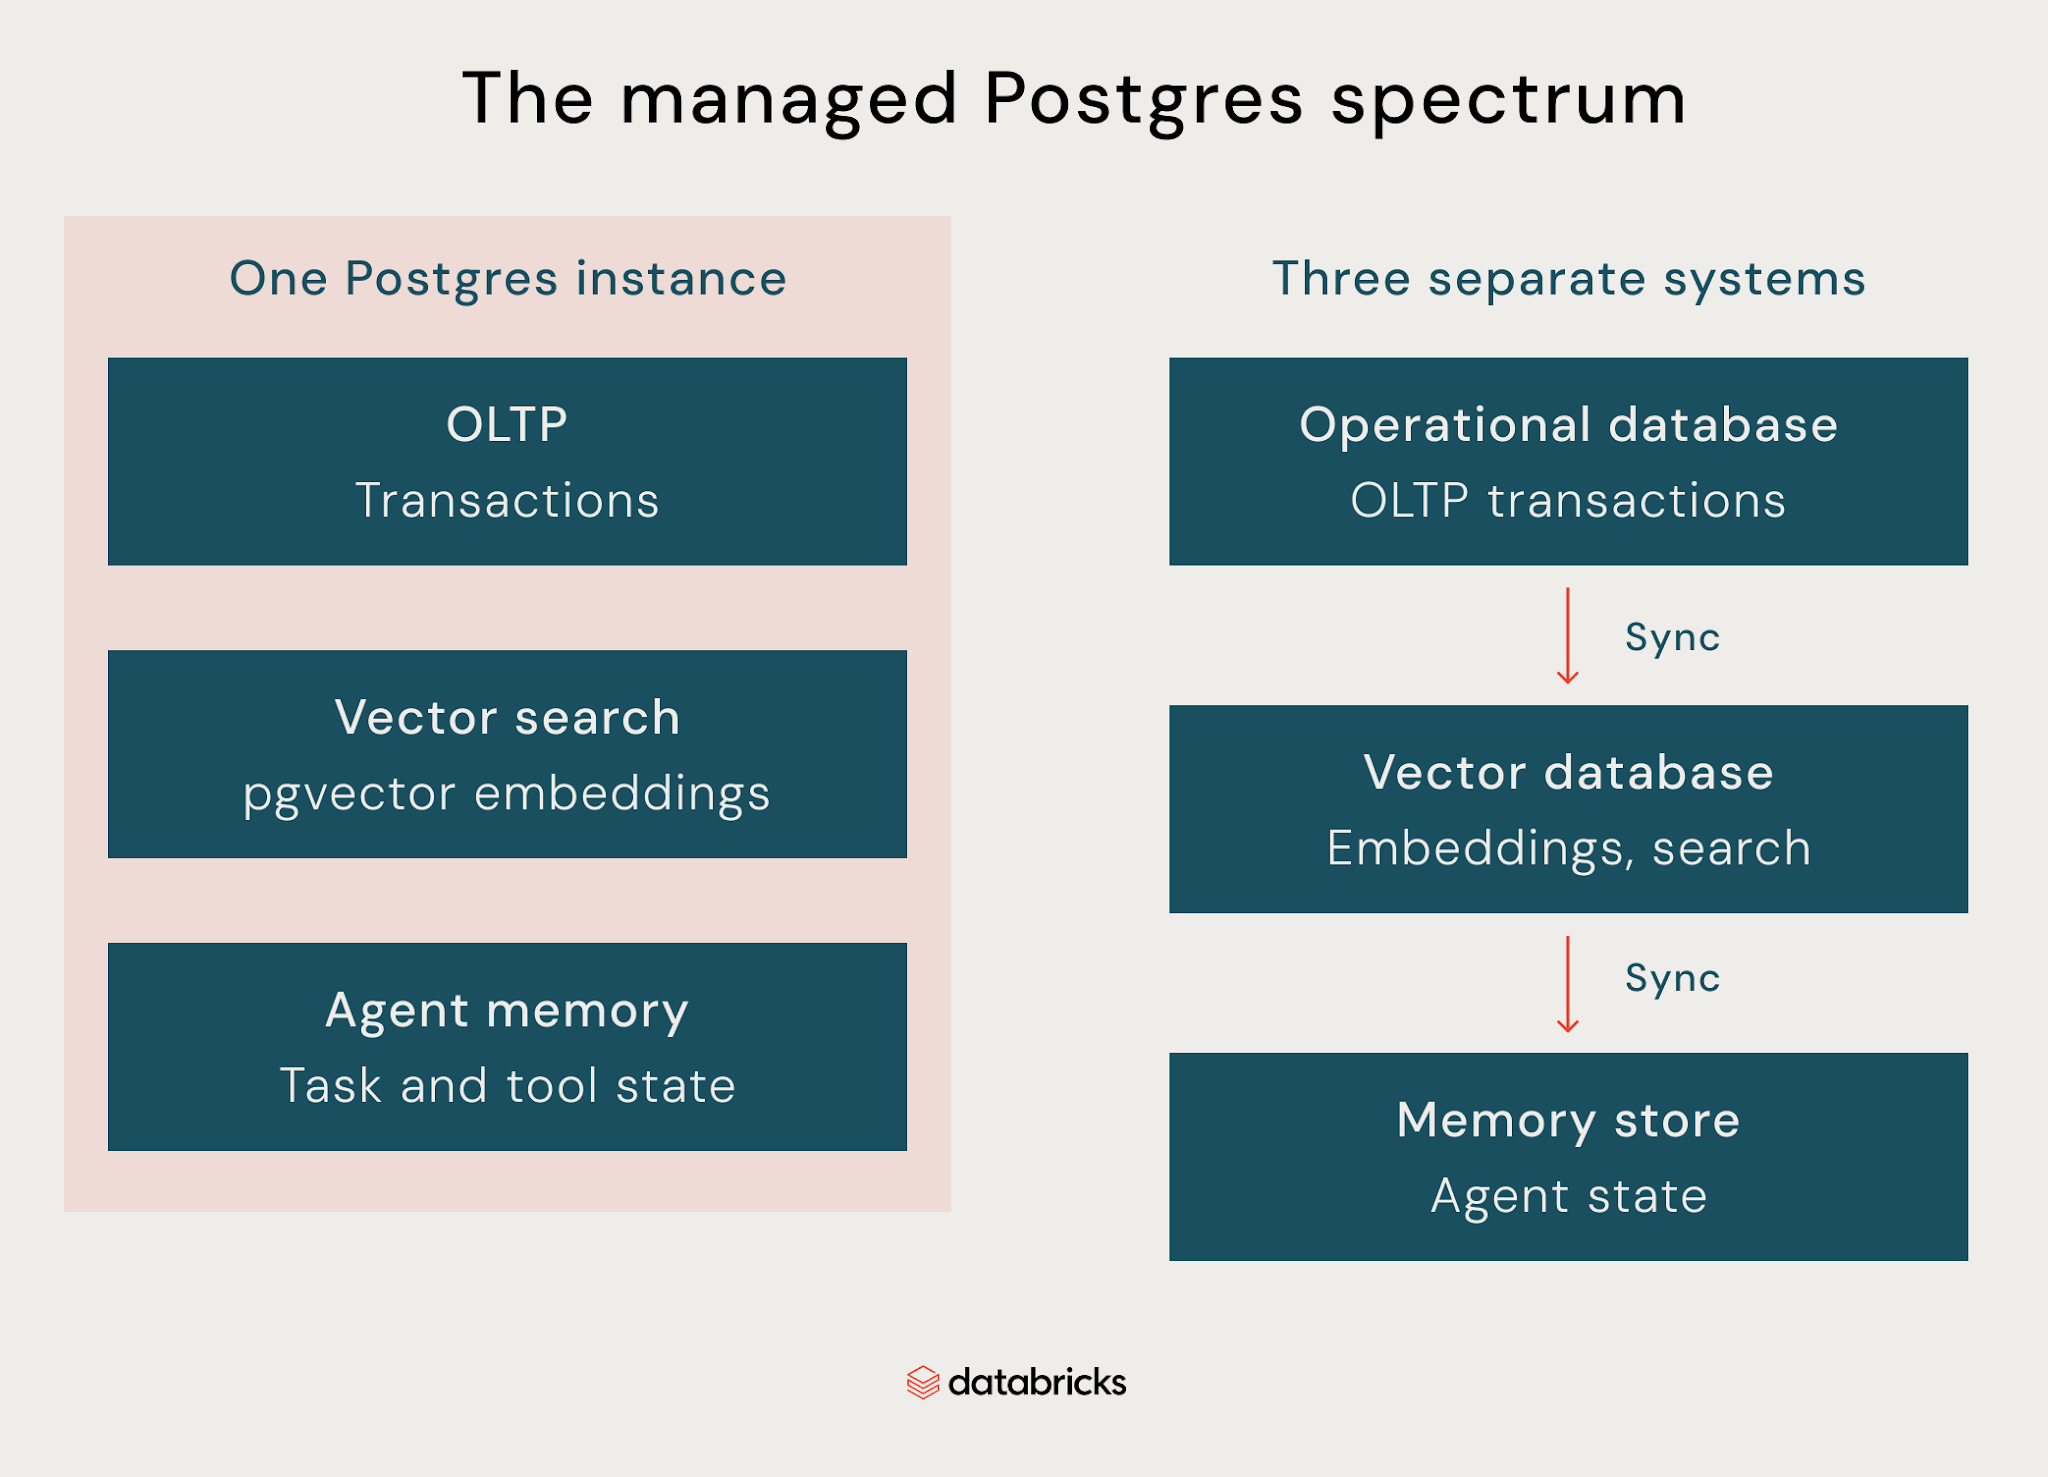
pgvector aggiunge un tipo di dati vettoriale e l'indicizzazione della ricerca di similarità direttamente all'interno di Postgres, in modo che gli embedding risiedano accanto al resto dei dati dell'applicazione anziché in un sistema separato. Il compromesso è che un database vettoriale separato comporta la necessità di mantenere sincronizzati gli embedding e i dati operativi, il che diventa un problema ingegneristico a sé stante; pgvector elimina questo problema per i carichi di lavoro che non richiedono un archivio vettoriale dedicato.
Ricerca vettoriale e ricerca semantica
pgvector consente di memorizzare gli embedding e utilizzare indici ANN (approximate nearest neighbor) per trovare vettori simili in modo efficiente man mano che il dataset cresce, rendendo possibili la ricerca semantica, la generazione aumentata dal recupero e la corrispondenza basata sul significato all'interno di Postgres. La giusta strategia di indicizzazione dipende comunque dalle dimensioni del dataset e dai pattern di query, quindi pgvector non elimina la necessità di valutare le prestazioni per il tuo carico di lavoro specifico.
Memoria LLM
Le applicazioni LLM hanno bisogno di un luogo in cui conservare lo stato tra le richieste, inclusi la cronologia delle conversazioni, le preferenze dell'utente, i documenti recuperati e i risultati degli strumenti. Postgres può memorizzare tale stato come normali dati relazionali, mentre pgvector gestisce gli embedding nello stesso database. Per i carichi di lavoro che richiedono un recupero vettoriale specializzato su larghissima scala, un database vettoriale dedicato potrebbe comunque avere senso, ma molte applicazioni AI possono mantenere uniti lo stato operativo e il recupero.
Carichi di lavoro degli agenti
Gli agenti leggono e aggiornano continuamente lo stato durante l'esecuzione. Tracciano le conversazioni, memorizzano i risultati intermedi e registrano le chiamate agli strumenti, il che rende il database parte del livello di esecuzione dell'agente, anziché solo un luogo da cui recuperare il contesto. Un database creato per i carichi di lavoro degli agenti AI deve supportare, in un unico sistema, sia lo stato transazionale in costante mutamento sia il recupero che l'agente utilizza per trovare il contesto pertinente.
Postgres per lo sviluppo di applicazioni
Oltre a eseguire i carichi di lavoro di produzione, Postgres deve supportare il modo in cui il tuo team sviluppa effettivamente. Ciò significa che le connessioni non diventano un collo di bottiglia durante la scalabilità e che testare le modifiche allo schema non comporta rischi per i dati di produzione.
Gestione delle connessioni
Postgres ha un limite finito sul numero di connessioni che può gestire contemporaneamente, e le istanze dell'applicazione che scalano orizzontalmente possono raggiungere tale limite prima che il calcolo o l'archiviazione diventino il collo di bottiglia. Il connection pooling riutilizza le connessioni al database stabilite per le varie richieste, invece di aprirne una nuova per ciascuna di esse. In un servizio gestito, ciò che conta è se il pooling è integrato o se è qualcosa che il tuo team deve gestire separatamente.
Branching del database
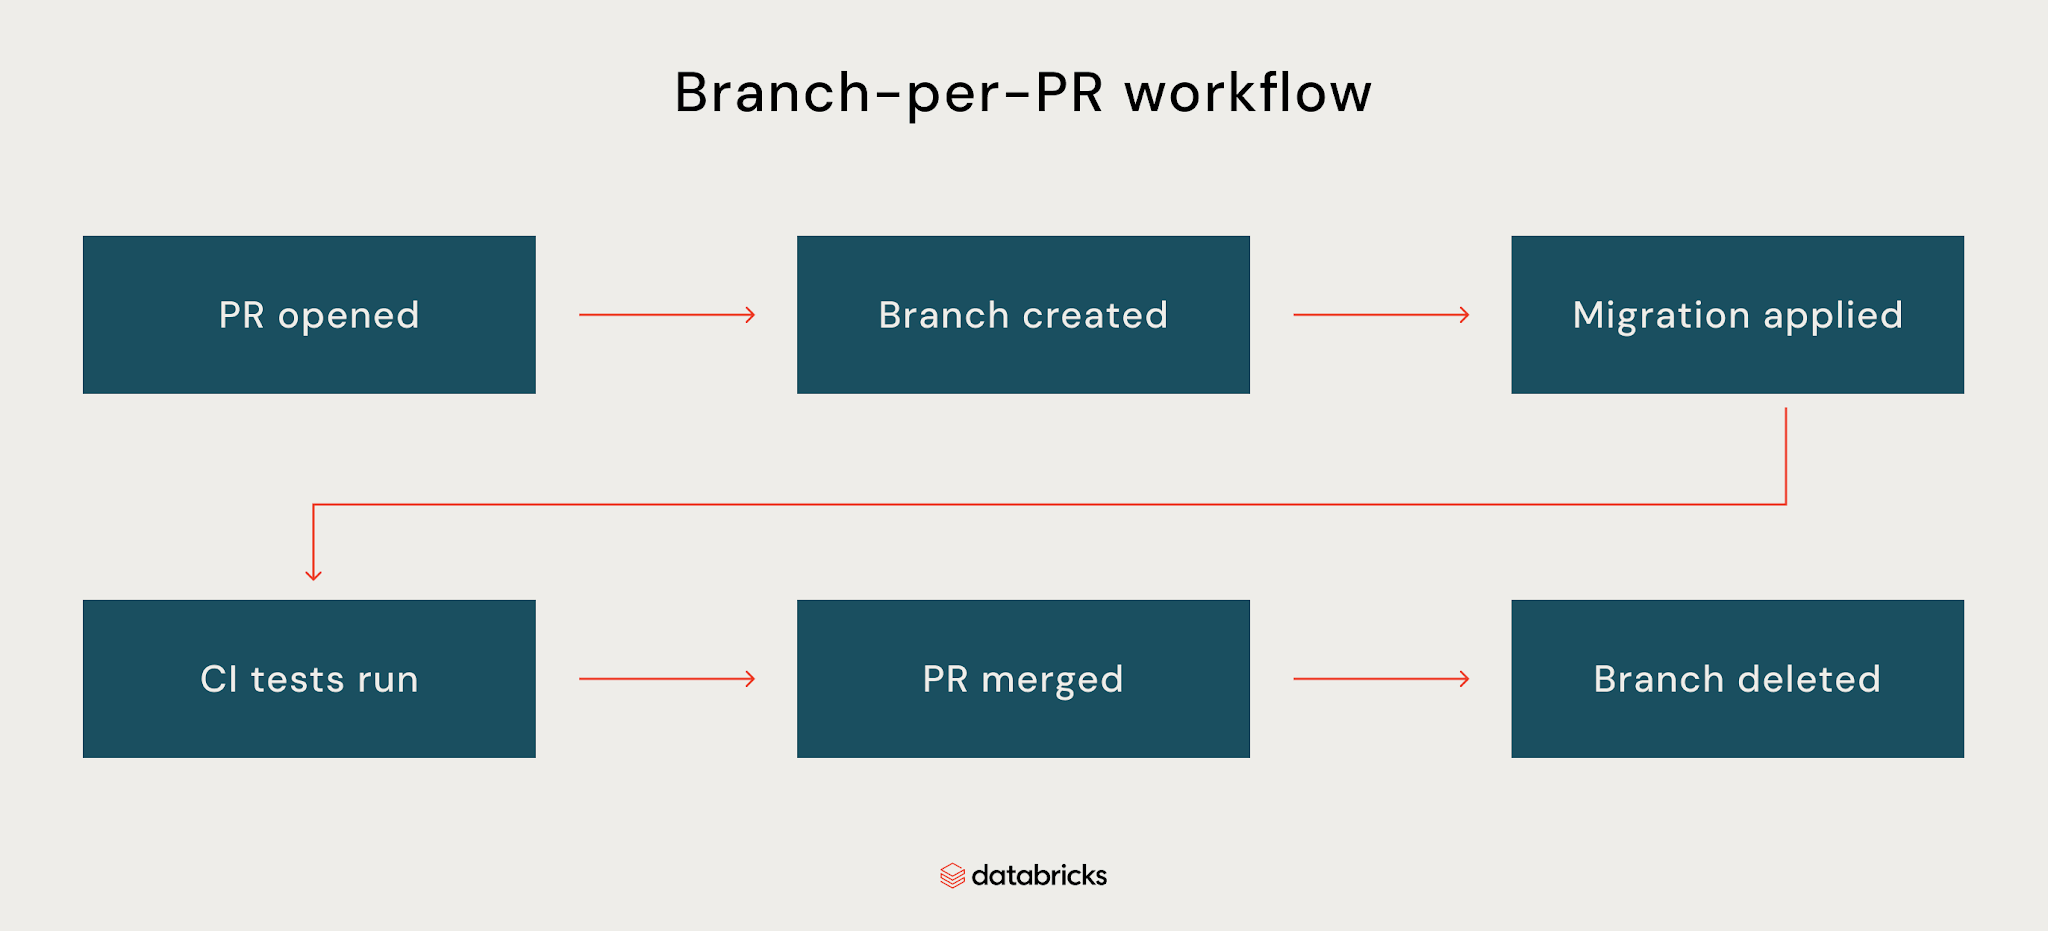
Testare le modifiche allo schema sui dati di produzione significa rischiare la produzione o dover mantenere un database di staging che nel tempo si disallinea. Il branching del database crea un ambiente isolato a partire dallo stato di un database esistente o da uno snapshot point-in-time, in modo che gli sviluppatori possano testare le migrazioni con dati realistici, lavorare secondo un approccio di sviluppo evolutivo del database ed eliminare il branch quando non è più necessario.
Perché scegliere Lakebase su Postgres gestito
L'approccio di Lakebase diventa più chiaro se confrontato con le attività principali che un Postgres gestito dovrebbe gestire:
- Serverless: Lakebase esegue PostgreSQL su calcolo serverless che scala automaticamente con la domanda, fino a zero quando è inattivo, eliminando la necessità di dimensionare un'istanza in anticipo o pagare per la capacità inutilizzata. Nei suoi test, Databricks riporta un throughput di scrittura fino a 5 volte superiore su Postgres con Lakebase, sebbene il risultato dipenda dal carico di lavoro e dalla configurazione.
- Compatibilità con PostgreSQL: Lakebase utilizza la connettività PostgreSQL standard, quindi i driver esistenti, gli ORM e gli strumenti come psql, pgAdmin e DBeaver si connettono nello stesso modo in cui si connetterebbero a qualsiasi altra istanza Postgres, senza alcun protocollo proprietario tra l'applicazione e il database.
- Affidabilità: Lakebase esegue il calcolo secondario in zone di disponibilità separate e lo promuove automaticamente in caso di guasto del primario, mantenendo invariato l'endpoint di connessione. Il team del database non deve promuovere manualmente una replica o riconfigurare l'applicazione durante l'incidente.
- Prezzi: Il calcolo scala con il carico di lavoro anziché con un'istanza con provisioning permanente, e i costi si interrompono una volta sospeso il database. L'archiviazione viene fatturata separatamente.
- Integrazione con il lakehouse: Lakebase si connette al resto della piattaforma Databricks anziché operare come servizio Postgres isolato. Le tabelle sincronizzate rendono i dati di Unity Catalog disponibili per le applicazioni Postgres senza una pipeline di sincronizzazione personalizzata, e Change Data Feed, attualmente in Public Preview, espone le modifiche del database per l'elaborazione downstream nel lakehouse.
Cosa non è più a carico del team
La tabella seguente mostra quali operazioni del database sono gestite da Lakebase e quali rimangono a carico del team del database:
| Dimensione | Cosa gestisce Lakebase |
|---|---|
| Patching | Aggiornamenti automatici di PostgreSQL, sicurezza, OS e calcolo |
| Scalabilità | Scalabilità automatica, incluso lo scale-to-zero quando inattivo |
| Failover | Failover automatico al calcolo secondario all'interno di una regione |
| Backup e ripristino | Ripristino point-in-time con cronologia configurabile da 2 a 30 giorni, oltre a snapshot pianificati per una protezione di backup aggiuntiva |
| Disaster recovery | Private Preview, solo AWS. Replicazione periodica con failover manuale e procedure di ripristino gestite dal cliente. |
| Crittografia | A riposo e in transito, chiavi gestite dal cliente disponibili |
| Controllo degli accessi | Ruoli e autorizzazioni PostgreSQL, con integrazioni di Unity Catalog per una governance più ampia. |
| Estensioni | pgvector, PostGIS e altre estensioni PostgreSQL supportate |
| Connection pooling | PgBouncer integrato |
| Branching | Copy-on-write, nessuna duplicazione dell'archiviazione |
| Integrazione con il lakehouse | Tabelle sincronizzate e Change Data Feed |
| Prezzi | Serverless, scala con il carico di lavoro, si sospende quando è inattivo. Archiviazione fatturata separatamente. |
Patching, scalabilità, failover e backup vengono eseguiti automaticamente come indicato nella tabella sopra. Il disaster recovery fa eccezione: è ancora in Private Preview, solo su AWS, con failover manuale e procedure di ripristino gestite dal cliente. Questo è il dettaglio che vale la pena verificare prima di affidarsi a Lakebase per qualsiasi attività che si estenda su più regioni. Scopri di più su Databricks Lakebase.
Conclusioni
Il termine "gestito" assume significati diversi a seconda di chi lo propone, dall'applicazione di patch all'OS considerandola un'attività conclusa, fino a farsi carico dell'intero peso della gestione di un database di produzione: scalabilità, failover, backup, sicurezza, migrazione, carichi di lavoro AI e l'intera esperienza di sviluppo correlata.
Lakebase supera questa soglia per la maggior parte di questi aspetti. Patching, scalabilità e failover vengono eseguiti senza l'intervento del tuo team; il ripristino point-in-time è integrato, e sicurezza, estensioni, connection pooling e branching sono tutti inclusi nel servizio. Il disaster recovery multi-regione è l'unica eccezione, ancora in Private Preview con failover manuale, e non offre la stessa protezione automatica che Lakebase fornisce all'interno di una singola regione.
Per i team che valutano un Postgres gestito, la domanda cruciale è quanta parte del lavoro operativo venga effettivamente tolta dalle loro responsabilità. Lakebase gestisce la maggior parte di questo lavoro all'interno di una regione, mentre il disaster recovery multi-regione rimane un'area in cui i team hanno ancora delle responsabilità.
Domande frequenti
Qual è la differenza tra Postgres gestito e self-hosted?
Postgres self-hosted affida ogni attività operativa al team del database: applicazione di patch, scalabilità, failover, criteri di backup e disaster recovery. Postgres gestito trasferisce in parte o del tutto queste attività al provider, ma la quantità trasferita varia notevolmente. I servizi parzialmente gestiti si occupano dell'infrastruttura e lasciano il resto al cliente. Alcuni servizi completamente gestiti includono anche strumenti di sicurezza, assistenza alla migrazione e flussi di lavoro per gli sviluppatori, come il branching del database.
Che cos'è Postgres serverless?
Postgres serverless è un modello di database gestito in cui le risorse di calcolo scalano automaticamente in base alla domanda, eliminando la necessità di allocare una dimensione fissa per l'istanza. Alcuni provider scalano le risorse di calcolo a zero quando il database è inattivo, mentre altri mantengono una capacità di base. Le tariffe si basano in genere sulle risorse di calcolo utilizzate, anziché su un'istanza allocata in modo permanente.
Come funziona il branching del database in Postgres?
Il branching del database crea un ramo isolato copy-on-write di un database senza duplicare lo storage sottostante. Ogni ramo può avere le proprie risorse di calcolo e modifiche ai dati senza influire sulla produzione. I team lo utilizzano per testare le migrazioni dello schema su dati reali, avviare un ramo per ogni pull request o ripristinare un ramo da un momento specifico nel tempo, per poi eliminarlo una volta completato il lavoro.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.