Elaborazione dei dati in parallelo da più piattaforme di streaming tramite Spark Declarative Pipelines
Gestisci e consuma facilmente da diverse piattaforme di streaming su più cloud tramite un'unica pipeline ETL.
Uno dei principali obiettivi delle organizzazioni oggi è consentire il processo decisionale alla velocità del business. I team aziendali e i sistemi decisionali autonomi spesso richiedono tutte le informazioni necessarie per prendere decisioni e rispondere rapidamente non appena si verificano gli eventi di origine, in tempo reale o quasi reale. Tali informazioni, note come eventi nel gergo dello stream processing, vengono trasmesse in modo asincrono da un'origine a una destinazione e in genere gestite tramite un message broker o message bus.
Con la crescita delle organizzazioni e la divisione dei team in altri team, i pattern di utilizzo, il numero e la varietà dei message broker aumentano. Negli scenari di fusioni e acquisizioni, le aziende ereditano spesso nuovi message broker, che devono poi essere integrati nei loro processi di data engineering esistenti. Gestire una moltitudine di message broker, i loro producer, consumer e le pipeline di data engineering in modo coerente può essere difficile a causa del numero di tecnologie, piattaforme cloud e linguaggi di programmazione in cui è richiesta una specializzazione.
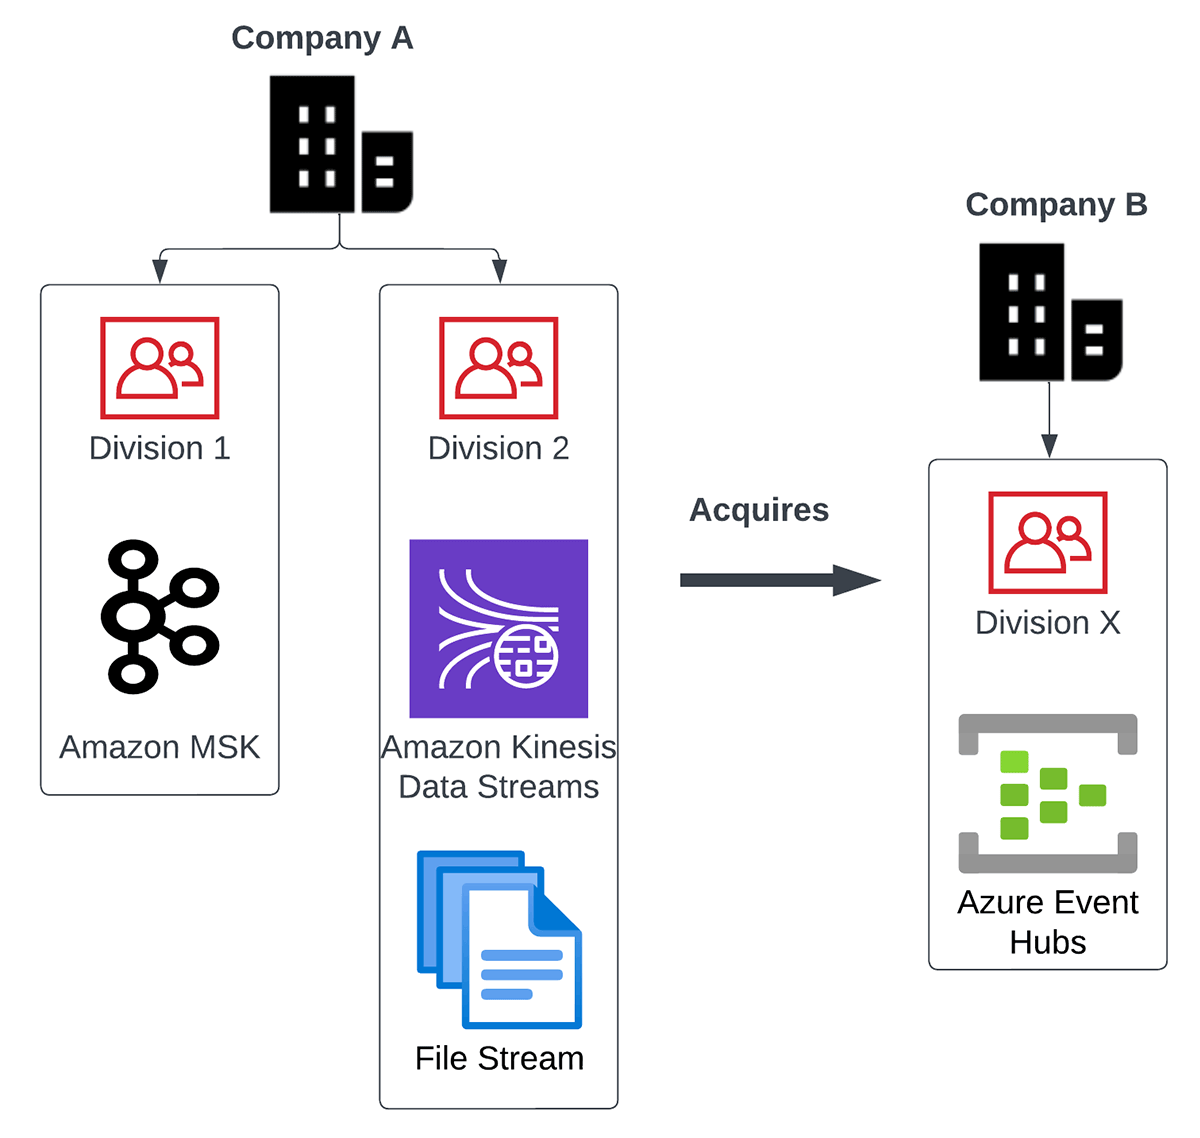
Ad esempio, esaminiamo un caso d'uso Multi-Stream. Immagina la seguente situazione in un conglomerato globale, in cui
- Hanno due divisioni principali che utilizzano due message broker separati: Amazon Kinesis Data Streams e Amazon Managed Service for Kafka (MSK).
- Hanno acquisito un'altra azienda di prodotti più piccola che utilizza internamente Azure Event Hubs.
- Hanno anche una fonte di dati principale proveniente sotto forma di un flusso continuo di file csv o json.
Il diagramma sottostante illustra il caso d'uso multi-stream descritto sopra:
Ecco alcune delle principali sfide nell'elaborazione di tutti questi dati in un simile scenario:
- Come integrano tutte queste diverse fonti di dati e le relative tecnologie?
- Come costruiscono sistemi di data engineering in modo che siano facili da scalare e mantenere? Assumono talenti specializzati per ogni singola tecnologia?
- Come fanno a garantire che, nel processo di risoluzione di questo enigma tecnologico, non dimentichino l'obiettivo finale: dare un senso ai dati e consentire decisioni più rapide?
- Come fanno a garantire che sia le esigenze di elaborazione batch che di streaming possano essere soddisfatte dallo stesso sistema di elaborazione dati?
Attraverso questo blog, dimostreremo come questi problemi possano essere risolti in modo semplice e pulito tramite Spark Declarative Pipelines (SDP). Spark Declarative Pipelines sulla Databricks Lakehouse Platform semplifica la creazione e la gestione di pipeline di dati batch e streaming di alta qualità.
Caso d'uso multi-stream
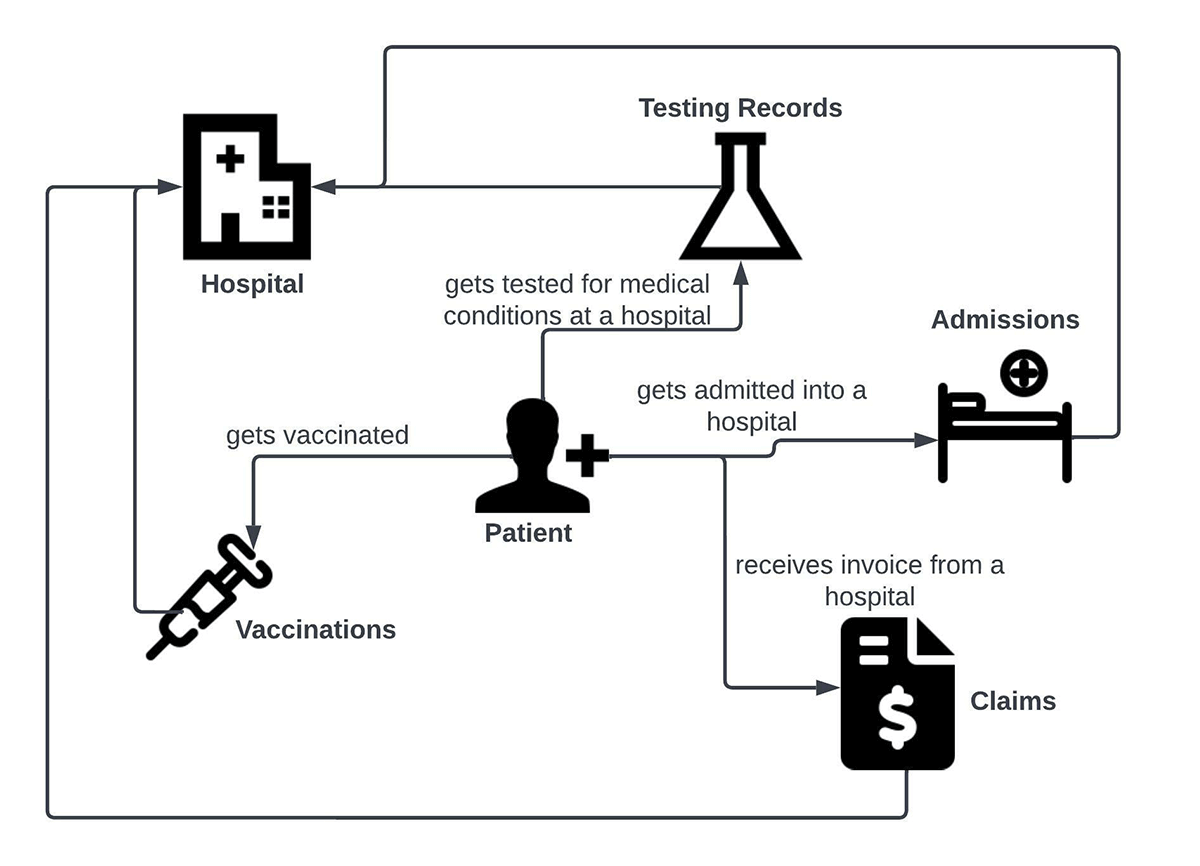
Per dimostrare uno scenario di elaborazione multi-stream tramite SDP, immaginiamo un caso d'uso nel settore sanitario. Al centro del caso d'uso c'è un paziente. Il paziente completa le seguenti interazioni con un'altra entità, l'ospedale:
- Viene vaccinato contro condizioni mediche in ospedale
- Si sottopone a test per condizioni mediche in ospedale
- Viene ricoverato in ospedale per determinate condizioni mediche
- Riceve la fattura per il trattamento, tramite un processo di rimborso
Queste interazioni possono essere rappresentate nel diagramma del caso d'uso aziendale sottostante.
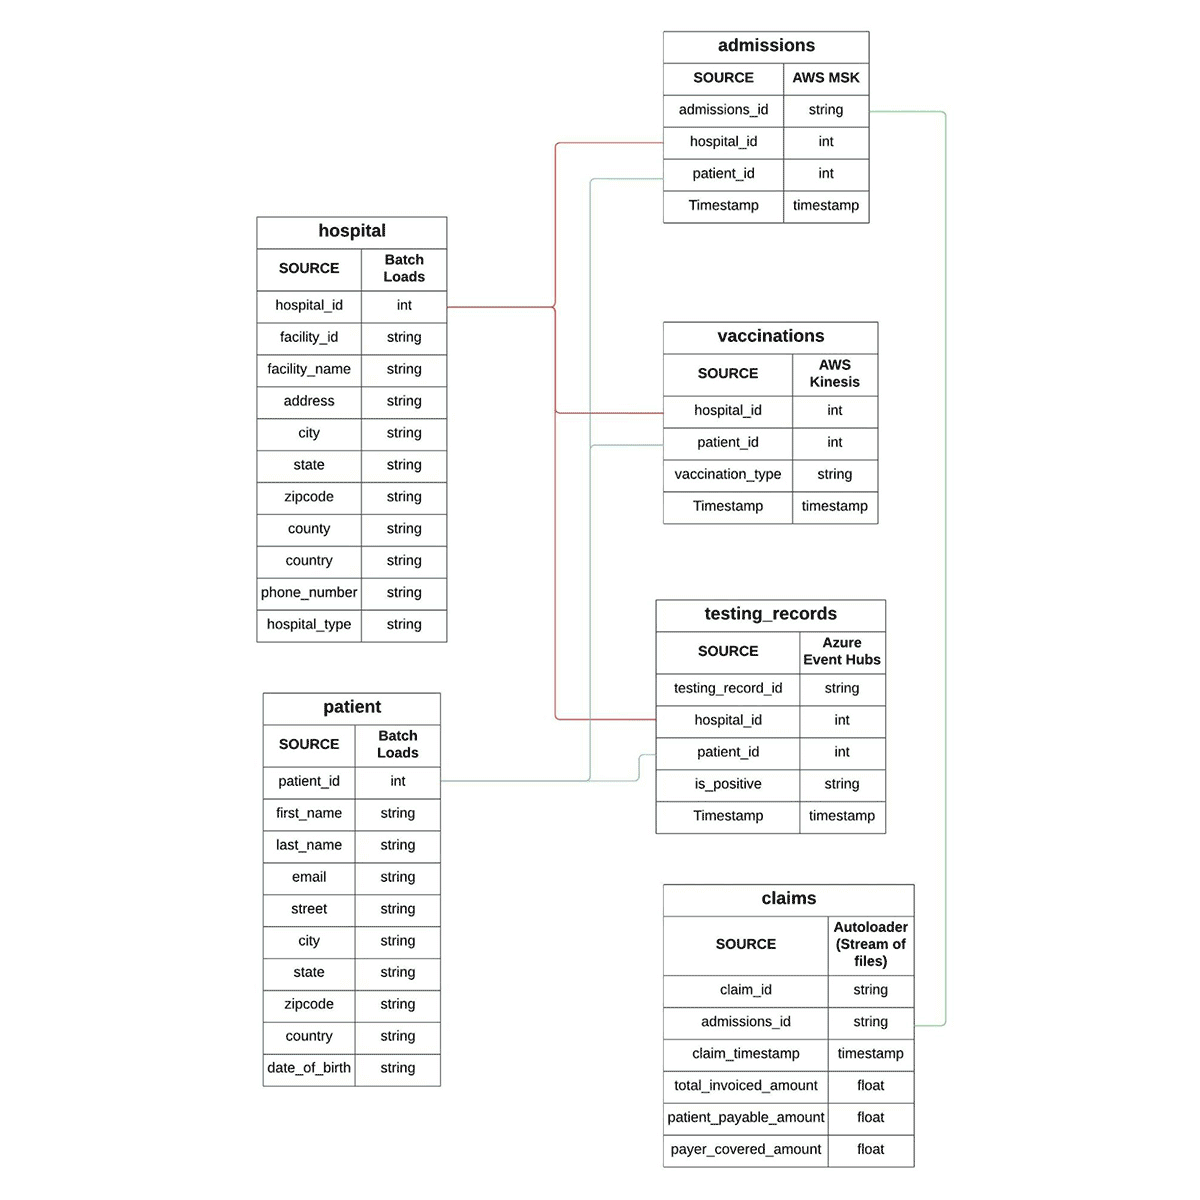
Le entità coinvolte in queste interazioni possono essere rappresentate sotto forma del diagramma entità-relazione (ER) sottostante. In futuro faremo ampio uso dei termini Fact e Dimension provenienti dal lessico della modellazione dimensionale del Data warehousing. Nel diagramma ER, puoi vedere che Patient e Hospital sono tabelle di dimensione, mentre i dati per Admissions, Vaccinations, Testing records e Claims sono rappresentati sotto forma di tabelle di fact.
Supponiamo che i dati di tipo fact per Admissions, Vaccinations, Testing records e Claims arrivino tramite diversi message broker. Per questo blog, abbiamo selezionato quelli più popolari nel settore, ovvero Apache Kafka (Amazon MSK), AWS Kinesis Data Streams e Azure Event Hubs. Il nostro quarto modo per mostrare uno scenario di stream processing consiste nell'inserire una sequenza di file in modo incrementale nelle tabelle (Delta Lake in questo caso). Abbiamo selezionato Databricks Autoloader a questo scopo. Con queste informazioni, il diagramma delle interazioni del paziente può ora essere aggiornato con le origini dati pertinenti:
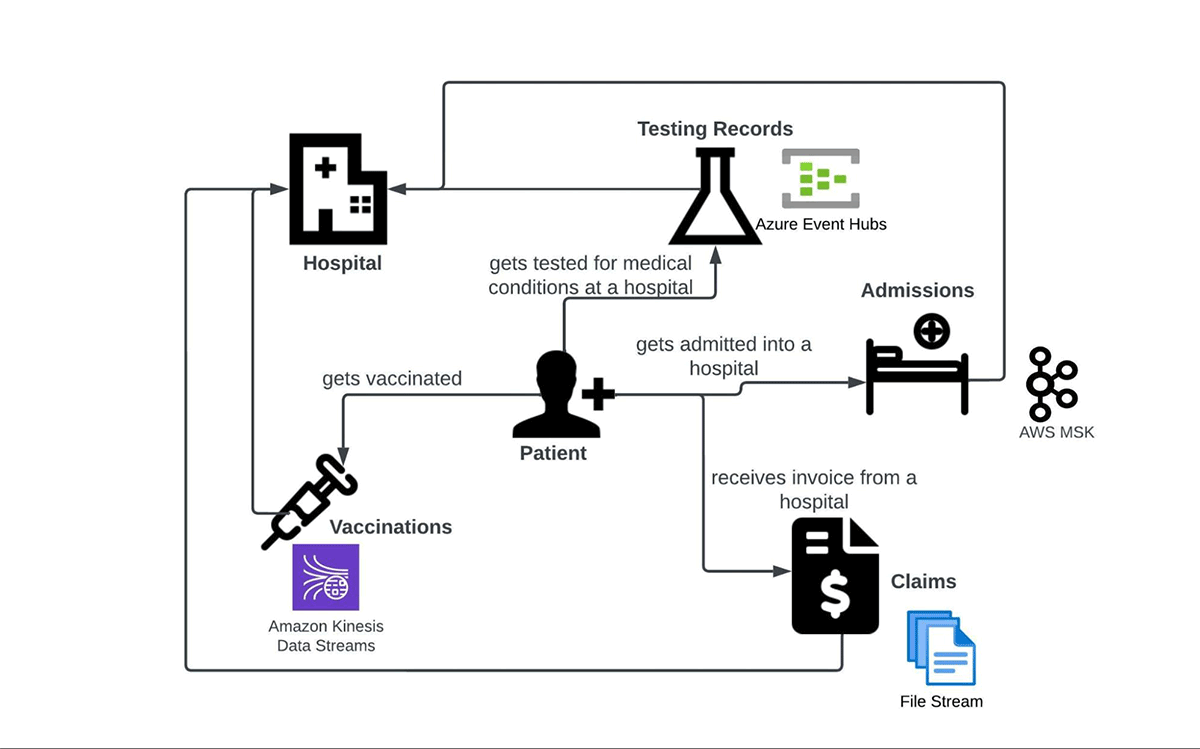
Di seguito sono riepilogate le origini dati in formato tabellare:
| Fact | Origine dati |
| Admissions | Amazon MSK (Apache Kafka) |
| Testing Records | Azure Event Hubs |
| Vaccinations | AWS Kinesis Data Streams |
| Claims | Flusso incrementale di file |
Nella prossima sezione, dimostreremo come una singola pipeline SDP possa acquisire dati dalle origini di streaming di cui sopra simultaneamente ed eseguire anche operazioni di ETL su di essi. Abbiamo utilizzato l'infrastruttura AWS per configurare le risorse e la pipeline per questo blog, ma gli scenari dovrebbero essere configurabili in modo simile su altri cloud pubblici come Azure e GCP.
Elaborazione multi-stream tramite SDP
Il diagramma sottostante mostra l'aspetto di una comune pipeline SDP. Sebbene l'acquisizione e la trasformazione dei dati in streaming provenienti da diverse origini rientrino nell'ambito di questo blog, ci sono ulteriori funzionalità di SDP che meritano attenzione. Ad esempio, la gestione della qualità dei dati è una funzionalità chiave che può aiutare i team a elaborare solo i dati che superano determinate "aspettative". I team possono quindi intraprendere azioni correttive e preventive sui dati errati. Altri vantaggi di SDP sono il checkpointing gestito e l'autoscaling migliorato. Puoi leggere di queste e altre funzionalità in questo articolo: Concetti di Spark Declarative Pipelines.
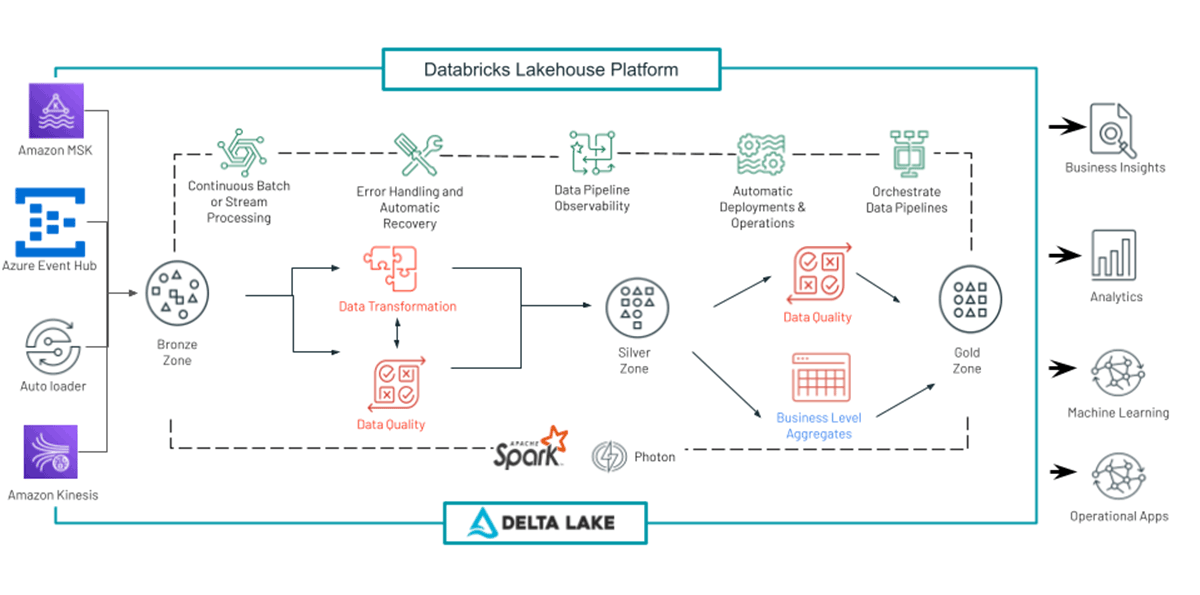
La nostra pipeline SDP di elaborazione multi-stream (chiamiamola sdp_multistream_consumer per semplicità) prevede le seguenti operazioni:
- Caricamento dei dati in streaming dai message broker in un livello grezzo di tabelle Delta Lake.
- Analisi e applicazione dello schema sui dati grezzi per generare fact significativi (tabelle di fact) dai payload dei messaggi.
- Generazione di dataset aggregati per il consumo da parte dei team di BI e Analytics. Questo viene fatto unendo varie tabelle di fact e dimension e suddividendo/analizzando i record generati.
Una pipeline SDP può essere configurata per funzionare nelle seguenti modalità:
- Continua: un cluster attivo elabora i dati non appena arrivano in modo continuo. Questa opzione è consigliata per gli scenari di streaming in cui la latenza è fondamentale.
- Attivata: un cluster viene avviato secondo una pianificazione desiderata ed elabora i dati disponibili in quel momento. Una volta che non ci sono più dati in attesa di elaborazione (per una determinata soglia di durata temporale), il cluster viene arrestato. Questa modalità è consigliata quando il risparmio sui costi e il throughput hanno la priorità sulla latenza.
Per questo blog, utilizziamo la modalità continuous per due motivi. Il primo è dimostrare un vero scenario di streaming processing in cui i dati vengono catturati ed elaborati in tempo reale. Il secondo è che il connettore Amazon Kinesis Data Streams per Apache Spark, al momento della pubblicazione di questo articolo, non supporta una modalità di ingestione in batch (ad esempio, trigger once o available now), che è invece il caso di una modalità triggered. Tuttavia, sarà disponibile a breve.
Un altro punto da evidenziare è che generalmente in un setup di produzione, una volta acquisiti i dati grezzi, questi passano attraverso molte fasi di elaborazione e arricchimento. Queste fasi puliscono, trasformano e aggregano i dati per casi d'uso aziendali che coinvolgono l'analisi dei dati, l'analisi storica e predittiva. Ci riferiamo al progressivo miglioramento della struttura e della qualità dei dati man mano che fluiscono attraverso ogni livello dell'architettura come Medallion Lakehouse Architecture. Sebbene l'architettura Medallion sia una best practice per i casi d'uso principali, per semplificare questo blog salteremo la parte di trasformazione dei dati e passeremo all'esecuzione dell'analisi dei dati per supportare i casi d'uso aziendali.
Ora vediamo come possiamo eseguire l'ingestione di dati in streaming – tutti in una volta da una moltitudine di sistemi di streaming utilizzando SDP in Delta Lake e analizzare tali dati per generare insight significativi.
Ingestione di dati da stream
In questa sezione ti mostriamo come acquisiremo dati da più piattaforme di streaming.
Ingestione di dati da Amazon MSK
Amazon Managed Streaming for Apache Kafka (Amazon MSK) è un servizio completamente gestito che ti consente di creare ed eseguire applicazioni che utilizzano Apache Kafka per elaborare dati in streaming. Amazon MSK fornisce le operazioni di control-plane, come quelle per la creazione, l'aggiornamento e l'eliminazione dei cluster.
Per questo blog abbiamo utilizzato un cluster MSK con le seguenti configurazioni:
- Tipo di cluster - Provisioned
- Numero totale di broker - 2
- Versione di Apache Kafka - 2.5.1
- Tipo di broker - kafka.m5.large
- Numero di zone di disponibilità - 2
- Volume di archiviazione EBS per broker - 300 GiB
- Crittografia tra client e broker:
- Crittografia TLS - Abilitata
- Testo in chiaro - Abilitato
Per l'autenticazione nell'ambiente AWS, abbiamo associato un instance profile al cluster SDP. Questo fa riferimento a un ruolo IAM che dispone di appropriate autorizzazioni di lettura/scrittura come configurato nella definizione del ruolo.
La pipeline sdp_multistream_consumer acquisisce il dataset Hospital Admission dal topic MSK admission nella tabella delta lake denominata msk_admissions_tbl_raw. Il payload kafka (binario rappresentato come stringa) per un fact Admissions appare così:
Abbiamo utilizzato il codice seguente in un notebook python per l'ingestione e lo abbiamo collegato alla nostra pipeline SDP sdp_multistream_consumer.
La pipeline sdp_multistream_consumer, quando viene avviata, crea la tabella msk_admissions_tbl_raw all'interno del database/schema desiderato e popola la tabella con i dati letti dal topic admission. Quindi continua ad acquisire dati aggiuntivi non appena nuovi dati vengono scritti in quel topic.
Oltre ai quattro campi acquisiti dal topic Kafka, abbiamo aggiunto una colonna msk_event_timestamp (derivata dal timestamp dell'evento generato da Kafka) alla tabella msk_admissions_tbl_raw. I messaggi vengono ricevuti nel campo value del payload Kafka in formato binario. Devono essere convertiti in stringa affinché i processi a valle possano analizzarli.
Ingestione da Amazon Kinesis
Amazon Kinesis Data Streams rende semplice raccogliere, elaborare e analizzare dati in streaming in tempo reale. I dati potrebbero essere video, audio, log di applicazioni, clickstream di siti Web e dati di telemetria IoT per machine learning, analytics e altre applicazioni. Per il nostro blog, abbiamo utilizzato uno stream di dati Kinesis con le seguenti configurazioni:
- Nome dello stream di dati: test_vaccination_data
- Modalità di capacità: On Demand
- Capacità di scrittura: 200 MiB/secondo o 200.000 record/secondo (Massimo predefinito)
- Capacità di lettura: 400 MiB/secondo (Predefinito)
Per una migliore produttività, la funzionalità Amazon Kinesis enhanced fan-out (EFO) del connettore Kinesis di Databricks Runtime può essere utilizzata in scenari di produzione.
Lo stream test_vaccination_data, nel nostro caso d'uso, trasporta i dati sulle vaccinazioni (eventi) per un paziente. Di seguito è riportato un payload di esempio:
Il codice SDP per l'utilizzo dei dati dallo stream di dati Kinesis alla Landing zone in Lake house è il seguente:
La pipeline sdp_multistream_consumer popola la tabella di destinazione kinesis_vaccination_tbl_raw con i dati disponibili nello stream di dati Kinesis ed esegue un checkpoint per evitare di rileggere i dati. I messaggi vengono ricevuti nel campo data del payload Kinesis in formato binario. Devono essere convertiti in stringa affinché i processi a valle possano analizzarli.
Ingestione da Azure Event Hubs
Azure Event Hubs è una popolare piattaforma di streaming offerta da Microsoft. Event Hubs supporta più protocolli per la lettura e la scrittura, come AMQP, HTTPS e Apache Kafka. Per questo blog, la nostra pipeline SDP sdp_multistream_consumer utilizza l'interfaccia Kafka di Event Hubs per consumare i messaggi, poiché il connettore Kafka per Spark è disponibile nativamente in Databricks Runtime senza la necessità di librerie aggiuntive. Stiamo utilizzando il piano tariffario standard per il nostro spazio dei nomi Event Hubs con 2 Throughput Units.
La documentazione di Azure descrive gli spazi dei nomi come contenitori di gestione per gli hub eventi (o topic, nel gergo di Kafka). L'Event Hub (noto anche come topic) di nostro interesse è testing_records_stream, che trasporta eventi relativi ai risultati dei test di laboratorio di un paziente. Ogni messaggio appare come di seguito:
Il codice SDP per l'elaborazione dei messaggi dall'hub eventi testing_records_stream è molto simile al modello di inserimento dati con Amazon MSK (del resto usano entrambi il protocollo Kafka).
La pipeline SDP legge in modo incrementale i messaggi dei record di test da Event Hubs e li aggiunge come nuove righe nella tabella delta lake eventhubs_testing_records_tbl_raw. I messaggi vengono ricevuti nel campo valore del payload di tipo Kafka in formato binario. Devono essere convertiti in stringa in modo che i processi successivi possano analizzarli.
Inserimento di file tramite Auto Loader
Auto Loader è uno degli strumenti di inserimento di file di dati più potenti e affidabili del settore. Elabora in modo incrementale ed efficiente i nuovi file di dati non appena arrivano nello storage cloud, senza bisogno di configurazioni aggiuntive. Ad oggi, può inserire formati di file JSON, CSV, PARQUET, AVRO, ORC, TEXT e BINARYFILE.
Auto Loader consente agli utenti di configurare un'origine Structured Streaming chiamata cloudFiles. Le opzioni di configurazione includono percorsi di file di storage cloud, modelli di filtraggio dei file, opzioni di eventi di arrivo dei file per code come Azure Queue Storage, AWS SQS, AWS SNS, ecc. La pipeline SDP utilizza queste opzioni per inserire automaticamente i nuovi file non appena arrivano, con la possibilità di elaborare anche eventuali file preesistenti in quella directory. Auto Loader supporta sia Python che SQL nelle pipeline SDP. I clienti hanno utilizzato Auto Loader per elaborare miliardi di file per la migrazione dei dati o il popolamento retroattivo di una tabella. È scalabile per supportare l'inserimento quasi in tempo reale di milioni di file all'ora.
In questo blog abbiamo inserito i dati sui sinistri dei pazienti utilizzando Auto Loader con il seguente esempio:
Nella pipeline sdp_multistream_consumer, i file json relativi ai sinistri dei pazienti vengono inseriti tramite Auto Loader non appena arrivano nella posizione di origine, come illustrato nel codice seguente:
Analisi dei dati inseriti per generare informazioni aziendali
Come accennato in precedenza, per questo blog abbiamo già inserito i dataset dei pazienti da quattro diverse origini: Amazon MSK, Amazon Kinesis Data Streams, Azure Event Hubs e Databricks Auto Loader. Per brevità, abbiamo limitato la parte di trasformazione dei dati alla sola applicazione dello schema e procediamo all'analisi dei dati su questi dataset per supportare i casi d'uso aziendali.
Abbiamo creato due casi d'uso di business analytics per questo blog. L'idea è dimostrare come gli utenti possano utilizzare le tabelle delta lake create da SDP per eseguire l'analisi dei dati e rispondere a domande di business.
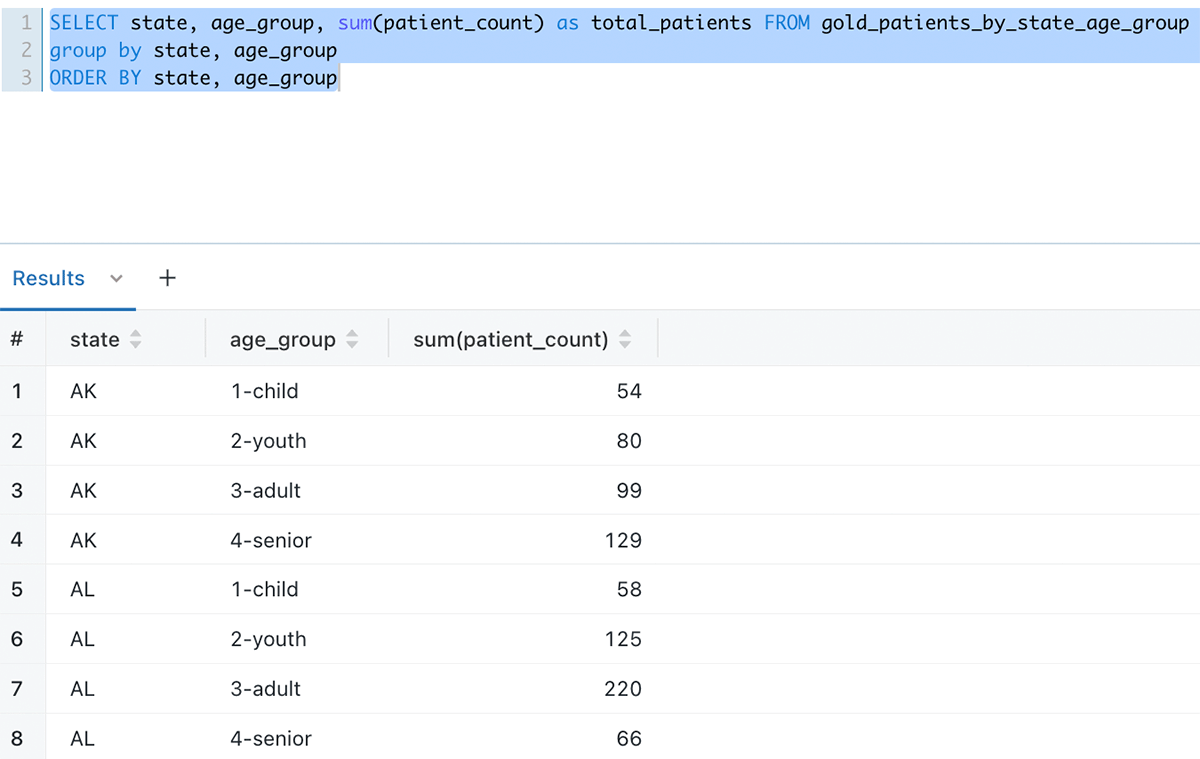
Numero di pazienti per stato e fasce d'età risultati positivi al Covid dopo essere stati vaccinati contro il Covid
La tabella gold_patients_by_state_age_group viene creata in SDP unendo le tabelle popolate tramite l'inserimento dei dati tramite SDP. Man mano che i nuovi dati arrivano nel livello di inserimento, la pipeline SDP continua inserisce tali dati nel livello di inserimento e aggiorna questa tabella gold_patients_by_state_age_group per l'analisi dei dati. --
Ecco l'aspetto dei dati quando vengono interrogati tramite l'editor di query di Databricks SQL:
Numero di ricoveri mensili per città e stato
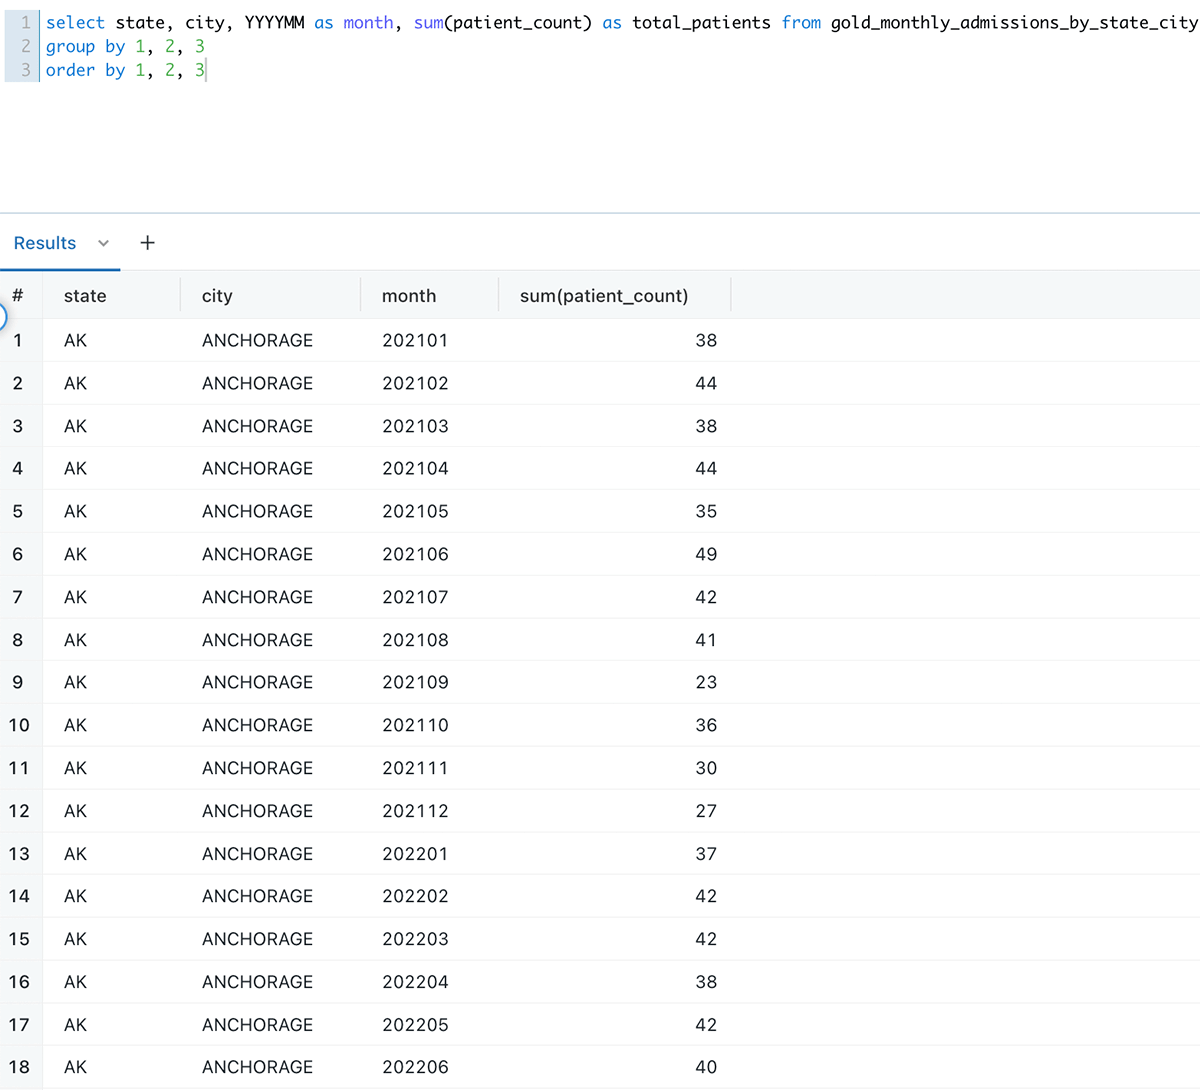
Il numero di ricoveri per città e stato al mese è un altro caso d'uso supportato interrogando la tabella gold_monthly_admissions_by_state_city.
Ecco come si presentano i dati se interrogati tramite l'editor di query di Databricks SQL:
Vista end-to-end della SDP Pipeline
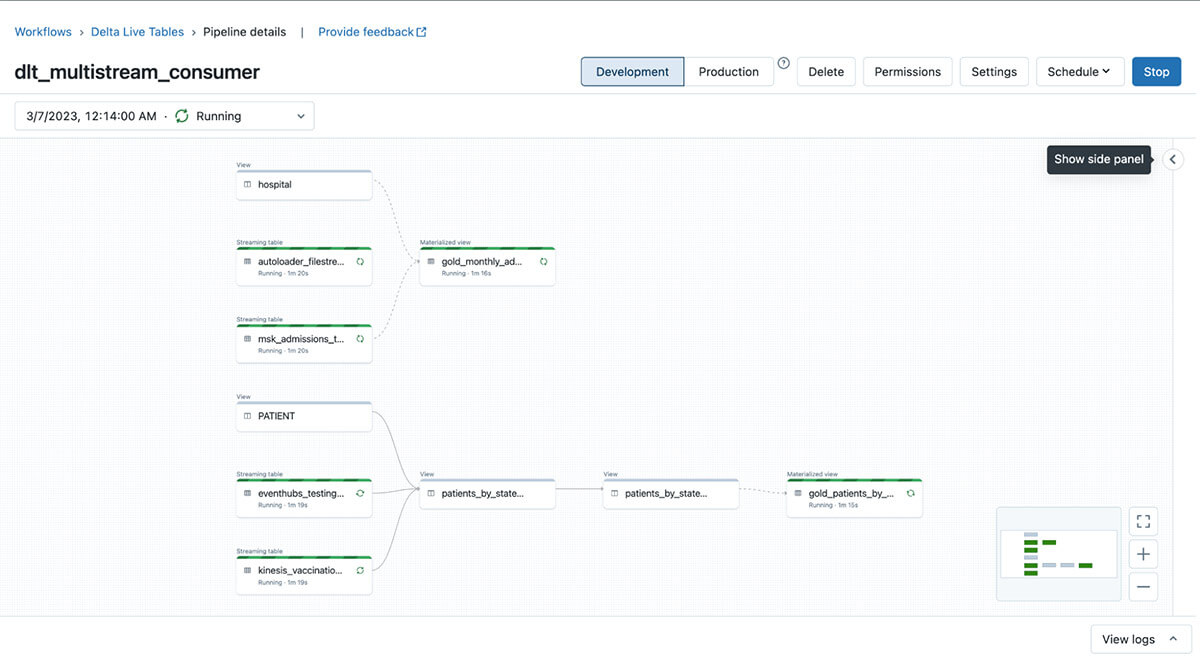
Una delle caratteristiche principali di SDP è la sua capacità di analizzare tutte le dipendenze a livello di tabella tra gli elementi di codice inclusi nella pipeline e di mostrarle sotto forma di grafico di lignaggio. Questo grafico è "dinamico". Man mano che le operazioni ETL procedono, mostra le operazioni riuscite in verde e quelle con errori in rosso. Sotto trovi uno screenshot della nostra pipeline di dati SDP in esecuzione continua:
Conclusione
In questo blog, abbiamo mostrato come puoi acquisire e utilizzare dati da diverse piattaforme di streaming su più cloud tramite Databricks Spark Declarative Pipelines usando un'unica data pipeline. Il processo ETL avviene continuamente, non appena i dati arrivano. I dati generati tramite le trasformazioni sono continuamente disponibili per eseguire analisi dei dati e trovare risposte alle domande del tuo business. Una soluzione di questo tipo semplifica notevolmente l'architettura tecnica generale e la rende facile da mantenere e scalare. Poiché Databricks introduce regolarmente nuove funzionalità in SDP, questa soluzione sta riscontrando una vasta adozione tra i clienti per i carichi di lavoro ETL. Prova subito Spark Declarative Pipelines.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.