Il framework di pipeline aperto per agenti e team di dati
Crea in sicurezza pipeline su scala agentica con qualità, convalida e governance dei dati integr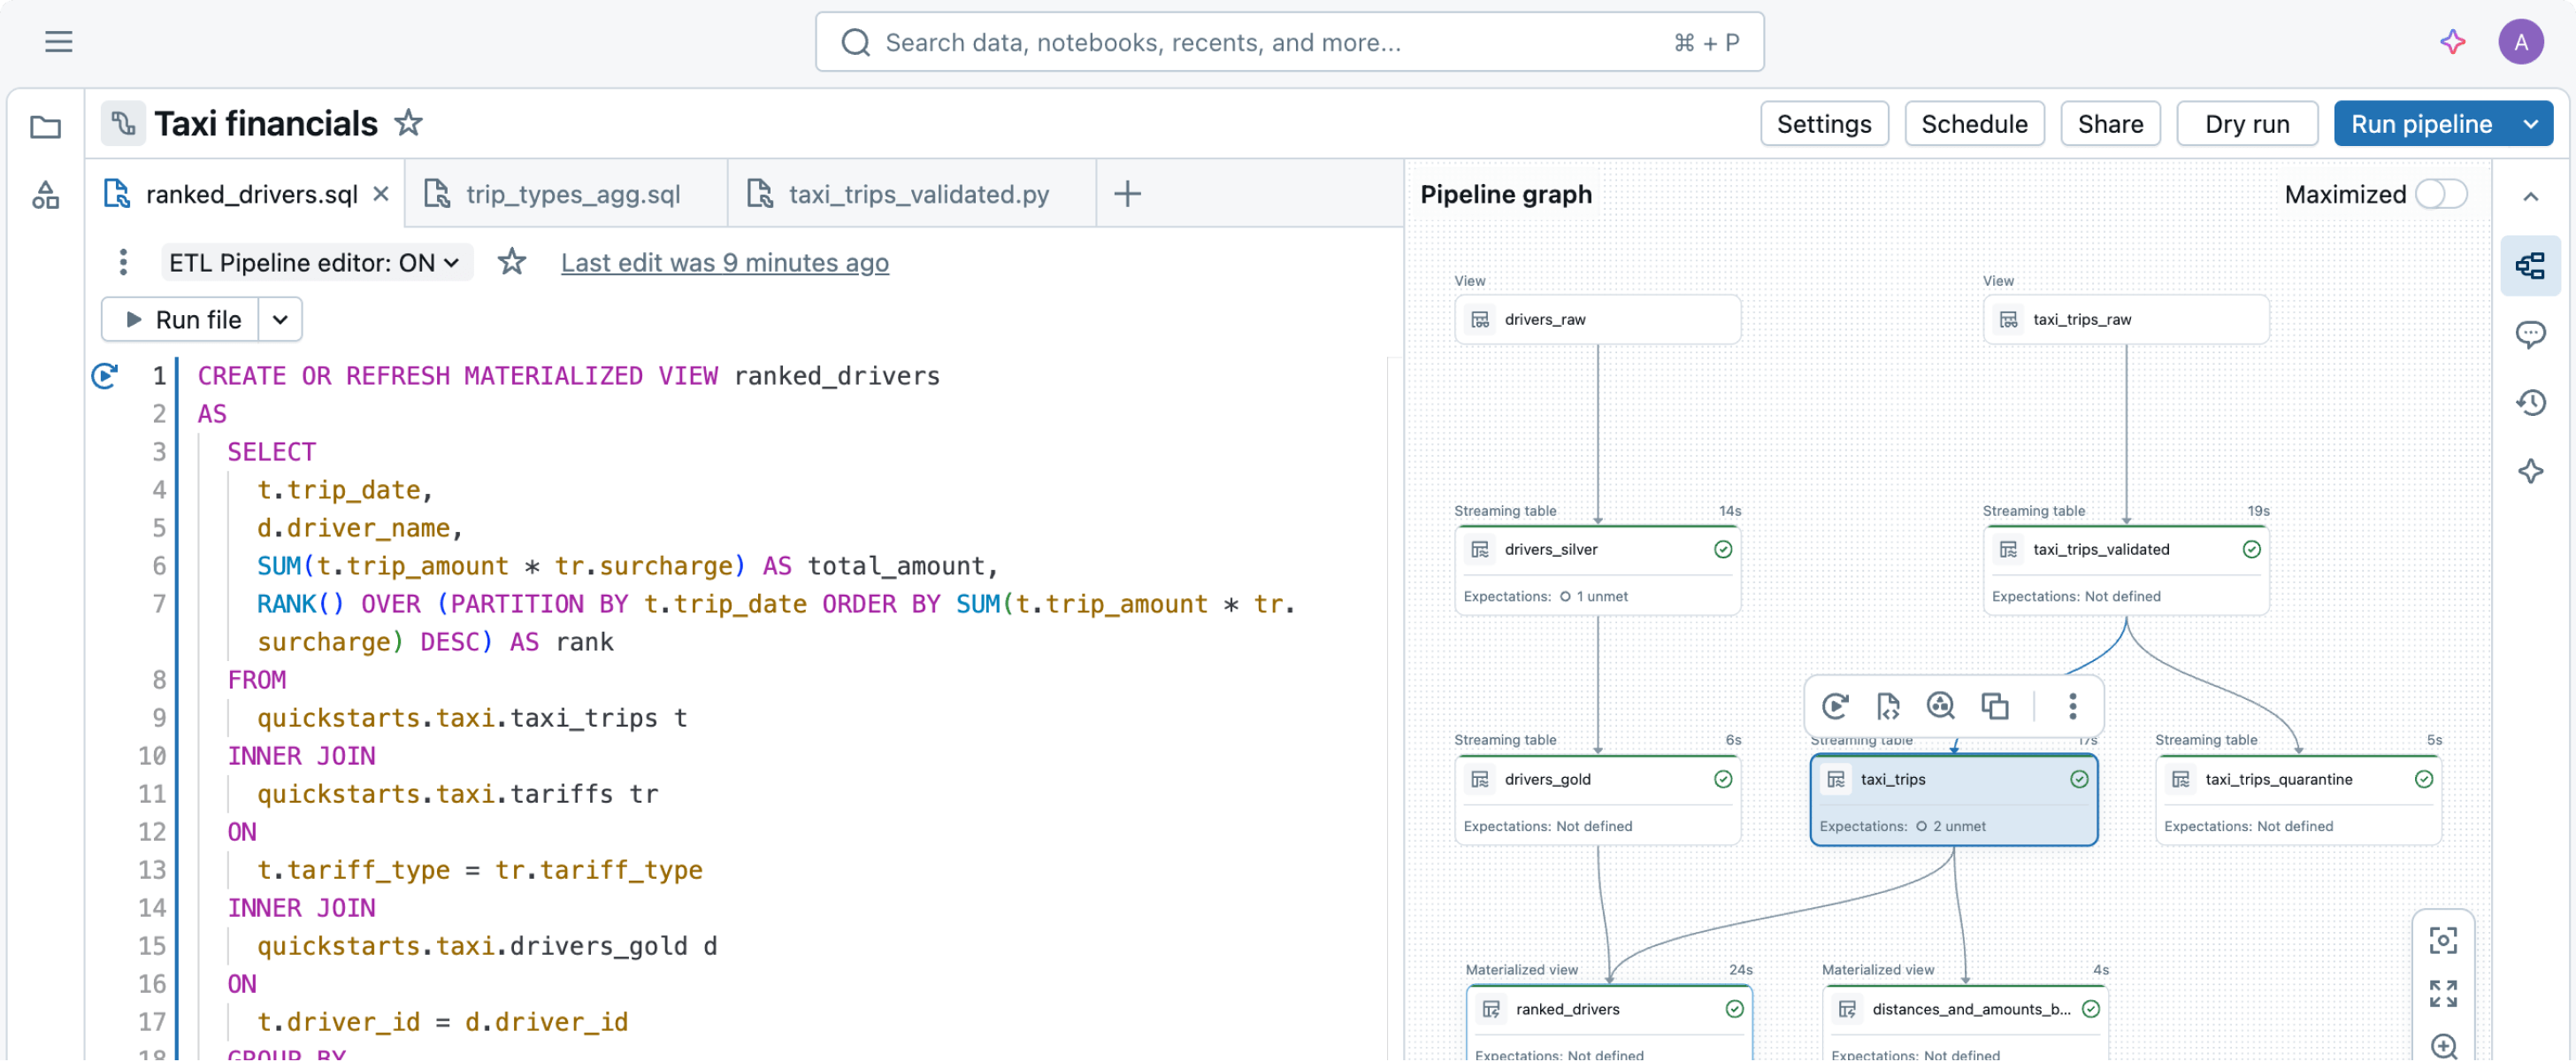
TOP TEAMS SUCCEED WITH INTELLIGENT DATA PIPELINES
Crea ed esegui pipeline su scala agentica in totale sicurezza
Potenzia i team di dati e gli agenti AI con standard aperti, controlli di qualità automatizzati e governance di livello aziendale.
Standard aperti
Lo standard aperto e universale per le pipeline di dati. Unifica l'elaborazione in batch e in streaming, oltre a SQL e Python, su Apache Spark™, fornendo una base portabile affinché i team di dati e gli agenti AI possano generare un robusto codice di produzione.

Costruito per gli agenti
Il framework nativo per gli agenti di coding. Gli agenti dichiarano i risultati dei dati di destinazione. Apache Spark™ Declarative Pipelines (SDP) risolve automaticamente i grafi delle dipendenze, effettua esecuzioni di prova del compilatore e applica regole di qualità prima dell'esecuzione delle pipeline.

Esecuzione governata
Esecuzione sicura e autonoma delle pipeline. Unity Catalog applica rigorosi confini di catalogo e di sicurezza, mentre SDP si occupa dietro le quinte della gestione dello stato, del ripristino dagli errori e dell'elaborazione incrementale.
Progettato per standardizzare lo sviluppo delle pipeline per agenti ed esseri umani
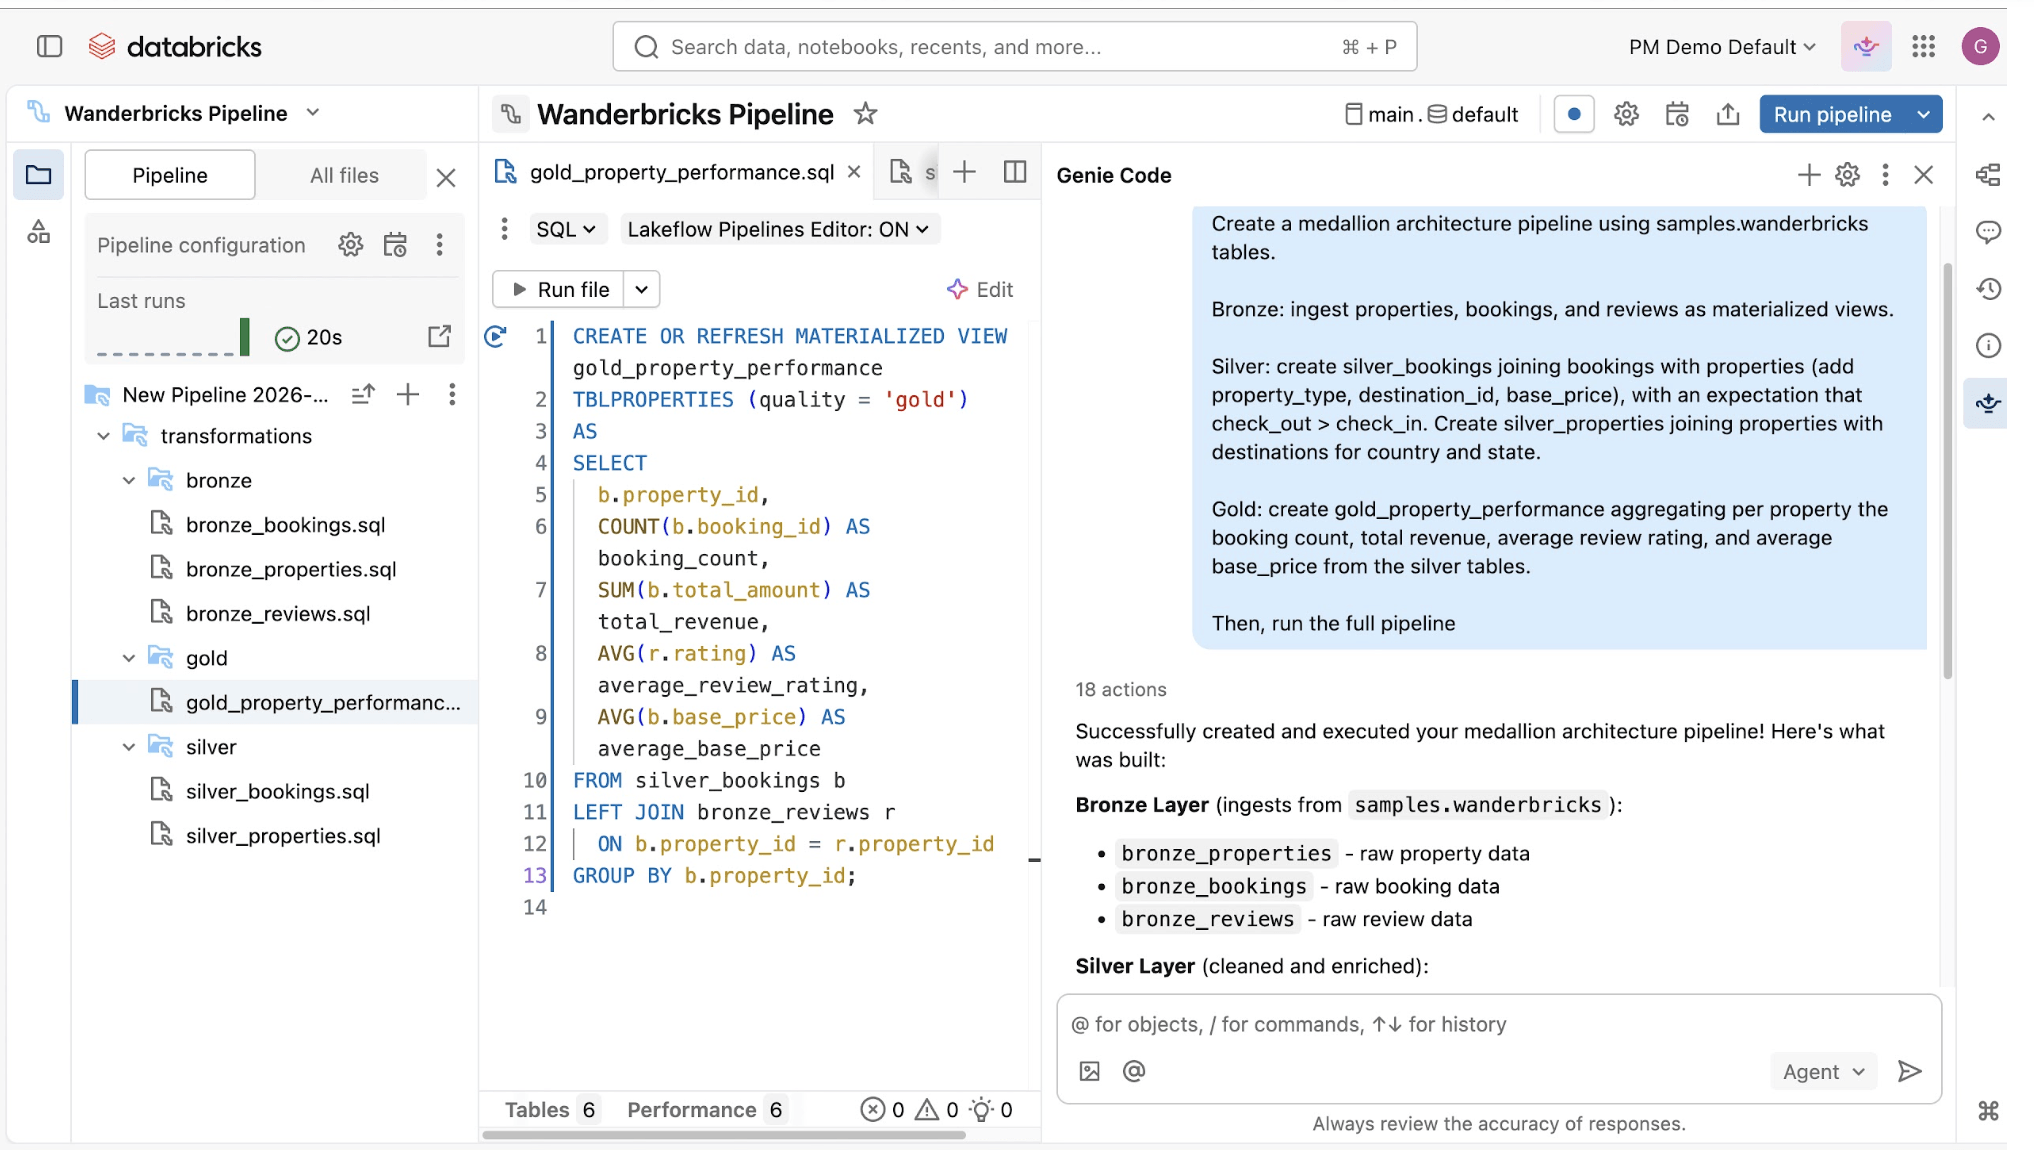
Standardizza lo sviluppo delle pipeline con una creazione pronta per gli agenti, la gestione automatizzata dei pattern e un unico framework per tutti i team.Crea, convalida e itera in modo dichiarativo utilizzando il linguaggio naturale tramite Genie Code oppure tramite il tuo agente di coding preferito.
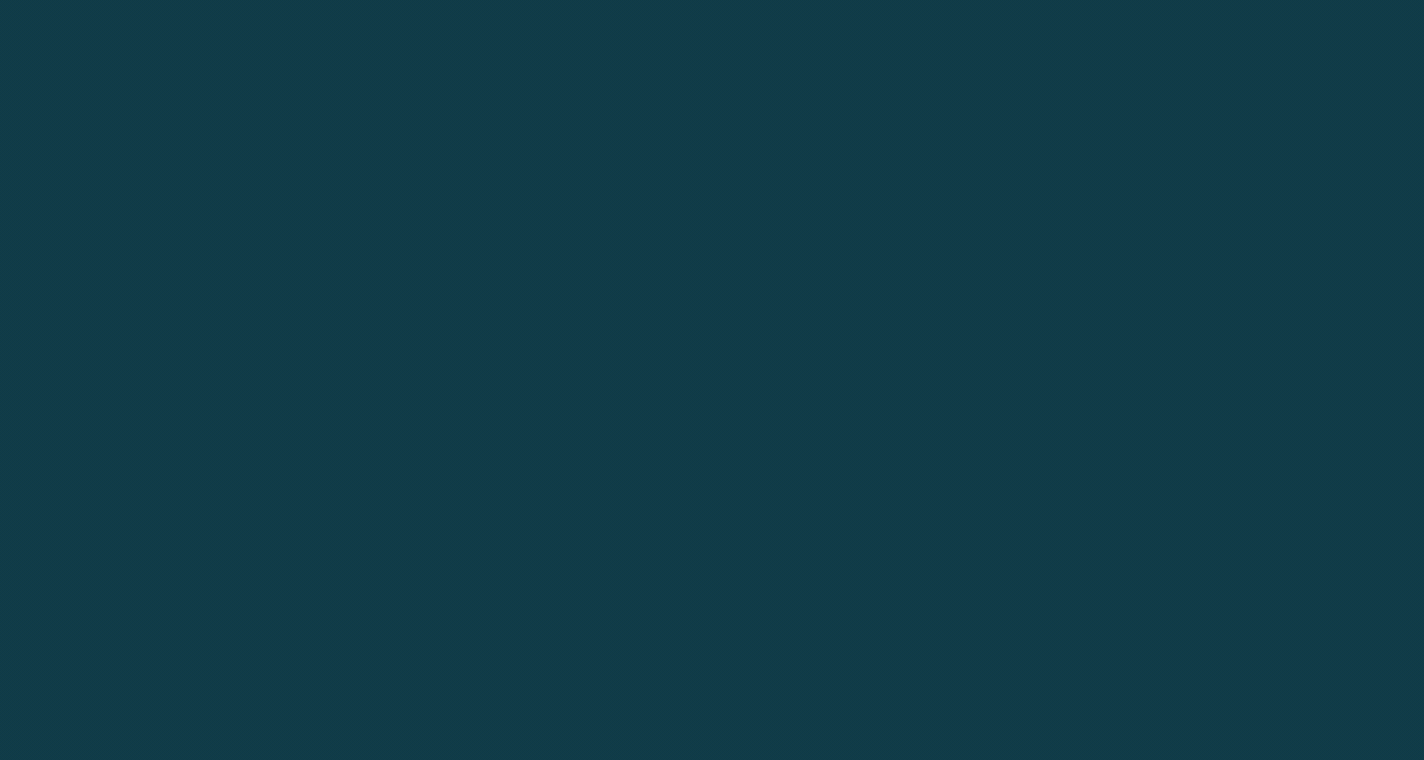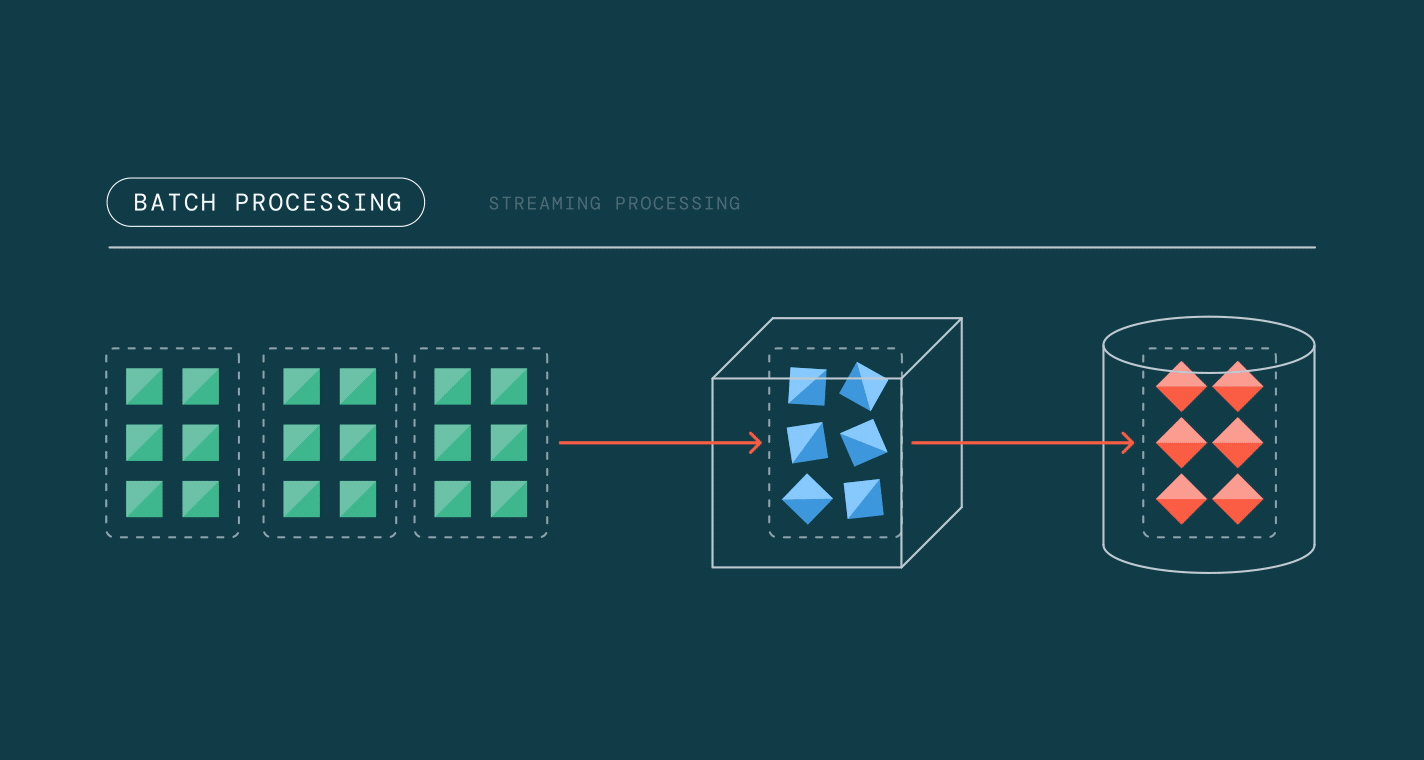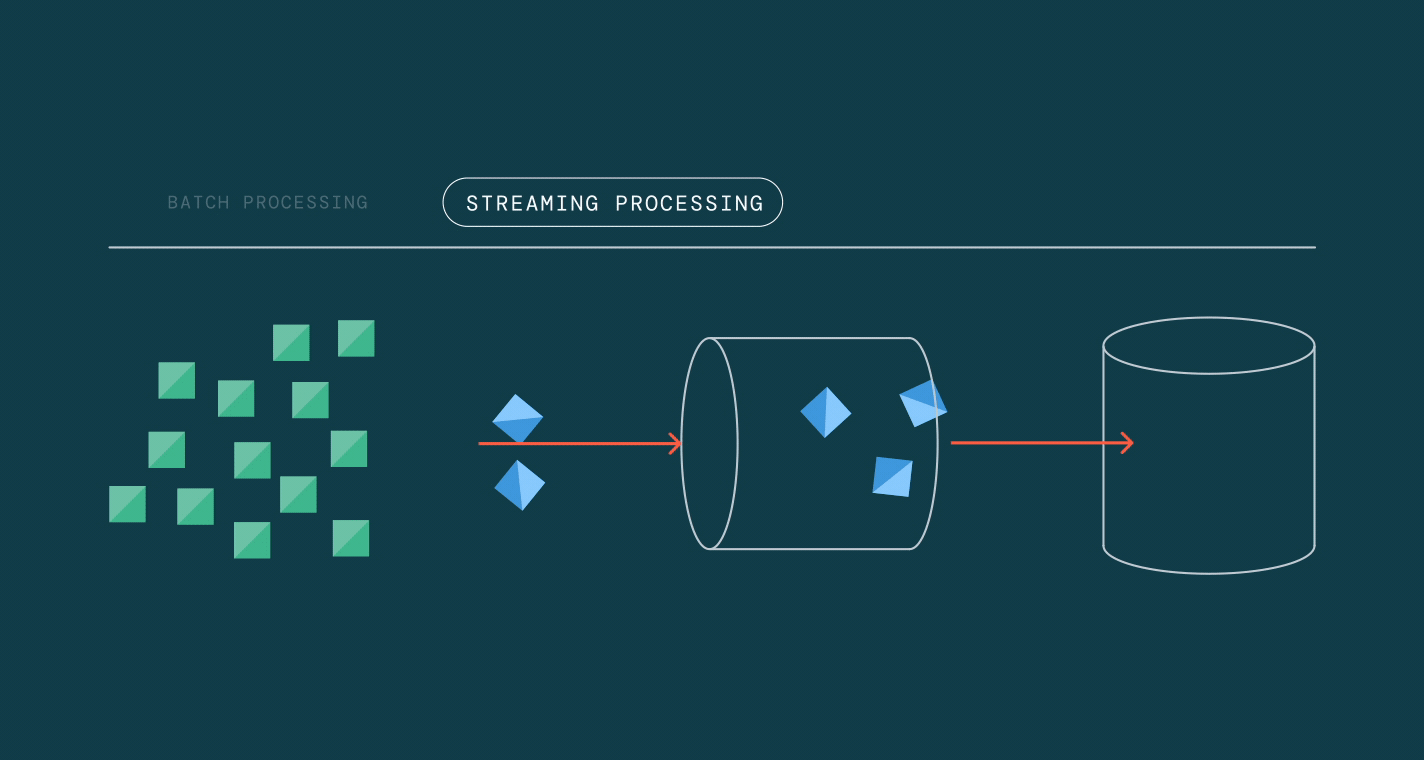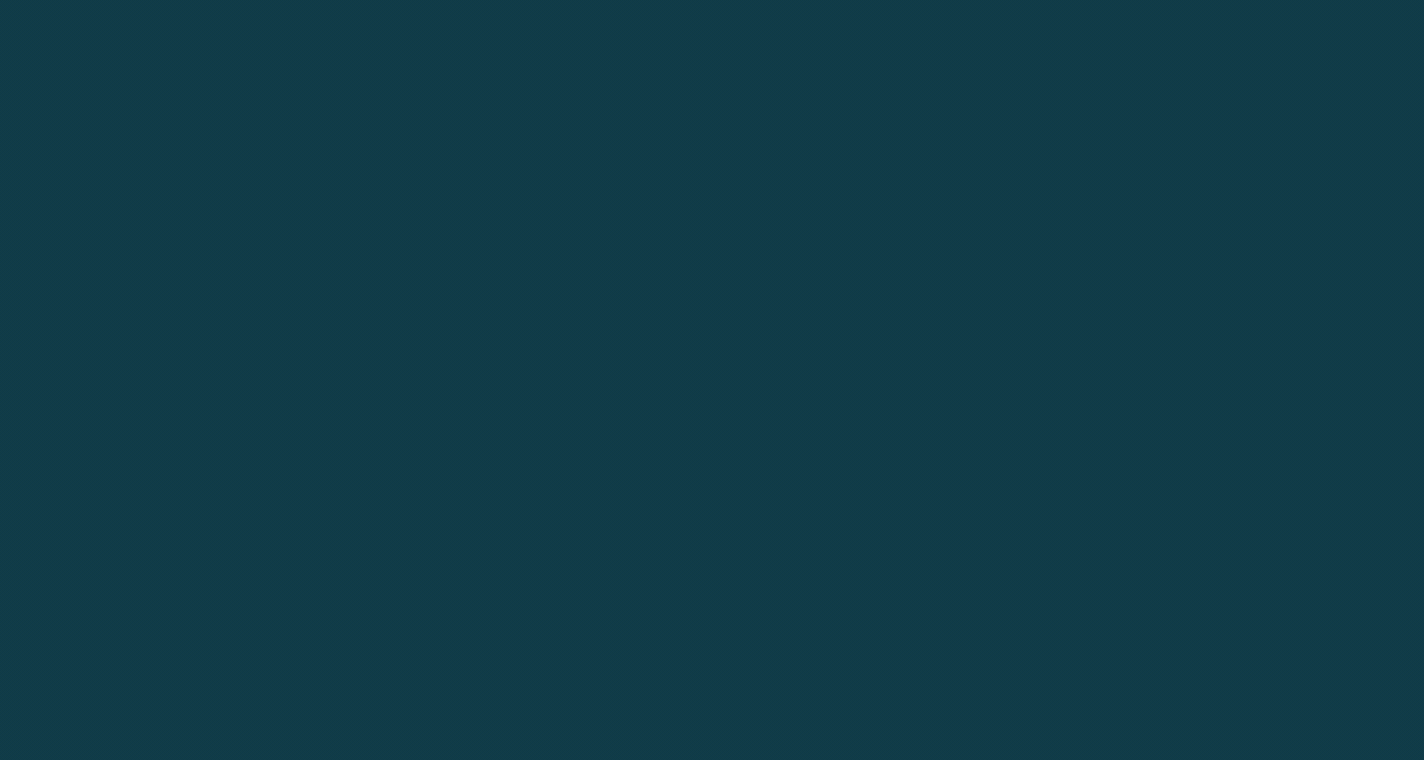
Sfruttando l'API unificata di Spark per l'elaborazione sia in batch che in streaming, SDP permette di passare facilmente da una modalità di elaborazione all'altra.
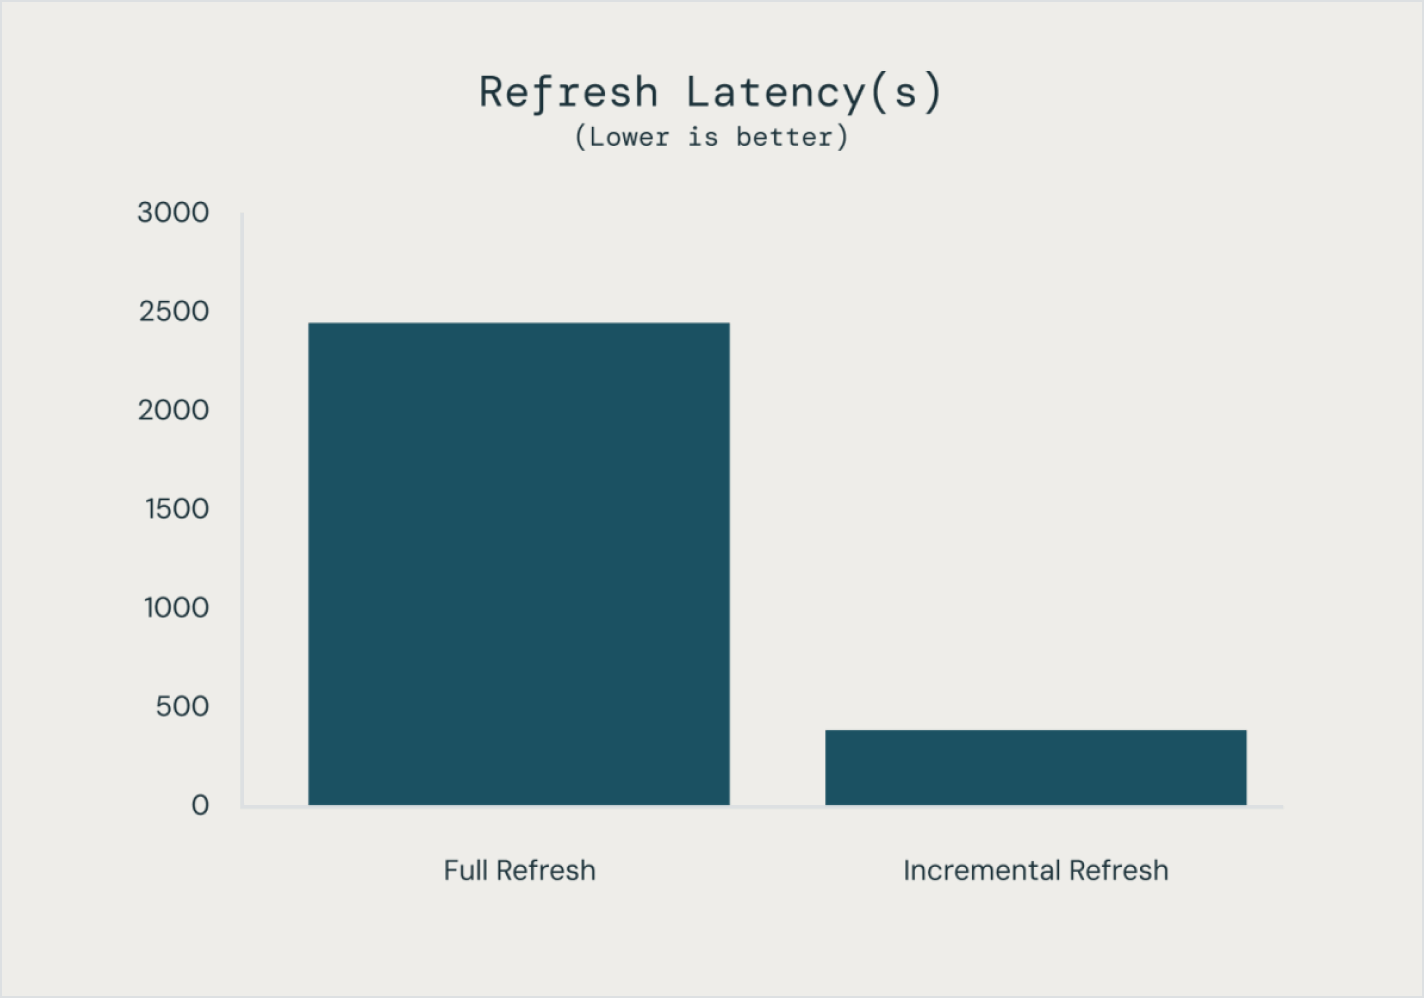
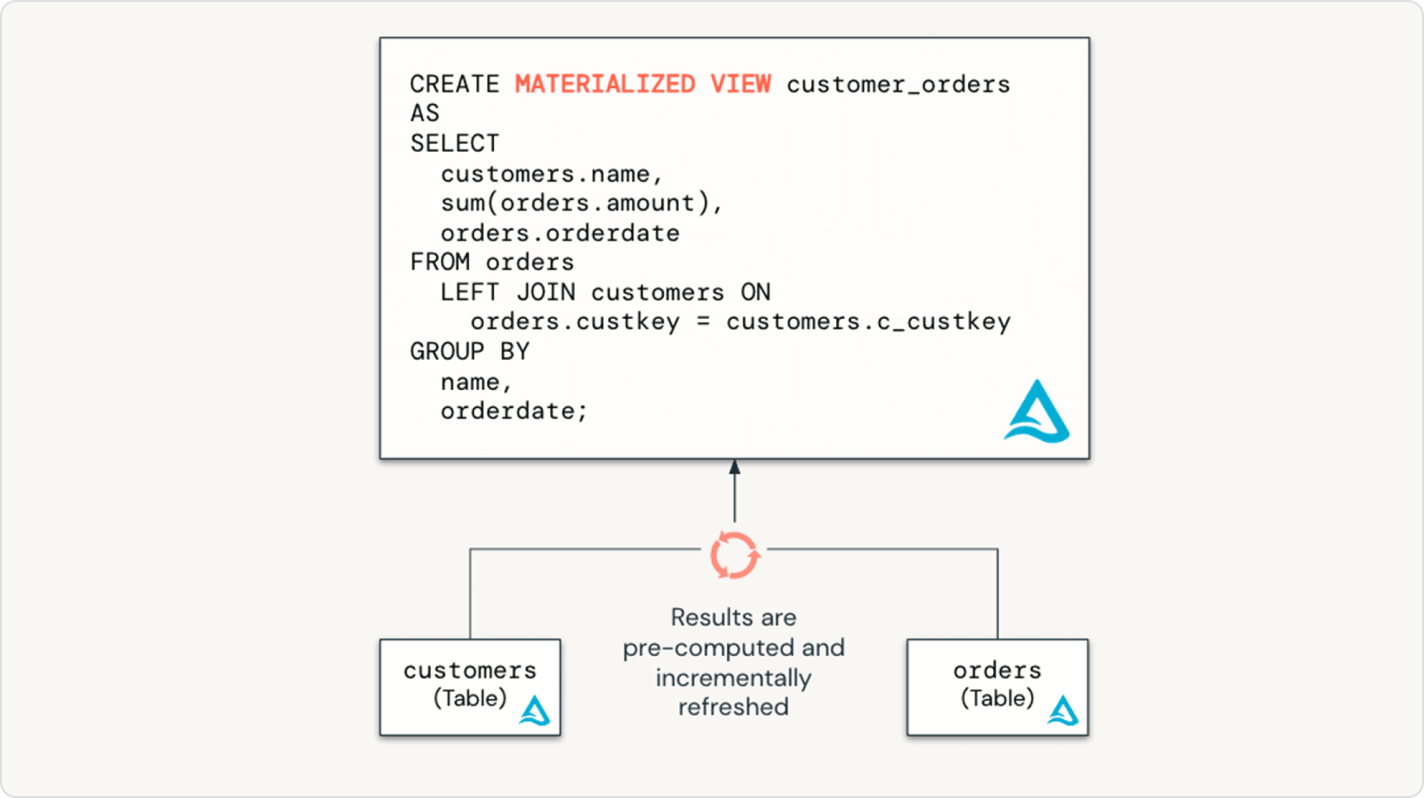
Con SDP, è semplice ottimizzare le prestazioni delle pipeline dichiarando un'intera pipeline di dati incrementale con tabelle e viste materializzate.
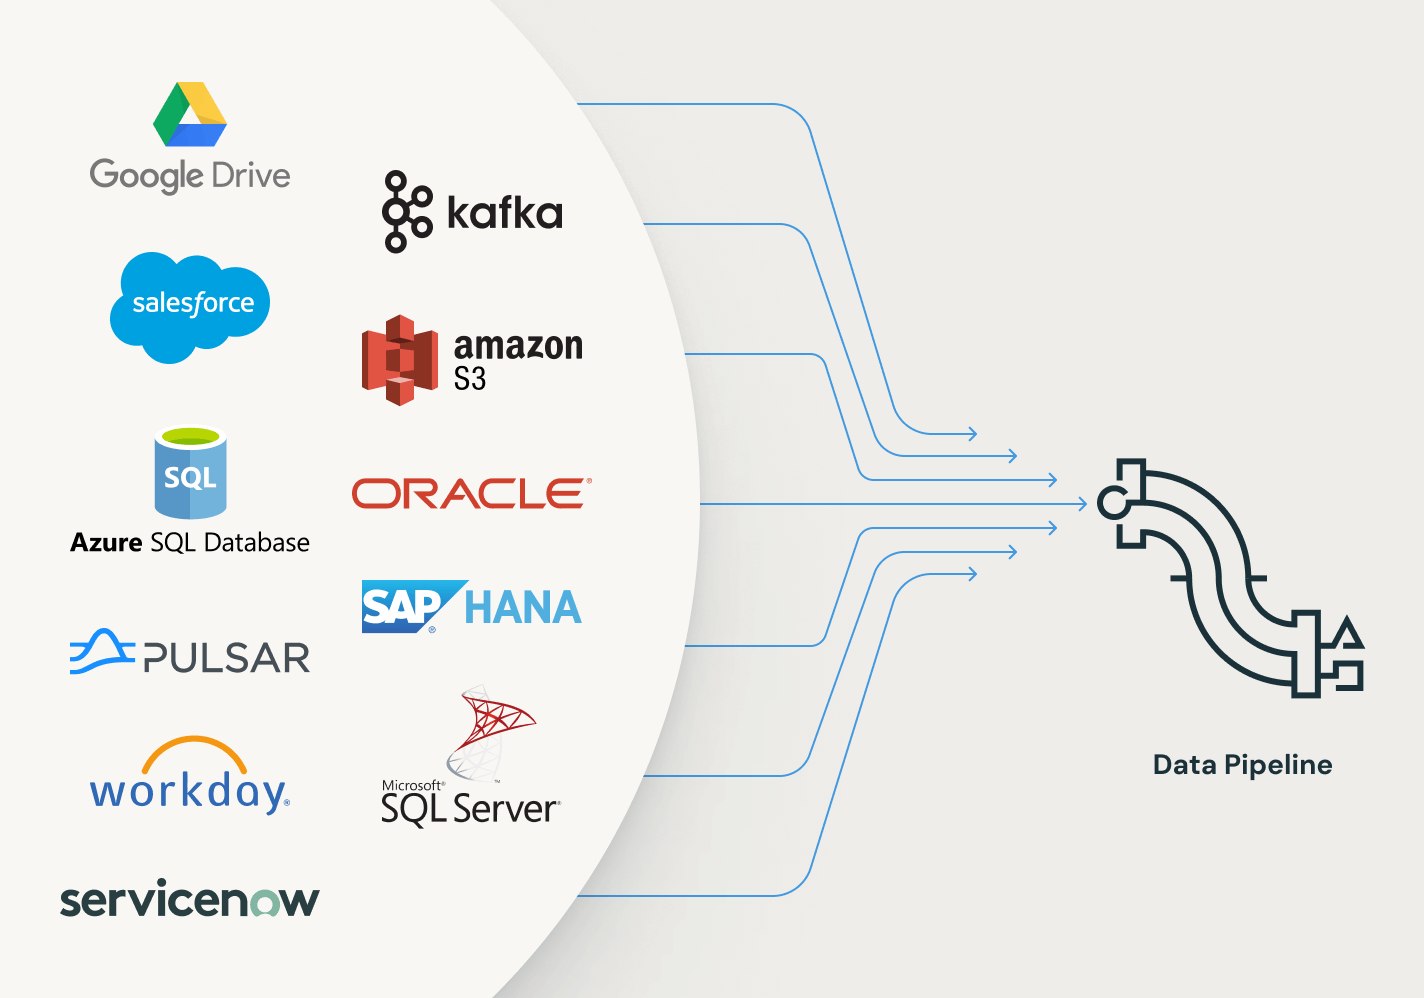
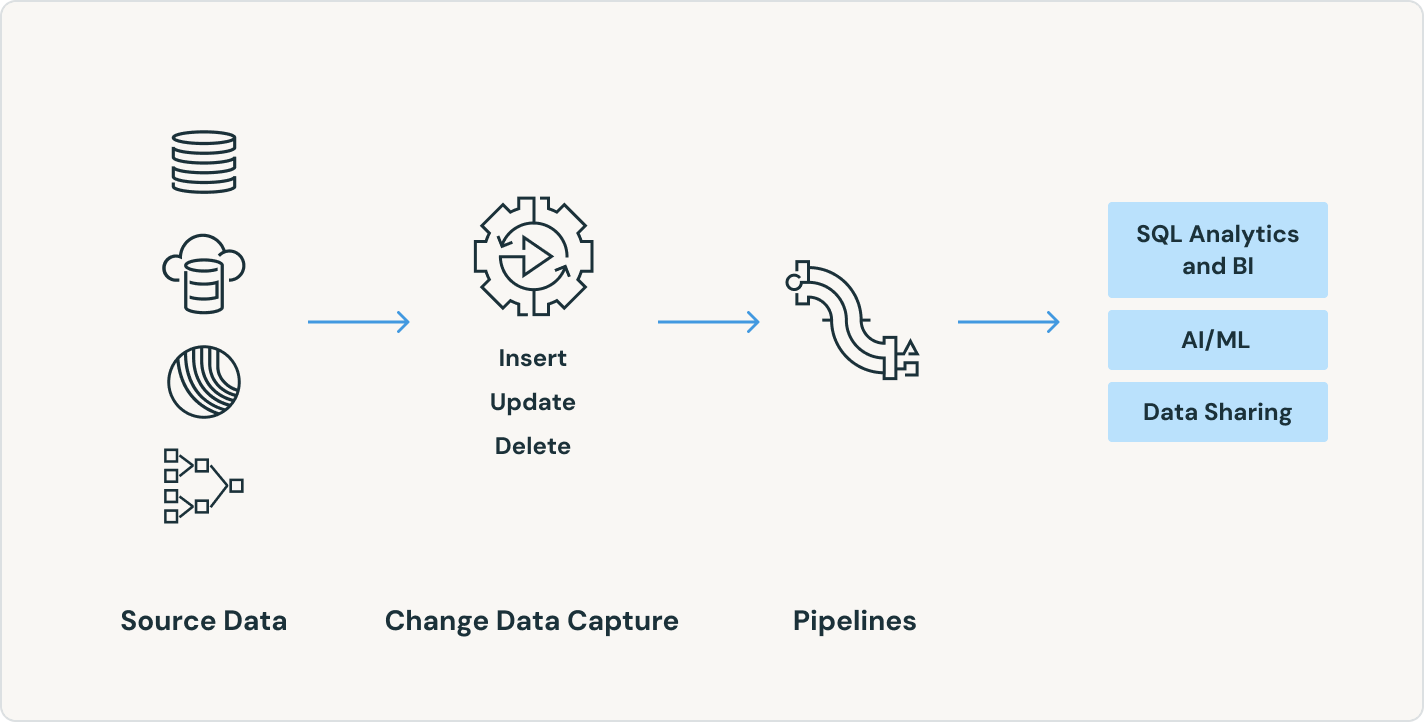
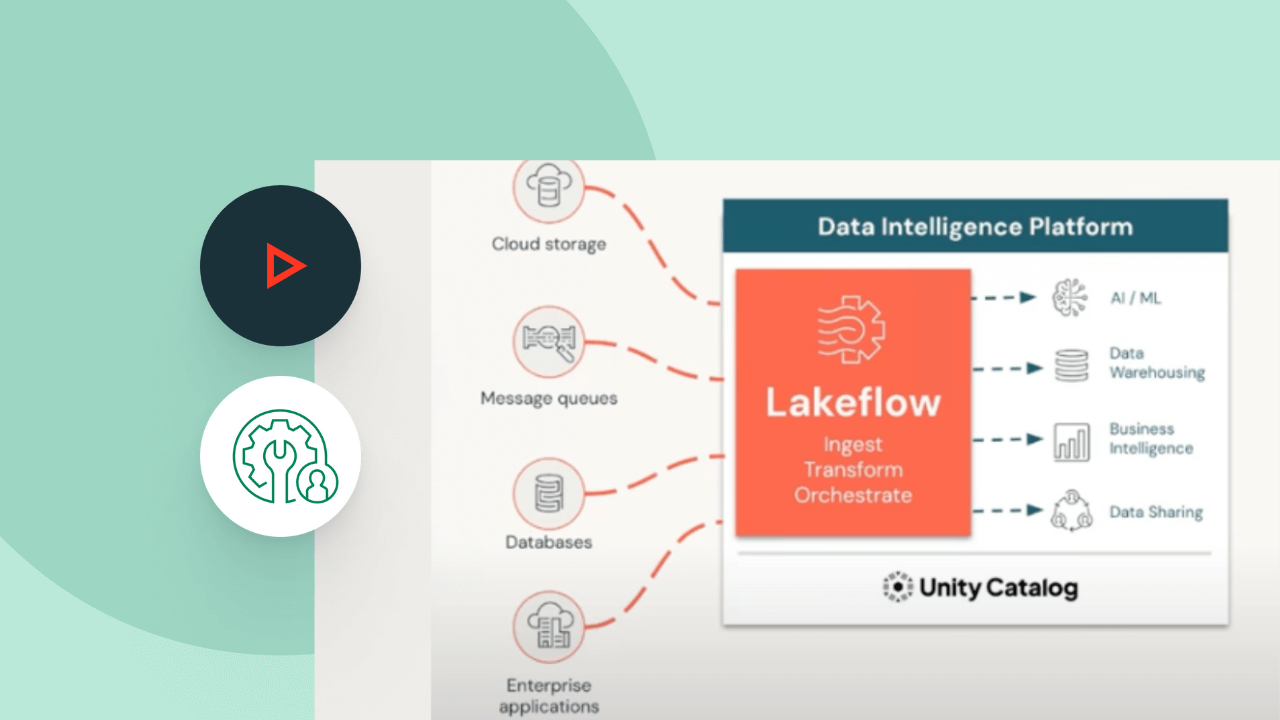
SDP supporta un vasto ecosistema di fonti e destinazioni. Carica dati da qualsiasi fonte, inclusi archiviazione cloud, bus di messaggi, feed di dati di modifica, database e app aziendali.
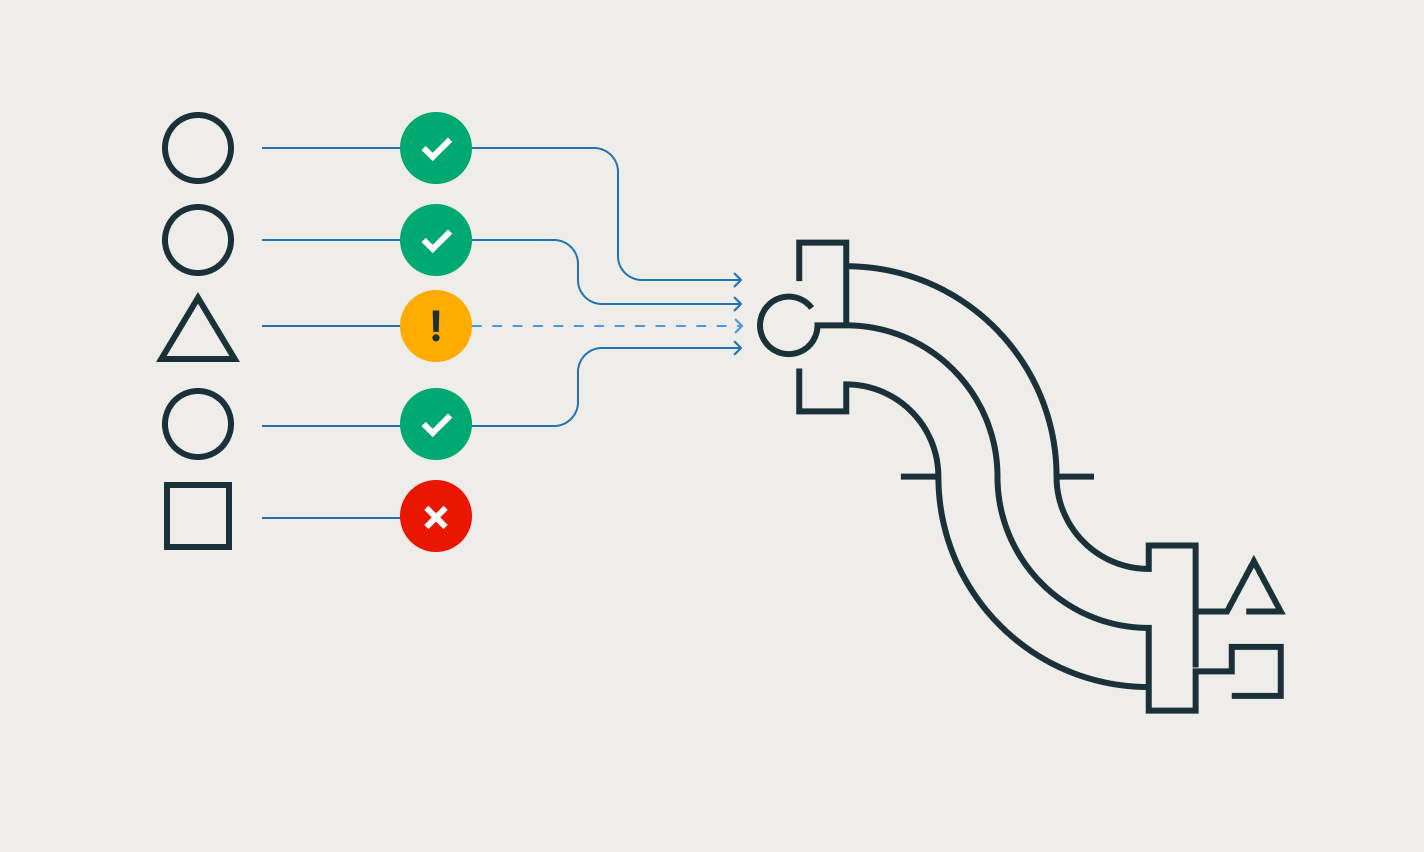
Le aspettative ti permettono di garantire che i dati in arrivo nelle tabelle soddisfino i requisiti di qualità e forniscono informazioni approfondite sulla qualità dei dati a ogni aggiornamento della pipeline.
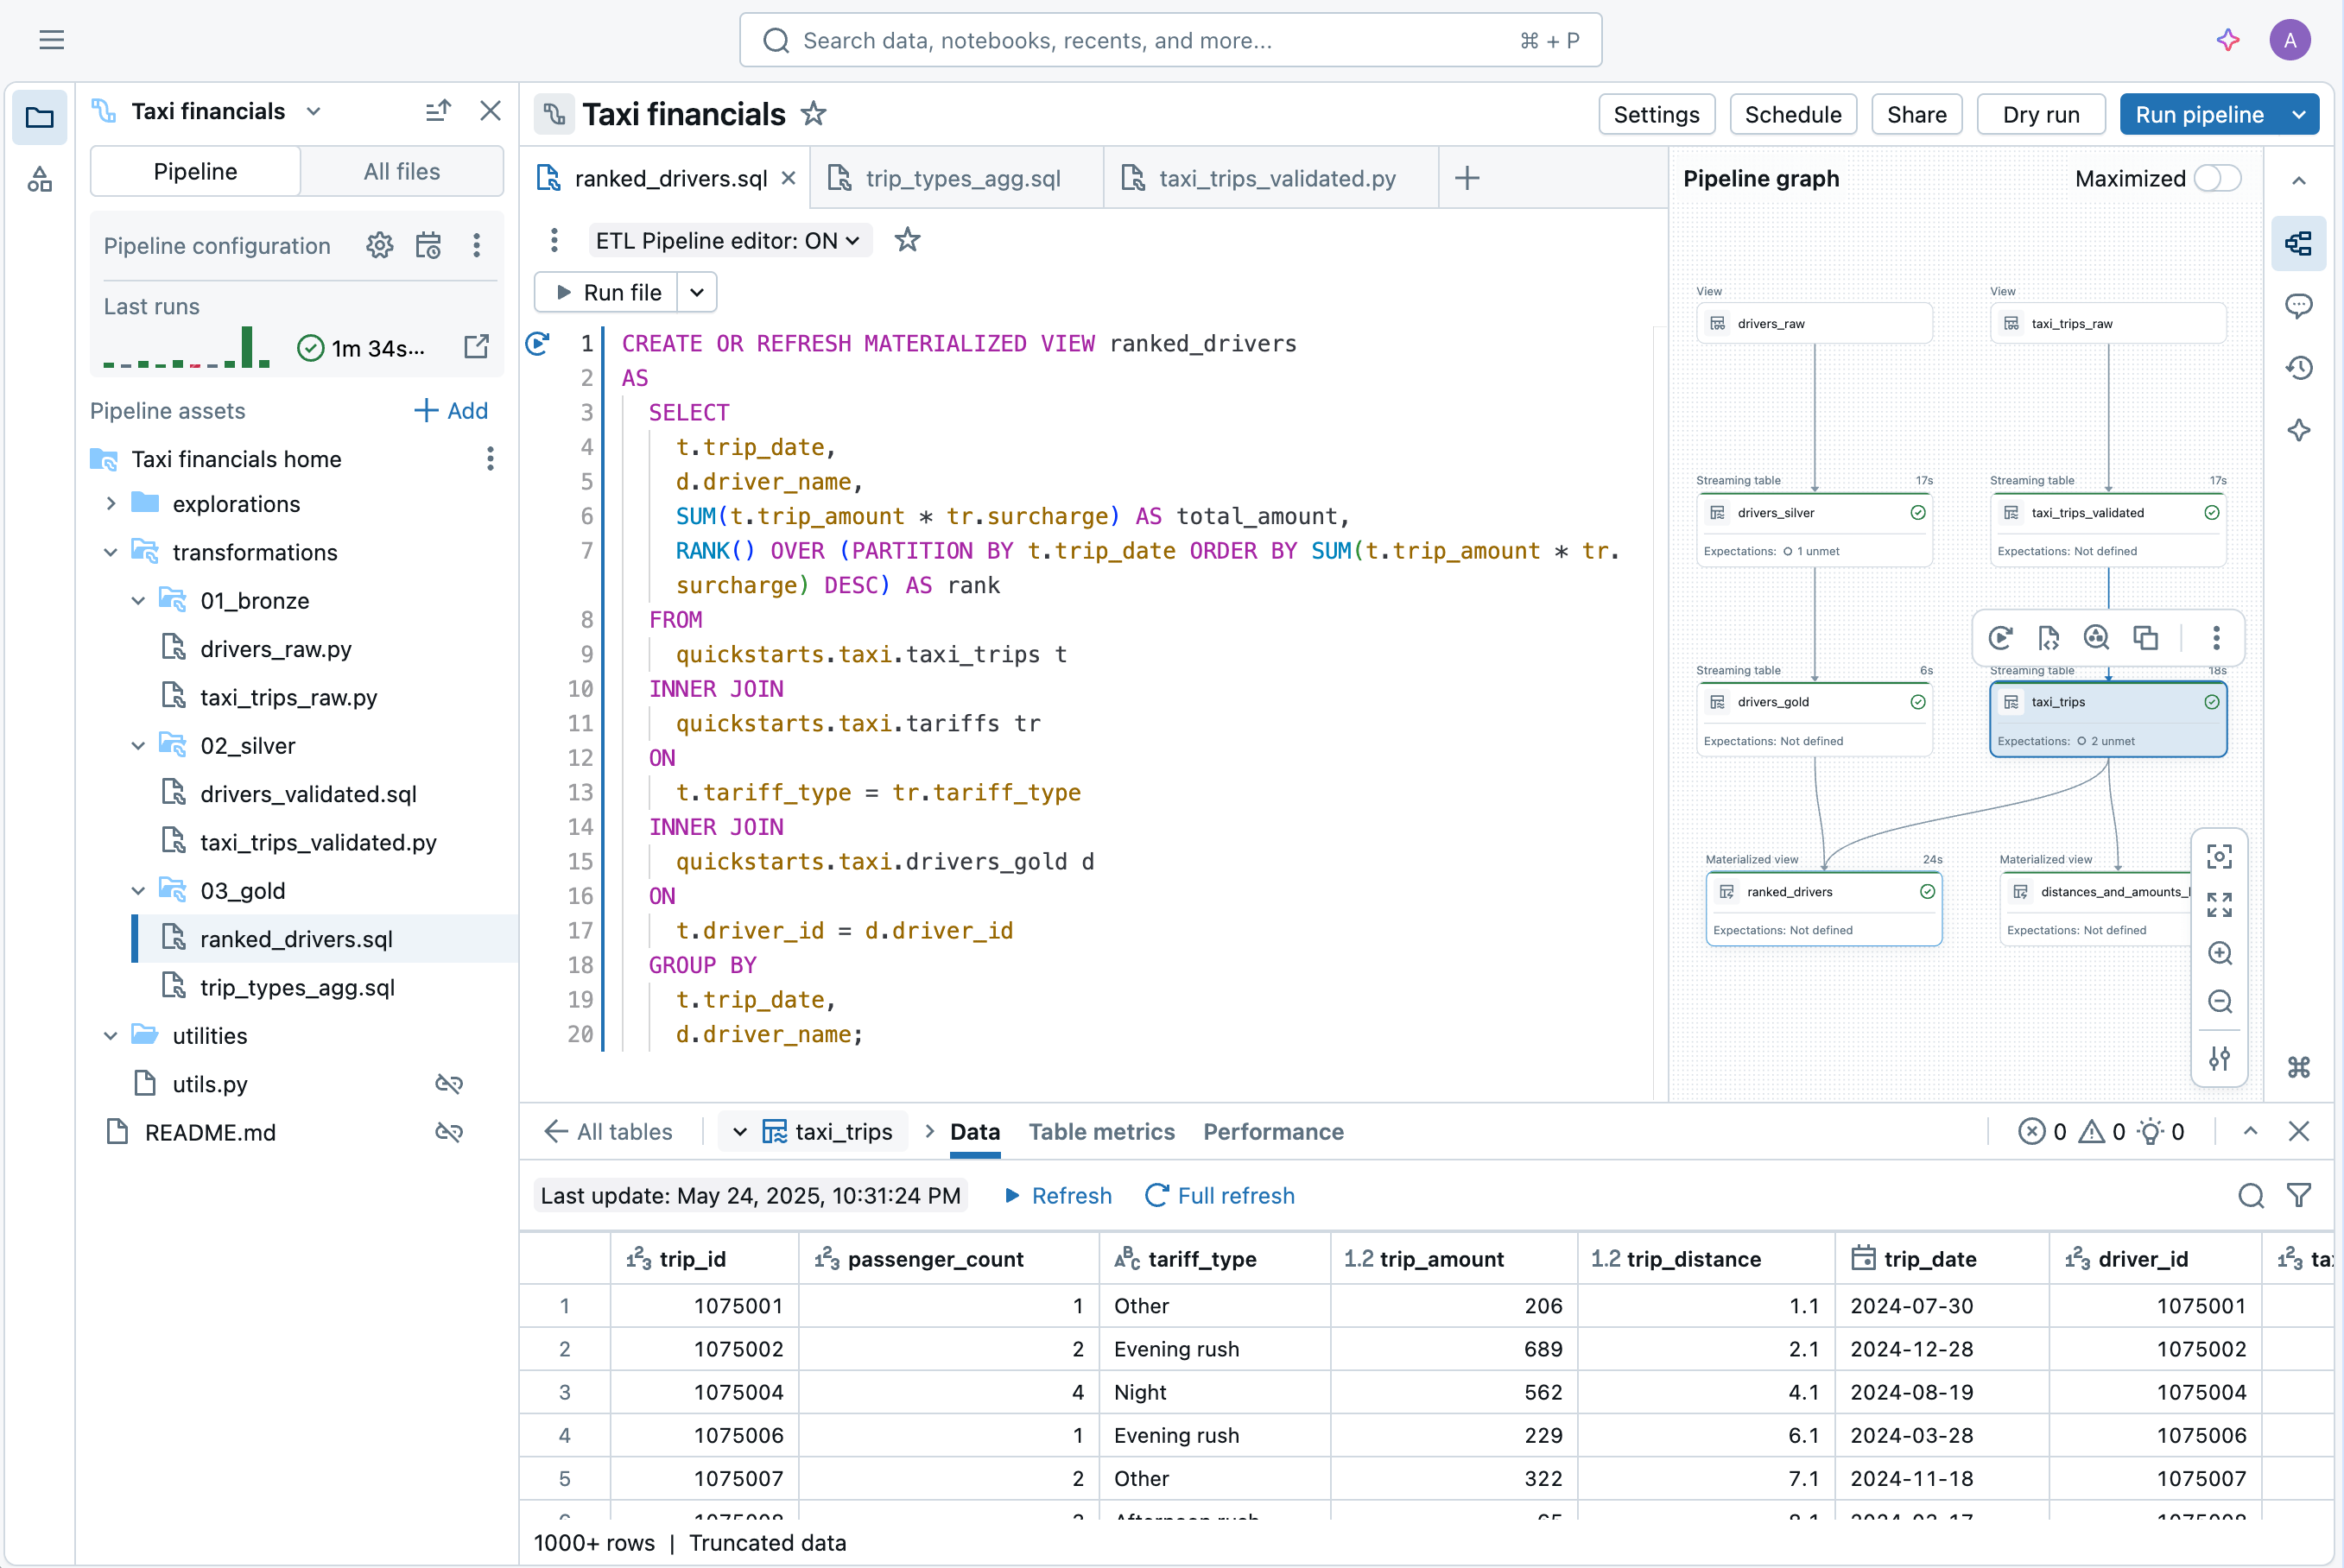
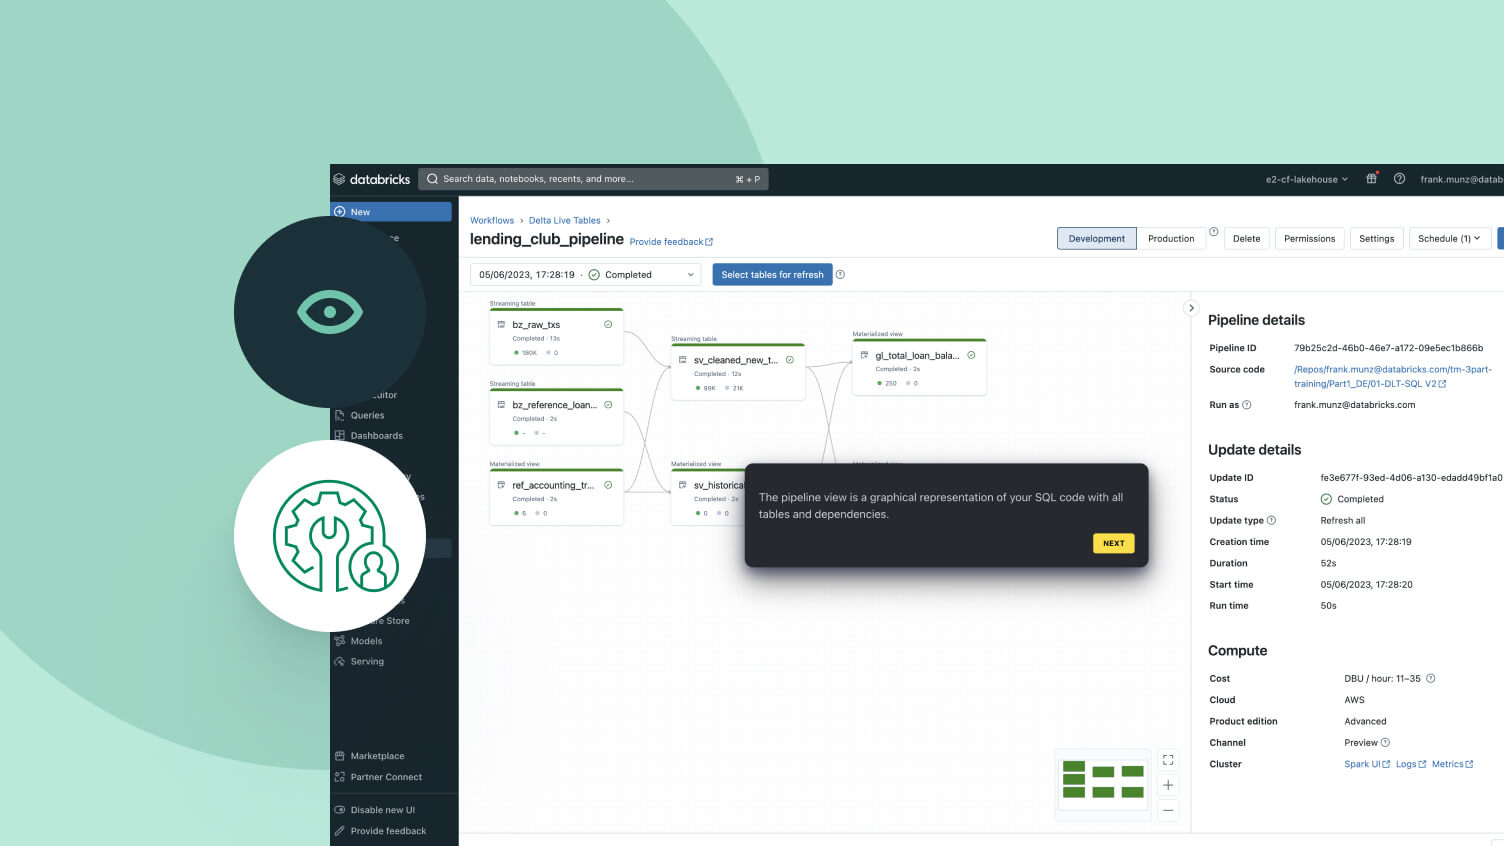
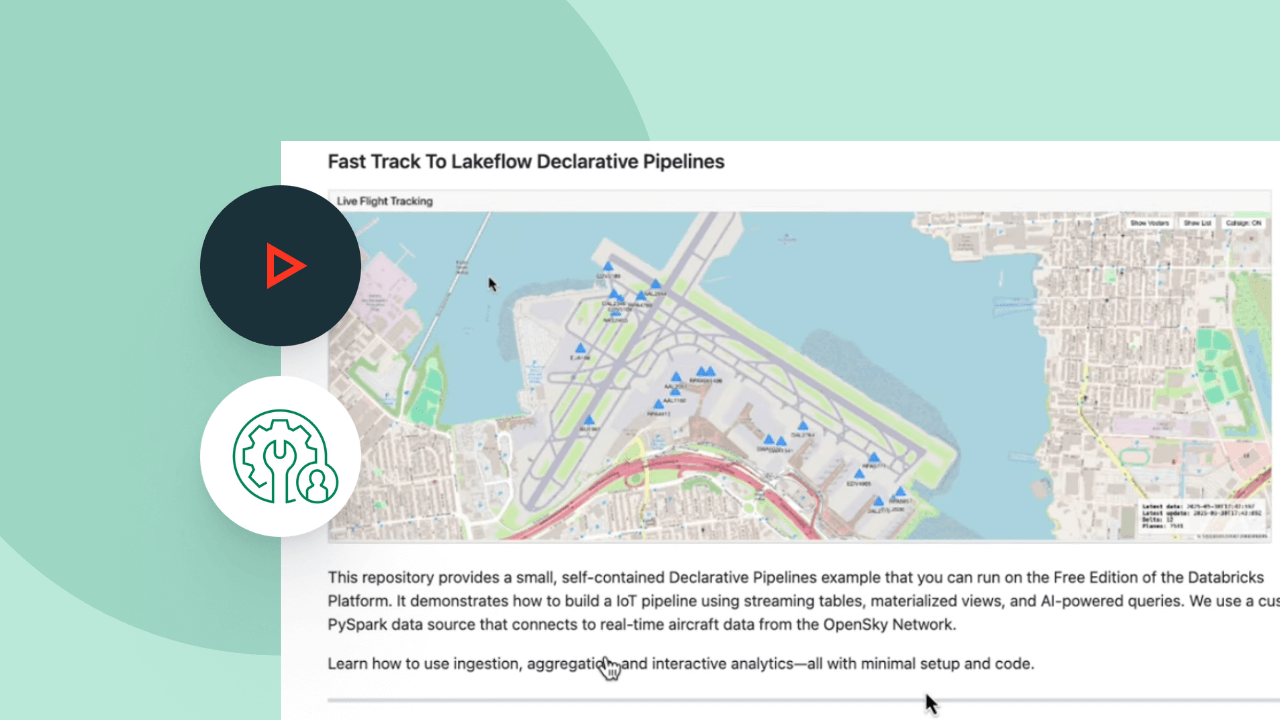
Sviluppa pipeline nell'editor di pipeline Lakeflow, un IDE nativo per il data engineering, senza alcun cambio di contesto. Visualizza il DAG, l'anteprima dei dati e le informazioni sull'esecuzione in un'unica interfaccia utente. Scrivi codice in modo semplice grazie a funzioni di completamento automatico, rilevamento degli errori in tempo reale e diagnostica.
Altre funzioni
Semplifica le tue pipeline di dati

Rendi semplici le fonti, le trasformazioni e le destinazioni
La programmazione dichiarativa ti permette di sfruttare la potenza dell'ETL sulla Databricks Platform con appena qualche riga per esplicitare ciò che vuoi ottenere.
I prezzi basati sull'utilizzo tengono sotto controllo la spesa
Paga solo per i prodotti che utilizzi con una granularità al secondo.Scopri di più
Esplora altre offerte integrate e intelligenti sulla Databricks Data + AI Platform.
Genie Code
Il tuo partner di AI autonoma per il lavoro sui dati.

Lakeflow Connect
Connettori efficienti per l'acquisizione di dati da qualsiasi fonte e l'integrazione nativa con la Databricks Data + AI Platform facilitano l'accesso all'analisi e all'AI, con una governance unificata.

Lakeflow Jobs
Definisci, gestisci e monitora facilmente flussi di lavoro multitask per pipeline di ETL, analisi e machine learning. Grazie a un'ampia gamma di tipologie di task supportati, funzioni di osservabilità approfondita e alta affidabilità, i team di gestione dei dati saranno in grado di automatizzare e orchestrare meglio qualsiasi pipeline e diventare più produttivi.

Archiviazione nel lakehouse
Unifica i dati nel tuo lakehouse, di qualunque formato e tipo, per tutti i tuoi carichi di lavoro di analisi e AI.

Unity Catalog
Gestisci senza interruzioni tutte le tue risorse di dati con l'unica soluzione di governance unificata e aperta del settore per dati e AI, integrata nella Databricks Data + AI Platform.

Document Intelligence
Analizza, estrai e classifica documenti aziendali su larga scala con governance integrata per l'AI agentica.

Databricks Data + AI Platform
Scopri come la Databricks Data + AI Platform abilita i tuoi carichi di lavoro di dati e AI.
Fai il passo successivo
Consulta la documentazione su Spark Declarative Pipelines
Tutto ciò di cui hai bisogno per iniziare a utilizzare Spark Declarative Pipelines negli ambienti AWS, Microsoft Azure o Google Cloud Platform.
Prova Databricks gratuitamente
Inizia una prova gratuita o semplicemente registrati per la Free Edition.
Contenuti associati
Domande frequenti su Spark Declarative Pipelines
Spark Declarative Pipelines (SDP) è un framework aperto che semplifica il data engineering in batch e in streaming su Apache Spark. Consentendo ai team di dati e agli agenti di coding di dichiarare gli stati dei dati di destinazione anziché scrivere codice procedurale, SDP risolve automaticamente le dipendenze, garantisce le aspettative di qualità dei dati e si occupa della gestione incrementale dello stato.
Vuoi diventare un'azienda basata su dati e AI?
Inizia il percorso di trasformazione