Che cos'è l'AIOps?
L'AIOps combina AI e machine learning con l'osservabilità per automatizzare le operazioni IT. Esplora i suoi componenti chiave, i vantaggi, i casi d'uso e le sfide.
- L'AIOps (Artificial Intelligence for IT Operations) applica l'AI, il machine learning e i dati operativi per rilevare anomalie, correlare eventi, identificare le cause principali e automatizzare la risposta agli incidenti.
- Aiuta i team di IT e platform engineering a ridurre il rischio di downtime, limitare l'affaticamento da alert, accelerare i tempi decisionali e ridurre il tempo medio di risoluzione (MTTR).
- L'AIOps integra l'osservabilità e le pratiche DevOps convertendo i segnali grezzi di sistema in intelligence operativa fruibile, mantenendo al contempo la supervisione human-in-the-loop per le azioni a rischio più elevato.
L'Artificial Intelligence for IT Operations (AIOps) applica l'AI e il machine learning alle operazioni IT per rilevare anomalie, correlare eventi, identificare le cause principali e attivare risposte più velocemente di qualsiasi processo manuale.
Gartner ha coniato il termine nel 2017. Allora perché ne parliamo proprio ora?
Perché l'infrastruttura che eseguirà le tue applicazioni nel 2026 non ha nulla a che fare con ciò per cui è stato progettato il monitoraggio tradizionale. Ti trovi a gestire centinaia di microservizi, dipendenze multi-cloud, carichi di lavoro AI e sistemi basati su agenti che generano più segnali operativi in un'ora di quanti un ingegnere reperibile possa leggerne in una settimana.
Questo divario è proprio ciò che l'AIOps è ora in grado di colmare. Questa guida spiega come funziona, dove si colloca e cosa valutare prima di scegliere una piattaforma.
- L'AIOps applica l'AI e il machine learning alle operazioni IT per rilevare anomalie, correlare eventi, identificare le probabili cause principali e consentire una risposta più rapida agli incidenti.
- L'AIOps aiuta i team a ridurre il rischio di tempi di inattività, limitare l'affaticamento da avvisi, migliorare la velocità decisionale e accelerare la risposta agli incidenti, trasformando i dati operativi in insight azionabili.
- L'AIOps integra l'osservabilità e il DevOps anziché sostituirli, potenziando il lavoro degli ingegneri AI e di piattaforma con l'intelligenza operativa, pur mantenendo la supervisione umana per le azioni a maggior rischio.
Cosa fa e cosa non fa l'AIOps
L'AIOps analizza i dati provenienti da log, tracce, eventi e topologia di rete per rilevare problemi e prevedere guasti prima che si trasformino in incidenti.
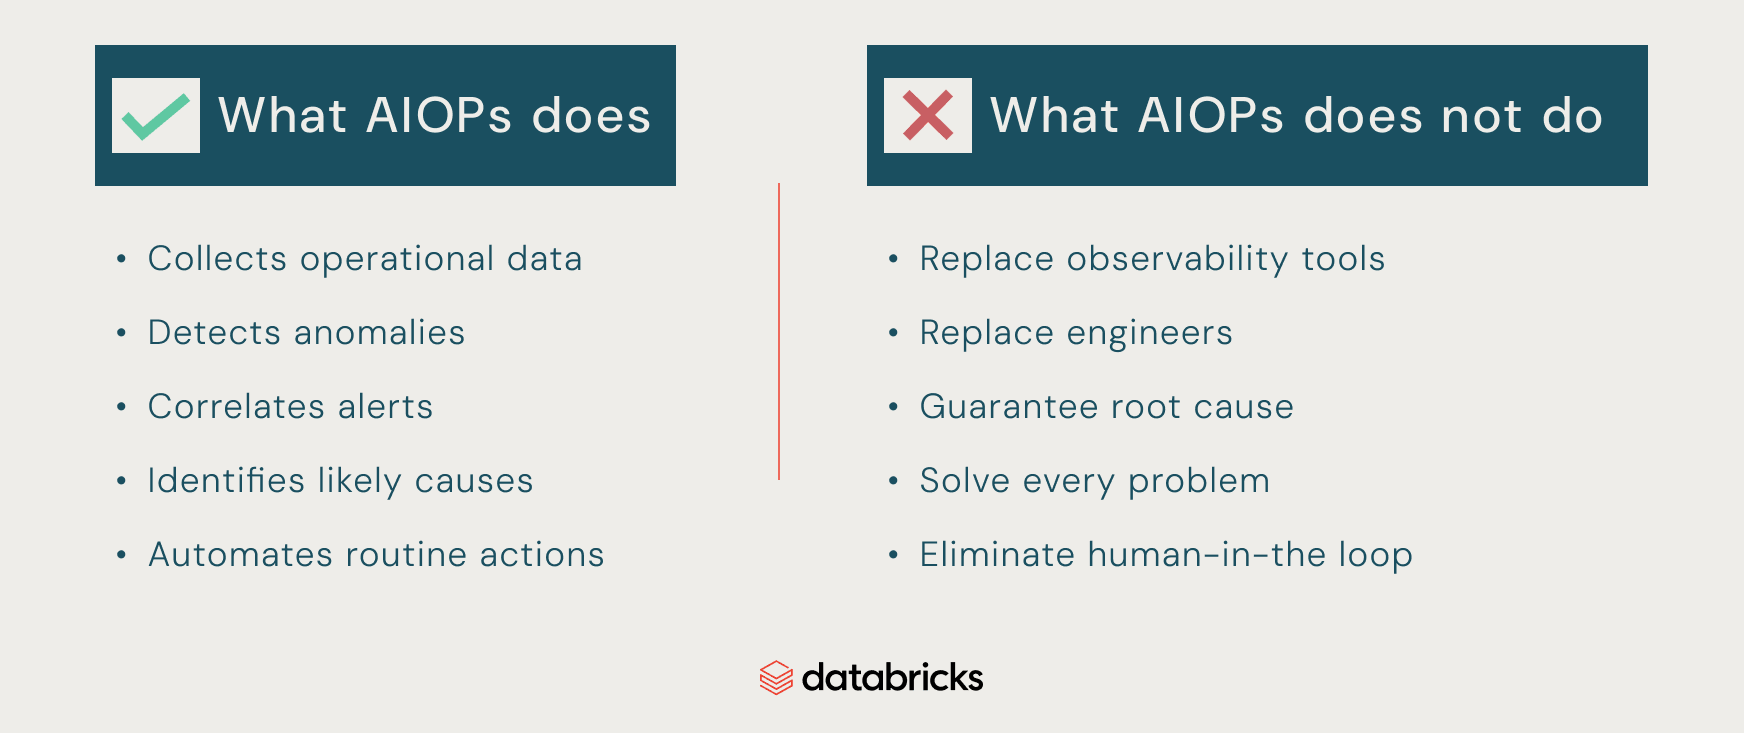
Si colloca tra l'osservabilità e l'azione. L'osservabilità indica cosa sta accadendo nei sistemi. L'AIOps riceve quel segnale, riduce il rumore, collega gli eventi correlati e aiuta gli ingegneri di piattaforma a decidere come procedere. Non sostituisce l'osservabilità, il DevOps o il giudizio umano: rende tutti e tre più veloci.
Perché proprio ora?
Man mano che l'infrastruttura diventa più distribuita, il volume dei dati operativi, la complessità delle dipendenze e la velocità del cambiamento aumentano costantemente. Gli strumenti di monitoraggio tradizionali non soddisfano le crescenti esigenze e spesso generano un rumore eccessivo, privo del contesto chiaro necessario per dare priorità alle minacce. Di conseguenza, i team di dati faticano a identificare i segnali importanti prima che gli incidenti abbiano un impatto sugli utenti.
Quando i team sfruttano l'AI e il machine learning nelle operazioni IT, ottimizzano i processi per:
- Ridurre il rischio di tempi di inattività: l'AIOps è in grado di rilevare anomalie e correlare eventi correlati per identificare tempestivamente potenziali guasti, aiutando a risolvere i problemi prima che interrompano i servizi principali e causino tempi di inattività.
- Ridurre l'affaticamento da avvisi: il machine learning può filtrare gli avvisi ripetitivi o di scarso valore e mettere in evidenza gli eventi che hanno maggiore probabilità di richiedere l'intervento umano.
- Migliorare la velocità decisionale: aggiungendo contesto agli eventi operativi e identificando le probabili cause principali, l'AIOps aiuta gli ingegneri a determinare cosa sta accadendo e su cosa indagare successivamente.
- Accelerare la risposta agli incidenti: quando si conosce la soluzione appropriata, l'AIOps può consigliare o automatizzare azioni come il riavvio dei servizi, il dimensionamento delle risorse o l'attivazione di workflow predefiniti.
Questi fattori mirano specificamente a un rilevamento tempestivo delle minacce e a un ripristino più rapido. Non intendono implicare che l'AIOps risolva tutti i colli di bottiglia dell'automazione o elimini la necessità di ingegneri.
Quali sono i componenti fondamentali dell'AIOps?
Quando si valuta una piattaforma AIOps, è importante comprendere i blocchi costruttivi principali e il modo in cui operano nei rispettivi ambiti:
- Ingestione dei dati: in questa fase, le piattaforme AIOps raccolgono e consolidano dati da metriche, log, tracce, eventi e avvisi provenienti da infrastrutture, applicazioni e dispositivi di rete in un data lake, data warehouse o lakehouse. Un'ingestione di dati ampia e affidabile offre all'AIOps la visibilità necessaria per rilevare problemi in tutti gli ambienti IT.
- Normalizzazione e arricchimento dei dati: dopo che l'AIOps ha raccolto i dati da varie fonti, i processi di analisi elaborano i dati grezzi per evidenziare le tendenze, prevedere le esigenze di capacità degli ambienti e rilevare comportamenti insoliti del sistema prima che causino interruzioni. Ciò fornisce alle analisi a valle una visione coerente di ciò che sta accadendo e dei punti critici.
- Rilevamento delle anomalie. Per rilevare attività insolite nei sistemi, i metodi tradizionali si affidano a soglie statiche, limiti di CPU e misure simili per attivare gli avvisi, senza alcun tipo di contesto. L'AIOps apprende l'aspetto di un comportamento normale per ciascuna metrica, in base a ora, giorno e stagione. Successivamente, invia avvisi solo quando tale comportamento devia dalla baseline. Questo offre agli ingegneri AI più tempo per indagare su potenziali problemi prima che abbiano un impatto sugli utenti.
- Correlazione degli eventi. Quando 10 server diversi mostrano un utilizzo elevato della CPU, l'AIOps collega gli avvisi correlati anziché trattare ciascun avviso come un incidente isolato. Ciò riduce l'affaticamento da avvisi e aiuta a concentrarsi sul problema di fondo anziché su centinaia di singoli eventi.
- Analisi delle cause principali. Il vecchio metodo, in cui si attivano 70 avvisi e si segue ciascuno di essi, è insostenibile. L'AIOps comprende la topologia del sistema, esamina i servizi dipendenti durante gli avvisi ed evidenzia la causa principale del problema. Dagli avvisi, l'AIOps determina che il servizio C è degradato, mentre i servizi A e B si trovano solo a valle. Ciò accelera la risoluzione dei problemi, riduce al minimo i tempi di inattività aziendali e fa risparmiare tempo evitando indagini per singolo incidente.
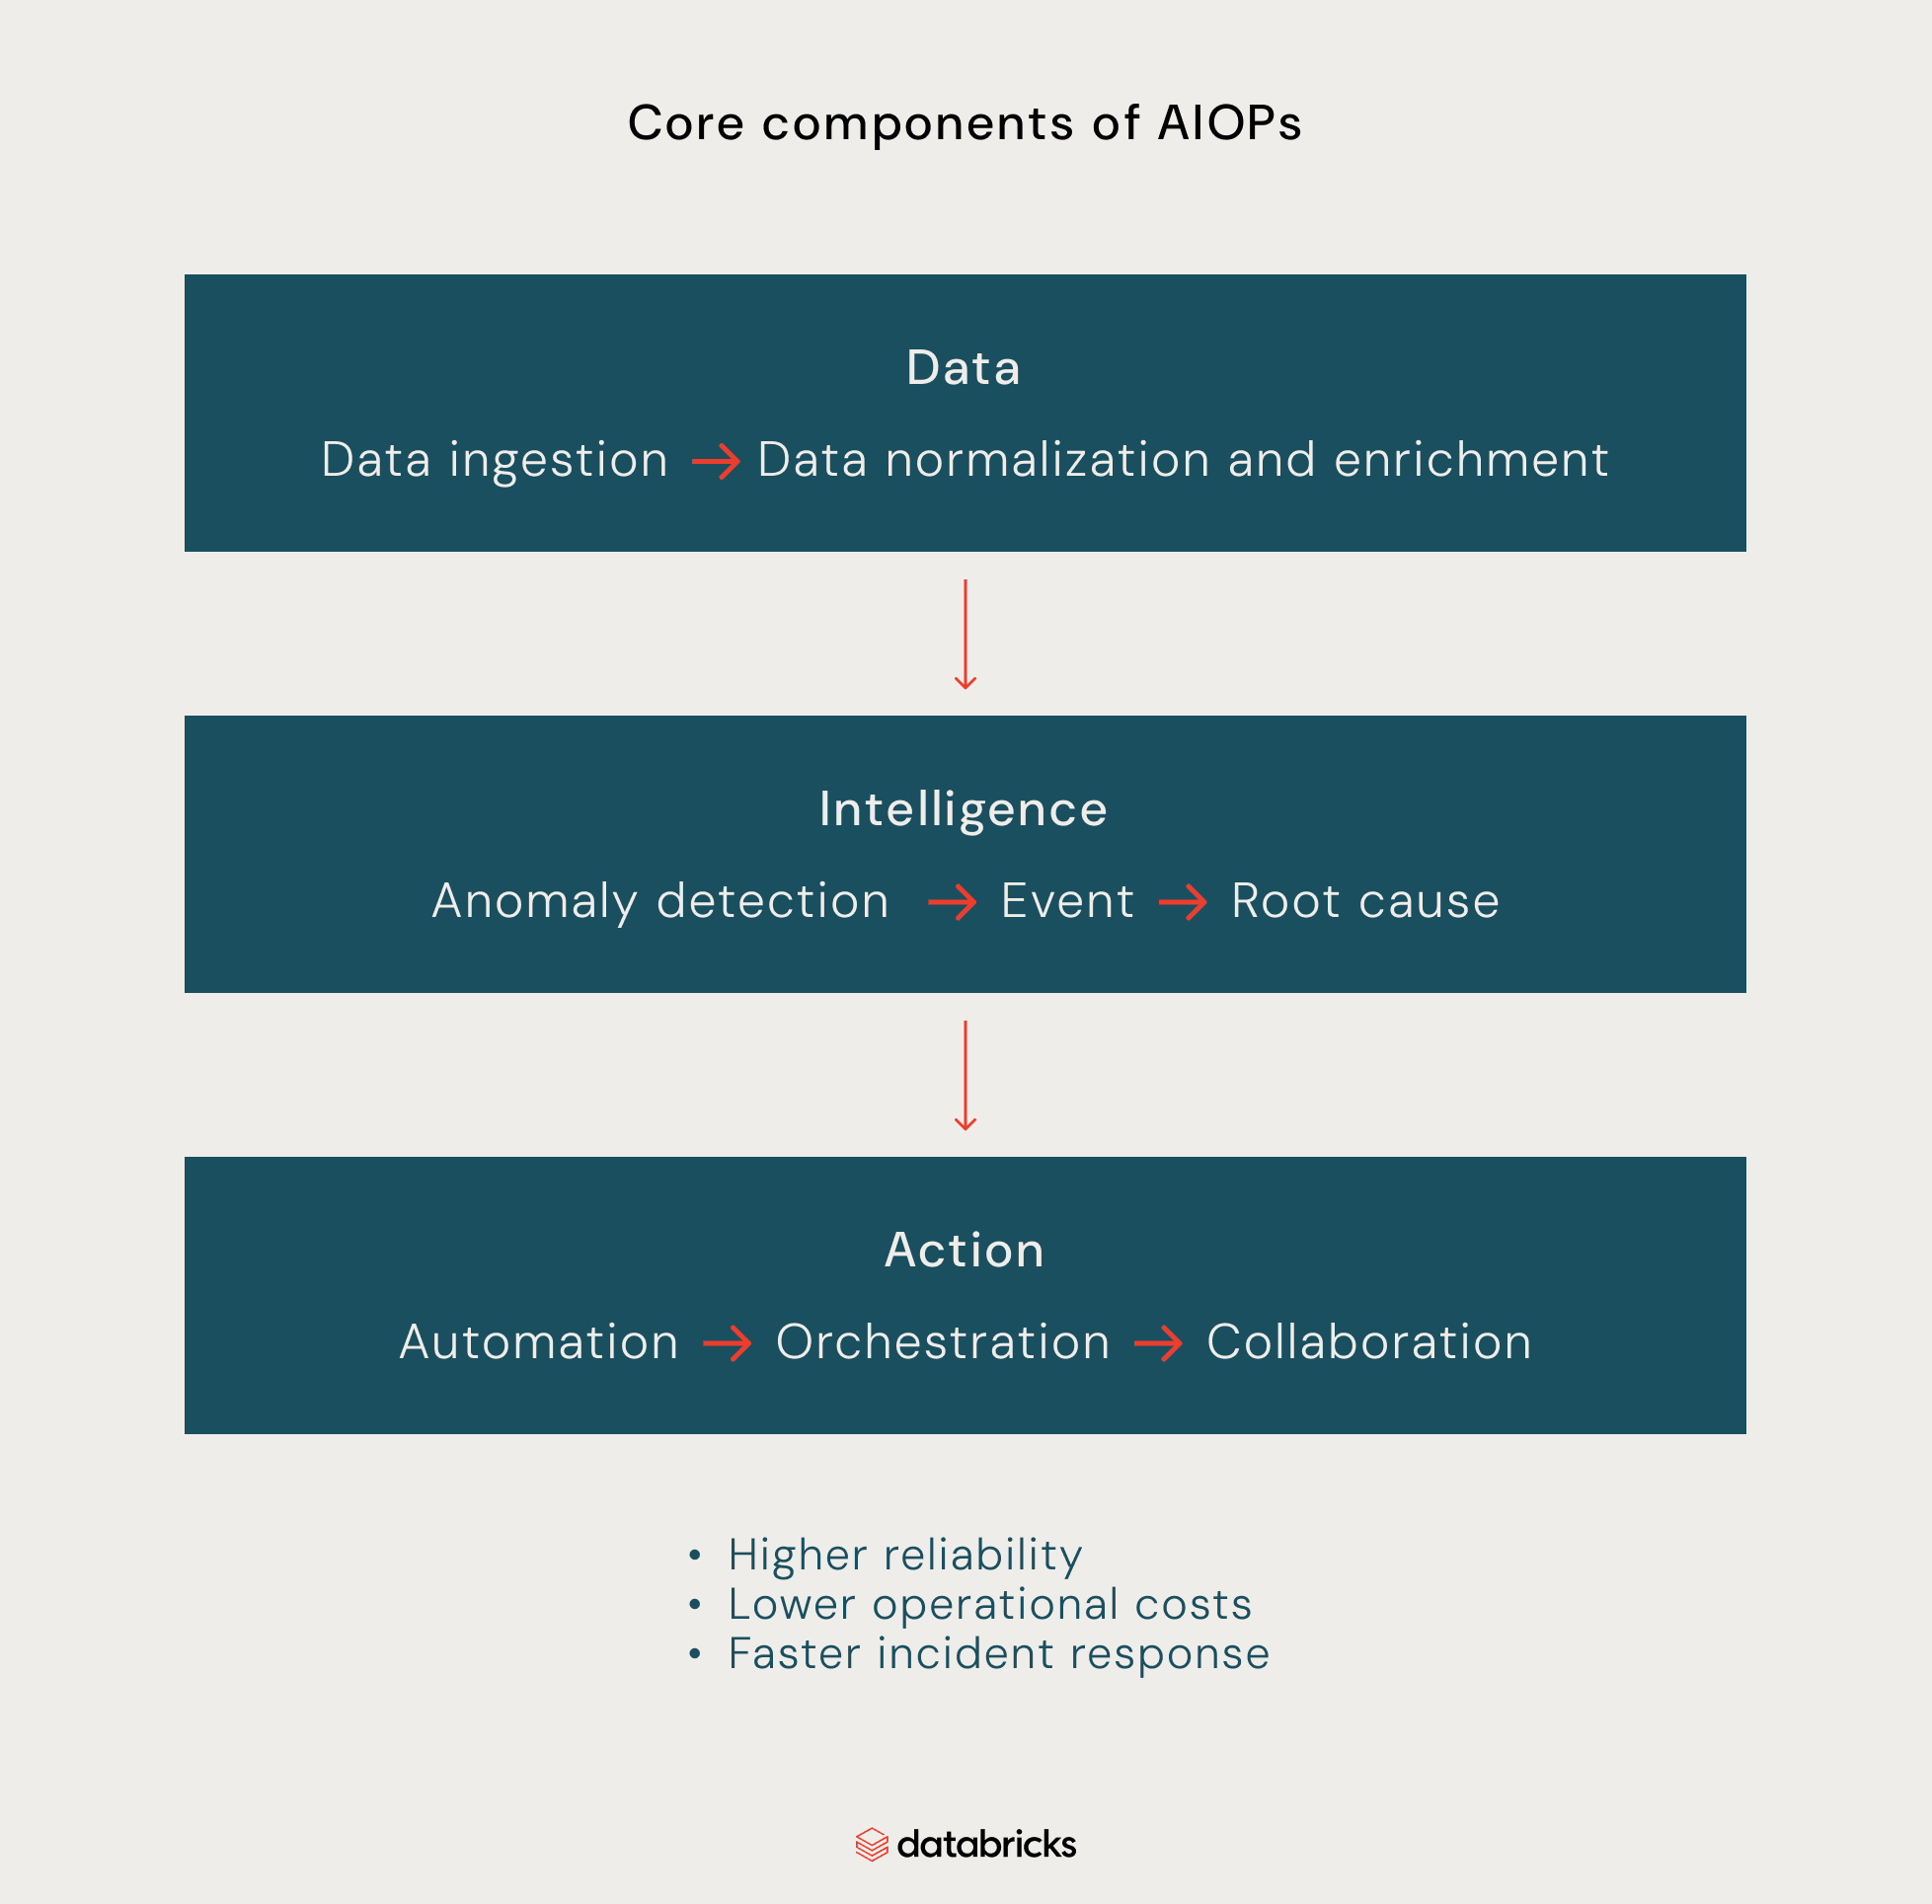
- Automazione e orchestrazione. Una volta identificata la causa principale, l'AIOps trasforma questi insight in azioni consigliando o eseguendo risposte predefinite, come il riavvio di un servizio, il dimensionamento dell'infrastruttura, il rollback di un deployment o l'apertura di un ticket. Questo componente riduce l'intervento manuale, accelera la risoluzione degli incidenti e aiuta a controllare i costi operativi. Per workflow operativi più avanzati, Agent Bricks può aiutare i team a creare e distribuire agenti AI che utilizzano dati e strumenti aziendali per eseguire attività in più passaggi.
- Workflow di collaborazione. Collegano gli insight di AIOps alle persone e ai processi responsabili della risoluzione degli incidenti. Ciò può includere l'instradamento degli avvisi, l'assegnazione della proprietà, l'escalation degli incidenti e la fornitura agli ingegneri del contesto necessario per rispondere.
Dopo aver visto questi componenti fondamentali, scopriamo come si integrano nella sezione seguente.
Come funziona l'AIOps?
Il processo AIOps inizia con la raccolta di segnali da applicazioni, infrastrutture, reti e servizi cloud. I dati vengono quindi sottoposti a pulizia, in cui i segnali duplicati, incompleti o incoerenti vengono organizzati in un formato che l'AIOps può analizzare.
Ad esempio, il sistema rileva che l'applicazione inizia improvvisamente a restituire un numero elevato di errori di Application Programming Interface (API). L'AIOps confronta il comportamento corrente dell'applicazione con i pattern precedenti e segnala l'aumento degli errori come insolito.
Grazie alla correlazione degli eventi, la piattaforma AIOps collega gli errori API ad altri segnali, come un improvviso aumento del carico del database o un deployment recente. L'analisi delle probabili cause esamina quindi questi segnali collegati per determinare le cause più plausibili. Invece di trattare gli errori API, il carico del database e il deployment come eventi distinti, l'AIOps identifica il deployment recente come la probabile origine dell'incidente.
La fase finale è la risposta guidata o automatizzata. A seconda del workflow, l'AIOps può consigliare un'azione correttiva, aprire un ticket, notificare il team appropriato o eseguire automaticamente una risposta predefinita, come il rollback del deployment.
Le azioni a maggior rischio dovrebbero richiedere un approccio human-in-the-loop per consentire agli ingegneri di esaminare e approvare la risposta prima che influisca sulla produzione.
Quali sono le principali tipologie di AIOps?
Le tipologie di AIOps dipendono da ciò che meglio si adatta all'organizzazione, dall'ambito delle sue operazioni, dai sistemi da gestire e dal livello di interconnessione dell'infrastruttura.
Gli approcci domain-centric e domain-agnostic sono le due tipologie principali di AIOps. Nessuno dei due sostituisce direttamente l'altro; ciascuno presenta punti di forza e compromessi:
La AIOps domain-centric si concentra su un'area specifica, come la gestione del cloud, le prestazioni di rete o il monitoraggio delle applicazioni. Un approccio domain-centric è ideale per risolvere i problemi relativi a un dominio specifico, poiché fornisce un contesto più approfondito e un'analisi più specializzata all'interno di quell'ambiente.
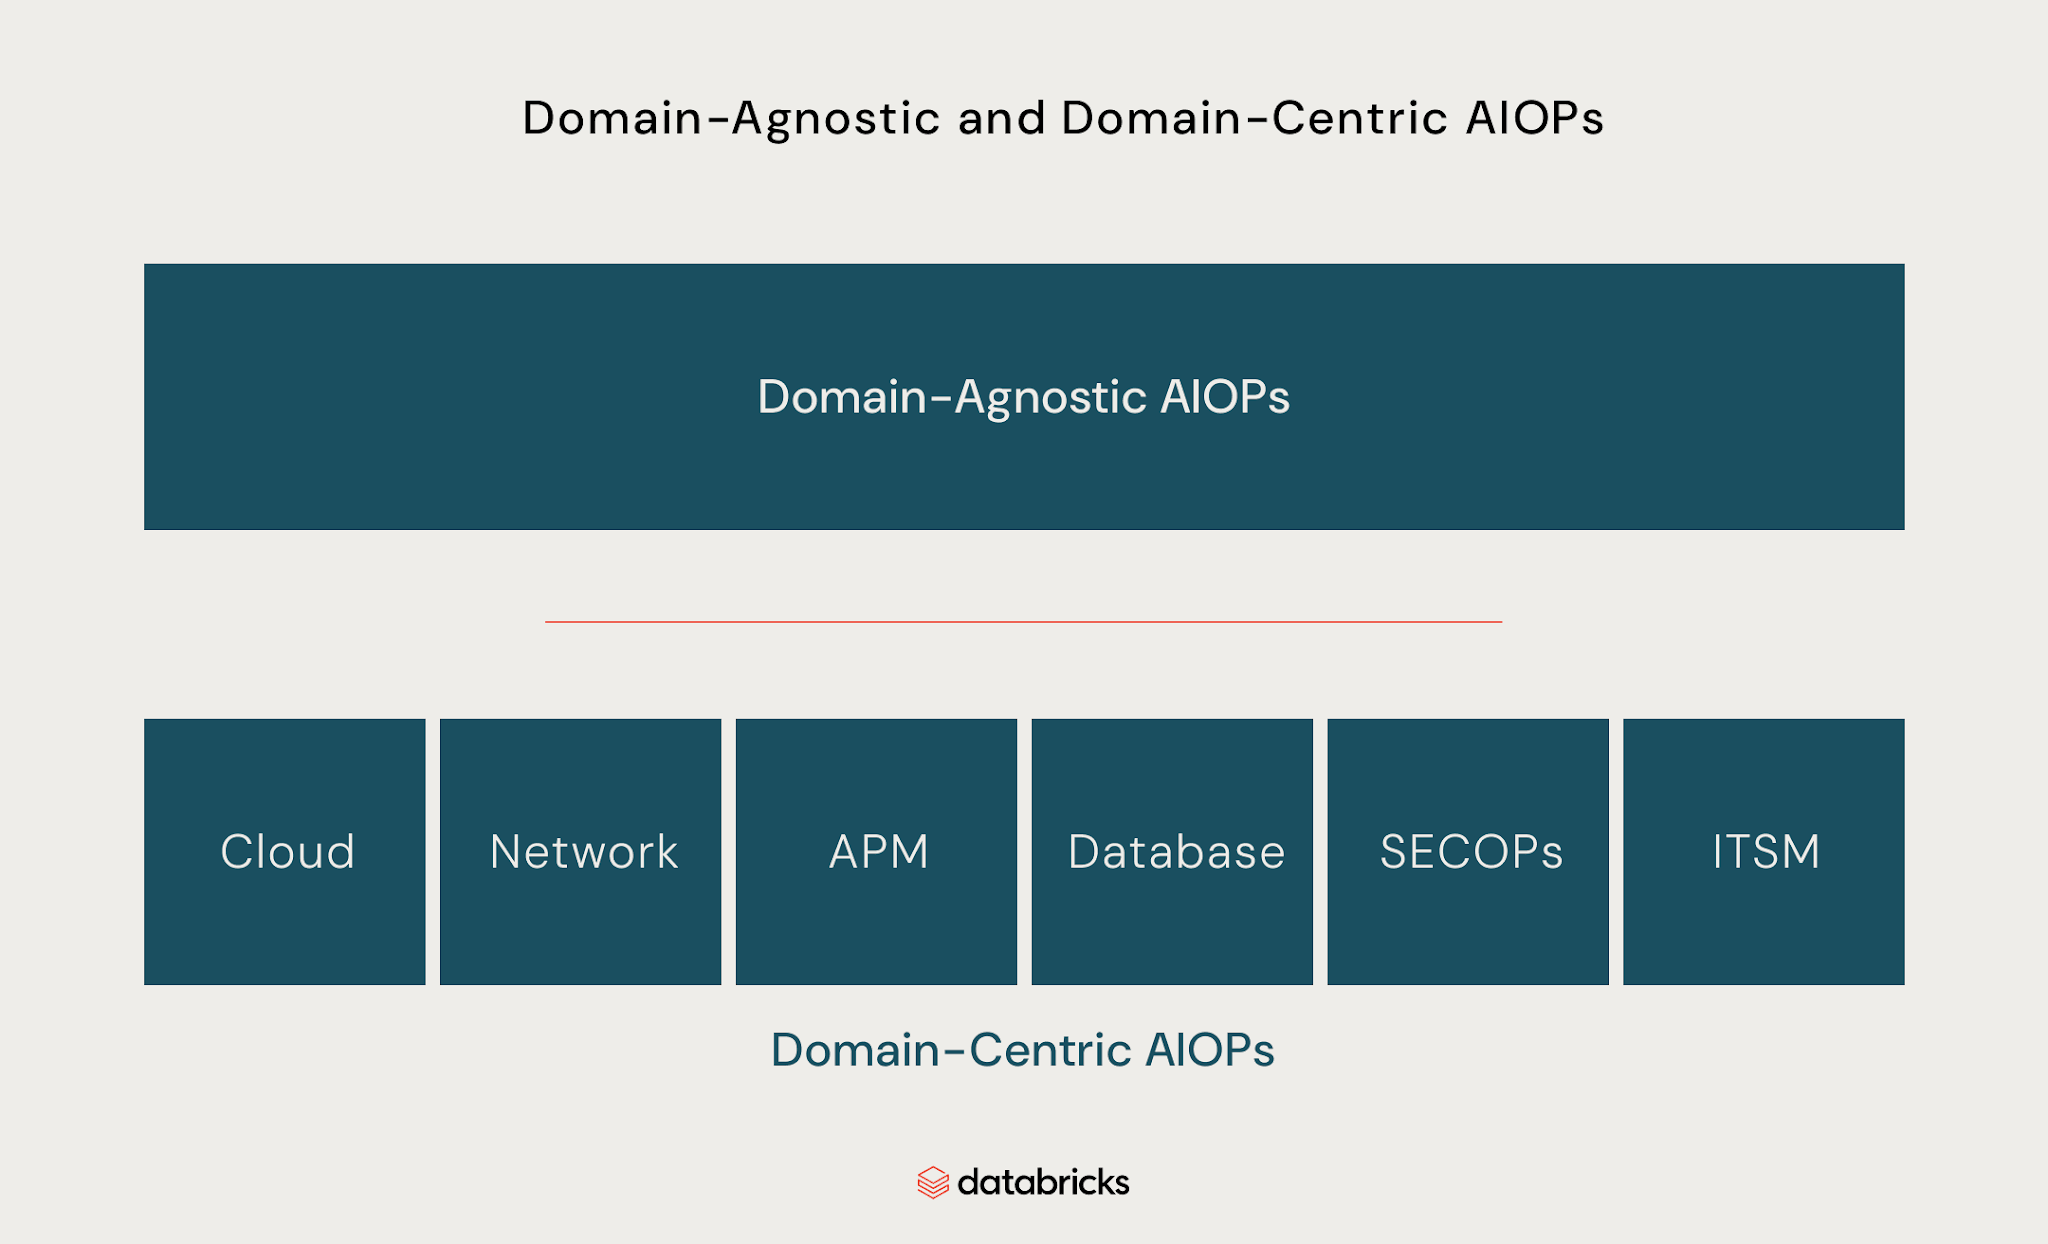
La AIOps domain-agnostic opera su più ambienti IT, raccogliendo e analizzando dati da sistemi quali applicazioni, reti, infrastrutture cloud e storage. Contrariamente all'approccio domain-centric, le piattaforme AIOps domain-agnostic sono ideali per risolvere problemi più ampi. Ciò le rende più adatte per le organizzazioni che gestiscono infrastrutture complesse e interconnesse, dove gli incidenti spesso superano i confini operativi.
La AIOps domain-centric può fornire una maggiore profondità e un'intelligence più specializzata all'interno di un singolo dominio, mentre la AIOps domain-agnostic offre una portata più ampia e una maggiore visibilità su sistemi e strumenti.
Casi d'uso comuni della AIOps
I casi d'uso della AIOps coprono molte aree delle operazioni IT; alcune delle applicazioni più comuni includono:
Analisi delle cause alla radice
La AIOps aiuta a individuare la causa probabile di un'interruzione, di un errore o di un problema di prestazioni. Invece di trattare un picco di errori API come un incidente isolato, la AIOps può correlarlo a un deployment recente, a un guasto del database o a una modifica della configurazione di rete.
Rilevamento delle anomalie
La AIOps analizza continuamente i dati di sistema per stabilire una baseline e rilevare deviazioni che potrebbero causare incidenti e guasti.
Monitoraggio delle prestazioni
La AIOps può monitorare gli ambienti IT in contesti cloud, on-premise e ibridi con servizi e dipendenze interconnessi. Ciò aiuta a identificare i trend e a dare priorità ai problemi attraverso un monitoraggio costante e la correlazione delle prestazioni.
Adozione e migrazione al cloud
Le migrazioni al cloud introducono nuove dipendenze tra carichi di lavoro, API, servizi e infrastruttura. La AIOps mappa queste relazioni, monitora i cambiamenti nel comportamento del sistema e identifica i potenziali colli di bottiglia prima che interrompano i servizi critici. La AIOps offre una visibilità più chiara negli ambienti ibridi e multicloud durante la migrazione.
Adozione di DevOps
DevOps aumenta la velocità di sviluppo e deployment, ma introduce anche rischi operativi e problemi che potrebbero non essere rilevati dall'uomo. La AIOps monitora l'attività di deployment, ne analizza l'impatto sulla produzione e può attivare risposte predefinite in caso di problemi.
AIOps e DevOps si occupano di parti diverse del ciclo di vita del rilascio del software e delle operazioni, e sono più efficaci se integrati.
Il playbook sull'AI agentiva per l'enterprise

AIOps vs DevOps: qual è la differenza?
Non si tratta di scegliere tra AIOps o DevOps, ma di integrare AIOps e DevOps. I due approcci si completano a vicenda anziché farsi concorrenza. DevOps fornisce il modello operativo per creare, testare e distribuire il software, mentre la AIOps applica l'intelligence operativa ai sistemi che lo eseguono.
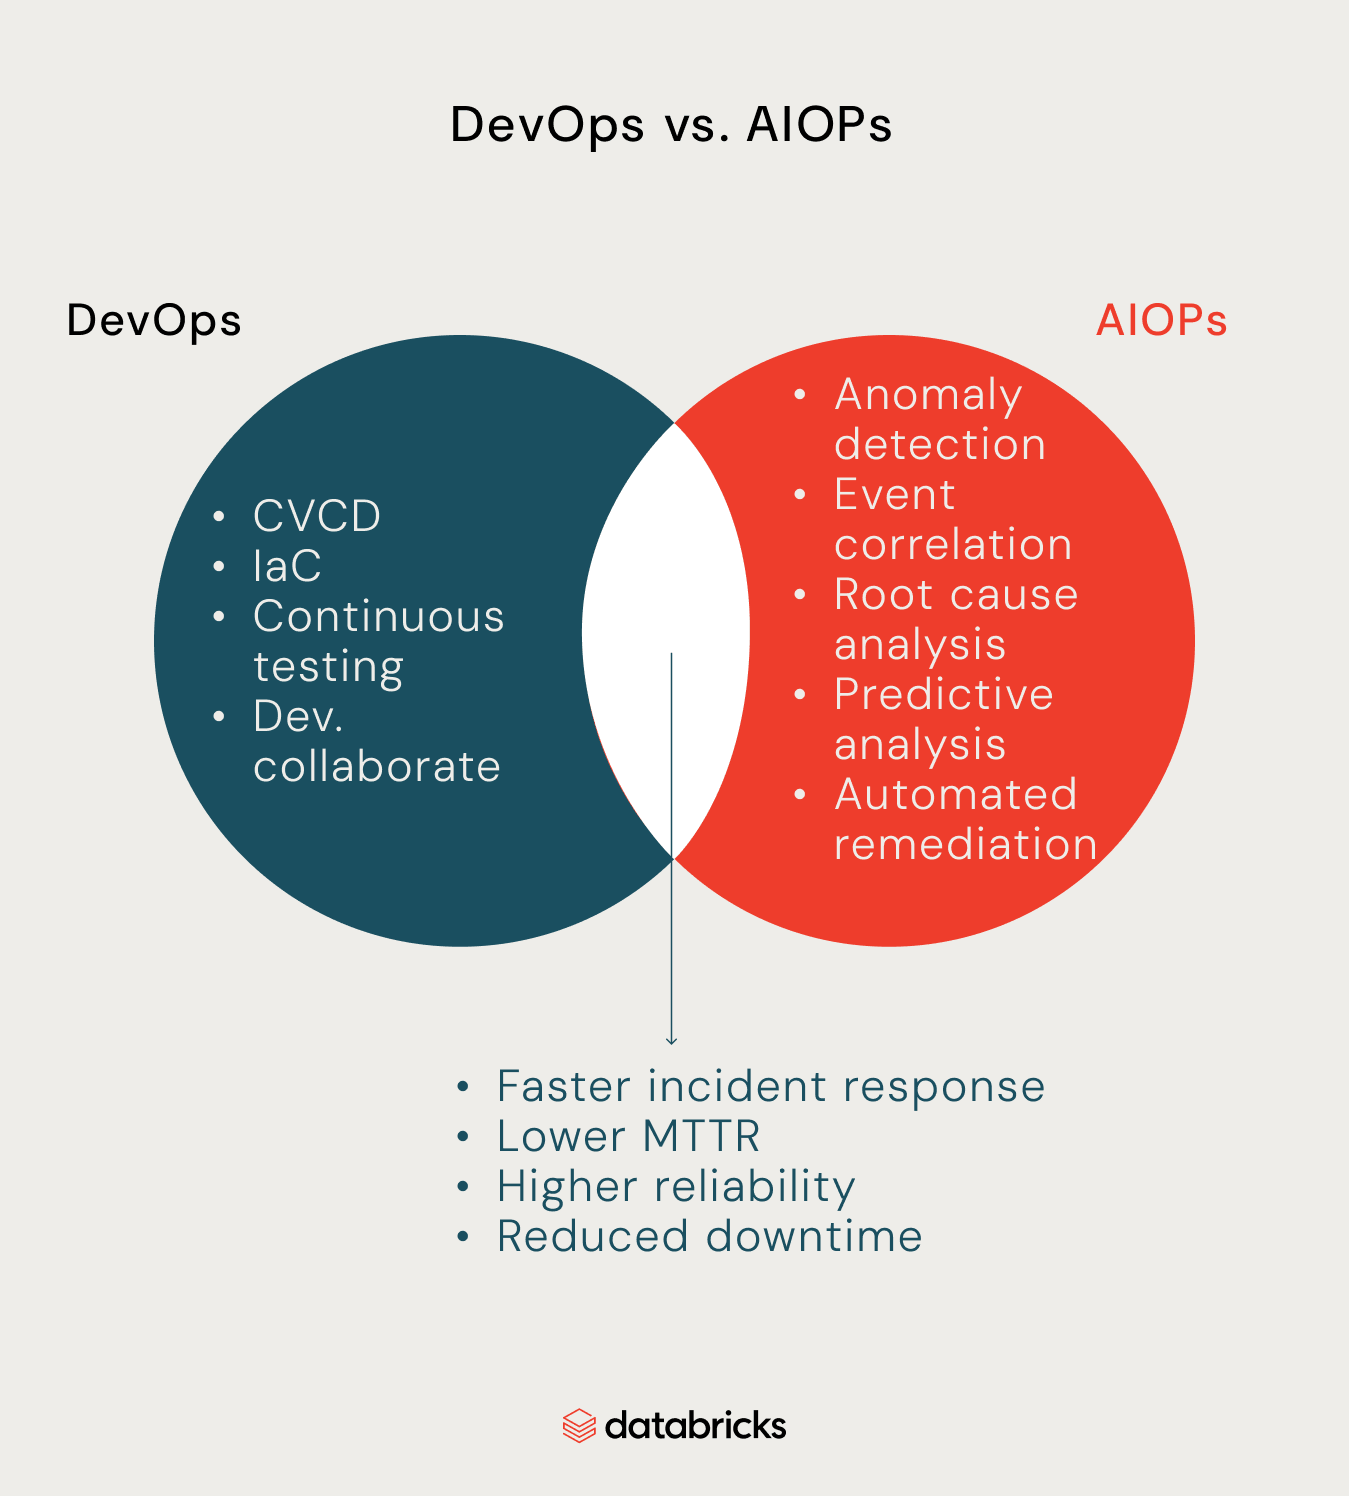
DevOps collega sviluppo e operazioni automatizzando il rilascio del software e consentendo agli sviluppatori di rilasciare le modifiche più rapidamente. La AIOps estende questo modello operativo analizzando i dati provenienti da infrastrutture, applicazioni e altri sistemi per rilevare anomalie, correlare eventi, identificare le cause probabili e supportare una risoluzione più rapida.
| DevOps | AIOps | |
|---|---|---|
| Focus principale | Rilascio del software e collaborazione | Operazioni IT e intelligence operativa |
| Ruolo | Modello operativo e pratiche di ingegneria | Analisi e automazione basate sull'AI |
| Cosa analizza | Codice, build, test, deployment | Metriche, log, tracce, eventi e avvisi |
| Risultati chiave | Rilasci più rapidi e affidabili | Rilevamento, risposta e ripristino più rapidi |
| Come lavorano insieme | Distribuisce le modifiche in produzione | Monitora e risponde al loro impatto operativo |
DevOps può distribuire una nuova versione dell'applicazione mentre la AIOps ne monitora l'impatto in produzione. Se il deployment mostra un comportamento insolito, la AIOps può correlare i segnali, identificare la causa probabile e attivare una risposta predefinita o avvisare l'ingegnere competente. Insieme, aiutano a procedere più rapidamente con una visibilità chiara.
Quali sono i vantaggi della AIOps?
I vantaggi principali della AIOps sono un MTTR più rapido, costi operativi inferiori, una migliore osservabilità e collaborazione e una gestione delle ITOps più predittiva. Ciascun vantaggio si collega direttamente al modo in cui i platform engineer rilevano, comprendono e risolvono gli incidenti.
- MTTR più rapido: la AIOps può correlare gli eventi, identificare le probabili cause alla radice e consigliare le azioni successive più rapidamente rispetto a un'indagine manuale. Ciò riduce il tempo che gli ingegneri dedicano alla tracciabilità degli incidenti e aiuta a ripristinare prima i servizi interessati.
- Costi operativi inferiori: la AIOps automatizza le attività ripetitive di rilevamento, indagine e risoluzione, riducendo lo sforzo manuale richiesto per gestire ambienti IT in crescita. Può anche aiutare a prevenire costosi tempi di inattività identificando i problemi prima che si aggravino.
- Migliore osservabilità e collaborazione: la AIOps unisce i segnali provenienti da infrastrutture, applicazioni e altri sistemi operativi in una vista condivisa dello stato del sistema. Ciò offre ai team di sviluppo, sicurezza e operazioni IT un contesto migliore durante l'analisi degli incidenti e il coordinamento delle risposte.
- Gestione predittiva delle ITOps: la AIOps utilizza dati operativi storici e in tempo reale per identificare pattern che potrebbero indicare guasti futuri o problemi di capacità. I team di dati possono dare priorità a questi rischi e agire prima che si trasformino in incidenti gravi.
Questi risultati dipendono dalla qualità dei segnali ricevuti dalla piattaforma AIOps, da una chiara titolarità dei processi operativi e dall'integrazione con i flussi di lavoro esistenti. Senza questi elementi, la AIOps può aggiungere ulteriore rumore e automazione senza migliorare la risposta agli incidenti.
Nonostante questi motivi per integrare la AIOps nelle organizzazioni, ci sono ancora alcuni vincoli da considerare.
Quali sono i limiti della AIOps?
La AIOps presenta alcune limitazioni; la sua efficacia dipende dalla qualità dei dati, dal contesto disponibile per i suoi modelli e da come gli ingegneri AI integrano i suoi suggerimenti nei flussi di lavoro esistenti.
- Lacune nella qualità dei dati: dati incompleti, incoerenti o rumorosi provenienti da log, metriche, tracce, eventi e altre fonti possono produrre correlazioni imprecise, anomalie mancate o avvisi non necessari.
- Mancanza di contesto: i segnali operativi, senza informazioni preventive su dipendenze, deployment recenti, configurazioni o impatto aziendale, possono portare la AIOps a identificare un'anomalia senza comprenderne correttamente la causa o la gravità.
- Model drift: i modelli addestrati su pattern storici possono diventare meno precisi al variare di sistemi, carichi di lavoro e baseline operative, richiedendo un monitoraggio e una regolazione continui.
- Rischio di sovra-automazione: i team non possono automatizzare completamente una fase di risoluzione complessa senza adeguate tutele. Farlo può trasformare un piccolo incidente in uno più grave. Le azioni a rischio più elevato dovrebbero mantenere la supervisione umana.
- Proliferazione degli strumenti (tool sprawl): l'aggiunta di un'altra piattaforma AIOps a uno stack di monitoraggio e osservabilità frammentato può creare ulteriore complessità.
- Scarsa fiducia o adozione: è meno probabile che gli ingegneri si affidino a consigli che non possono comprendere o verificare. I team di dati hanno bisogno di una chiara titolarità, consigli spiegabili e risultati misurabili prima di estendere la AIOps a operazioni critiche.
I team di dati e gli ingegneri AI devono essere consapevoli di queste limitazioni perché definiscono le aspettative e li aiutano a prepararsi in modo più efficace per le loro strategie di governance e gestione del rischio.
Unity Catalog fornisce queste strategie di governance e l'accesso agli asset di dati e AI in un unico catalogo, aiutando i team a controllare l'accesso ai dati sensibili e regolamentati.
Come possono le organizzazioni implementare la AIOps?
Per le organizzazioni che desiderano implementare la AIOps nelle loro operazioni IT, è importante notare che si tratta di un processo graduale piuttosto che di una trasformazione radicale e immediata. Ciò significa concentrarsi sulla sequenzialità, introducendola in più fasi, convalidandone il valore ed estendendola per creare fiducia nel sistema.
Inizia con un problema operativo ad alto impatto in cui AIOps può offrire vantaggi misurabili, come la riduzione dell'affaticamento da alert o il miglioramento della risposta agli incidenti.
Unifica i segnali operativi rilevanti, aggiungi contesto sulle dipendenze e sul comportamento del sistema e inizia con i consigli prima di consentire a AIOps di automatizzare le azioni a rischio più elevato. I team che creano workflow operativi basati su agenti su Databricks possono utilizzare Agent Bricks per creare e distribuire agenti, MLflow per il tracciamento e la valutazione, Unity Catalog per l'accesso governato e Unity Gateway per il controllo del traffico di modelli e strumenti.
I team iniziano a fidarsi dei consigli, a rendere operativi i workflow e a definire metriche come MTTR, volume degli alert e frequenza degli incidenti per misurarne l'impatto. Da lì, le organizzazioni possono estendere AIOps ad altri sistemi, gestendo al contempo i cambiamenti a strumenti, processi e responsabilità esistenti.
Scopri come Mosaic AI aiuta le organizzazioni a gestire e governare l'AI in tutte le loro attività operative.
Quali sono i diversi approcci ad AIOps?
Per determinare se un approccio AIOps incentrato sul dominio o indipendente dal dominio sia migliore per l'infrastruttura e i processi della tua organizzazione, considera la copertura, la profondità, le integrazioni, l'impegno di configurazione e l'adeguatezza.
- Copertura: hai bisogno di AIOps per un singolo dominio operativo o per più team, sistemi e ambienti?
- Profondità: il tuo team ha bisogno di un'intelligence specializzata per un dominio specifico o di un'analisi più ampia su sistemi interconnessi?
- Integrazioni: questo approccio è in grado di connettersi con i tuoi strumenti esistenti di monitoraggio, osservabilità, cloud e operazioni IT?
- Impegno di configurazione: quanto tempo e sforzo operativo saranno necessari per l'implementazione, la configurazione e la manutenzione?
- Adeguatezza organizzativa: si allinea con le competenze del tuo team, i workflow esistenti, il modello di responsabilità e gli obiettivi operativi?
Esaminare attentamente e rispondere a queste domande offre ai team un modello decisionale migliore sull'approccio da adottare. La scelta giusta è quella che si adatta ai tuoi requisiti operativi.
I prossimi passi
AIOps applica l'AI e il machine learning ai dati operativi per rilevare i problemi in anticipo, comprenderne l'impatto e rispondere più rapidamente. Funziona al meglio come livello di intelligence che supporta gli ingegneri e i processi esistenti di osservabilità e operazioni IT, anziché sostituirli.
Inizia identificando dove AIOps può offrire il massimo valore, che si tratti di rilevamento delle anomalie, analisi delle cause principali, risposta agli incidenti o monitoraggio delle prestazioni. Quindi valuta i dati e le integrazioni disponibili, introduci raccomandazioni prima di implementare l'automazione a rischio più elevato e misura l'impatto su metriche chiave come il volume degli alert e i costi operativi.
Per la creazione e la gestione di applicazioni basate su agenti e di modelli linguistici di grandi dimensioni (LLM), esplora MLflow per scoprire come può supportare il ciclo di vita delle tue applicazioni e i workflow operativi.
Domande frequenti
Cosa significa AIOps?
AIOps sta per Artificial Intelligence for IT Operations. Utilizza l'AI, il machine learning e i dati operativi per rilevare, analizzare e rispondere ai problemi IT.
Quali dati utilizza AIOps?
AIOps può analizzare i dati operativi, inclusi log, metriche, tracce, eventi, alert, dati di configurazione e altri segnali provenienti dai sistemi IT.
In cosa differisce AIOps dall'osservabilità?
L'osservabilità raccoglie e comprende ciò che accade nei sistemi. AIOps si basa su questi segnali operativi applicando l'AI e il machine learning per correlare gli eventi, rilevare anomalie, identificare le probabili cause e supportare o automatizzare le risposte.
In cosa differisce AIOps da MLOps?
AIOps applica l'AI e il machine learning alle operazioni IT, mentre MLOps si concentra sullo sviluppo, l'implementazione, il monitoraggio e la gestione dei modelli di machine learning e del loro ciclo di vita. Risolvono problemi operativi diversi, sebbene possano sovrapporsi nelle organizzazioni che gestiscono sistemi di ML su larga scala.
AIOps è uno strumento o una pratica?
AIOps è sia una pratica che una categoria di strumenti. La pratica prevede l'applicazione dell'AI e del machine learning alle operazioni IT, mentre le piattaforme AIOps forniscono le funzionalità di elaborazione dati, analisi, correlazione e automazione necessarie per supportare tale pratica.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.