Databricks 문서 인텔리전스: 복잡한 문서 추출의 새로운 지평을 열다
AI Extract의 Precision Mode를 소개합니다. 기존 방식으로는 한계가 있었던 긴 문서와 복잡한 스키마에서 프론티어 수준의 정확도를 달성해 보세요.
작성자: Jane Zhang, Arnav Singhvi, Ivan Zhou, Archika Dogra, Matthew Ding , Nihit Desai
- 복잡한 문서에서 필드를 추출하는 작업은 흔히 세 가지 사용 사례에서 실패합니다. 페이지 간 대조가 필요한 긴 문서, 수천 개의 송장 품목과 같은 긴 출력값, 그리고 필드에 추론과 계산이 필요한 복잡한 스키마입니다.
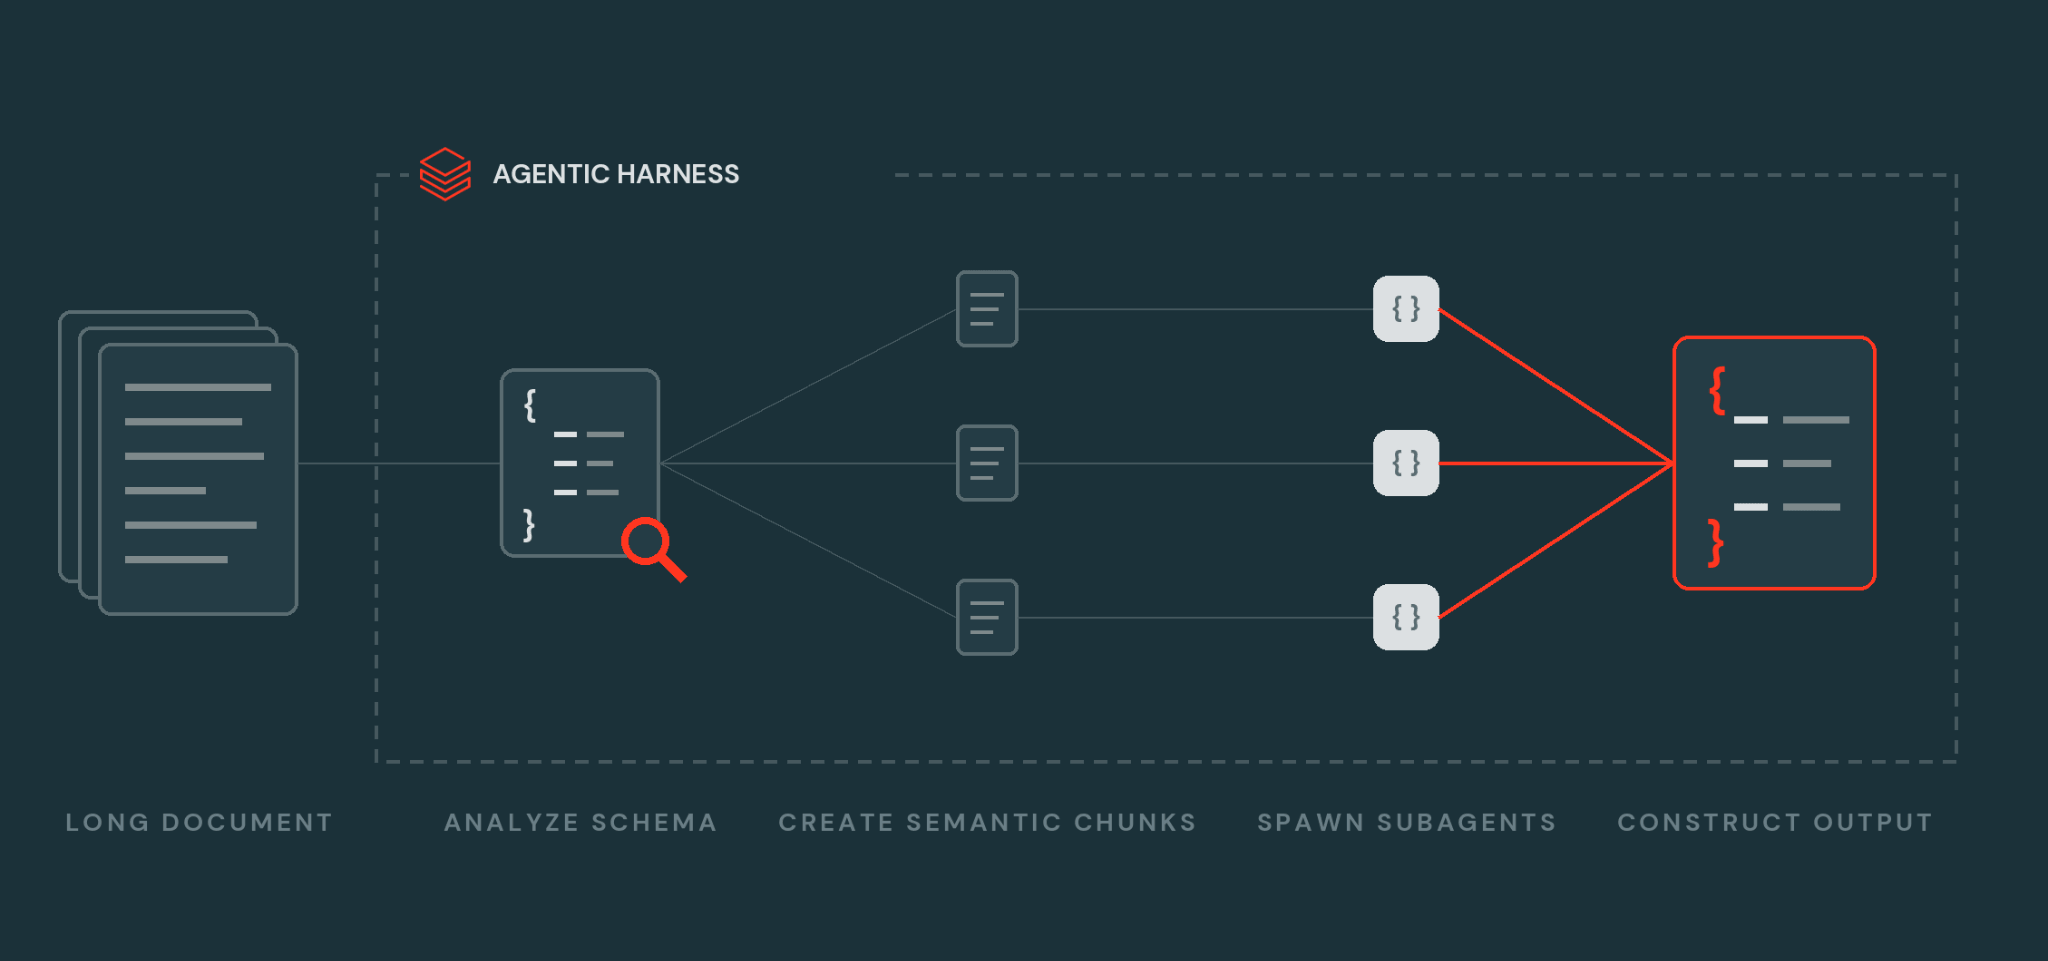
- Precision Mode는 맞춤형 미세 조정 추출 모델과 단계별로 추론하고 병렬 추출을 위해 하위 에이전트를 생성하며 결과를 하나의 출력으로 병합하는 에이전트 기반 하네스를 결합하여, 문서와 스키마가 커지더라도 안정성을 유지합니다.
- 6개의 복잡한 문서 벤치마크에서 Precision Mode는 정확도 측면에서 차순위 프론티어 모델을 7포인트 차이로 앞섭니다.
모든 기업에는 복잡하고 비정형화된 문서 속에 갇혀 있는 가치 있는 데이터가 있습니다. 현재 Databricks Document Intelligence는 수천 명의 고객이 데이터를 활용할 수 있도록 지원하며, 수십억 페이지를 프로덕션 파이프라인, 에이전트 및 애플리케이션을 구동하는 정형 데이터로 변환하고 있습니다. Panasonic, EY-Parthenon, Intercontinental Exchange (NYSE)와 같은 고객들은 가장 까다로운 워크플로에 Document Intelligence를 사용하여 매주 수백만 개의 문서를 처리하고 있습니다.
고객과 협력하는 과정에서 기존의 대규모 언어 모델(LLM) 또는 규칙 기반 문서 추출 솔루션으로는 해결하기 어려운 몇 가지 까다로운 추출 문제를 발견했습니다.
- 장문 문서. 1페이지의 갱신 조건이 80페이지의 조항에 종속되어 있는 임대차 계약서나, 150페이지의 문단이 3페이지의 용어를 재정의하는 합의서 등이 이에 해당합니다. 기존 솔루션은 이러한 상호 참조를 해결하지 못합니다.
- 대규모 중첩 출력. 수백 개의 SKU가 포함된 다중 페이지 선하증권이나 수천 개의 품목이 포함된 인보이스 등이 있습니다. 기존 솔루션은 출력이 커짐에 따라 필드를 누락하거나 잘라냅니다.
- 복잡한 스키마 및 추론. 3개의 재무제표를 종합하는 위험 분류나 기록된 모든 가격에 나열된 할인율을 적용하는 계약 가치 등이 있습니다. 기존 솔루션은 문서 전반에 걸쳐 올바른 로직을 일관되게 적용하지 못합니다.
오늘 당사의 문서 추출 API인 ai_extract에 정밀 모드(Precision Mode)를 도입하게 되어 기쁘게 생각하며, 이를 통해 가장 복잡한 기업 문서 및 작업에 대한 정확도의 새로운 기준을 제시하고자 합니다.
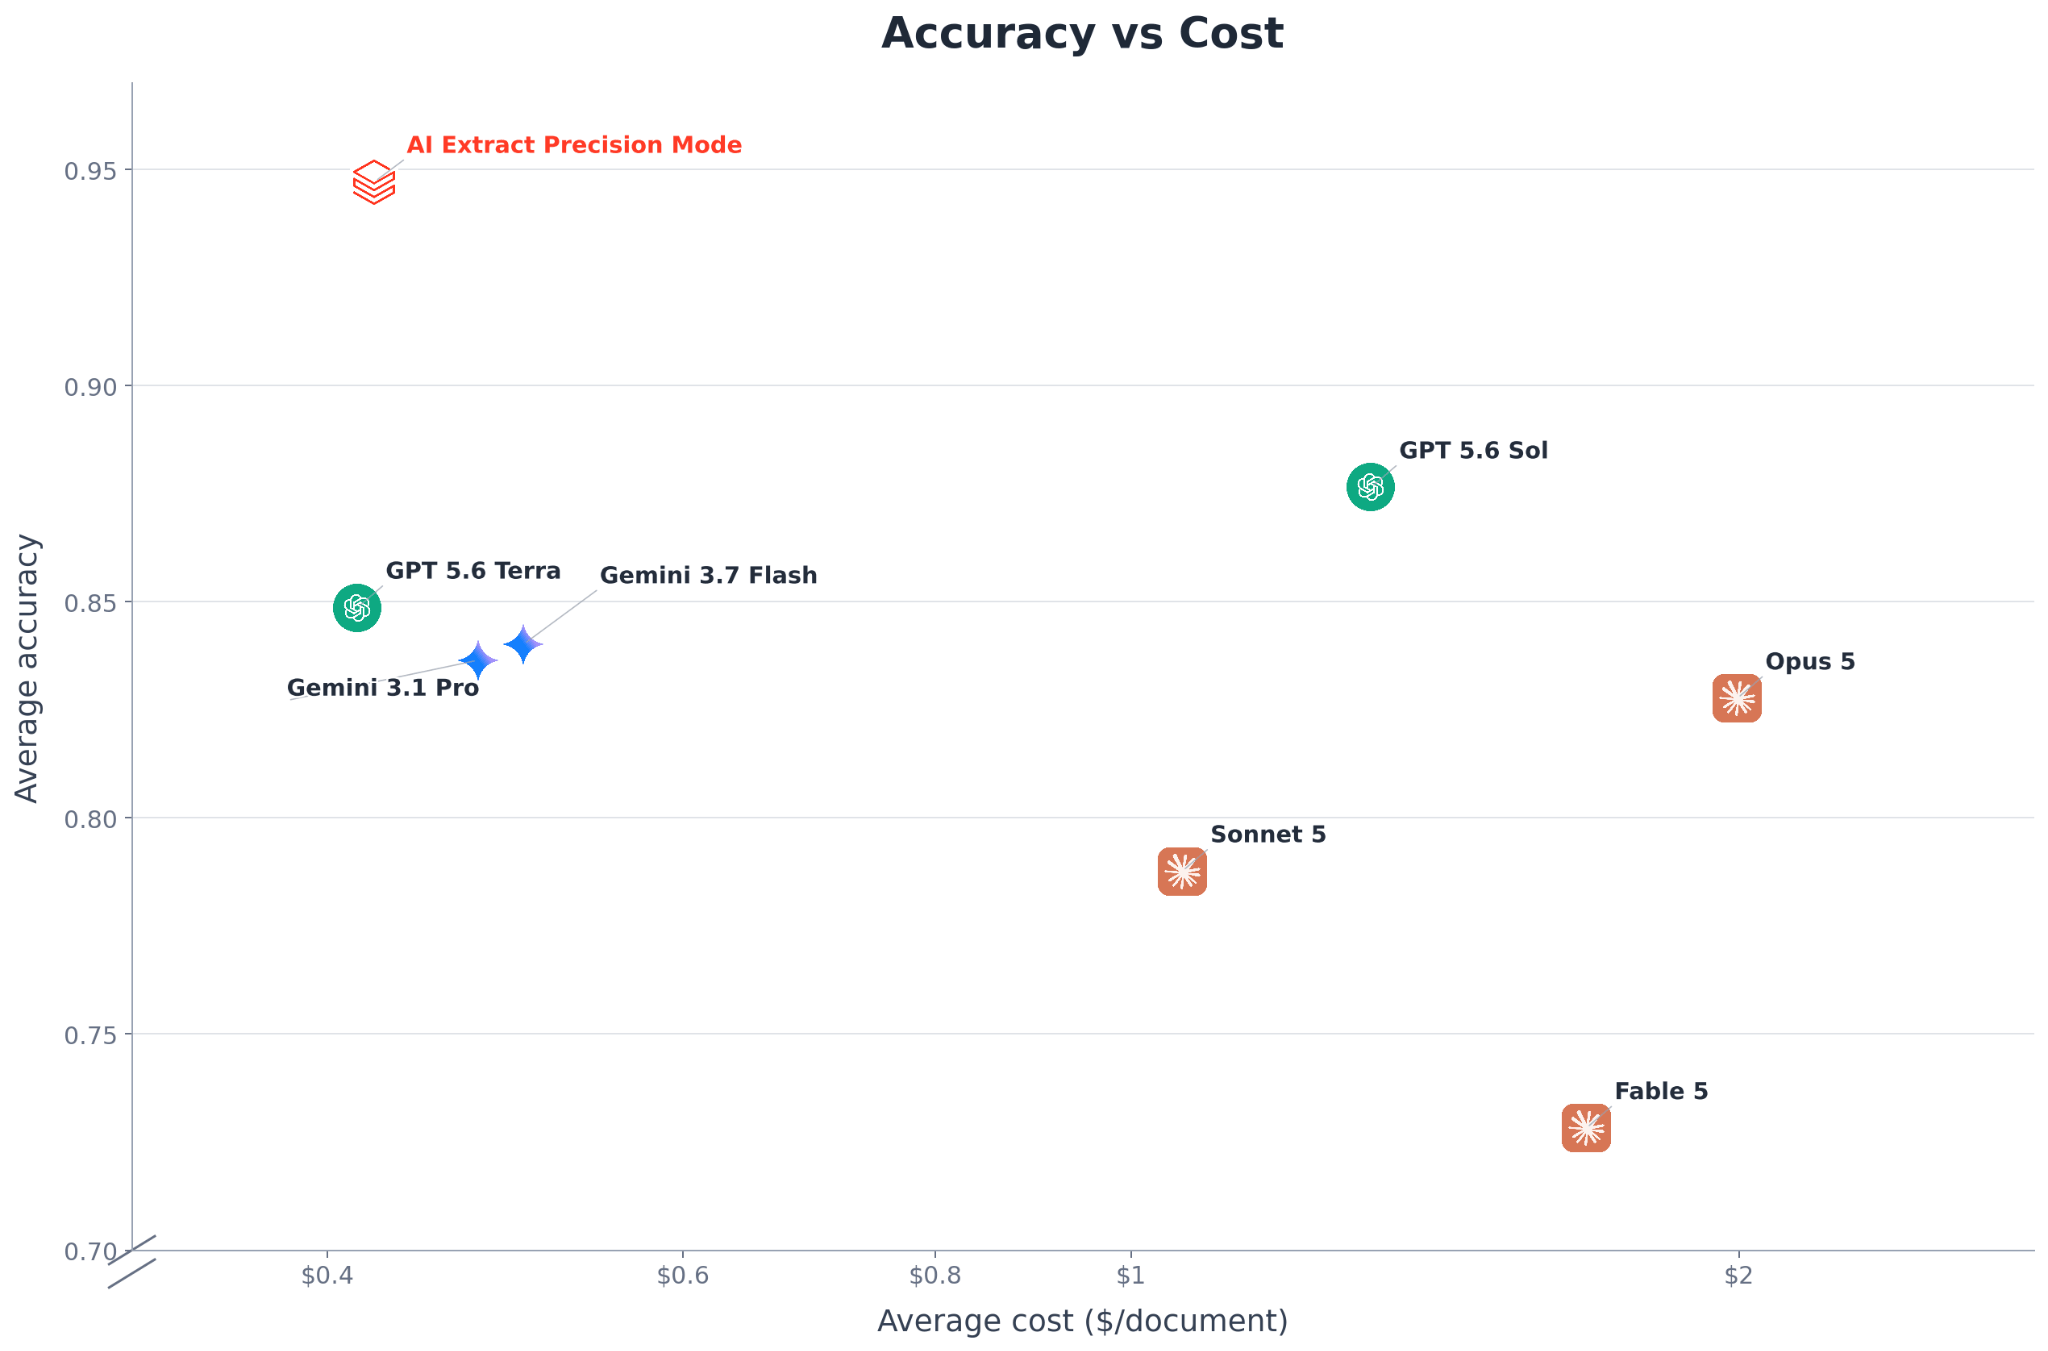
정밀 모드는 문서 추출을 위해 맞춤 학습된 자체 모델과 에이전트 하네스(agentic harness)를 결합하여 장문 문서, 대규모 출력 및 추론이 많이 필요한 스키마에서 안정적이고 정확한 추출을 제공합니다. 약 9,000개의 복잡한 문서를 대상으로 한 벤치마크 전반에서 정밀 모드는 최신 프론티어 모델의 추출 정확도를 크게 능가하며 최고 수준(SOTA)의 품질을 달성했습니다.
"Intercontinental Exchange에서는 매달 수백만 개의 복잡하고 가변성이 높은 금융 문서를 처리합니다. Document Intelligence는 이러한 복잡성을 정형화된 시장 인텔리전스로 전환하여, 당사가 더 빠르게 움직이고 고객에게 더 큰 가치를 제공하며 대규모 분석 및 의사 결정을 가속화하는 에이전트 워크플로를 실현할 수 있도록 지원합니다."- Anand Pradhan, Intercontinental Exchange (NYSE) 모기지 데이터 부문 CTO 겸 AI 책임자
복잡한 문서 추출을 위한 새로운 접근 방식
가장 까다로운 추출 작업의 정확도를 높이기 위해 당사의 연구 및 엔지니어링 팀은 모델 자체를 맞춤화하는 것과 모델 주변에 효과적인 에이전트 하네스를 구축하는 것의 두 가지 레이어로 문서 추출 품질에 접근했습니다.
- 문서 추출을 위해 효율적인 맞춤형 모델을 학습시켰습니다. 당사 연구 팀은 까다로운 고객 워크플로를 기반으로 구축된 벤치마크를 바탕으로 복잡한 문서에서 정형 정보를 찾고, 추론하고, 추출하는 맞춤형 모델을 학습시켰습니다. 점점 더 커지는 범용 모델에 의존하는 대신, 우리가 해결하고자 하는 과제인 정확한 정형 추출에 최적화했습니다.
- 모델 실패 모드를 극복하도록 설계된 추출 하네스를 구축했습니다. 강력한 모델이라도 수백 페이지에 걸쳐 추론해야 하거나 한 번에 수천 개의 필드를 생성해야 할 때는 어려움을 겪을 수 있습니다. 당사 팀은 Databricks MemEx에서 영감을 받아 대규모 추출 작업을 의미론적으로 분해하고, 소규모 작업을 병렬로 실행하며, 중간 결과를 보존하고, 이를 하나의 최종 정형 출력으로 조정하는 에이전트 하네스를 구축했습니다.
평가 방법론
벤치마크 설계 및 데이터 세트 구성
정밀 모드를 검증하기 위해 기존 접근 방식의 한계를 시험하는 워크로드를 중심으로 평가 벤치마크를 설계했습니다.
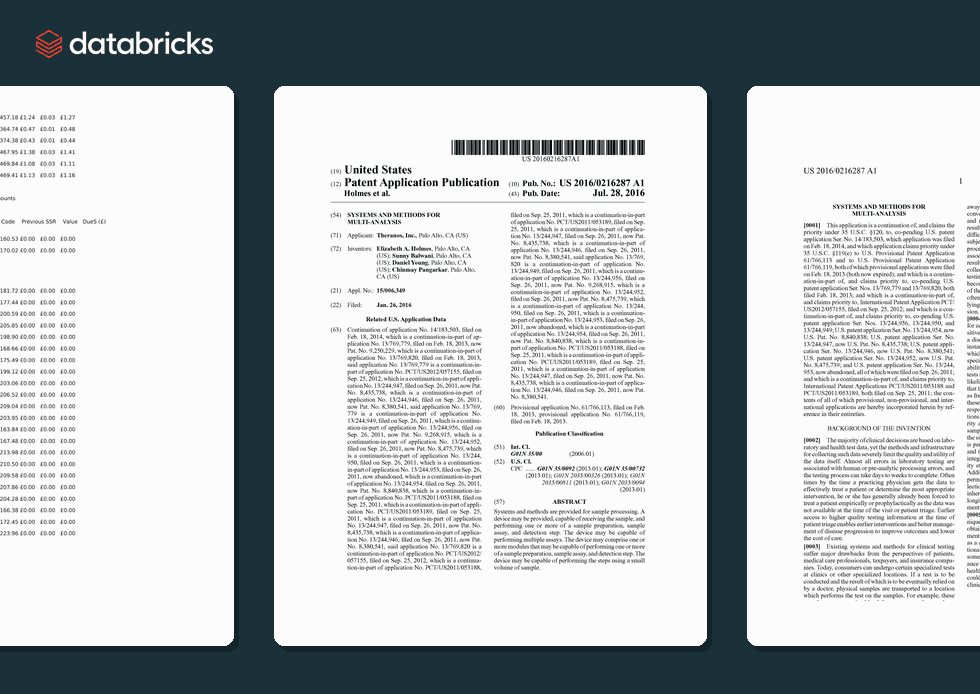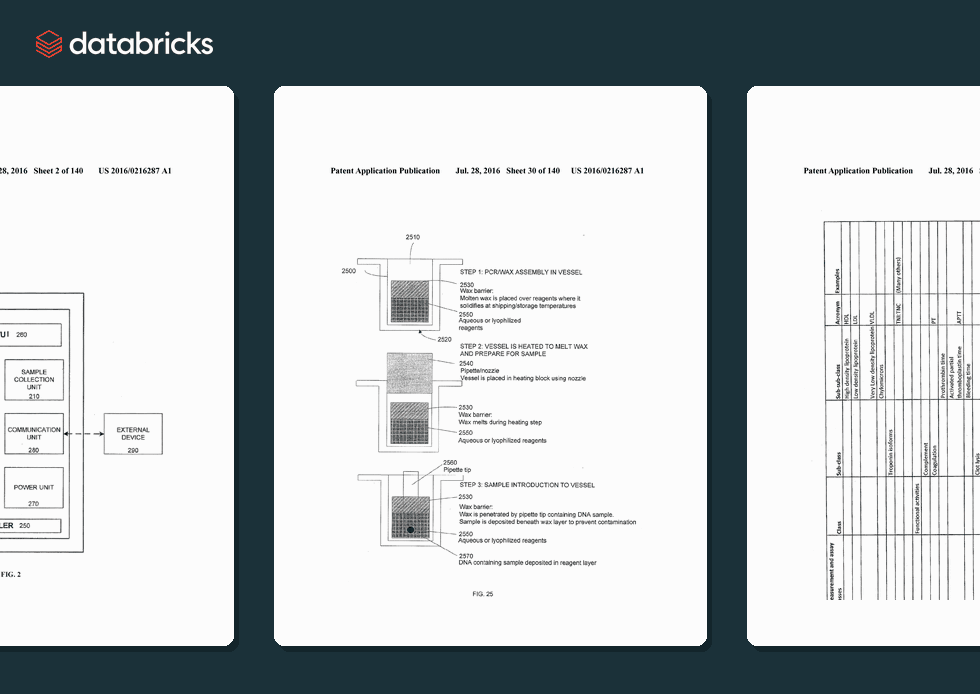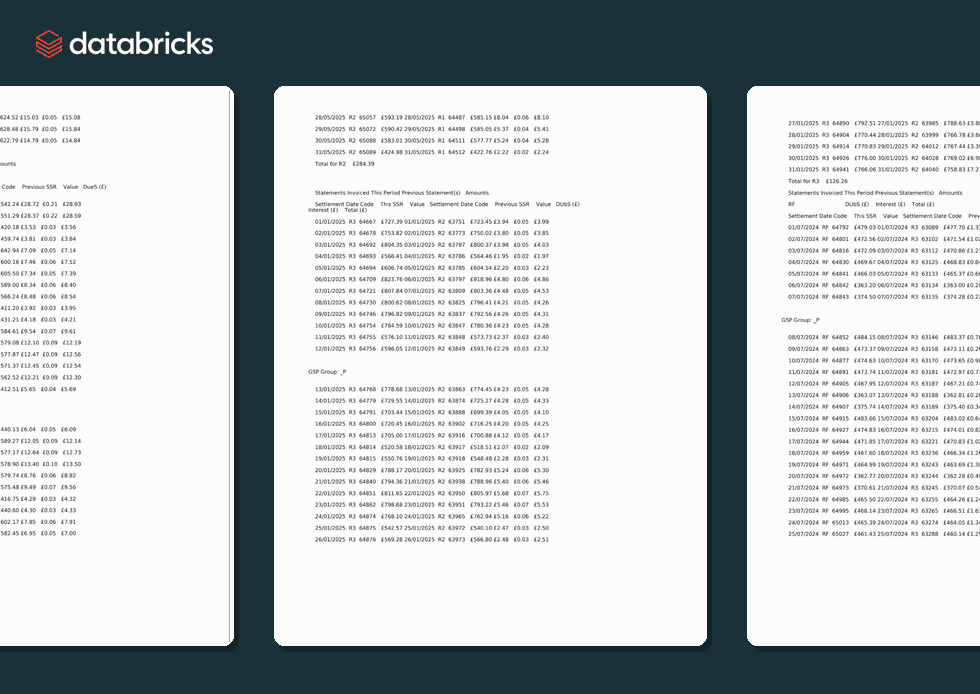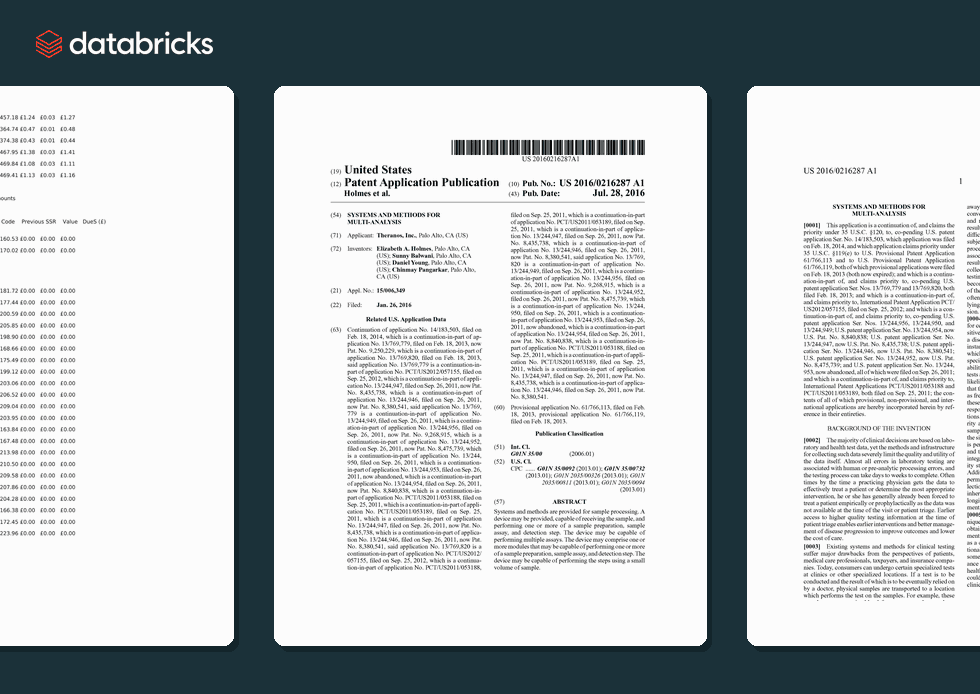
구체적으로, 정밀 모드가 해결하도록 설계된 세 가지 추출 과제에 걸쳐 약 9,000개의 문서를 대상으로 평가를 진행했습니다. 이 평가에는 최대 2,000페이지에 달하는 문서, 수천 개의 품목이 포함된 인보이스, 조밀한 다중 페이지 표 및 차트, 300개 이상의 깊게 중첩된 필드가 있는 스키마, 문서 전체에서 정보를 상호 참조해야 하는 추론 중심의 작업이 포함됩니다.
문서는 다음 두 가지 벤치마크 세트에서 가져왔습니다.
- 금융 서비스, 제조업, 헬스케어를 포함한 주요 산업 전반에서 당사가 관찰한 가장 까다로운 고객 워크로드를 기반으로 한 10개의 내부 데이터 세트.
- 5개의 공개 벤치마크: VAREX, RealDocBench, LongExtractBench 및 LEDGER 및 Caselaw Access Project 데이터 세트를 사용한 장문 문서 스트레스 테스트.
이러한 데이터 세트에는 10-K 보고서, 선하증권, 기술 매뉴얼, 금융 문서, 임상 기록, 정부 특허 및 자금 지원 신청서 등이 포함됩니다.
베이스라인 설계 및 모델 비교
문서 추출의 자연스러운 시작점은 단일 프론티어 모델 호출입니다. 즉, 문서와 스키마를 전달하고 모델에 정형 출력을 반환하도록 요청하는 것입니다. 하지만 당사가 평가하는 조밀하고 복잡한 워크로드에서는 이러한 접근 방식이 금방 한계에 부딪힙니다. 장문 문서는 모델의 컨텍스트 제한을 초과하여 부정확하고 불완전한 결과를 초래할 수 있습니다.
따라서 당사는 더 강력하고 현실적인 베이스라인인 청크 및 병합(chunk-and-merge)을 기준으로 벤치마크를 수행했습니다. 각 문서를 더 작은 청크로 분할하고, 각 청크에서 독립적으로 추출한 다음, 결과를 최종 출력으로 병합하는 방식입니다. 이는 단일 모델 호출만으로는 충분하지 않을 때 엔지니어들이 사용하는 것과 동일한 패턴입니다.
당사는 기본 API 설정을 사용하여 주요 GPT, Claude, Gemini 모델로 청크 및 병합 접근 방식을 테스트했습니다. 그런 다음 각 모델의 추출 정확도를 정밀 모드와 비교했습니다. ¹
벤치마크 결과
벤치마크 전반에서 정밀 모드는 94.7%의 정확도를 달성하여 가장 강력한 프론티어 모델 청크 및 병합 베이스라인인 GPT-5.6 Sol을 7%포인트 차이로 앞섰습니다.
특히 까다로운 장문 문서 워크로드에서 프론티어 모델은 청크 타임아웃, 출력 잘림, 요청된 스키마를 따르지 않는 불완전한 최종 병합 등 수많은 운영상의 실패 모드를 겪는 것을 관찰했습니다. 반면, 정밀 모드의 에이전트 기반 접근 방식은 이러한 실패 모드에 견고하며, 맞춤 학습된 추출 모델은 효율적이고 정확한 추출을 유지합니다.
시작하기
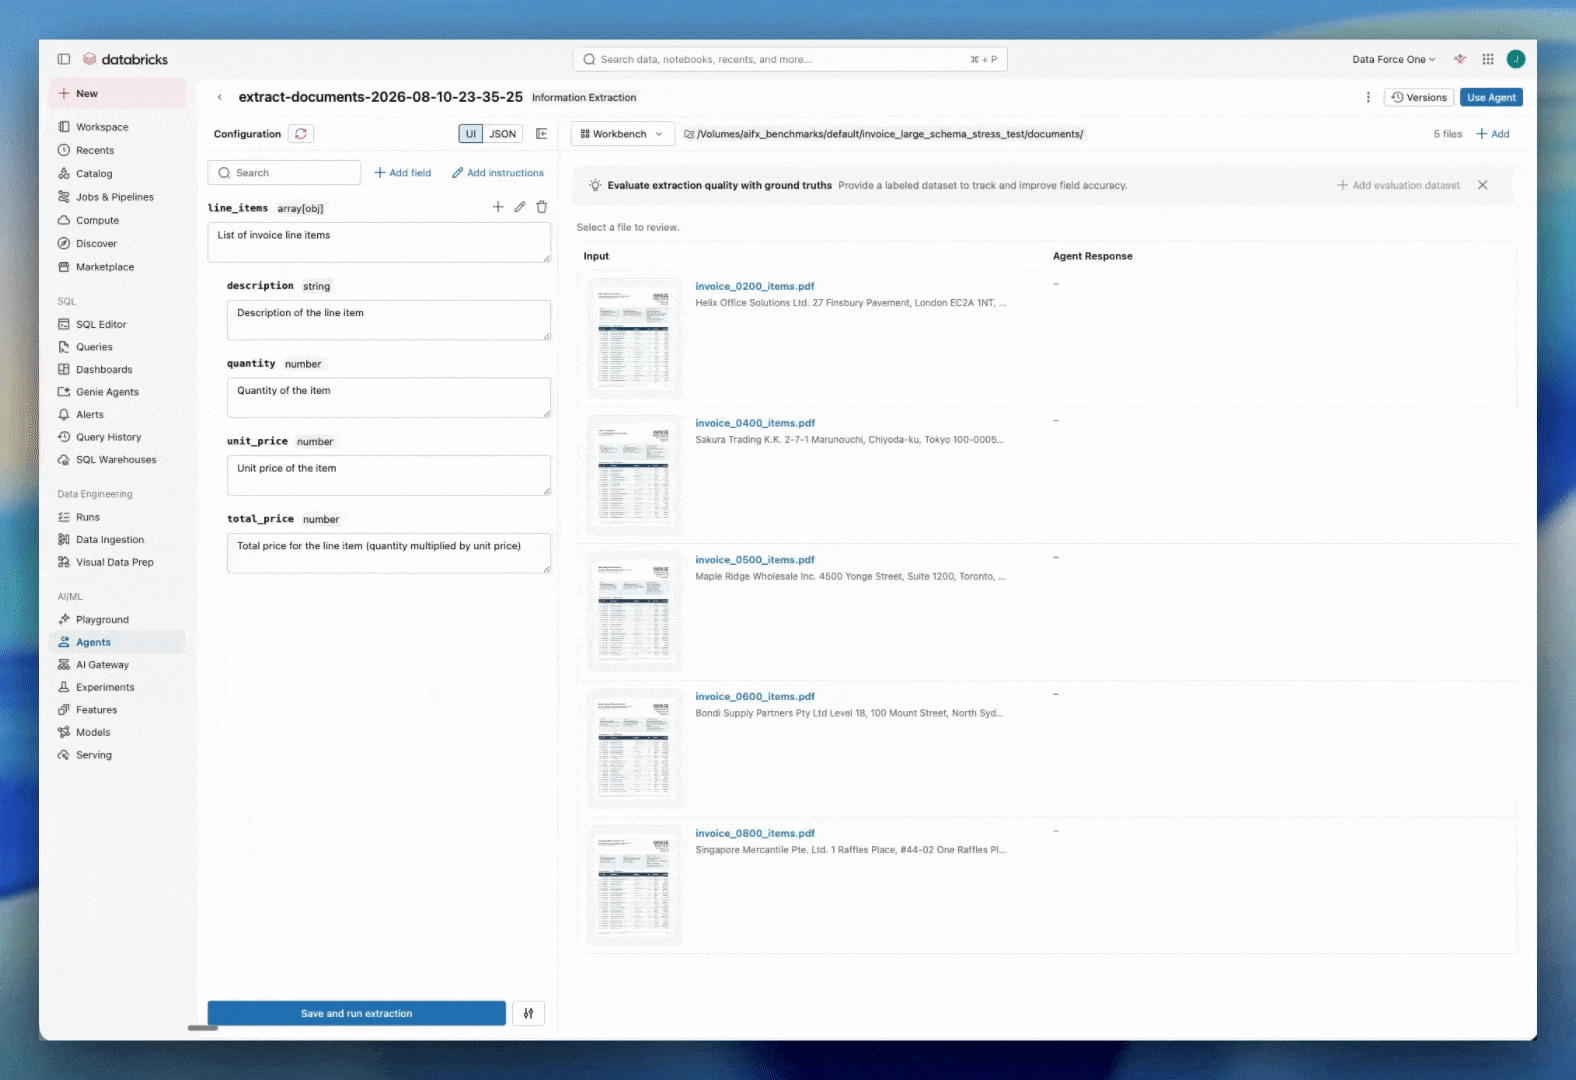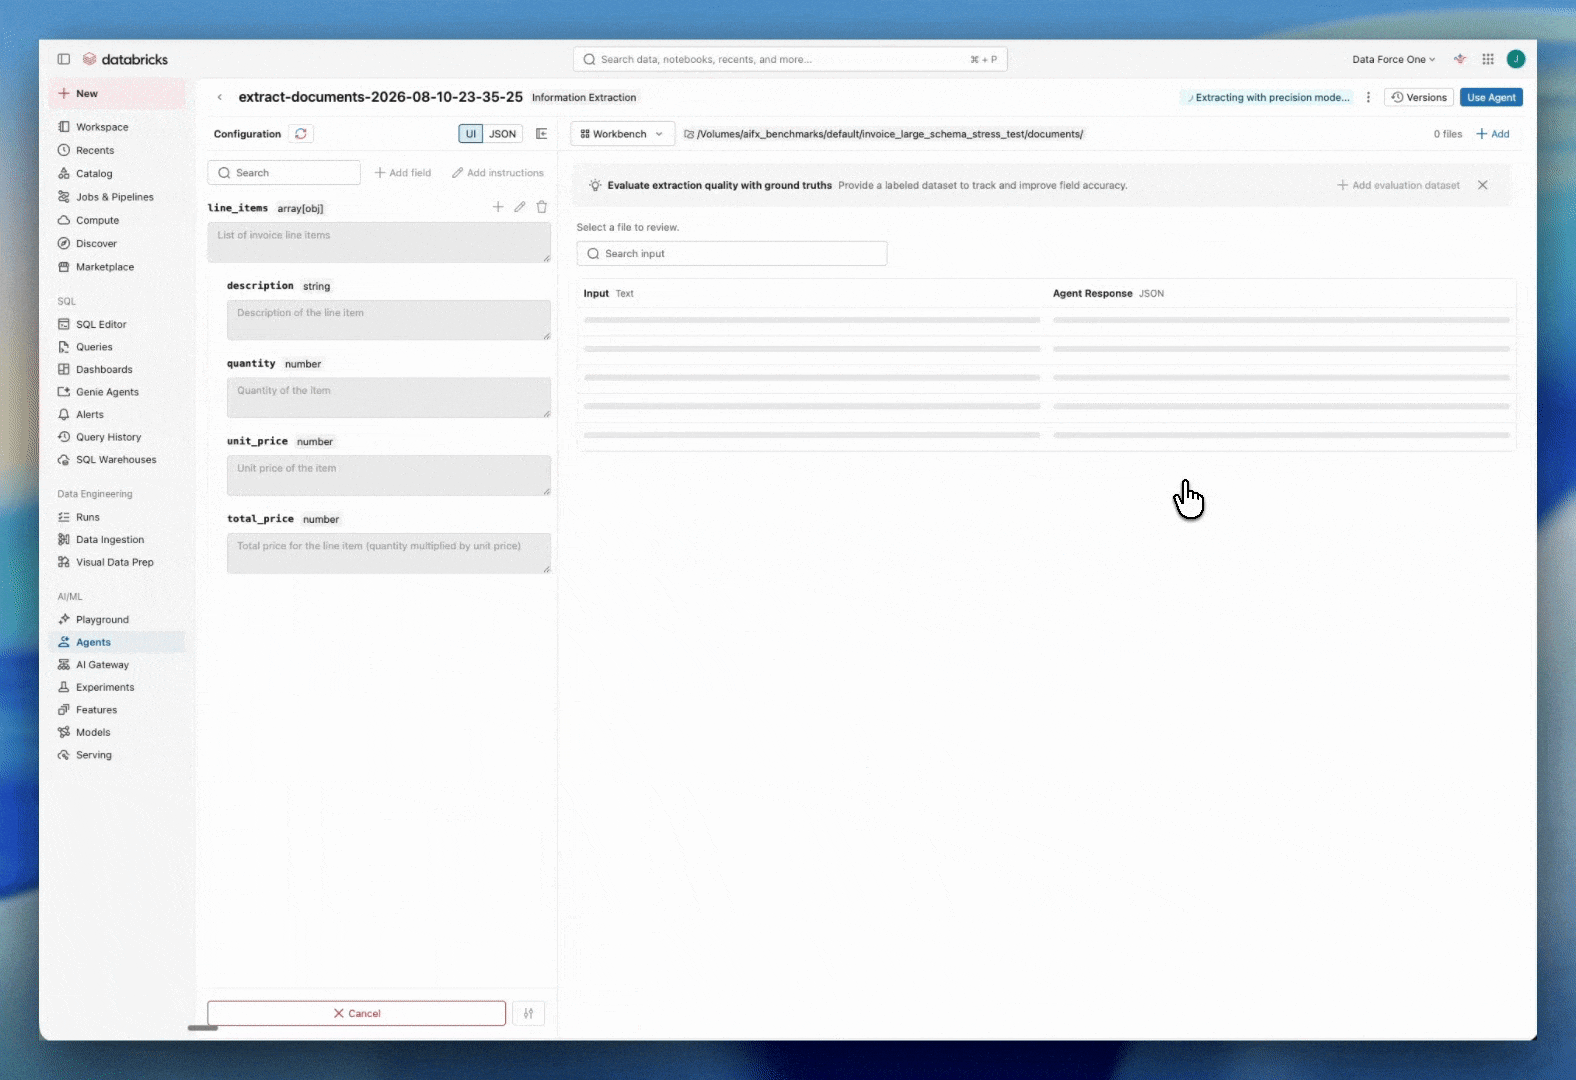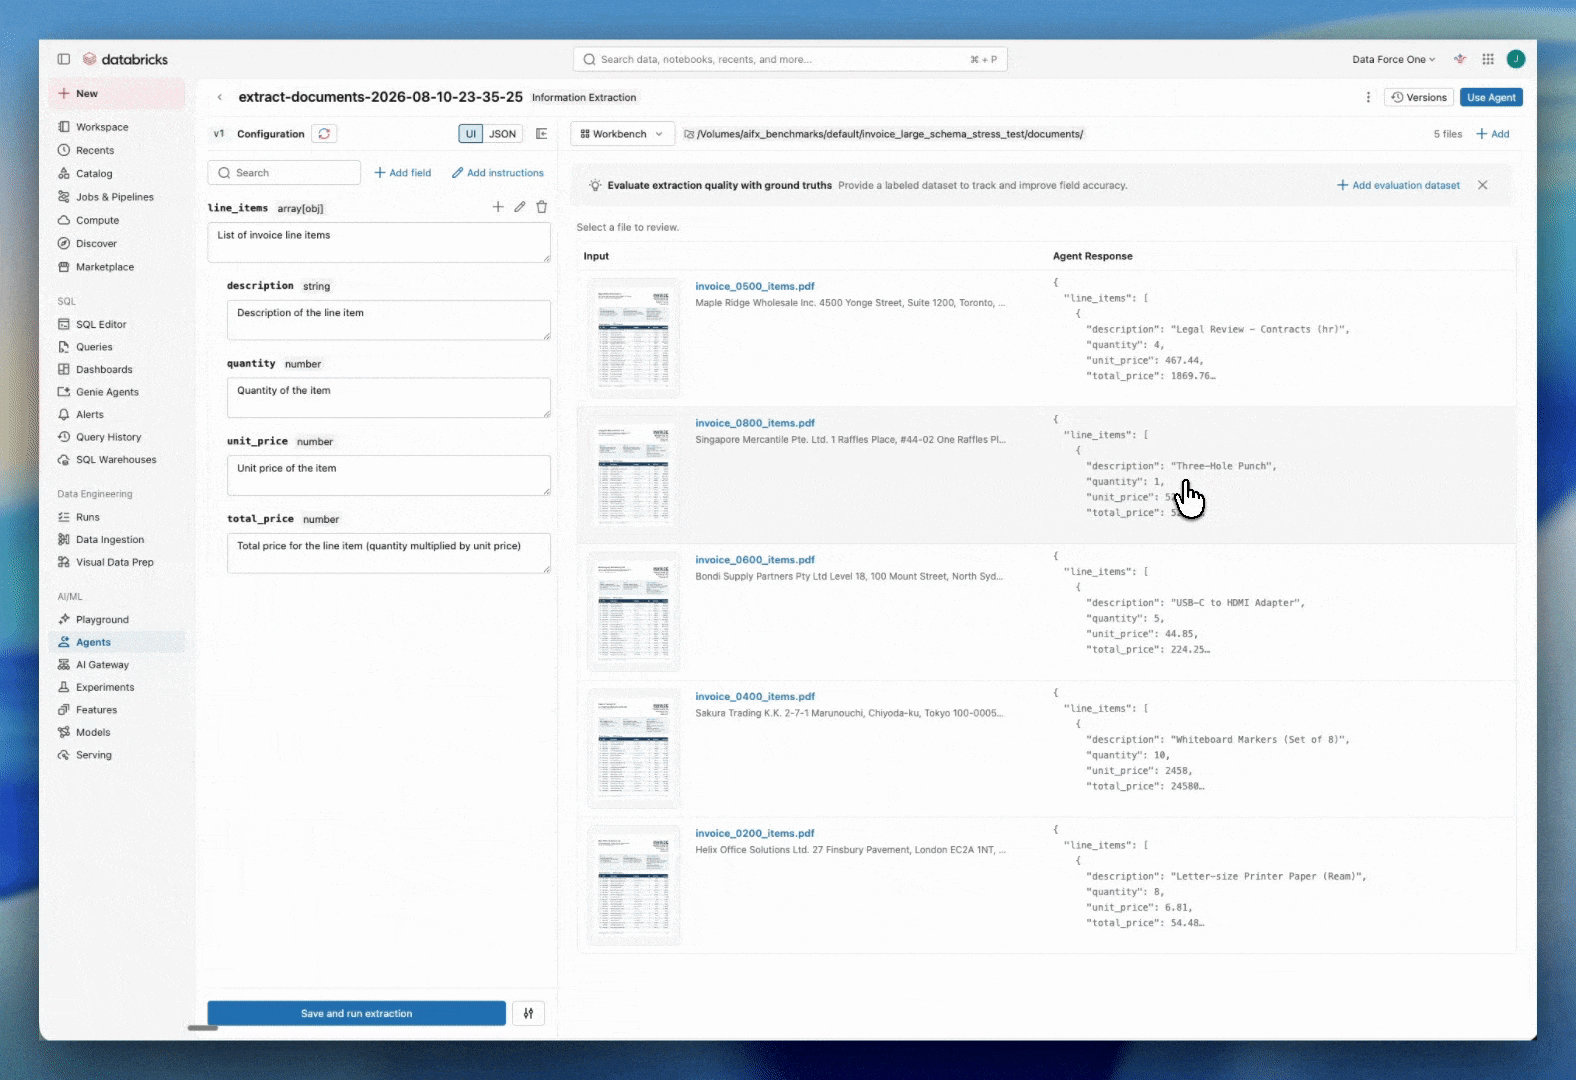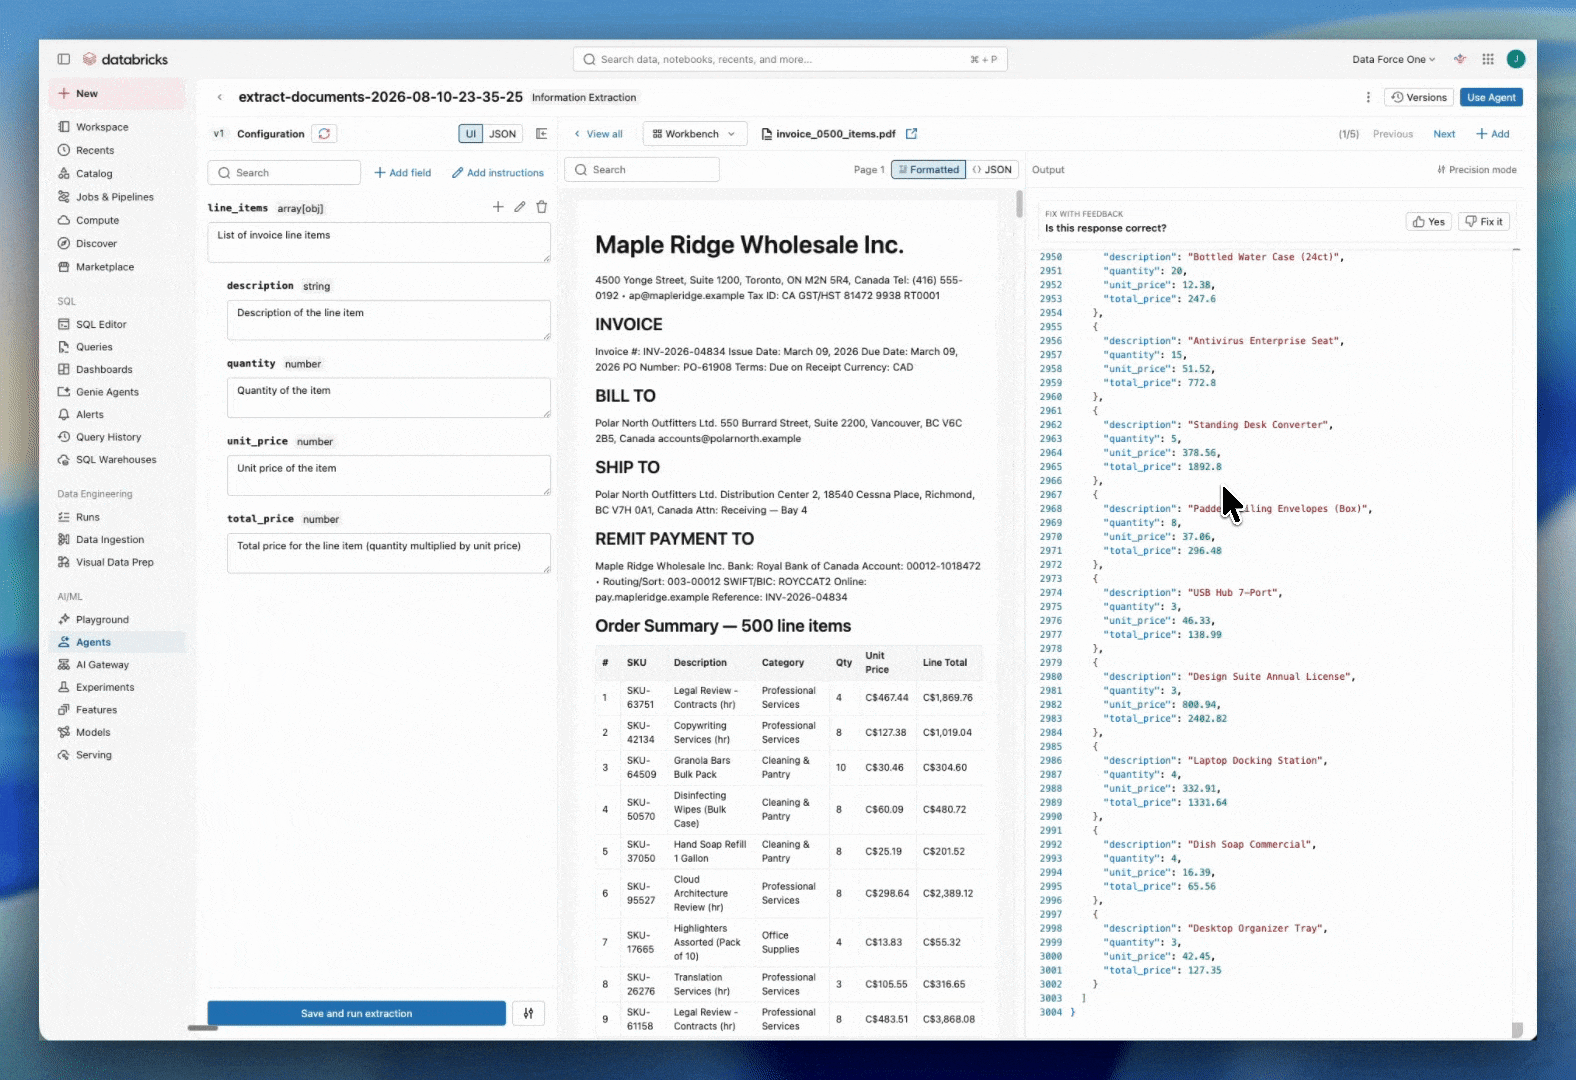
가장 복잡한 문서 추출 작업을 위한 AI Extract 정밀 모드를 이제 사용할 수 있습니다. ai_extract 함수를 호출할 때 모드를 precision로 설정하거나, 에이전트 페이지의 정보 추출(Information Extraction) UI에서 정밀 모드 토글을 켜세요:
각주:
¹ 정확도는 실제값(ground-truth) 객체와 일치하는 추출된 객체의 비율로 정의됩니다. 점수 측정은 타입에 따라 다릅니다. 기본 타입(boolean, float, integer, enum)은 직접 일치 방식을 사용합니다. 문자열은 먼저 직접 일치를 시도한 후 퍼지 일치(fuzzy match), 그리고 LLM 판정 순으로 진행됩니다. 배열은 예측된 항목과 실제 항목 간에 가장 유사한 쌍을 찾아 매칭한 후, 각 쌍의 점수를 평균하여 계산합니다. 객체는 필드별로 타입에 따라 점수를 매긴 후, 모든 필드의 평균을 계산합니다.
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.