Wir geben die allgemeine Verfügbarkeit von Serverless Compute für Notebooks, Workflows und Spark Declarative Pipelines bekannt
Schnelles, unkompliziertes Compute zum Ausführen von Notebooks, Jobs und Pipelines ist jetzt allgemein auf Azure und AWS verfügbar
von Bilal Aslam und Lucian Popa
Wir freuen uns, die allgemeine Verfügbarkeit (GA) von serverlosem Compute für Notebooks, Jobs und Spark Declarative Pipelines (SDP) auf AWS und Azure anzukündigen. Databricks-Kunden profitieren bereits von schnellem, einfachem und zuverlässigem serverlosem Compute für Databricks SQL und Databricks Model Serving. Dieselbe Funktion ist jetzt für alle ETL-Workloads auf der Data + AI Platform verfügbar, einschließlich Apache Spark und Spark Declarative Pipelines. Sie schreiben den Code und Databricks sorgt für einen schnellen Start der Workloads, eine automatische Skalierung der Infrastruktur und nahtlose Versions-Upgrades der Databricks Runtime. Wichtig ist, dass Ihnen bei serverlosem Compute nur die tatsächliche Arbeit und nicht die Zeit für die Bereitstellung und Initialisierung von Instanzen bei Cloud-Anbietern in Rechnung gestellt wird.

Unser aktuelles Angebot für serverloses Compute ist auf schnelle Starts, Skalierung und Leistung optimiert. Benutzer werden bald auch andere Ziele wie geringere Kosten festlegen können. Wir bieten derzeit einen Einführungspreisnachlass für serverloses Compute an, der ab sofort bis zum 31. Januar 2025 gilt. Sie erhalten eine Preisreduzierung von 50 % auf serverloses Compute für Workflows und SDP sowie 30 % Preisnachlass für Notebooks.
„Der Cluster-Start hat für uns Priorität, und serverlose Notebooks sowie Workflows haben einen riesigen Unterschied gemacht. Serverloses Compute für Notebooks macht es mit nur einem Klick ganz einfach; wir erhalten serverloses Compute, das sich nahtlos in Workflows integrieren lässt. Außerdem ist es sicher. Diese lang erwartete Funktion ist ein echter Game-Changer. Vielen Dank, Databricks!“ - Chiranjeevi Katta, Data Engineer, Airbus
Schauen wir uns die Herausforderungen an, die serverloses Compute lösen hilft, und die einzigartigen Vorteile, die es Data-Teams bietet.
Die Compute-Infrastruktur ist komplex und teuer in der Verwaltung
Das Konfigurieren und Verwalten von Compute wie Spark-Clustern ist für Data Engineers und Data Scientists seit Langem eine Herausforderung. Zeit, die für das Konfigurieren und Verwalten von Compute aufgewendet wird, fehlt für die Wertschöpfung im Unternehmen.
Die Auswahl des richtigen Instanztyps und der passenden Größe ist zeitaufwändig und erfordert Experimente, um die optimale Wahl für eine bestimmte Workload zu ermitteln. Die Festlegung von Cluster-Richtlinien, Autoscaling und Spark-Konfigurationen verkompliziert diese Aufgabe zusätzlich und erfordert Fachwissen. Sobald Cluster eingerichtet sind und laufen, müssen Sie dennoch Zeit in die Wartung und Leistungsoptimierung sowie die Aktualisierung der Databricks Runtime-Versionen investieren, um von neuen Funktionen zu profitieren.
Inaktivitätszeit – also Zeit, in der keine Workloads verarbeitet werden, für die Sie aber dennoch bezahlen – ist ein weiteres kostspieliges Ergebnis der Verwaltung einer eigenen Compute-Infrastruktur. Während der Compute-Initialisierung und des Hochfahrens müssen Instanzen booten, Software einschließlich der Databricks Runtime muss installiert werden usw. Sie bezahlen Ihren Cloud-Anbieter für diese Zeit. Zweitens: Wenn Sie Compute durch die Verwendung zu vieler Instanzen oder Instanztypen mit zu viel Arbeitsspeicher, CPU usw. überprovisionieren, wird das Compute unzureichend ausgelastet, aber Sie zahlen dennoch für die gesamte bereitgestellte Compute-Kapazität.
Die Beobachtung dieser Kosten und Komplexität bei Millionen von Kunden-Workloads hat uns dazu gebracht, Innovationen im Bereich serverloses Compute voranzutreiben.
Serverloses Compute ist schnell, einfach und zuverlässig
Beim klassischen Compute erteilen Sie Databricks über komplexe Cloud-Richtlinien und -Rollen delegierte Berechtigungen zur Verwaltung des Lebenszyklus von Instanzen, die für Ihre Workloads erforderlich sind. Serverloses Compute beseitigt diese Komplexität, da Databricks in Ihrem Namen einen riesigen, sicheren Pool an Compute-Ressourcen verwaltet. Sie können Databricks einfach ohne jegliche Einrichtung nutzen.
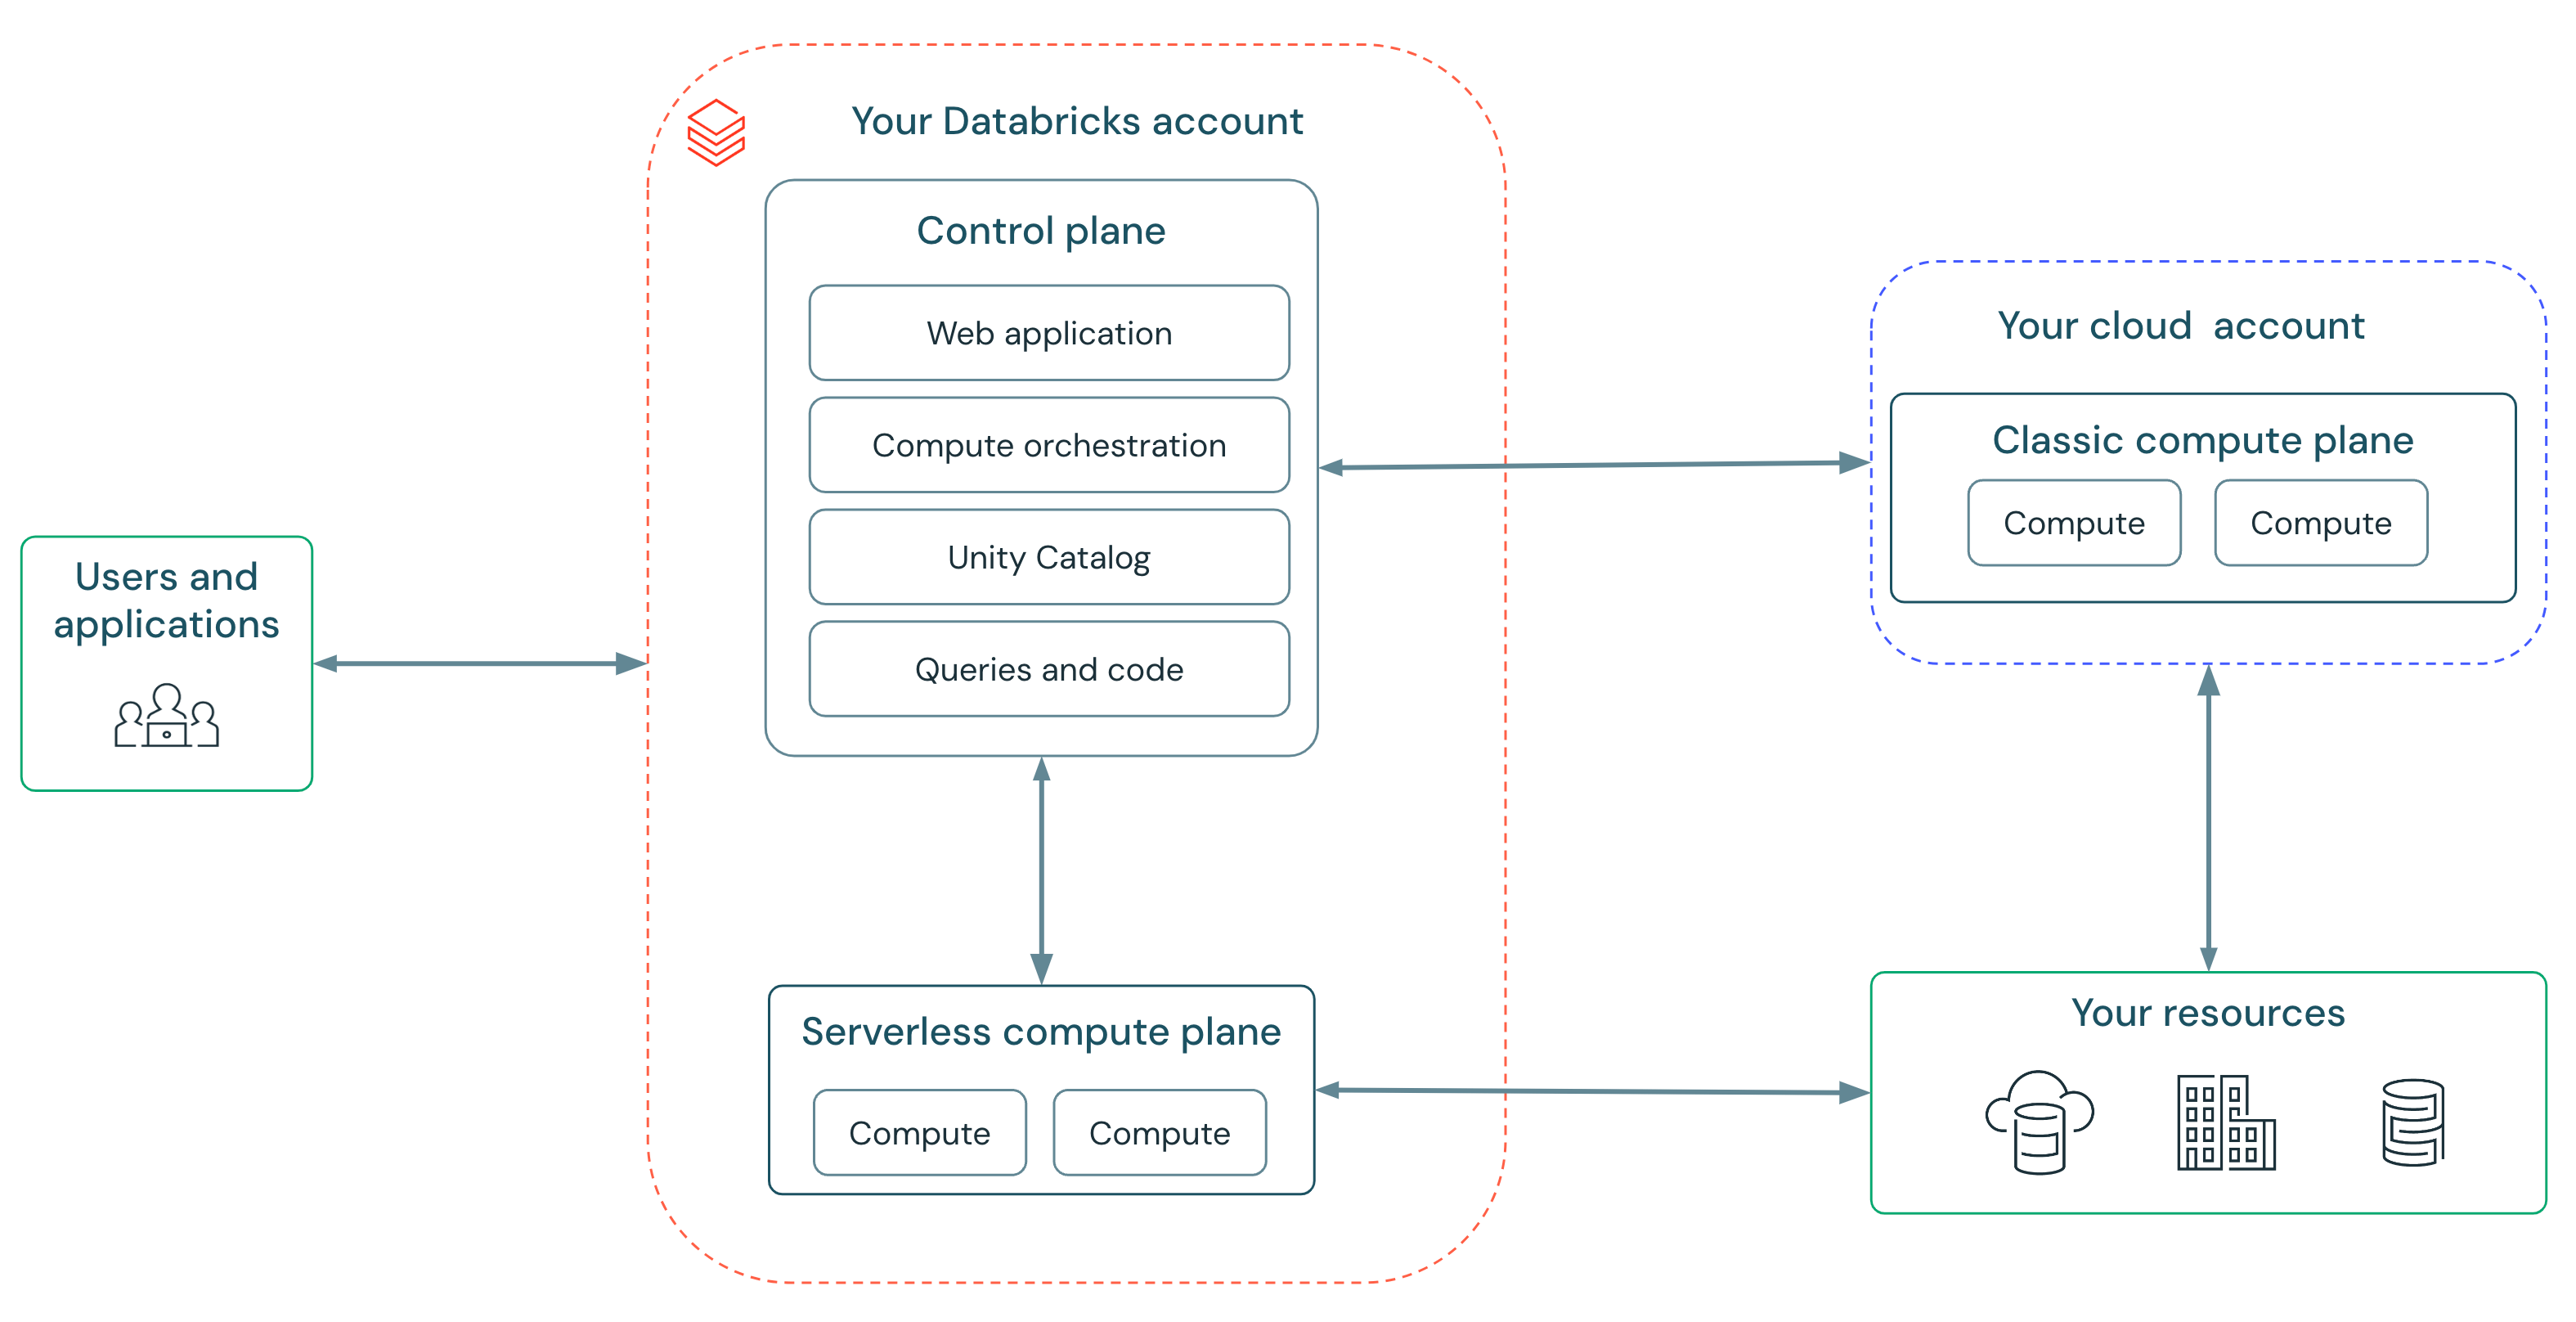
Serverloses Compute ermöglicht es uns, einen Service bereitzustellen, der schnell, einfach und zuverlässig ist:
- Schnell: Kein Warten mehr auf Cluster – Compute startet in Sekunden statt in Minuten. Databricks betreibt „Warm Pools“ von Instanzen, sodass Compute bereit ist, wenn Sie es sind.
- Einfach: Kein Auswählen von Instanztypen, Cluster-Skalierungsparametern oder Festlegen von Spark-Konfigurationen mehr. Serverless umfasst einen neuen Autoscaler, der intelligenter und reaktionsschneller auf die Anforderungen Ihrer Workload reagiert als der Autoscaler beim klassischen Compute. Das bedeutet, dass jetzt jeder Benutzer Workloads ausführen kann, ohne dass Infrastrukturexperten eingreifen müssen. Databricks aktualisiert Workloads automatisch und führt sichere Upgrades auf die neuesten Spark-Versionen durch – so stellen Sie sicher, dass Sie stets von den neuesten Leistungs- und Sicherheitsvorteilen profitieren.
- Zuverlässig: Das serverlose Compute von Databricks schützt Kunden vor Cloud-Ausfällen durch automatisches Failover von Instanztypen und einen „Warm Pool“ von Instanzen, der Engpässe bei der Verfügbarkeit abfängt.
„Es ist sehr einfach, Workloads von der Entwicklung in die Produktion zu migrieren, ohne Worker-Typen auswählen zu müssen. [Die] deutliche Verbesserung der Startzeit, kombiniert mit reduziertem DataOps-Aufwand bei Konfiguration und Wartung, steigert Produktivität und Effizienz enorm.“ - Gal Doron, Head of Data, AnyClip
Serverloses Compute rechnet nach geleisteter Arbeit ab
Wir freuen uns, ein elastisches Abrechnungsmodell für serverloses Compute einzuführen. Ihnen wird nur dann etwas berechnet, wenn Ihren Workloads Compute zugewiesen ist, und nicht für die Zeit zum Beschaffen und Einrichten von Compute-Instanzen.
Der intelligente serverlose Autoscaler stellt sicher, dass Ihr Workspace immer über die richtige Kapazitätsausstattung verfügt, um auf Anforderungen zu reagieren – beispielsweise wenn ein Benutzer einen Befehl in einem Notebook ausführt. Er skaliert die Workspace-Kapazität automatisch in abgestuften Schritten nach oben und unten, um Ihren Anforderungen gerecht zu werden. Um sicherzustellen, dass Ressourcen sinnvoll verwaltet werden, reduzieren wir die bereitgestellte Kapazität nach einigen Minuten, wenn der intelligente Autoscaler prognostiziert, dass sie nicht mehr benötigt wird.
„Serverloses Compute für SDP war unglaublich einfach einzurichten und in Betrieb zu nehmen, und wir sehen bereits massive Leistungssteigerungen bei unseren Materialized Views. Historisch gesehen dauerte der Weg von Rohdaten zur Silver-Schicht etwa 16 Minuten, aber nach dem Wechsel zu Serverless sind es nur noch etwa 7 Minuten. Die Zeit- und Kosteneinsparungen werden enorm sein“ - Aaron Jepsen, Director IT Operations, Jet Linx Aviation
Serverloses Compute ist einfach zu verwalten
Serverloses Compute enthält Tools für Administratoren zur Verwaltung von Kosten und Budgets. Schließlich sollte Einfachheit nicht zu Budgetüberschreitungen und überraschenden Rechnungen führen!
Daten zur Nutzung und zu den Kosten von serverlosem Compute sind in Systemtabellen verfügbar. Wir stellen vordefinierte Dashboards bereit, mit denen Sie einen Überblick über die Kosten erhalten und einen Drilldown in bestimmte Workloads durchführen können.
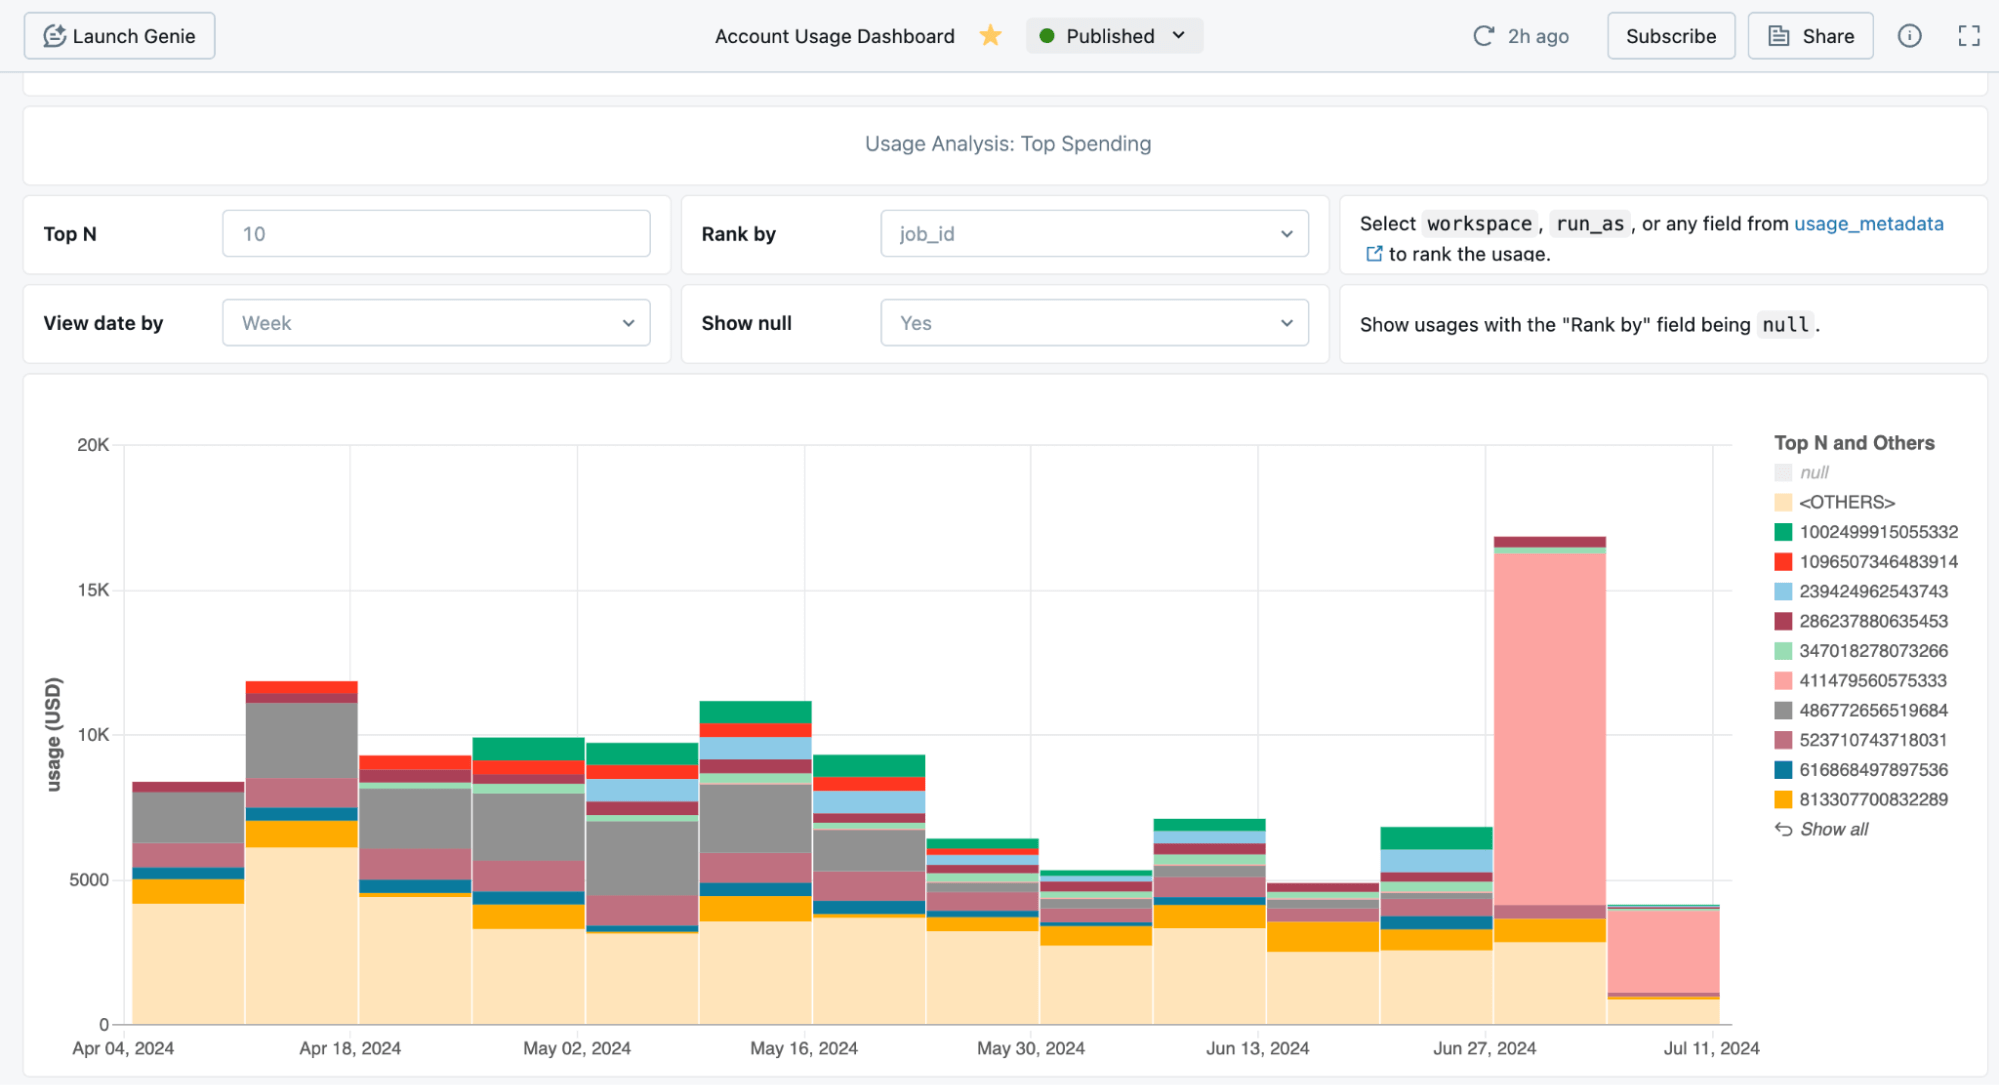
Administratoren können Budgetbenachrichtigungen (Vorschau) verwenden, um Kosten zu gruppieren und Benachrichtigungen einzurichten. Es gibt eine benutzerfreundliche Benutzeroberfläche zur Budgetverwaltung.

Serverloses Compute ist für moderne Spark-Workloads konzipiert
Unter der Haube verwendet serverloses Compute Lakeguard, um Benutzer-Code mithilfe von Sandboxing-Techniken zu isolieren – eine absolute Notwendigkeit in einer serverlosen Umgebung. Infolgedessen erfordern einige Workloads Codeänderungen, um weiterhin unter Serverless ausgeführt werden zu können. Serverloses Compute erfordert Unity Catalog für den sicheren Zugriff auf Datenelemente, weshalb Workloads, die ohne Unity Catalog auf Daten zugreifen, möglicherweise angepasst werden müssen.
Der einfachste Weg, um zu testen, ob Ihre Workload für serverloses Compute bereit ist, besteht darin, sie zunächst auf einem klassischen Cluster im Modus für gemeinsamen Zugriff (Shared Access Mode) unter DBR 14.3+ auszuführen.

Serverloses Compute ist einsatzbereit
Wir arbeiten mit Hochdruck daran, serverloses Compute in den kommenden Monaten noch besser zu machen:
- GCP-Unterstützung: Wir starten jetzt mit einer Private Preview für serverloses Compute auf GCP; bleiben Sie dran für unsere Ankündigungen zur Public Preview und zur GA.
- Private Netzwerke und Egress-Steuerung: Stellen Sie Verbindungen zu Ressourcen in Ihrem privaten Netzwerk her und steuern Sie, worauf Ihre serverlosen Compute-Ressourcen im öffentlichen Internet zugreifen können.
- Durchsetzbare Zuordnung: Stellen Sie sicher, dass alle Notebooks, Workflows und SDP-Pipelines entsprechend getaggt sind, damit Sie Kosten bestimmten Kostenstellen zuweisen können, z. B. für interne Verrechnungen.
- Umgebungen: Administratoren können eine Basisumgebung für den Arbeitsbereich einrichten, die Zugriff auf private Repositorys, bestimmte Python- und Bibliotheksversionen sowie Umgebungsvariablen bietet.
- Kosten im Vergleich zur Leistung: Serverless Compute ist derzeit auf schnelles Starten, Skalieren und hohe Leistung optimiert. Benutzer werden bald auch andere Ziele wie geringere Kosten festlegen können.
- Scala-Unterstützung: Benutzer können Scala-Workloads auf serverlosen Compute-Ressourcen ausführen. Um einen reibungslosen Übergang zu serverlos vorzubereiten, verschieben Sie Ihre Scala-Workloads auf klassischen Compute mit Shared Access Mode.
So verwenden Sie serverloses Compute ab heute:
- Aktivieren Sie serverloses Compute in Ihrem Konto auf AWS oder Azure
- Stellen Sie sicher, dass Ihr Arbeitsbereich für die Nutzung von Unity Catalog aktiviert ist und sich in einer unterstützten Region in AWS oder Azure befindet.
- Stellen Sie bei vorhandenen PySpark-Workloads sicher, dass diese mit dem Shared Access Mode und DBR 14.3+ kompatibel sind.
- Befolgen Sie die spezifischen Anweisungen für Notebooks, Workflows, Spark Declarative Pipelines
- Verwenden Sie serverloses Compute von einem beliebigen Drittanbietersystem mit Databricks Connect, z. B. bei der lokalen Entwicklung in Ihrer IDE oder beim nativen Integrieren Ihrer Anwendungen mit Databricks in Python.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.