Datenbank-Branching: Ein Leitfaden für Entwickler zu Workflows im Git-Stil
Erfahren Sie, wie Datenbank-Branching Git-ähnliche Workflows in Datenbanken bringt – mithilfe von Copy-on-Write, um isolierte, kurzlebige Umgebungen für Entwickler, CI und AI-Agenten zu erstellen.
- Datenbank-Branching erstellt isolierte Umgebungen über Copy-on-Write, wobei unveränderte Daten geteilt und nur Unterschiede gespeichert werden – es sind keine vollständigen Kopien erforderlich.
- Es unterstützt produktionsnahe Tests, CI-Isolierung pro PR und eine einfache Wiederherstellung, wobei Migrationen (nicht Merges) als Source of Truth dienen.
- Es ist von entscheidender Bedeutung für AI-Agenten, die viele kurzlebige Branches ausführen; eine sichere Nutzung erfordert geschützte Parent-Branches, Mock-Daten, TTLs und Zugriffskontrollen.
Git hat die isolierte Entwicklung zum Standard für Softwareteams gemacht. Jeder Entwickler kann einen Branch erstellen, unabhängig arbeiten und Änderungen zusammenführen, sobald sie bereit sind.
Database Branching bringt genau diese Isolation in die Datenbank. Damit können Entwickler, CI-Jobs und AI-Agenten isolierte Datenbankumgebungen aus einem gemeinsamen Datenbankzustand erstellen und Änderungen vornehmen, ohne die übergeordnete Datenbank oder sich gegenseitig zu beeinflussen.
Das bedeutet weniger Wartezeit auf gemeinsam genutzte Umgebungen, seltener fehlerhafte Tests durch Änderungen anderer und schnelleres Feedback zu Schema-Migrationen. Wenn etwas schiefgeht, können Sie den Branch einfach verwerfen, anstatt eine gemeinsam genutzte Datenbank mühsam zu reparieren oder wiederherzustellen.
TL;DR
- Database Branching erstellt isolierte Umgebungen ohne vollständige Datenbankkopien. Copy-on-Write macht dies möglich, indem unveränderte Daten gemeinsam genutzt und nur die Änderungen gespeichert werden.
- Database Branching wird für AI-Agenten immer wichtiger. Es bietet Agenten isolierte Umgebungen, um Änderungen zu testen und zu experimentieren, ohne die übergeordnete Datenbank zu gefährden.
- Der sichere Betrieb von Datenbank-Branches erfordert klare Kontrollen. Schützen Sie übergeordnete Branches, beschränken Sie den Zugriff auf sensible Daten, automatisieren Sie die Bereinigung und halten Sie temporäre Umgebungen reproduzierbar.
Was ist Database Branching?
Database Branching bietet Ihnen eine isolierte Datenbankumgebung, die auf dem Zustand einer anderen Datenbank zu einem bestimmten Zeitpunkt basiert. Der Branch startet mit dem Schema und den Daten der übergeordneten Datenbank, aber Änderungen, die Sie am Branch vornehmen, haben keine Auswirkungen auf die übergeordnete Datenbank oder andere parallele Branches.
Wenn Sie mit Git vertraut sind, sollte Ihnen das Grundprinzip bekannt vorkommen. Ein Code-Branch bietet Ihnen eine private Entwicklungslinie ausgehend von einem bekannten Commit. Ein Datenbank-Branch bietet Ihnen eine isolierte Datenbankumgebung ausgehend von einem bekannten Datenbankzustand.
Ein wichtiger Unterschied besteht darin, dass Sie Änderungen aus einem Datenbank-Branch normalerweise nicht in die übergeordnete Datenbank zurückführen. Stattdessen bleiben Migrationsdateien die dauerhafte Quelle der Wahrheit (Source of Truth). Sie können eine Migration in Ihrem Branch testen, sicherstellen, dass sie mit realistischen Daten funktioniert, und dann Ihre Deployment-Pipeline dieselbe Migration auf die Zieldatenbank anwenden lassen. Auf diese Weise macht Database Branching bewährte Praktiken wie evolutionäres Datenbankdesign, dedizierte Datenbankumgebungen pro Entwickler und versionskontrollierte Migrationen selbst dann praktikabel, wenn Sie mit Daten im Produktionsmaßstab arbeiten.
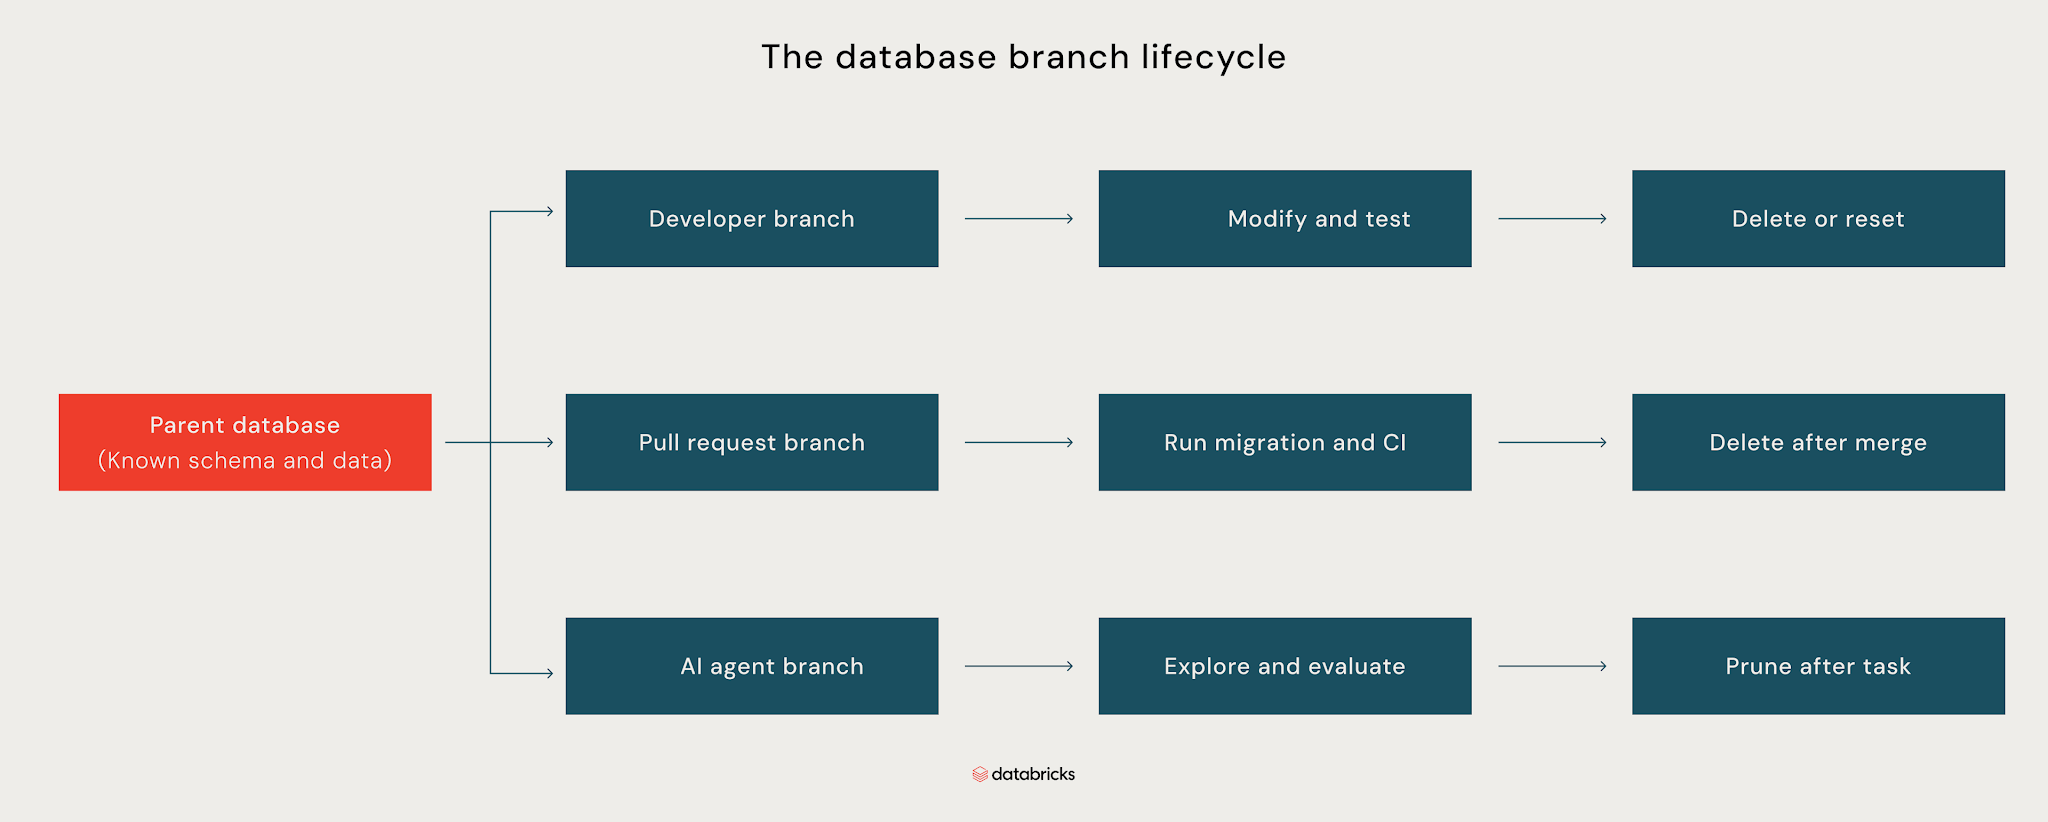
Wie oben gezeigt, stellt eine übergeordnete Datenbank das bekannte Schema und die Daten für mehrere isolierte Branches bereit. Sie können einen Entwickler-Branch verwenden, um Änderungen zu modifizieren und zu testen, einen Pull-Request-Branch, um Migrationen und CI auszuführen, oder einen Agent-Branch, um Änderungen zu untersuchen und zu bewerten. Wenn die Arbeit erledigt ist, kann jeder Branch zurückgesetzt, gelöscht oder bereinigt werden, ohne die übergeordnete Datenbank oder die anderen Branches zu beeinflussen. Database Branching macht diese Stufe der Isolation durch Copy-on-Write möglich.
Wie Copy-on-Write Database Branching funktioniert
Copy-on-Write (CoW) macht Database Branching praktikabel, da eine vollständige Vorabkopie der Datenbank vermieden wird. Wenn Sie einen Branch erstellen, teilt er sich anfangs die vorhandenen Daten der übergeordneten Datenbank, anstatt sie zu duplizieren. Beide können auf dieselben zugrunde liegenden Daten zugreifen, während Änderungen an einem Branch vom anderen isoliert bleiben. Wenn der Branch jedoch Daten ändert, erstellt die Speicherebene eine neue Version der betroffenen Daten für diesen Branch, während unveränderte Daten weiterhin mit der übergeordneten Datenbank geteilt werden.
Lakebase nutzt diesen Copy-on-Write-Ansatz, um Datenbank-Branches zu erstellen, ohne die gesamte übergeordnete Datenbank zu duplizieren. Dadurch benötigt jeder Branch zusätzlichen Speicherplatz nur für die Daten, die von der übergeordneten Datenbank abweichen.
Nehmen wir eine 40 GB große Datenbank an. Bei einer herkömmlichen vollständigen Kopie würde das Erstellen eines Entwickler-Branches und eines Pull-Request-Branches zusätzliche 80 GB Speicherplatz erfordern. Bei Copy-on-Write teilen sich jedoch beide Branches zunächst die Daten der übergeordneten Datenbank und verbrauchen erst dann zusätzlichen Speicherplatz, wenn sie voneinander abweichen.
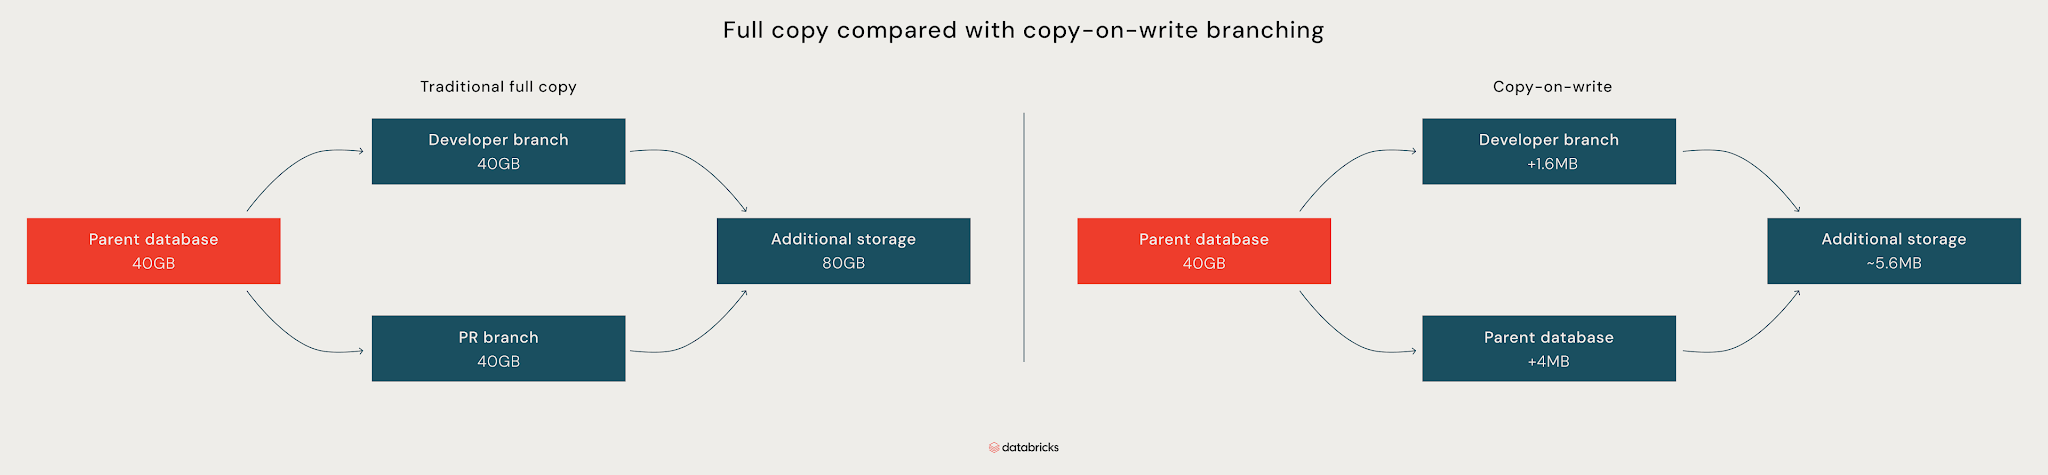
Wie im obigen Diagramm dargestellt, belaufen sich die Änderungen im Entwickler-Branch auf nur 1,6 MB und im PR-Branch auf nur 4 MB, sodass die beiden Branches zusammen nur etwa 5,6 MB zusätzlichen Speicherplatz beanspruchen. Herkömmliche Kopien duplizieren die gesamte Datenbank für jeden Branch, während Copy-on-Write-Branches unveränderte Daten gemeinsam nutzen und nur ihre Änderungen speichern.
Dasselbe Prinzip gilt, wenn sich die übergeordnete Datenbank nach der Erstellung eines Branches ändert. Der Branch verweist weiterhin auf die Originalversion der unveränderten Daten, während die übergeordnete Datenbank neue Versionen der von ihr geänderten Seiten schreibt. Dadurch können sich die beiden Branches unabhängig voneinander ändern, ohne dass unveränderte Daten dupliziert werden.
Was Database Branching ermöglicht
Sobald Sie Database Branching nutzen, lassen sich verschiedene Entwicklungs-Workflows viel einfacher implementieren:
Produktionsnahe Baselines
Sie können Datenbank-Branches aus einem geschützten Produktions-Snapshot erstellen, sodass jeder Entwickler und jeder CI-Job vom selben bekannten Zustand aus startet. Dadurch können Sie Migrationen mit realistischen Daten, bestehenden Constraints und Tabellen im Produktionsmaßstab testen, anstatt eine leere lokale Datenbank oder eine veraltete Staging-Umgebung zu nutzen.
Beispielsweise kann eine Migration wie ALTER TABLE orders ADD COLUMN customer_id UUID NOT NULL auf einer leeren Datenbank funktionieren, aber bei Millionen von bestehenden Bestellungen fehlschlagen. Das Testen auf einem produktionsnahen Branch deckt dieses Problem auf, bevor die Migration das Staging oder die Produktion erreicht. Wenn der Branch veraltet ist, können Sie ihn einfach löschen und einen neuen auf Basis derselben Baseline erstellen.
Isolation pro PR
Sie können jedem Pull-Request eine eigene Datenbankumgebung zuweisen. Die CI erstellt den Branch, sobald der PR geöffnet wird, wendet die vorgeschlagenen Migrationen an und führt Integrationstests darauf aus. Wenn der PR geschlossen wird, löscht die Pipeline den Branch.
Das bedeutet, dass zwei Entwickler widersprüchliche Schemaänderungen vornehmen können, ohne die Tests des jeweils anderen zu beeinflussen. Ein PR, der eine Spalte hinzufügt, einen Constraint ändert oder einen Index modifiziert, erhält seinen eigenen Datenbankzustand. So testet die CI die Änderung isoliert und nicht im Konflikt mit den Aktivitäten anderer Entwickler im Staging.
Einfachere Fehlerbehebung
Branches erleichtern auch die Isolation fehlgeschlagener Migrationen und Experimente. Wenn ein Backfill unerwartete Ergebnisse liefert, ein Test Daten beschädigt oder eine Migration einen Branch in einem fehlerhaften Zustand hinterlässt, können Sie den betroffenen Branch einfach verwerfen und einen neuen aus der übergeordneten Datenbank erstellen, anstatt in einer fehlerhaften Entwicklungsumgebung weiterzuarbeiten.
Beispielsweise können Sie eine destruktive Operation wie DELETE FROM orders WHERE created_at < ... sicher auf einem Branch testen, die Ergebnisse überprüfen und den Branch anschließend verwerfen. Die übergeordnete Datenbank bleibt dabei völlig unberührt.
Für Entwickler und DevOps-Teams sind diese Vorteile bereits überzeugend. Wenn Sie jedoch AI-Agenten entwickeln oder betreiben, gewinnt Database Branching in einer völlig neuen Dimension an Bedeutung.
Das Playbook für agentenbasierte KI für Unternehmen

Warum AI-Agenten Branching infrastrukturkritisch machen
AI-Agenten benötigen möglicherweise eigene Datenbankumgebungen, um verschiedene Lösungsansätze für eine Aufgabe zu testen. Sie können für jeden Ansatz einen Branch erstellen, die Ergebnisse vergleichen und die nicht benötigten Branches verwerfen. Bei einer ganzen Flotte von Agenten kann dies bedeuten, dass Hunderte oder Tausende von kurzlebigen Umgebungen gleichzeitig ausgeführt werden.
In dieser Größenordnung werden vollständige Datenbankkopien teuer und die Bereitstellung dauert zu lange. Database Branching vermeidet diesen Overhead und macht es für Agenten praktikabel, Umgebungen während ihrer Arbeit flexibel zu erstellen und wieder zu verwerfen.
Branching kann auch die Auswirkungen von Fehlern der Agenten minimieren, indem es ihnen eine isolierte Umgebung zum Testen von Änderungen bietet. Anstatt einem Agenten Schreibzugriff auf eine Produktionsdatenbank zu gewähren, können Sie ihm Zugriff auf einen Branch geben, auf dem er destruktive Operationen testen kann, ohne die übergeordnete Datenbank zu beeinflussen.
Wie Sie Datenbank-Branches sicher betreiben
Datenbank-Branches lassen sich am einfachsten verwalten, wenn Sie sie als temporäre Umgebungen behandeln und ihren Lebenszyklus automatisieren. Einige Best Practices sorgen dafür, dass dieser Workflow sicher und vorhersehbar bleibt:
- Schützen Sie Produktions- und übergeordnete Branches: Schränken Sie ein, wer auf Produktions- und andere wichtige übergeordnete Branches schreiben, diese zurücksetzen oder löschen darf. Agenten und Entwickler sollten stattdessen auf untergeordneten Branches arbeiten.
- Nutzen Sie sichere Daten für temporäre Branches: Vermeiden Sie es, sensible Produktionsdaten in kurzlebige Entwicklungs- oder Agent-Branches zu kopieren, es sei denn, dies ist zwingend erforderlich und angemessen geschützt. Verwenden Sie nach Möglichkeit Mock-Daten, damit temporäre Umgebungen nicht zu einem Sicherheitsrisiko für Produktionsdaten werden.
- Legen Sie eine Lebensdauer (TTL) für Branches fest: Geben Sie kurzlebigen Branches eine Ablaufzeit, damit verwaiste PRs, fehlgeschlagene CI-Läufe und abgebrochene Agent-Tasks Umgebungen nicht unbegrenzt weiterlaufen lassen.
- Nutzen Sie Migrationen als Single Source of Truth: Behandeln Sie Migrationsdateien als die Single Source of Truth. Testen Sie Migrationen in einem Branch, überprüfen Sie sie in der Versionskontrolle und wenden Sie die genehmigte Migration auf die Zieldatenbank an, anstatt Änderungen direkt aus einem Branch zu übernehmen.
- Machen Sie Umgebungen reproduzierbar: Betrachten Sie Branches als temporär und nicht als langlebige Umgebungen, die manuell repariert werden müssen. Speichern Sie die für die Wiederherstellung einer Umgebung erforderliche Konfiguration in der Versionskontrolle, sodass ein veralteter oder beschädigter Branch gelöscht und aus seinem Parent-Branch neu erstellt werden kann.
- Steuern Sie den Zugriff und die Ressourcennutzung: Geben Sie Entwicklern und Agents nur die Berechtigungen, die sie benötigen, und überwachen Sie das Alter von Branches, Compute, Speicher und die Anzahl der aktiven Umgebungen. Verwenden Sie Tools wie Unity Catalog, um den Zugriff auf die in diesen Umgebungen verfügbaren Daten zu steuern.
Mit diesen Sicherheitsvorkehrungen können Teams Datenbank-Branches als temporäre Umgebungen für die Entwicklung, Continuous Integration und Continuous Delivery (CI/CD) sowie Agent-Workflows nutzen. Jeder Branch bietet eine isolierte Umgebung zum Testen von Änderungen und kann automatisch entfernt werden, sobald die Arbeit abgeschlossen ist.
Fazit
Datenbank-Branching bietet Ihnen eine praktische Möglichkeit, isolierte Datenbankumgebungen ohne die Kosten und den Aufwand vollständiger Kopien zu erstellen. Sie können Branches verwenden, um Migrationen mit realistischen Daten zu testen, jedem Pull Request eine eigene Datenbank zuzuweisen, fehlgeschlagene Experimente rückgängig zu machen und datenbankgestützte Workloads parallel auszuführen.
Beginnen Sie mit einem einfachen Workflow, z. B. einem Branch pro Pull Request, und automatisieren Sie die Erstellung und Bereinigung. Von dort aus können Sie das Branching auf Entwicklerumgebungen und Agent-Workloads ausweiten, wenn Ihre Anforderungen steigen. Bereit, es auszuprobieren? Entdecken Sie Datenbank-Branching mit Databricks Lakebase oder folgen Sie einem praktischen Tutorial zur Implementierung von Datenbank-Branching in Postgres.
Häufig gestellte Fragen
Was ist Datenbank-Branching?
Datenbank-Branching erstellt zu einem bestimmten Zeitpunkt eine isolierte Datenbankumgebung aus einer Parent-Datenbank. Der Branch startet mit dem Schema und den Daten des Parents, aber am Branch vorgenommene Änderungen bleiben isoliert. Mit Copy-on-Write teilen sich Branches unveränderte Daten mit dem Parent, wodurch sie schnell erstellt und kostengünstig verworfen werden können.
Wie unterscheidet sich Datenbank-Branching von Git-Branching?
Die Idee ist ähnlich: Beide ermöglichen es Ihnen, eine isolierte Umgebung aus einem bekannten Zustand zu erstellen und Änderungen vorzunehmen, ohne das Original zu beeinträchtigen. Git-Branches isolieren Quellcode, während Datenbank-Branches Datenbankschema und -daten isolieren.
Danach unterscheiden sich die Workflows. Git-Branches werden normalerweise wieder in den Main-Branch zusammengeführt, Datenbank-Branches in der Regel nicht. Stattdessen testen Sie Ihre Migration auf dem Datenbank-Branch und wenden die überprüfte Migration dann über Ihren Deployment-Prozess auf die Zieldatenbank an.
Was ist der Zweck von Datenbank-Branching?
Datenbank-Branching bietet Entwicklern, CI-Jobs und AI-Agents isolierte Umgebungen zum Testen von Änderungen, ohne die Produktion oder andere Workloads zu beeinträchtigen. Sie können Branches verwenden, um Migrationen mit realistischen Daten zu testen, Umgebungen pro PR zu erstellen, fehlgeschlagene Experimente rückgängig zu machen und mehrere datenbankgestützte Workloads parallel auszuführen.
Welche zwei Arten von Datenbank-Branching gibt es?
Die beiden gängigen Ansätze sind Full-Copy-Branching und Copy-on-Write-Branching. Beim Full-Copy-Branching wird die Datenbank für jeden Branch dupliziert, sodass Erstellungszeit und Speicherbedarf mit der Datenbankgröße steigen. Beim Copy-on-Write-Branching werden unveränderte Daten mit dem Parent geteilt und nur die an jedem Branch vorgenommenen Änderungen gespeichert.
Welche Arten von Datenbanken unterstützen Branching?
Branching hängt mehr von der Speicherarchitektur der Datenbank ab als von ihrem Datenmodell. Relationale, Dokumenten-, Key-Value- und Graphdatenbanken können theoretisch alle Branching unterstützen, aber die Implementierung und die Funktionen variieren je nach Plattform.
Wie implementiere ich Datenbank-Branching?
Die Implementierung hängt von Ihrer Datenbankplattform und Speicherarchitektur ab. Im Allgemeinen benötigen Sie eine Parent-Datenbank und eine Möglichkeit, isolierte Branches aus einem bekannten Datenbankzustand zu erstellen. Databricks Lakebase bietet Datenbank-Branching für Entwicklungs-, CI- und Agent-Workflows mit Branches, die je nach Bedarf erstellt und entfernt werden können. Eine praktische Implementierung finden Sie im Databricks-Tutorial für Branch-basierte Entwicklung.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.