Datenbank für AI-Agenten: 5 Evaluierungskriterien
Erfahren Sie mehr über die 5 Kriterien zur Evaluierung einer Datenbank für AI-Agenten – Branch-Isolierung, Serverless-Skalierung, Hybridsuche, ACID-Garantien und einheitlicher Zugriff.
- AI-Agenten benötigen eine Datenbank, die kontinuierliche, gleichzeitige Lese- und Schreibvorgänge über mehrere Speichertypen hinweg unterstützt – nicht das Prinzip "Eine Anfrage nach der anderen", das herkömmliche Apps nutzen.
- Fünf Kriterien definieren eine produktionsbereite Agenten-Datenbank: Branch-per-Agent-Isolierung, Scale-to-Zero-Compute, Hybridsuche in einer einzigen Abfrage, ACID-Garantien bei Gleichzeitigkeit und eine einheitliche Plattform ohne ETL-Verzögerung.
- Lakebase von Databricks erfüllt jedes dieser Kriterien, was durch die Praxisvalidierung von Superhuman und easyJet bestätigt wird.
Die fünf Kriterien zur Bewertung einer Datenbank für AI-Agenten sind Branch-Isolierung, serverlose Skalierung, hybride Suche, ACID-Garantien und einheitlicher Plattformzugriff. Zusammen helfen diese Kriterien Entwicklern und Datenteams zu bestimmen, ob eine Datenbank Agenten beim Übergang von Prototypen in die Produktion unterstützen kann, wenn sie anfangen, gleichzeitige Aufgaben, operative Live-Daten und persistenten Zustand zu verarbeiten.
Eine Datenbank für AI-Agenten ist ein System, das darauf ausgelegt ist, den Zustand, den Speicher, die Tool-Ergebnisse und die operativen Daten zu speichern, die ein Agent benötigt, um Aufgaben über mehrere Schritte und Sitzungen hinweg auszuführen. Im Gegensatz zu einer Datenbank für eine herkömmliche Anwendung muss sie wiederholte Lese- und Schreibvorgänge, gleichzeitige Agentenaktivitäten, das Abrufen über verschiedene Speichertypen hinweg und den Zugriff auf aktuelle operative Daten unterstützen.
Der Aufstieg von AI-Agenten macht diese Anforderungen noch wichtiger. Wenn Entwickler Coding-Agenten, Kundensupport-Agenten oder mandantenfähige Plattformen betreiben, tun Agenten mehr als nur Informationen abzurufen. Sie schreiben Zustände, setzen Aufgaben fort, koordinieren Tool-Aufrufe und agieren auf sich ändernden operativen Daten. Wenn Datenteams Agenten in die Produktion überführen, können Datenbankbeschränkungen zu veraltetem Speicher, Schreibkonflikten, Latenzzeiten und unnötigen Rechenkosten führen.
Warum eine Datenbank für AI-Agenten nicht dasselbe Problem darstellt
Ein produktionsreifer Agent muss sich merken, was er bereits getan hat, eine Aufgabe dort fortsetzen, wo er aufgehört hat, und den richtigen Kontext einholen, bevor er handelt. Kombiniert man ihn mit der falschen Datenbank, kann dieser Speicher veraltet, unvollständig oder inkonsistent werden.
Produktions-Agenten stützen sich auf vier Speicherebenen, um dies zu bewerkstelligen:
- Kurzzeitgedächtnis: der im Kontext verfügbare Arbeitsspeicher während der aktuellen Interaktion, einschließlich der letzten Nachrichten, abgerufener Informationen und Tool-Ergebnisse.
- Episodisches Gedächtnis: vergangene Interaktionen, die es einem Agenten ermöglichen, sich an frühere Gespräche, Benutzerpräferenzen und abgeschlossene Aufgaben zu erinnern.
- Prozedurales Gedächtnis: die Workflows, Tool-Definitionen und Anweisungen, die steuern, wie Aufgaben ausgeführt werden, unabhängig davon, ob sie extern gespeichert oder in das Modell integriert sind.
- Operativer Zustand: der Live-Status der Aufgabe, einschließlich abgeschlossener und ausstehender Schritte, Tool-Ausgaben und Checkpoints zur späteren Fortsetzung der Arbeit.
Das ist eine weitaus komplexere Arbeitslast als bei einer typischen Anwendung, die eine Abfrage an die Datenbank sendet und fortfährt. Die meisten Produktionsdatenbanken sind operative Datenbanken, auch Online-Transaktionsverarbeitungssysteme (OLTP) genannt, die auf genau diesem Muster „Eine Anfrage nach der anderen“ basieren. Ein Agent arbeitet nicht so. Er führt innerhalb einer einzigen Aufgabe Lesevorgang auf Lesevorgang und Schreibvorgang auf Schreibvorgang aus, ohne menschliche Pause dazwischen, während Hunderte anderer Agenten dasselbe tun.
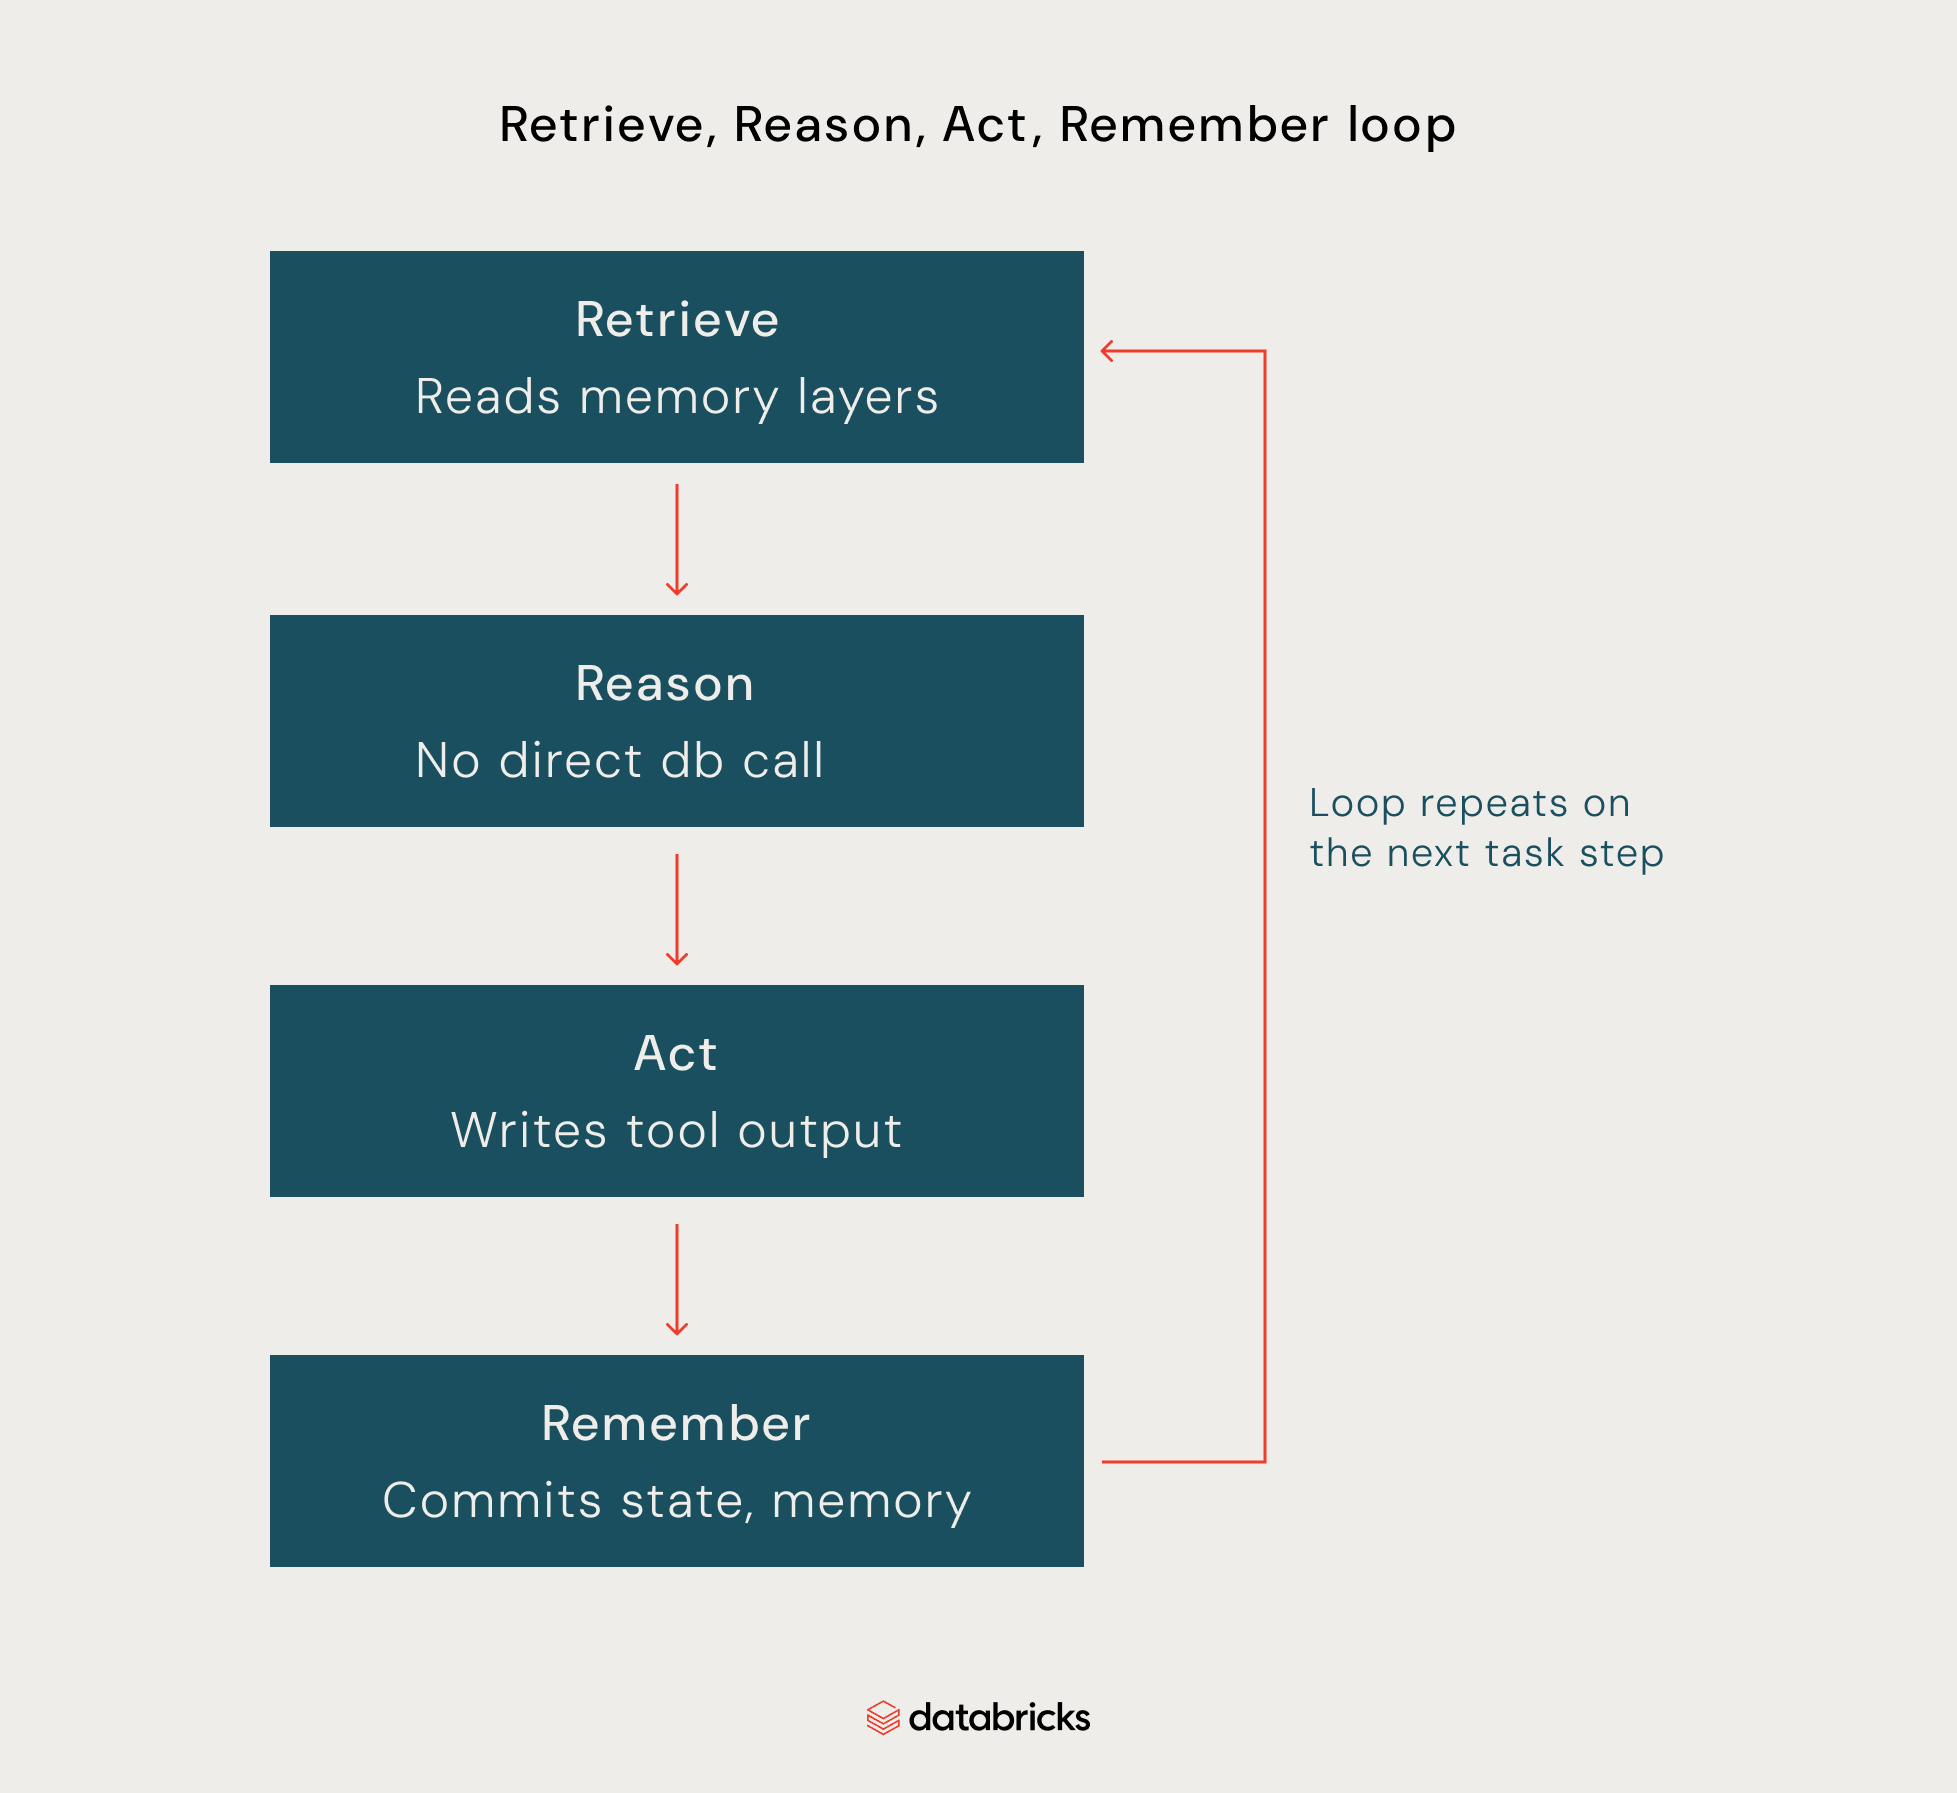
Die 5 Kriterien zur Bewertung jeder Datenbank für AI-Agenten-Arbeitslasten
Bei der Auswahl einer Datenbank für AI-Agenten spielen mehrere Kriterien eine Rolle, aber diese fünf sind diejenigen, die unabhängig vom jeweiligen Anbieter – ob verwaltet oder selbst gehostet – eine Bewertung wert sind.
Branch pro Agent: Sicheres Testen mit echten Daten
Einen Agenten nur mit synthetischen Daten zu testen, ist wie das Testen eines Support-Systems mit einer Handvoll perfekt formatierter Kundenkonten. Er verhält sich vielleicht genau wie erwartet, aber echte Konten sind immer ungeordneter. Datenteams stoßen schließlich auf fehlende Felder, inkonsistente Datensätze, veraltete Daten und Grenzfälle, die es nie in ihre Testumgebungen geschafft haben.
Deshalb empfehlen wir, isolierte Tests mit echten Daten als Kriterium für die Datenbankbewertung heranzuziehen. Das Ziel ist, dass der Agent mit einem produktionsähnlichen Zustand arbeitet, ohne die Möglichkeit zu haben, die Produktion zu verändern. Eine Möglichkeit, diese Isolierung zu erreichen, ist das Zero-Copy-Branching, mit dem Entwickler eine separate Umgebung erstellen können, ohne eine zweite vollständige Kopie der Datenbank verwalten zu müssen.
Lakebase Projects ist darauf ausgelegt, diese Art der isolierten Entwicklung und des Testens zu unterstützen, indem Entwickler Branches aus Produktionsdaten erstellen können, ohne die zugrunde liegenden Daten zu kopieren. Das Erstellen eines Branches einer Produktionsdatenbank im Terabyte-Bereich dauert etwa eine Sekunde, ohne zusätzliche Speicherkosten, bis der Branch von seinem übergeordneten Branch abweicht.
Scale-to-Zero: Wie serverlose Preisgestaltung die Wirtschaftlichkeit von Agenten verändert
27 % der Cloud-Ausgaben werden jedes Jahr verschwendet, und ungenutzte, nicht ausgelastete Rechenleistung ist durchweg der größte Treiber dafür. Agenten-Datenbanken sind ein anschauliches Beispiel dafür, warum. Die meisten Agenten laufen nicht kontinuierlich. Sie wachen auf, erledigen eine Aufgabe, schreiben die Ergebnisse und verhalten sich dann ruhig, bis die nächste Anfrage eingeht. Rund um die Uhr für dedizierte Rechenleistung zu bezahlen, bedeutet, für genau dieses Problem der ungenutzten Rechenleistung bei jeder Agenten-Datenbank zu bezahlen, die ein Team betreibt.
Ein serverloses Scale-to-Zero-Modell löst dies, indem es die Rechenleistung nach einem Zeitraum ohne aktive Verbindungen pausiert und wieder aufnimmt, wenn die Arbeit fortgesetzt wird. Dadurch richten sich die Kosten nach der tatsächlichen Nutzung statt nach der Leerlaufzeit. Die Startgeschwindigkeit ist jedoch genauso wichtig wie die Einsparungen. Ein Agent, der 20 oder 30 Sekunden darauf warten muss, dass seine Datenbank aufwacht, ist unpraktisch, insbesondere wenn er auf einen Benutzer antwortet oder auf den nächsten Tool-Aufruf wartet.
Lakebase nutzt dieses Modell für Postgres, wobei die Rechenleistung innerhalb weniger hundert Millisekunden nach einer neuen Abfrage wieder aufgenommen wird. Dadurch bleibt die Startverzögerung so gering, dass Scale-to-Zero auch bei interaktiven Agenten-Arbeitslasten funktioniert.
Hybride Suche: Abrufen über alle vier Speicherebenen in einer einzigen Abfrage
Die Vektorsuche allein ist wie ein Bibliothekar, der nur nach dem Prinzip „was sich ähnlich anfühlt“ suchen kann, niemals nach einer exakten Signatur. Wenn Sie ihn bitten, Dokumente über Datenbankarchitektur zu finden, wird er das gut machen. Bitten Sie ihn um den Datensatz mit der Konto-ID 48291, hat er keine zuverlässige Möglichkeit, diesen zu finden. Semantische Ähnlichkeit ist nicht für exakte Übereinstimmungen ausgelegt.
Das ist die Lücke, auf die viele RAG-Pipelines (Retrieval-Augmented Generation) stoßen, wenn sie sich ausschließlich auf die Vektorsuche verlassen. Die hybride Suche schließt diese Lücke, indem sie Vektorähnlichkeit, Keyword-Matching und Metadaten-Filterung in einer einzigen Abfrage kombiniert, anstatt Ergebnisse aus separaten Systemen zusammenzufügen. Teilt man dies auf einen Vektorindex und einen relationalen Speicher auf, führt der Agent zwei Aufrufe statt eines aus. Die Systeme können asynchron werden, und jeder zusätzliche Hop verursacht Latenzzeiten, die der Zyklus eines Agenten nicht immer auffangen kann. Das Abrufen muss deutlich unter 100 Millisekunden liegen, um innerhalb eines engen Denkzyklus nutzbar zu bleiben.
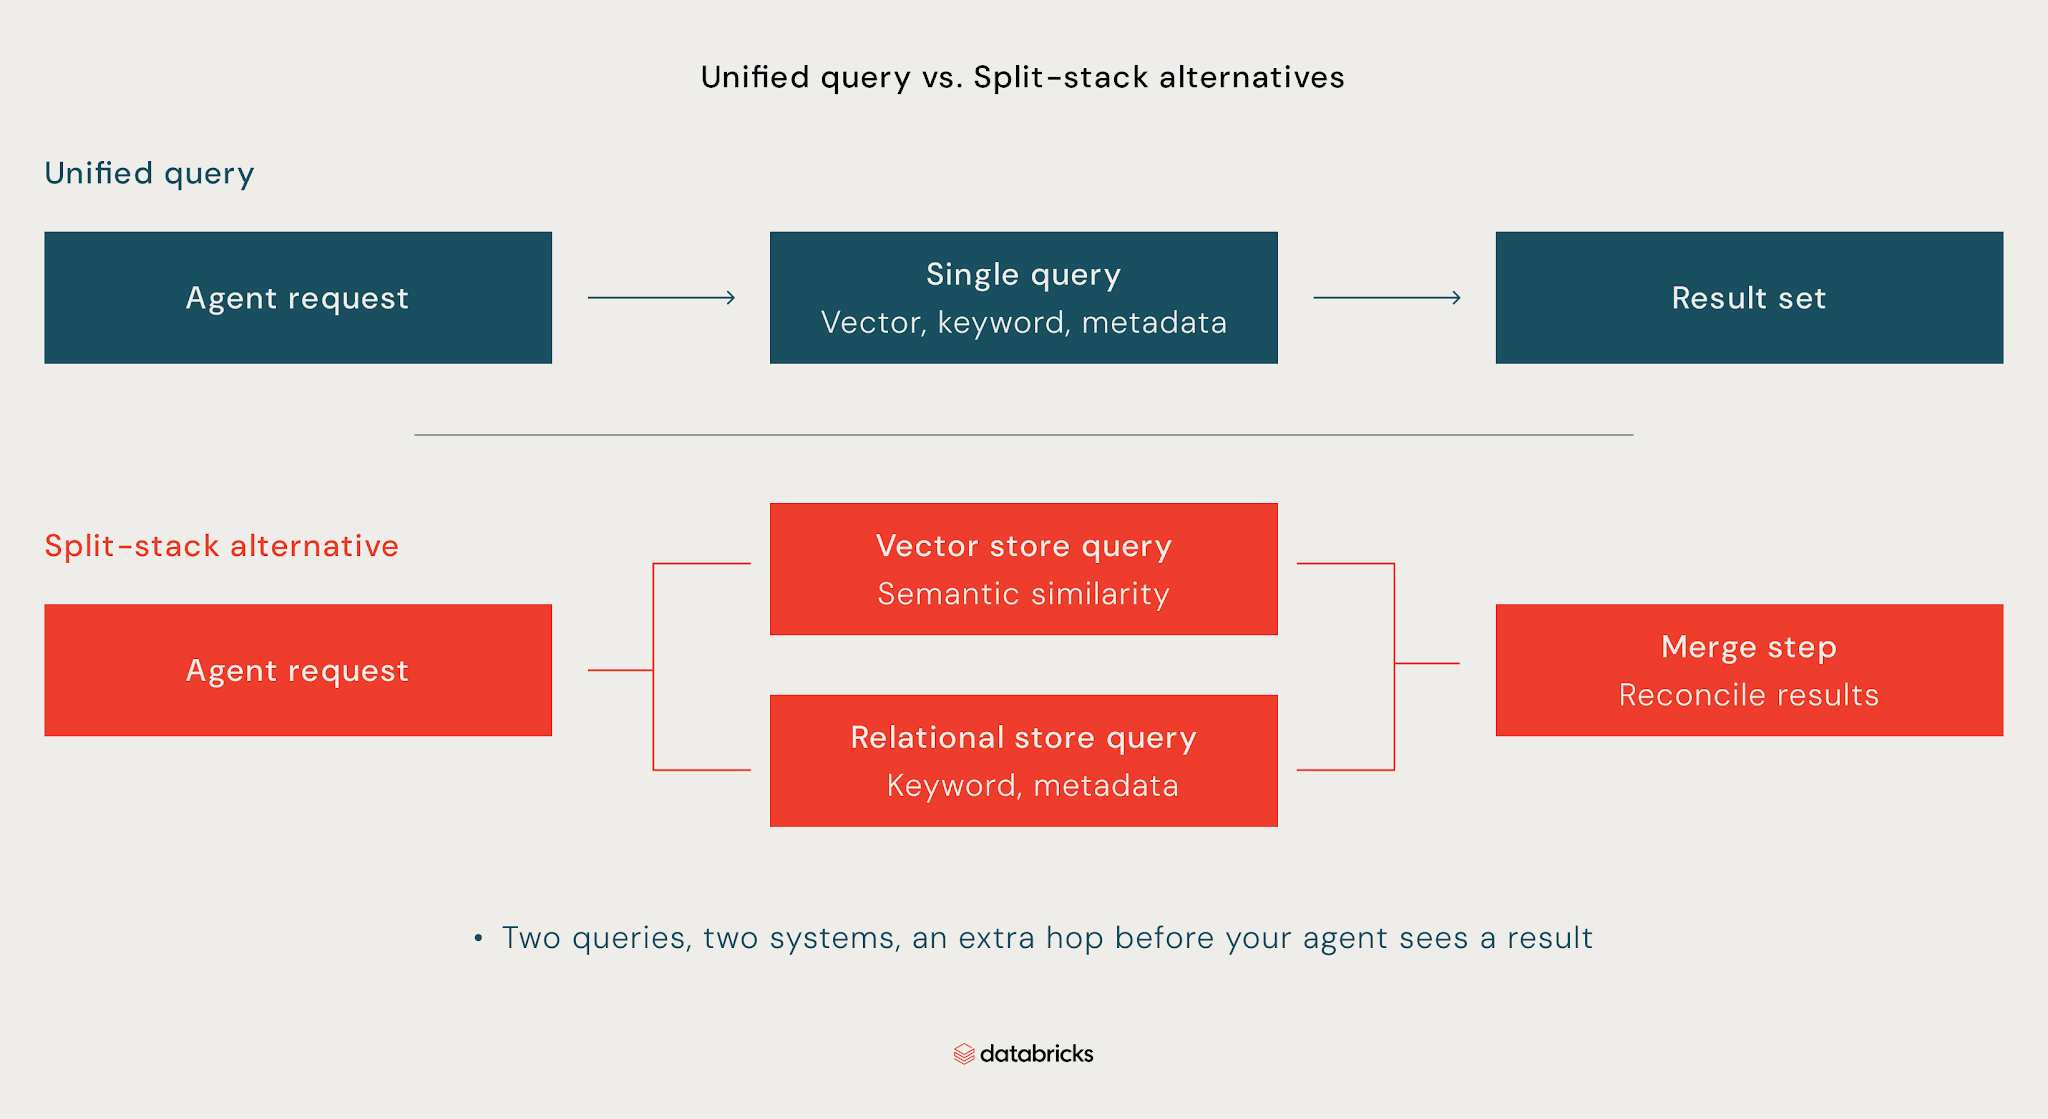
Lakebase Search führt Vektor-, Keyword- und Metadaten-Abfragen auf denselben Postgres-Tabellen aus, auf denen bereits operative Daten liegen, sodass kein zweites System asynchron werden kann. Seine LTAP-Architektur sorgt dafür, dass diese Daten aktuell bleiben, mit einer bis zu 5-mal schnelleren Schreibleistung als bei Standard-Postgres. Das bedeutet, dass das, was ein Agent gerade geschrieben hat, fast sofort für den Abruf verfügbar sein kann.
ACID-Garantien für Multi-Agenten-Systeme
Stellen Sie sich vor, zwei Support-Agenten aktualisieren gleichzeitig denselben Kundendatensatz. Einer löst ein Abrechnungsproblem und passt die Abonnementstufe an, während der andere eine Rückerstattung protokolliert. Ohne ordnungsgemäße Isolierung kann eine Aktualisierung die andere überschreiben, sodass der Datensatz in einem Zustand verbleibt, den keiner der beiden Agenten beabsichtigt hat.
Deshalb sollten transaktionale Garantien ein hartes Kriterium bei der Bewertung einer Datenbank für Multi-Agenten-Arbeitslasten sein. ACID bietet Entwicklern vier zu prüfende Eigenschaften:
- Atomarität: Eine Transaktion wird entweder vollständig oder gar nicht ausgeführt.
- Konsistenz: Die Datenbank bleibt vor und nach jeder Transaktion gültig.
- Isolierung: Gleichzeitige Transaktionen beeinträchtigen sich nicht gegenseitig auf unerwartete Weise.
- Dauerhaftigkeit: Ein erfolgreich abgeschlossener Schreibvorgang übersteht einen Absturz oder Neustart.
Bei Multi-Agenten-Systemen kommt es mehr auf die praktischen Fragen an als auf das Akronym. Kann ein Tool-Output-Commit atomar erfolgen, sodass eine halbfertige Aktion niemals als abgeschlossen behandelt wird? Was passiert, wenn zwei Agenten denselben Datensatz aktualisieren? Welche Isolationsstufen unterstützt die Datenbank? Kann ein Agent nach einem Neustart fortfahren, ohne den festgeschriebenen Zustand zu verlieren?
Beim Vergleich von Datenbanken empfehlen wir, die tatsächlich unterstützten Isolationsstufen und Commit-Semantiken zu überprüfen und sich nicht nur darauf zu verlassen, ob sie behaupten, „Transaktionen zu unterstützen“. Sobald mehrere Agenten operative Daten gemeinsam nutzen, entscheiden diese Details darüber, ob die gleichzeitige Arbeit vorhersagbar bleibt.
Einheitliche Plattform: Operative Daten im AI-Stack ohne ETL
Ein Agent, der darauf wartet, dass eine Pipeline aufholt, trifft Entscheidungen auf der Grundlage veralteter Daten. Bis diese Pipeline ausgeführt wird, hat sich der Datensatz, auf den sie einwirkt, möglicherweise bereits wieder geändert. Achten Sie bei der Bewertung einer Datenbank darauf, wie eng sie operative Daten mit den Analyse- und AI-Systemen verbindet, die von ihnen abhängen.
Eine einheitliche Plattform hält operative Schreibvorgänge und analytische Lesevorgänge auf denselben Daten, ohne dass eine separate Extract-, Transform-, Load- (ETL) Pipeline dazwischengeschaltet ist. Ihre Agenten können mit aktuellen Daten arbeiten, während Ihre Modelle Live-Ergebnisse nutzen können, anstatt auf einen Batch-Job zu warten. Datenteams behalten auch Governance und Audit-Trails auf derselben Plattform, anstatt Agenten-Workloads in ein separates System zu verschieben, das schwerer zu verfolgen ist. Unity Catalog sorgt für diese Governance-Ebene sowohl für operative als auch für analytische Daten in Databricks. Die Erfahrung von Superhuman zeigt, wie das in der Praxis aussieht: Der Ersatz benutzerdefinierter Synchronisations-Pipelines in eine Caching-Ebene und einen verwalteten NoSQL-Speicher durch eine einheitliche Plattform verkürzte den Zeitrahmen für die Datenintegration von fast drei Monaten auf etwa zwei Wochen.
easyJet hat einen ähnlichen Ansatz in seinem Revenue-Management-Stack gewählt. Seit dem Wechsel zu Lakebase erfasst die Fluggesellschaft Live-Buchungs- und Preisaktivitäten zusammen mit Analysen auf denselben Lakehouse-Daten, hat mehr als 100 Git-Repositories auf zwei konsolidiert und die App-Entwicklungszyklen von sechs bis neun Monaten auf etwa vier verkürzt.
Lakebase speichert operative Daten im Databricks Lakehouse, sodass dieselben Daten transaktionale Workloads und nachgelagerte Analysen ohne eine separate ETL-Pipeline unterstützen können.
Das Playbook für agentenbasierte KI für Unternehmen

Evaluierungs-Scorecard für KI-Agenten-Datenbanken
Unterziehen Sie jeden Kandidaten diesen einen von fünf Prüfungen, und Sie wissen innerhalb von Minuten, wo er standhält und wo nicht – unabhängig davon, welchen Anbieter Sie vergleichen.
| Kriterium | Was zu testen ist | Mindestanforderung | Warnsignale | Verhalten von Lakebase |
|---|---|---|---|---|
| Branch pro Agent | Können Sie einen isolierten Branch für echte Produktionsdaten erstellen, ohne eine vollständige Kopie anzufertigen? | Die Branch-Erstellung ist in Sekunden abgeschlossen, nicht in Minuten | Erfordert eine vollständige Datenbankkopie oder dauert länger als Ihr Testzyklus | Erstellt einen Branch einer Datenbank im Terabyte-Bereich in etwa einer Sekunde, ohne Speicherkosten, bis sie sich unterscheidet |
| Scale-to-Zero | Wird die Rechenleistung nach einer gewissen Zeit der Inaktivität pausiert und schnell genug wieder aufgenommen, um nutzbar zu bleiben? | Die Rechenleistung wird in weniger als einer Sekunde wieder aufgenommen, ohne manuellen Aktivierungsschritt | Der Kaltstart dauert mehr als 10 Sekunden, oder inaktive Datenbanken werden weiterhin zum vollen Tarif abgerechnet | Reaktiviert sich innerhalb weniger Hundert Millisekunden und verursacht im pausierten Zustand keine Kosten |
| Hybride Suche | Kann eine einzige Abfrage Vektorähnlichkeit, Keyword-Matching und einen strukturierten Filter kombinieren? | Einzelne Abfrage, unter 100 ms | Erfordert separate Aufrufe eines Vektorspeichers und eines relationalen Speichers sowie anschließendes manuelles Zusammenführen | Führt Vektor-, Keyword- und Metadatenabfragen für dieselben Postgres-Tabellen aus |
| ACID-Garantien | Können zwei Agenten gleichzeitig in denselben Datensatz schreiben, ohne dass einer der Schreibvorgänge verloren geht? | Keine verlorenen Schreibvorgänge; Isolation bleibt bei gleichzeitiger Last bestehen | Stilles Überschreiben oder eine Isolation, die sich bei Gleichzeitigkeit verschlechtert | Standard-Postgres-Transaktionsgarantien, unbeeinflusst von gleichzeitiger Agentenlast |
| Einheitliche Plattform | Wie lange dauert es, bis ein neuer Schreibvorgang für Analysen verfügbar ist? | Kein ETL-Schritt oder Verzögerung im Sekunden- statt im Stundenbereich | Erfordert eine geplante Pipeline, bevor Daten an anderer Stelle abgefragt werden können | Jeder Schreibvorgang wird im Databricks Lakehouse ohne separate Pipeline abfragbar |
Eine Datenbank, die mehr als eine dieser Mindestanforderungen nicht erfüllt, stellt ein Produktionsrisiko dar, sobald Sie Agenten in großem Maßstab betreiben, und ist nicht nur ein kleiner Kompromiss, den Sie später umgehen können.
Fazit
Die Wahl einer Datenbank für KI-Agenten hängt von der Eignung für die Workloads ab, nicht von Feature-Listen. Die fünf Kriterien in diesem Leitfaden bieten Entwicklern und Datenteams einen praktischen Rahmen für die Evaluierung jeder Datenbank, bevor sie in der Produktion eingesetzt wird. Wenn ein Kandidat diese Anforderungen heute nicht erfüllen kann, werden produktive Agenten die Lücken schließlich aufdecken, wenn sie mehr Benutzer, mehr Aufgaben und mehr gleichzeitige Arbeit übernehmen.
Wenn Sie eine Datenbank für KI-Agenten evaluieren, erkunden Sie Lakebase, um zu sehen, wie Databricks transaktionale Workloads, Branching, serverloses Skalieren, hybride Suche und einheitlichen Zugriff auf operative Daten unterstützt.
Häufig gestellte Fragen
Benötigen KI-Agenten eine Datenbank?
Ja. Die meisten Agenten-Implementierungen behalten keinen Kurzzeitkontext, keinen episodischen Verlauf, kein prozedurales Wissen oder keinen Live-Aufgabenstatus über Aufrufe hinweg bei, es sei denn, Sie speichern und laden ihn explizit neu. Ohne eine dahinterstehende Datenbank verliert Ihr Agent diesen Kontext in der Regel in dem Moment, in dem eine Sitzung endet, und kann eine Aufgabe nicht dort fortsetzen, wo er aufgehört hat.
Reicht eine Vektordatenbank für KI-Agenten aus?
Nicht allein. Eine Vektordatenbank bewältigt das semantische Abrufen gut, aber Ihr Agent muss auch den operativen Zustand schreiben und aktualisieren, die transaktionale Integrität bei gleichzeitigen Schreibvorgängen erzwingen und nach strukturierten Feldern filtern, die eine Ähnlichkeitssuche nicht zuverlässig erfassen kann. Die semantische Suche deckt nur einen Teil dessen ab, was ein Agent benötigt, nicht den gesamten Workload.
Was ist die beste Datenbank für RAG bei KI-Agenten?
Es gibt keine allgemeingültige Antwort. Für RAG bei KI-Agenten ist die beste Datenbank diejenige, die eine hybride Suche in einer einzigen Abfrage ausführen kann, das Abrufen für den Agenten-Loop schnell genug hält und aktuell genug bleibt, um veraltete Speicherinhalte zu vermeiden.
Wie verändern Multi-Agenten-Systeme die Datenbankanforderungen?
Sobald mehrere Agenten gleichzeitig in gemeinsam genutzte Daten schreiben, ist die transaktionale Integrität nicht mehr optional. Ihre Datenbank muss gleichzeitige Schreibvorgänge isolieren, damit das Update eines Agenten nicht stillschweigend das eines anderen überschreibt, und sie muss Tool-Ausgaben atomar committen, damit eine halbfertige Aktion niemals als abgeschlossen behandelt wird.
Was ist der Unterschied zwischen OLTP und OLAP für KI-Agenten?
Die Live-Aktionen Ihres Agenten, das Schreiben von Tool-Ausgaben, das Aktualisieren des Status und das Erstellen von Checkpoints für den Fortschritt sind OLTP-Workloads. Berichterstellung und Modelltraining auf Basis dieser Daten sind OLAP-Workloads. Agenten benötigen in der Regel beides, um mit denselben Daten ohne eine Pipeline dazwischen zu arbeiten. Aus diesem Grund konzentrieren sich die Kriterien in diesem Leitfaden auf Datenbanken, die sowohl transaktionsintensive Agentenarbeit als auch nachgelagerte Analysen aus denselben Daten bedienen können.
Ist Postgres gut für KI-Agenten?
Standard-Postgres bietet solide ACID-Garantien und ein ausgereiftes Ökosystem, was einen Teil dessen abdeckt, was Ihr Agent benötigt. Es bietet von sich aus kein Zero-Copy-Branching, keine Scale-to-Zero-Rechenleistung oder keinen einheitlichen operativen und analytischen Zugriff; diese hängen von der Plattform ab, die darum herum aufgebaut ist.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.