Managed Postgres: Was Lakebase Ihnen tatsächlich abnimmt
Erfahren Sie, was Lakebase bei Managed Postgres tatsächlich automatisiert – Patching, Skalierung, Failover und Backups – und wo die Verantwortung weiterhin bei Ihnen liegt.
- Managed Postgres sollte dem Datenbank-Team Routineaufgaben wie Patching, Skalierung, Failover und Backups abnehmen.
- Lakebase führt PostgreSQL auf einer serverlosen Infrastruktur mit automatischer Skalierung, Scale-to-Zero, Point-in-Time-Recovery, Branching, pgvector und PostGIS aus.
- Lakebase übernimmt die meisten Managed-Postgres-Operationen innerhalb einer Region, während die regionsübergreifende Disaster Recovery weiterhin vom Kunden verwaltete Wiederherstellungsverfahren erfordert.
Jeder Postgres-Anbieter bezeichnet sich selbst als „managed“. Nur wenige sind sich einig, was dieses Wort eigentlich bedeutet. Einige meinen damit, dass sie das Betriebssystem (OS) patchen und den Rest dem Datenbank-Team überlassen. Andere meinen, dass die Datenbank skaliert, Fehler behebt und sich selbst sichert, ohne dass jemand im Team eine Konfigurationsdatei anfassen muss.
Managed Postgres ist ein Datenbankdienst, bei dem der Anbieter die zugrunde liegende Infrastruktur betreibt und zentrale Datenbankaufgaben wie Patching, Skalierung, Failover und Backups übernimmt. So verbringt das Datenbank-Team weniger Zeit mit der Wartung und mehr Zeit mit der Entwicklung der darauf laufenden Anwendung. Je mehr dieser Aufgaben der Anbieter übernimmt, desto weniger Datenbankadministration verbleibt beim Kunden.
Dieser Unterschied wird umso wichtiger, je mehr Postgres in AI-Anwendungen zum Einsatz kommt. Die Datenbank kann nun neben traditionellen transaktionalen Workloads auch den Anwendungsstatus, den Konversationsverlauf, Embeddings und Agenten-Daten enthalten, sodass sich der operative Bereich über das bloße Am-Laufen-Halten der Datenbank hinaus erstreckt.
Lakebase Postgres bringt diesen Managed-Ansatz auf serverloses Postgres und kombiniert automatische Skalierung, PostgreSQL-Kompatibilität, Recovery und Databricks-Integrationen. Die Frage ist, wie viel operative Arbeit es tatsächlich abnimmt.
TL;DR
- Managed Postgres sollte dem Datenbank-Team routinemäßige Datenbankaufgaben wie Patching, Skalierung, Failover und Backups abnehmen.
- Lakebase führt PostgreSQL auf einer serverlosen Infrastruktur aus – mit automatischer Skalierung, Scale-to-Zero, automatischen Snapshots, Point-in-Time Recovery, Branching und Unterstützung für beliebte Erweiterungen wie pgvector und PostGIS.
- Lakebase übernimmt die meisten Managed-Postgres-Aufgaben innerhalb einer Region.
Was Managed Postgres wirklich bedeutet
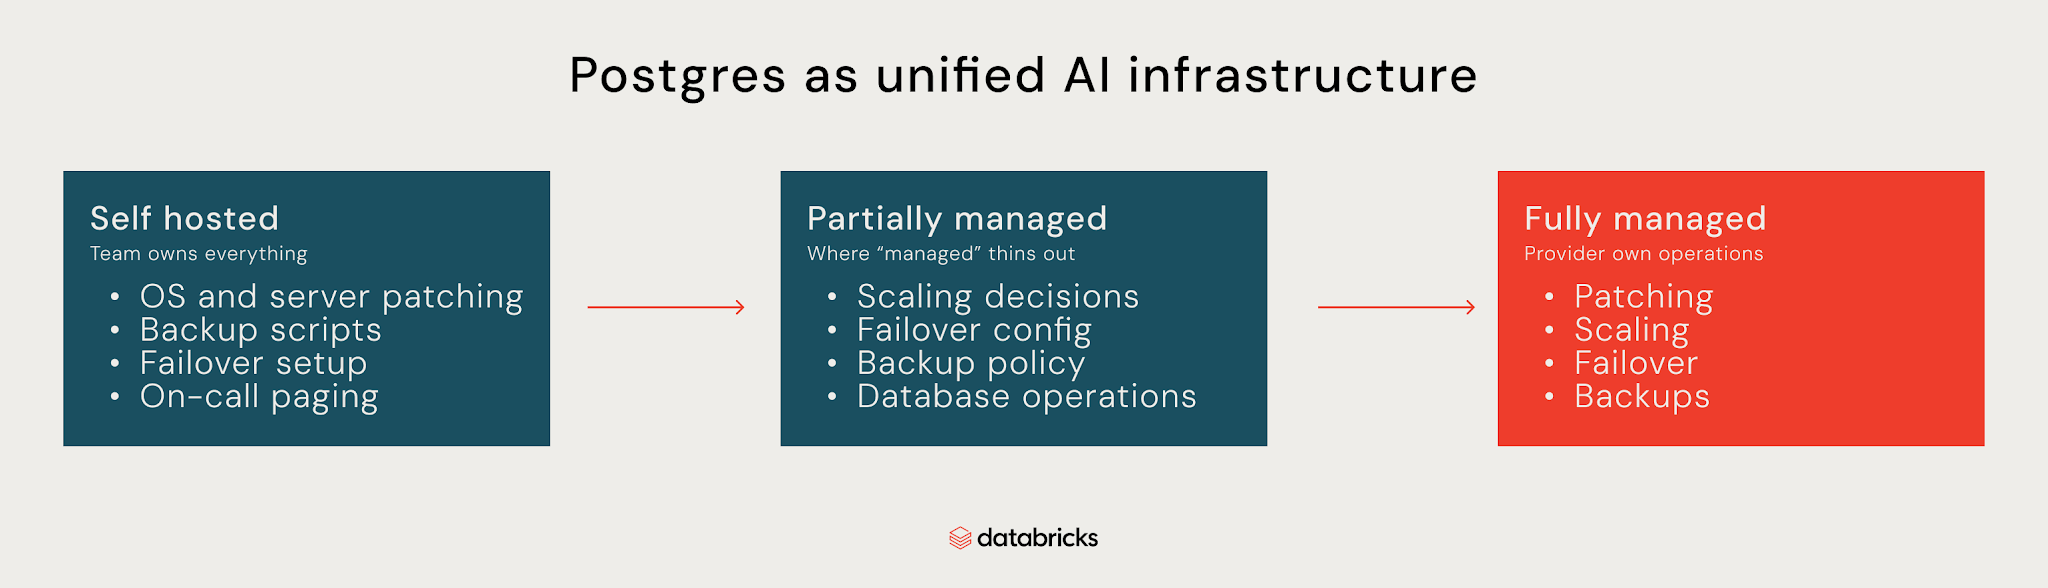
Stellen Sie sich Managed Postgres wie die Übergabe der Schlüssel zu einer Datenbank vor. Wie viel ein Team übergibt, hängt vom Anbieter ab. Am einen Ende kümmert sich das Datenbank-Team immer noch um Server, Backups, Failover und Skalierung. Am anderen Ende übernimmt ein vollständig verwalteter Dienst die operative Arbeit für das Team, nicht nur die darunter liegende Infrastruktur. Die meisten Anbieter bewegen sich irgendwo dazwischen: Sie verwalten die VM und das Netzwerk, überlassen aber einige Datenbankoperationen, Skalierungsentscheidungen, die Failover-Konfiguration und die Backup-Richtlinien dem Team.
Ein Anbieter kann das OS patchen und die Datenbank als „managed“ bezeichnen, während das Team immer noch für die Arbeit verantwortlich ist, die sie verfügbar und wiederherstellbar hält.
Patching, Skalierung, Failover und Backups sind ein guter Punkt, um diese Grenze zu ziehen. Ein Managed Service bestimmt auch, wie viel der Sicherheit, Wiederherstellung, Migration, AI-Workloads und Entwickler-Tools rund um Postgres Ihr Team noch selbst verwalten muss.
Managed Postgres ist ein Dienst, bei dem der Anbieter die Datenbankinfrastruktur betreibt und zentrale operative Aufgaben wie Patching, Skalierung, Failover und Backups übernimmt. Ein vollständig verwalteter Dienst übernimmt die Verantwortung für diese Abläufe, sodass sich Ihr Team auf die Entwicklung mit Postgres konzentrieren kann, anstatt es zu betreiben.
Was Managed Postgres leisten sollte
Der deutlichste Test dafür, wo ein Dienst auf diesem Spektrum einzuordnen ist, ist die Frage, ob er dem Team diese vier operativen Aufgaben abnimmt:
Wartung und Patching
Ein Managed-Anbieter sollte OS-Patches, Minor-Versionen von PostgreSQL und Routine-Wartungsarbeiten wie das Vacuum-Tuning aufspielen, ohne dass das Datenbank-Team dies manuell planen oder ausführen muss – ganz im Gegensatz zu selbst gehostetem Postgres, wo all dies beim Team liegt. Upgrades auf Major-Versionen müssen zwar immer noch geplant werden, da sich Erweiterungen und das Anwendungsverhalten ändern können, aber ein guter Anbieter reduziert diesen Aufwand auf ein Minimum und sorgt für einen klaren Upgrade-Pfad.
Skalierung
Die Kapazität sollte sich an den Workload anpassen, ohne dass Plattform-Engineers die Infrastruktur manuell anpassen müssen: vertikale Skalierung für mehr Rechenleistung oder Speicher, Read Replicas für Lese-Traffic und idealerweise eine serverlose Skalierung, die diese Entscheidung komplett überflüssig macht. Das Autoscaling von Lakebase ist ein Beispiel aus der Praxis, das 5-mal schnellere Postgres-Schreibvorgänge als Standard-Postgres ermöglicht. Der eigentliche Test ist eine Traffic-Spitze: Wenn das Datenbank-Team die Auslastung überwacht und auf eine Größenänderung wartet, ist Skalierung immer noch seine Aufgabe.
Hochverfügbarkeit und Failover
Die Datenbank sollte bei einem Infrastrukturausfall online bleiben, ohne dass ein Bereitschaftstechniker um 2 Uhr morgens manuell ein Replikat aktivieren muss. Einige Anbieter lösen dies mit Standby-Instanzen, die automatisch einspringen; andere, wie Lakebase, ersetzen die ausgefallene Rechenleistung direkt, da sie keinen dauerhaften lokalen Zustand speichert. Dennoch erfolgt das Failover nicht bei jedem Anbieter gleich schnell oder mit demselben Datenverlust. Einige verlieren dabei Schreibvorgänge von wenigen Sekunden, andere gar keine. Auf dieses Detail sollte man achten, bevor man dem Label vertraut – einschließlich der Frage, ob ein Failover überhaupt existiert und was mit laufenden Schreibvorgängen passiert, wenn es ausgelöst wird.
Backups und Recovery
Automatische Backups und ein Wiederherstellungsprozess, den Teams ohne Support-Ticket durchführen können, sind die Mindestanforderung. Point-in-Time Recovery (PITR) ermöglicht die Wiederherstellung zu einem bestimmten Zeitpunkt statt nur des letzten Snapshots – was wichtig ist, wenn eine fehlerhafte Migration am Nachmittag Daten beschädigt. Der Ausfall einer gesamten Region ist ein größeres Problem, gemessen an der Recovery Time Objective (RTO) (wie lange Sie offline sind) und der Recovery Point Objective (RPO) (wie viel Datenverlust Sie verkraften können). Ein Anbieter ohne definierte Werte für beides hat keinen Disaster-Recovery-Plan, sondern nur eine Vermutung.
Wie Managed Postgres Ihre Daten schützt
Eine verwaltete Datenbank sollte Daten im Ruhezustand (at rest) und bei der Übertragung (in transit) verschlüsseln, den Zugriff kontrollieren und Datenteams Einblick in die Datenbankaktivitäten geben. Das bedeutet:
- Verschlüsselung: Daten müssen im Ruhezustand und bei der Übertragung geschützt werden – auf der Festplatte und auf dem Weg zwischen Ihrer Anwendung und der Datenbank. Ein wichtiges Detail ist, wer die Schlüssel kontrolliert. Einige Anbieter verwalten die Verschlüsselung vollständig selbst, was in dem Moment zum Problem wird, in dem eine Compliance-Anforderung oder eine interne Richtlinie vorschreibt, dass das eigene Unternehmen die Schlüssel halten muss. Vom Kunden verwaltete Schlüssel (Customer-Managed Keys) geben Ihnen diese Kontrolle, während die zugrunde liegenden Datenbankoperationen beim Anbieter verbleiben.
- Zugriffskontrolle: Die rollenbasierte Zugriffskontrolle deckt die Grundlagen ab, indem sie verschiedenen Benutzern und Diensten unterschiedliche Berechtigungen zuweist. Produktionssysteme benötigen jedoch oft mehr, und Branchen, die Zahlungsdaten verarbeiten, müssen darüber hinaus Standards wie den Payment Card Industry Data Security Standard (PCI DSS) erfüllen. Die attributbasierte Zugriffskontrolle über den Unity Catalog erweitert diese Richtlinien, indem sie Eigenschaften des Benutzers, der Ressource oder der Anfrage berücksichtigt, anstatt sich nur auf Rollen zu verlassen.
- Audit-Protokollierung: Ohne Einblick darin, wer was wann getan hat, wird die Untersuchung eines Vorfalls und der Nachweis der Compliance erschwert. Die Audit-Protokollierung sollte Datenteams standardmäßig Einblick in Datenbank- und administrative Aktivitäten geben, anstatt dass sie diese als separate Pipeline auf der Datenbank konfigurieren, betreiben und warten müssen.
Was bei der Migration einer bestehenden PostgreSQL-Datenbank zu beachten ist
Eine Migration kann unkompliziert aussehen, bis die neue Datenbank eine Erweiterung, Konfiguration oder ein PostgreSQL-Feature, auf das eine Anwendung angewiesen ist, nicht unterstützt. Prüfen Sie die Abhängigkeiten der Anwendung, bevor Sie etwas verschieben. Hier sind die wichtigsten Aspekte, die bei der Migration einer bestehenden PostgreSQL-Datenbank zu beachten ist:
- Kompatibilität: Prüfen Sie, ob sich das aktuelle Setup auf der neuen Plattform genauso verhält: Unterstützung der PostgreSQL-Version, benutzerdefinierte Konfigurationen und Annahmen auf Anwendungsebene, die nach einer Änderung der Infrastruktur möglicherweise nicht mehr zutreffen. Die Kompatibilität mit dem Standard-Postgres-Wire-Protokoll bedeutet, dass bestehende Verbindungszeichenfolgen, Object-Relational Mappers (ORMs), Treiber und Tools eine echte Chance haben, ohne Codeänderungen zu funktionieren.
- Erweiterungen: Bei einer Migration stellt sich heraus, ob jede Erweiterung, auf die die Datenbank angewiesen ist, den Wechsel überstanden hat. Prüfen Sie daher die Liste der unterstützten Erweiterungen des Anbieters mit den tatsächlich verwendeten, bevor Sie sich festlegen. pgvector sollte für AI- oder Embedding-Workloads überprüft werden, PostGIS ist für Geodaten wichtig, und jede andere Erweiterung, von der eine Anwendung abhängt, sollte einzeln überprüft werden, anstatt davon auszugehen, dass eine beliebte Erweiterung vorhanden sein wird.
- Migrationsmethoden: Eine Dump-basierte Migration (Exportieren und Wiederherstellen auf der neuen Plattform) ist einfach und eignet sich für kleinere Datenbanken oder geplante Wartungsfenster. Die logische Replikation hält die Quelle aktiv, während Änderungen an das Ziel gestreamt werden. So können Teams mit einer viel kürzeren Unterbrechung umschalten, sobald beide synchronisiert sind. Die richtige Wahl hängt von der Datenbankgröße, dem Schreibvolumen und den verkraftbaren Ausfallzeiten für das Unternehmen ab.
- Validierung und Cutover: Eine Migration ist nicht schon deshalb abgeschlossen, weil die Daten verschoben wurden. Führen Sie die tatsächliche Abfrage-Workload auf der neuen Datenbank aus und vergleichen Sie die Ergebnisse und die Performance mit der Quelle. Denn übereinstimmende Zeilenzahlen reichen nicht aus – Abfragepläne, Antwortzeiten und das Anwendungsverhalten müssen ebenfalls standhalten. Planen Sie den Cutover mit einem Rollback-Pfad im Hinterkopf, damit das Team weiß, wie es den Traffic zurückleitet, falls etwas schiefgeht, anstatt dies erst während des Vorfalls herausfinden zu müssen.
Das Playbook für agentenbasierte KI für Unternehmen

Ist Postgres gut für AI-Anwendungen?
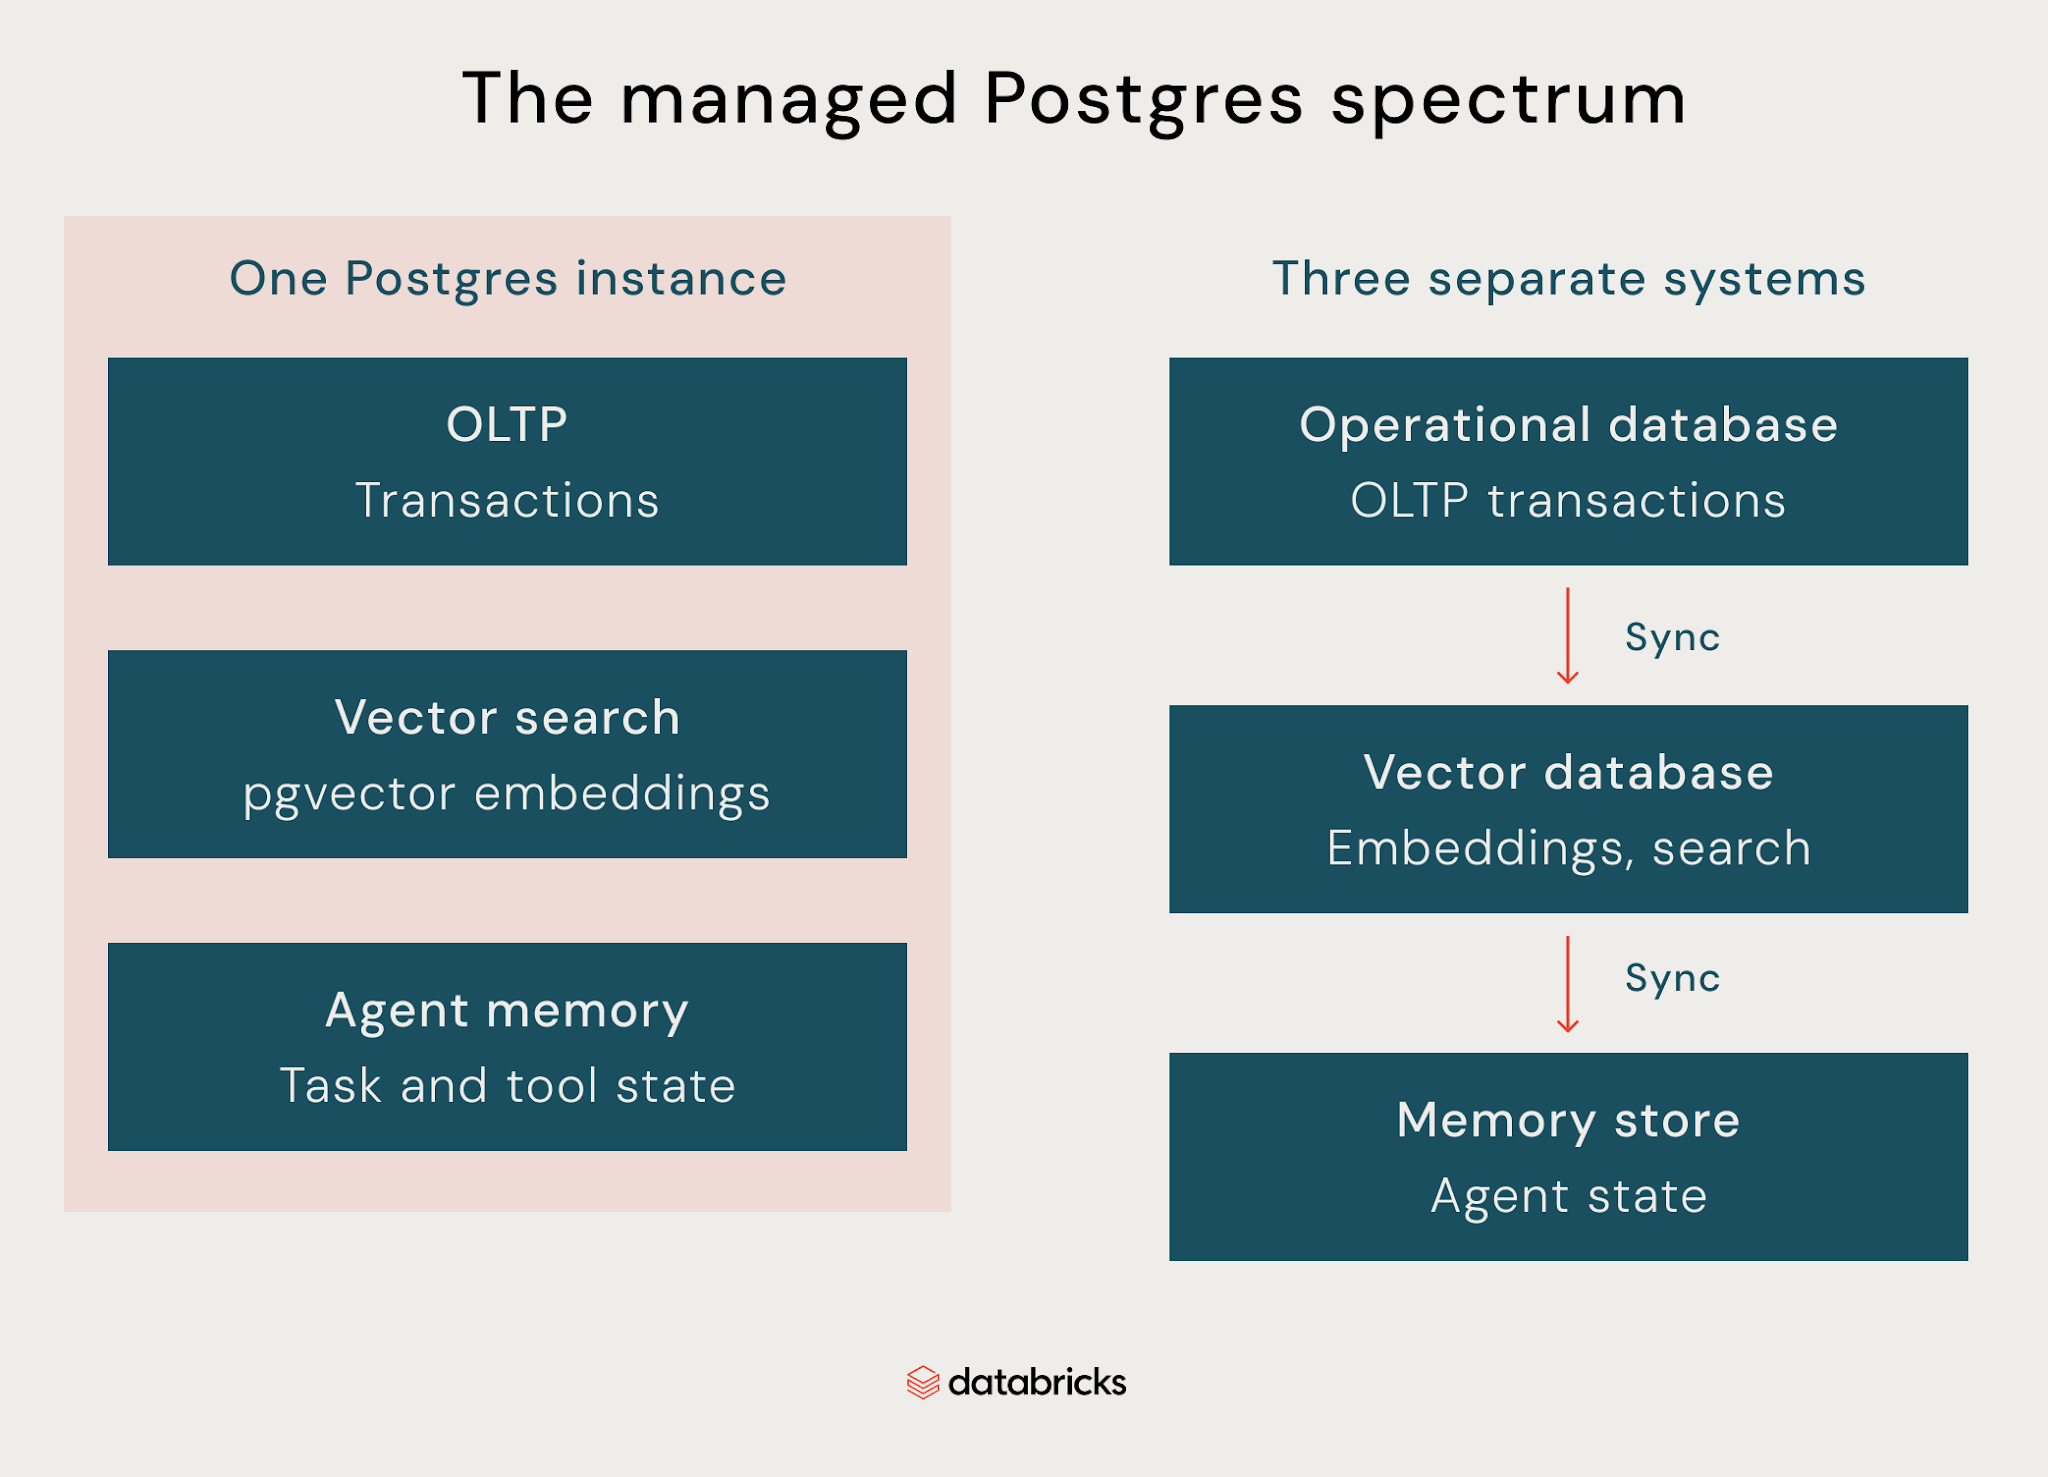
Postgres kann eine hervorragende Wahl für AI-Anwendungen sein, wenn eine Anwendung transaktionalen Zustand und Vektorsuche im selben System benötigt. Das läuft auf vier Dinge hinaus: pgvector als die Erweiterung, die dies ermöglicht, Vektorsuche für das Retrieval, LLM-Speicher (Large Language Model) zur Beibehaltung des Zustands zwischen Anfragen und Agent-Workloads, die beides gleichzeitig benötigen.
pgvector
pgvector fügt einen Vektordatentyp und einen Index für die Ähnlichkeitssuche direkt in Postgres hinzu, sodass Embeddings direkt neben den restlichen Anwendungsdaten liegen, anstatt in einem eigenen System. Der Nachteil einer separaten Vektordatenbank ist, dass die Synchronisierung von Embeddings und operativen Daten zu einer eigenen technischen Herausforderung wird – ein Problem, das pgvector für Workloads beseitigt, die keinen dedizierten Vektorspeicher benötigen.
Vektorsuche und semantische Suche
Mit pgvector können Sie Embeddings speichern und ANN-Indizes (Approximate Nearest Neighbor) verwenden, um ähnliche Vektoren bei wachsendem Datensatz effizient zu finden. Dies ermöglicht semantische Suche, Retrieval-Augmented Generation und bedeutungsbasiertes Matching direkt in Postgres. Die richtige Indexierungsstrategie hängt jedoch weiterhin von der Datensatzgröße und den Abfragemustern ab, sodass pgvector die Notwendigkeit, die Performance für Ihre spezifische Workload zu bewerten, nicht überflüssig macht.
LLM-Speicher
LLM-Anwendungen benötigen einen Ort, an dem sie den Zustand zwischen Anfragen speichern können, einschließlich des Konversationsverlaufs, der Benutzerpräferenzen, der abgerufenen Dokumente und der Tool-Ergebnisse. Postgres kann diesen Zustand als gewöhnliche relationale Daten speichern, während pgvector die Embeddings in derselben Datenbank verwaltet. Für Workloads, die ein spezialisiertes Vektor-Retrieval in sehr großem Maßstab erfordern, kann eine dedizierte Vektordatenbank weiterhin sinnvoll sein, aber viele AI-Anwendungen können den operativen Zustand und das Retrieval zusammenhalten.
Agent-Workloads
Agenten lesen und aktualisieren laufend ihren Zustand, während sie ausgeführt werden. Sie verfolgen Konversationen, speichern Zwischenergebnisse und protokollieren Tool-Aufrufe, wodurch die Datenbank Teil der Ausführungsebene des Agenten wird und nicht nur ein Ort zum Abrufen von Kontext ist. Eine für AI-Agent-Workloads entwickelte Datenbank muss sowohl diesen sich ständig ändernden transaktionalen Zustand als auch das Retrieval, das der Agent zum Finden von relevantem Kontext nutzt, in einem einzigen System unterstützen.
Postgres für die Anwendungsentwicklung
Neben dem Betrieb von Produktions-Workloads muss Postgres auch die tatsächliche Arbeitsweise Ihres Teams unterstützen. Das bedeutet, dass Verbindungen bei der Skalierung nicht zum Engpass werden und das Testen von Schemaänderungen kein Risiko für Produktionsdaten darstellt.
Verbindungsmanagement
Postgres hat ein begrenztes Limit für die Anzahl der gleichzeitigen Verbindungen, und horizontal skalierende Anwendungsinstanzen können dieses Limit erreichen, bevor Compute oder Speicher zum Engpass werden. Connection Pooling verwendet bestehende Datenbankverbindungen über Anfragen hinweg wieder, anstatt für jede Anfrage eine neue Verbindung zu öffnen. Bei einem Managed Service kommt es darauf an, ob das Pooling integriert ist oder ob Ihr Team es separat betreiben muss.
Datenbank-Branching
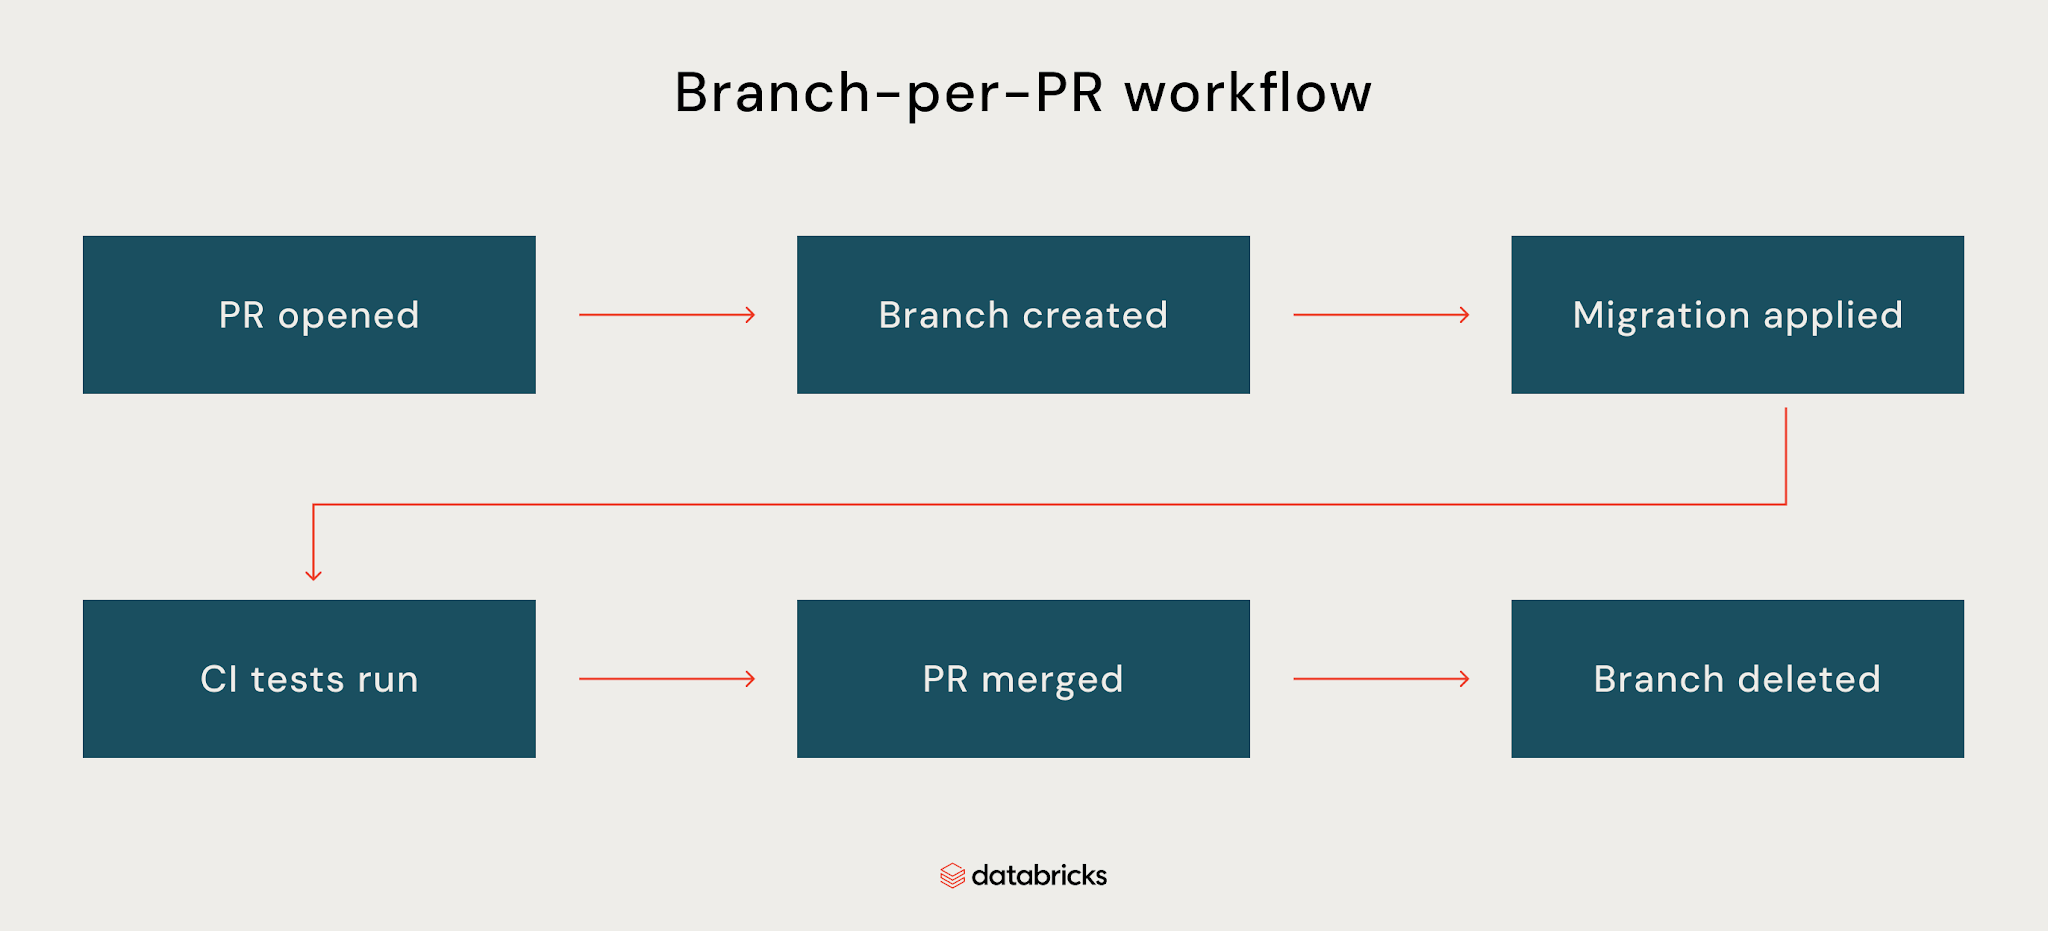
Das Testen von Schemaänderungen mit Produktionsdaten bedeutet, die Produktion zu gefährden oder eine Staging-Datenbank zu betreiben, die im Laufe der Zeit asynchron wird. Datenbank-Branching erstellt eine isolierte Umgebung aus einem bestehenden Datenbankzustand oder einem Point-in-Time-Snapshot. So können Entwickler Migrationen mit realistischen Daten testen, wie bei der evolutionären Datenbankentwicklung arbeiten und den Branch löschen, sobald er nicht mehr benötigt wird.
Warum Lakebase auf Managed Postgres
Der Ansatz von Lakebase wird deutlicher, wenn man ihn mit den Kernaufgaben vergleicht, die ein Managed Postgres bewältigen sollte:
- Serverless: Lakebase führt PostgreSQL auf Serverless-Compute aus, das sich automatisch an den Bedarf anpasst – bis hin zu Null bei Inaktivität. So müssen Sie Instanzen nicht im Voraus dimensionieren oder für ungenutzte Kapazitäten bezahlen. Databricks berichtet in seinen Tests von einem bis zu 5-mal höheren Postgres-Schreibdurchsatz mit Lakebase, wobei das Ergebnis von der Workload und Konfiguration abhängt.
- PostgreSQL-Kompatibilität: Lakebase nutzt standardmäßige PostgreSQL-Konnektivität, sodass sich vorhandene Treiber, ORMs und Tools wie psql, pgAdmin und DBeaver genauso verbinden wie mit jeder anderen Postgres-Instanz, ohne dass ein proprietäres Protokoll zwischen der Anwendung und der Datenbank steht.
- Zuverlässigkeit: Lakebase führt sekundäres Compute in separaten Availability Zones aus und stuft dieses automatisch hoch, wenn das primäre System ausfällt, wobei der Verbindungsendpunkt unverändert bleibt. Das Datenbankteam muss während des Vorfalls kein Replikat manuell hochstufen oder die Anwendung neu konfigurieren.
- Preise: Compute skaliert mit der Workload statt über eine dauerhaft bereitgestellte Instanz, und die Gebühren stoppen, sobald die Datenbank pausiert. Der Speicher wird separat abgerechnet.
- Lakehouse-Integration: Lakebase stellt eine Verbindung zum Rest der Databricks-Plattform her, anstatt als isolierter Postgres-Dienst zu agieren. Synchronisierte Tabellen machen Unity Catalog-Daten für Postgres-Anwendungen ohne benutzerdefinierte Synchronisierungspipeline verfügbar, und der Change Data Feed, der sich derzeit in der Public Preview befindet, stellt Datenbankänderungen für die nachgelagerte Verarbeitung im Lakehouse bereit.
Welche Aufgaben dem Team abgenommen werden
Die folgende Tabelle zeigt, welche Datenbankoperationen von Lakebase übernommen werden und welche weiterhin beim Datenbankteam verbleiben:
| Dimension | Was Lakebase übernimmt |
|---|---|
| Patching | Automatische PostgreSQL-, Sicherheits-, OS- und Compute-Updates |
| Skalierung | Automatische Skalierung, einschließlich Scale-to-Zero bei Inaktivität |
| Failover | Automatisches Failover auf sekundäres Compute innerhalb einer Region |
| Backups und Recovery | Point-in-Time-Wiederherstellung mit konfigurierbarem Verlauf von 2 bis 30 Tagen sowie geplanten Snapshots für zusätzlichen Backup-Schutz |
| Disaster Recovery | Private Preview, nur AWS. Periodische Replikation mit manuellem Failover und vom Kunden verwalteten Wiederherstellungsverfahren. |
| Verschlüsselung | Im Ruhezustand und bei der Übertragung, vom Kunden verwaltete Schlüssel verfügbar |
| Zugriffskontrolle | PostgreSQL-Rollen und -Berechtigungen mit Unity Catalog-Integrationen für eine umfassendere Governance. |
| Erweiterungen | pgvector, PostGIS und andere unterstützte PostgreSQL-Erweiterungen |
| Connection Pooling | Integriertes PgBouncer |
| Branching | Copy-on-Write, kein duplizierter Speicher |
| Lakehouse-Integration | Synchronisierte Tabellen und Change Data Feed |
| Preise | Serverless, skaliert mit der Workload, pausiert bei Inaktivität. Der Speicher wird separat abgerechnet. |
Patching, Skalierung, Failover und Backups laufen gemäß der obigen Tabelle alle automatisch ab. Die Ausnahme bildet Disaster Recovery: Befindet sich noch in der Private Preview, ist nur für AWS verfügbar und erfordert manuelles Failover sowie vom Kunden verwaltete Wiederherstellungsverfahren. Auf dieses Detail sollten Sie achten, bevor Sie sich bei regionenübergreifenden Szenarien auf Lakebase verlassen. Erfahren Sie mehr über Databricks Lakebase.
Fazit
„Managed“ bedeutet je nach Anbieter etwas anderes – vom bloßen Einspielen von OS-Patches bis hin zur vollständigen Verantwortung für den Betrieb einer Produktionsdatenbank: Skalierung, Failover, Backups, Sicherheit, Migration, AI-Workloads und die gesamte Developer Experience drumherum.
Lakebase erfüllt diese Anforderungen in den meisten Bereichen. Patching, Skalierung und Failover laufen ohne das Eingreifen Ihres Teams ab; Point-in-Time-Wiederherstellung ist integriert, und Sicherheit, Erweiterungen, Connection Pooling sowie Branching sind im Service enthalten. Regionenübergreifendes Disaster Recovery ist die einzige Ausnahme – es befindet sich noch in der Private Preview mit manuellem Failover und bietet nicht denselben automatischen Schutz, den Lakebase innerhalb einer Region bietet.
Für Teams, die Managed Postgres evaluieren, ist die entscheidende Frage, wie viel der operativen Arbeit ihnen tatsächlich abgenommen wird. Lakebase übernimmt den Großteil dieser Arbeit innerhalb einer Region, während das regionenübergreifende Disaster Recovery ein Bereich bleibt, in dem die Teams weiterhin selbst in der Verantwortung stehen.
Häufig gestellte Fragen (FAQ)
Was ist der Unterschied zwischen Managed und Self-Hosted Postgres?
Bei selbstgehostetem Postgres liegt jede operative Aufgabe beim Datenbankteam: Patching, Skalierung, Failover, Backup-Richtlinien, Disaster Recovery. Managed Postgres verlagert einen Teil oder die Gesamtheit dieser Aufgaben auf den Anbieter, wobei der Umfang dieser Verlagerung stark variiert. Teilweise verwaltete Services übernehmen die Infrastruktur und überlassen den Rest dem Kunden. Einige vollständig verwaltete Services umfassen auch Sicherheitstools, Migrationsunterstützung und Entwickler-Workflows wie Database Branching.
Was ist Serverless Postgres?
Serverless Postgres ist ein verwaltetes Datenbankmodell, bei dem die Rechenleistung automatisch mit der Nachfrage skaliert, sodass keine feste Instanzgröße bereitgestellt werden muss. Einige Anbieter skalieren die Rechenleistung auf Null, wenn die Datenbank inaktiv ist, während andere eine Mindestkapazität aufrechterhalten. Die Preisgestaltung richtet sich in der Regel nach der genutzten Rechenleistung und nicht nach einer dauerhaft bereitgestellten Instanz.
Wie funktioniert Database Branching in Postgres?
Database Branching erstellt einen isolierten Copy-on-Write-Branch einer Datenbank, ohne den zugrunde liegenden Speicher zu duplizieren. Jeder Branch kann seine eigenen Rechenressourcen und Datenänderungen enthalten, ohne die Produktion zu beeinträchtigen. Teams nutzen dies, um Schemamigrationen mit echten Daten zu testen, einen Branch pro Pull-Request zu erstellen oder einen Branch zu einem bestimmten Zeitpunkt wiederherzustellen und ihn nach Abschluss der Arbeit wieder zu löschen.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.