Gleichzeitige Verarbeitung von Daten von mehreren Streaming-Plattformen mit Spark Declarative Pipelines
Verwalten und nutzen Sie Daten von verschiedenen Streaming-Plattformen über mehrere Clouds hinweg ganz einfach über eine einzige ETL-Pipeline.
von Uday Satapathy, Dipankar Kushari und Akash Jaiswal
Eine der wichtigsten Aufgaben von Unternehmen heutzutage ist es, Entscheidungen in der Geschwindigkeit des Geschäftsbetriebs zu ermöglichen. Business-Teams und autonome Entscheidungssysteme benötigen oft alle Informationen, die sie brauchen, um Entscheidungen zu treffen und schnell zu reagieren, sobald ihre Quellereignisse eintreten – in Echtzeit oder nahe der Echtzeit. Solche Informationen, die im Jargon der Stream-Verarbeitung als Events bezeichnet werden, werden asynchron von einer Quelle zu einem Ziel übertragen und erfolgen im Allgemeinen über einen Message Broker oder Message Bus.
Wenn Unternehmen wachsen und Teams sich auf andere Teams ausdehnen, nehmen die Nutzungsmuster, die Anzahl und die Vielfalt der Message Broker zu. In Szenarien von Fusionen und Übernahmen erben Unternehmen oft neue Message Brokers, die dann in ihre bestehenden Data-Engineering-Prozesse integriert werden müssen. Die kohärente Verwaltung einer Vielzahl von Message Brokern, deren Producern, Consumer und Data-Engineering-Pipelines kann aufgrund der Anzahl der Technologien, Cloud-Plattformen und Programmiersprachen, in denen sie Spezialisierung erfordern, eine Herausforderung sein.
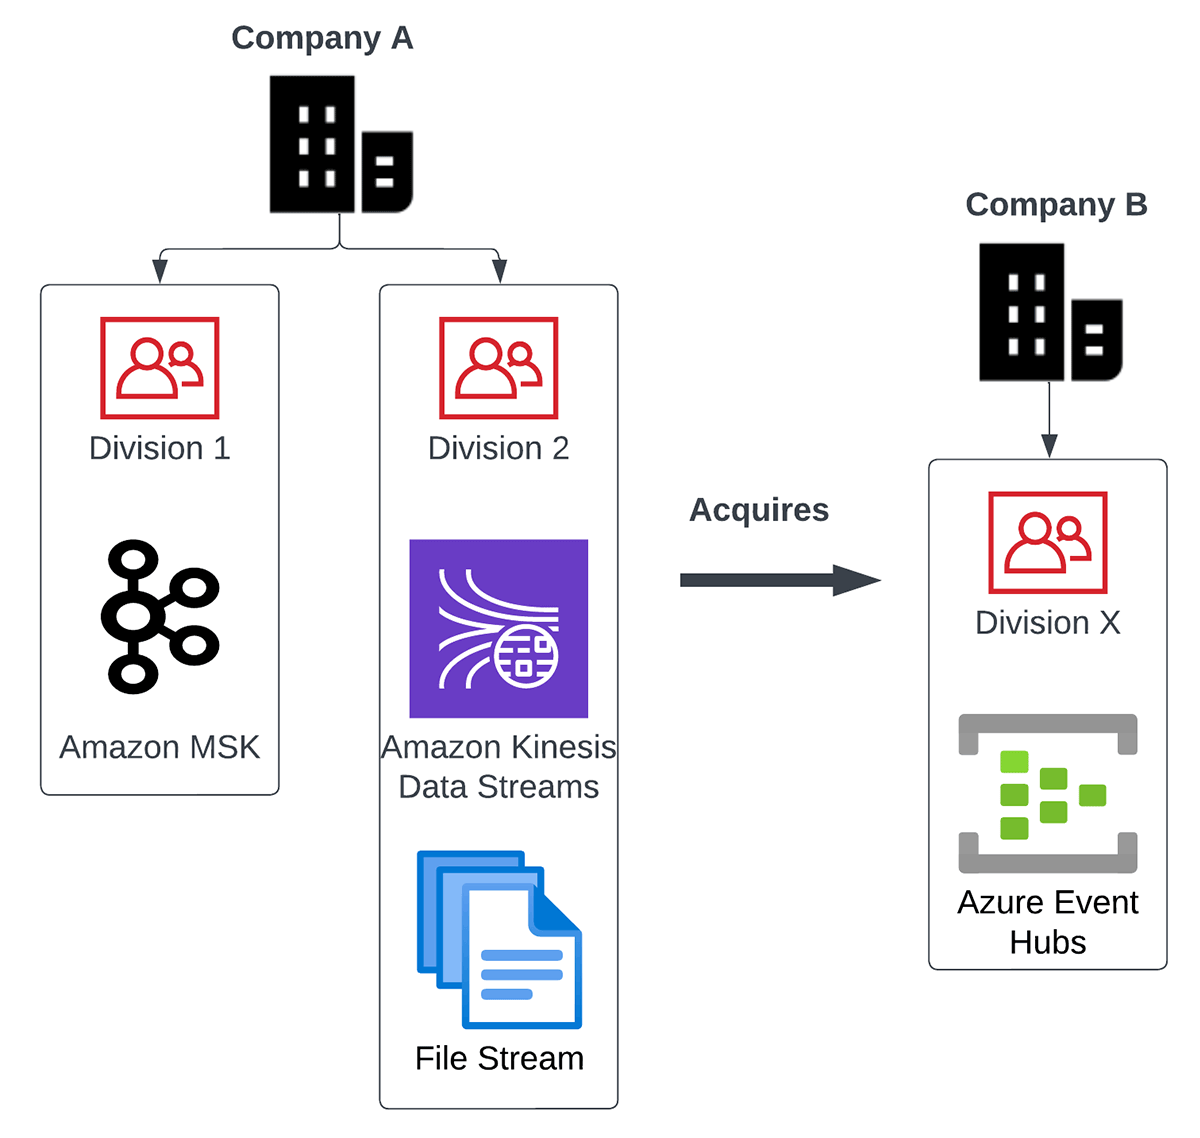
Schauen wir uns zum Beispiel einen Use Case für mehrere Streams an. Stellen Sie sich folgende Situation in einem globalen Konzern vor, in der
- Sie zwei Hauptdivisionen haben, die zwei separate Message Broker verwenden – Amazon Kinesis Data Streams und Amazon Managed Service for Kafka (MSK).
- Sie ein weiteres kleineres Produktunternehmen übernommen haben, das intern Azure Event Hubs verwendet.
- Sie zudem eine wichtige Datenquelle haben, die in Form eines kontinuierlichen Streams von CSV- oder JSON-Dateien eingeht.
Das Diagramm unten veranschaulicht den oben beschriebenen Use Case für mehrere Streams:
Hier sind einige der wichtigsten Herausforderungen bei der Verarbeitung all dieser Daten in einem solchen Szenario:
- Wie integrieren sie all diese verschiedenen Datenquellen und deren Technologien miteinander?
- Wie bauen sie Data-Engineering-Systeme so auf, dass sie einfach zu skalieren und zu warten sind? Stellen sie für jede Aufgabe die passenden Spezialisten ein, z. B. spezialisiertes Talent für jede einzelne Technologie?
- Wie stellen sie sicher, dass sie bei der Lösung dieses Technologie-Dilemmas das eigentliche Ziel nicht aus den Augen verlieren – die Daten sinnvoll zu nutzen und Entscheidungen schneller zu ermöglichen?
- Wie stellen sie sicher, dass sowohl Batch- alsFähigkeiten als auch Streaming-Anforderungen von demselben Datenverarbeitungssystem abgedeckt werden können?
In diesem Blog zeigen wir, wie diese Probleme auf einfache und saubere Weise durch Spark Declarative Pipelines (SDP) gelöst werden können. Spark Declarative Pipelines auf der Databricks Lakehouse Platform machen es einfach, hochwertige Batch- und Streaming-Datenpipelines zu erstellen und zu verwalten.
Use Case für mehrere Streams
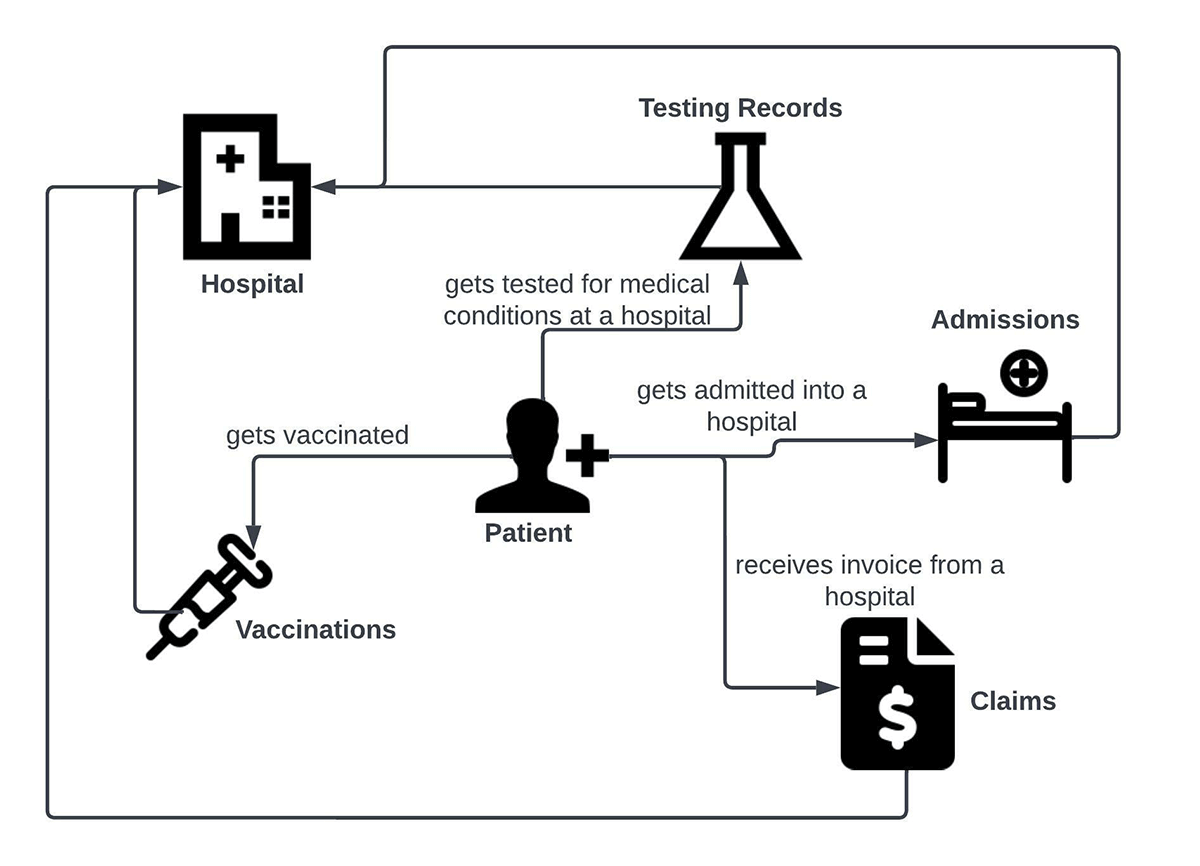
Um ein Szenario zur Verarbeitung mehrerer Streams über SDP zu veranschaulichen, stellen wir uns einen Use Case im Gesundheitswesen vor. Im Mittelpunkt des Use Case steht ein Patient. Der Patient führt die folgenden Interaktionen mit einer anderen Entität namens Krankenhaus durch:
- Wird in einem Krankenhaus gegen medizinische Beschwerden geimpft
- Wird in einem Krankenhaus auf medizinische Beschwerden getestet
- Wird wegen bestimmter medizinischer Beschwerden in ein Krankenhaus eingewiesen
- Wird für die Behandlung im Rahmen eines Claims-Prozesses in Rechnung gestellt
Diese Interaktionen können im folgenden Business-Use-Case-Diagramm dargestellt werden.
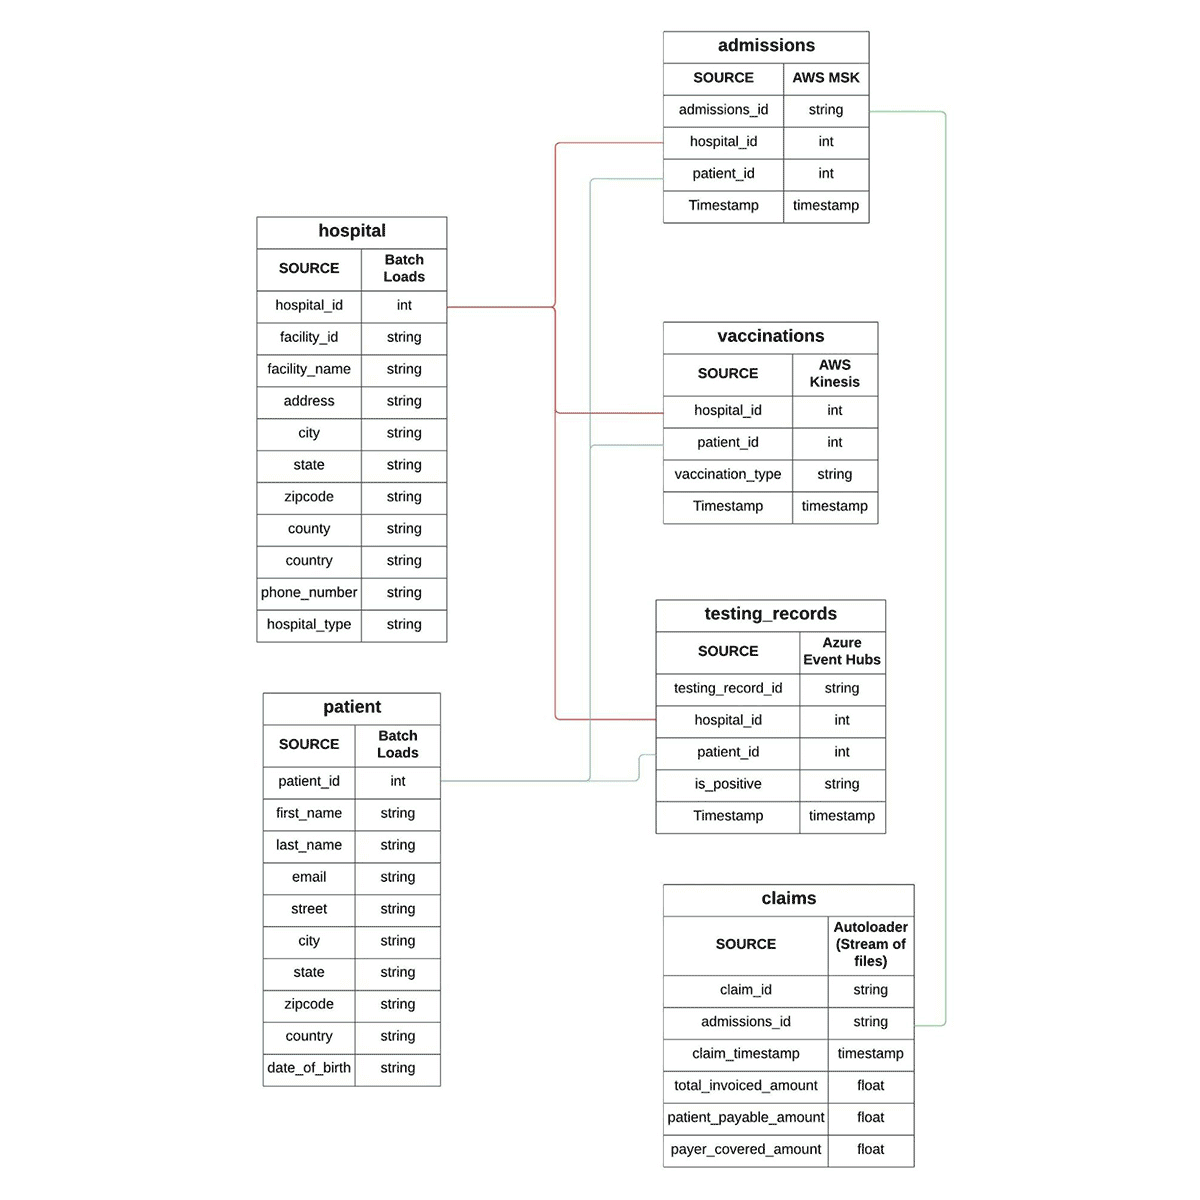
Die an diesen Interaktionen beteiligten Entitäten können in Form des folgenden ER-Diagramms (Entity Relationship) dargestellt werden. Im Folgenden werden wir reichlich Gebrauch von den Begriffen Fakten und Dimensionen aus dem Lexikon der Data-Warehousing-Dimensionsmodellierung machen. Im ER-Diagramm können Sie sehen, dass Patient und Krankenhaus Dimensions-Tabellen sind, während die Daten für Aufnahmen, Impfungen, Testergebnisse und Ansprüche in Form von Fakten-Tabellen dargestellt werden.
Nehmen wir an, dass die Fakten-Daten für Aufnahmen, Impfungen, Testergebnisse und Ansprüche über verschiedene Message Broker eingehen. Für diesen Blog haben wir die in der Branche beliebten ausgewählt, d. h. Apache Kafka (Amazon MSK), AWS Kinesis Data Streams und Azure Event Hubs. Unsere vierte Methode zur Darstellung eines Stream-Verarbeitungsszenarios besteht darin, eine Sequenz von Dateien inkrementell in Tabellen (in diesem Fall Delta Lake) zu laden. Wir haben dafür Databricks Autoloader ausgewählt. Mit diesen Informationen kann das Diagramm der Patienteninteraktionen nun mit den relevanten Datenquellen aktualisiert werden:
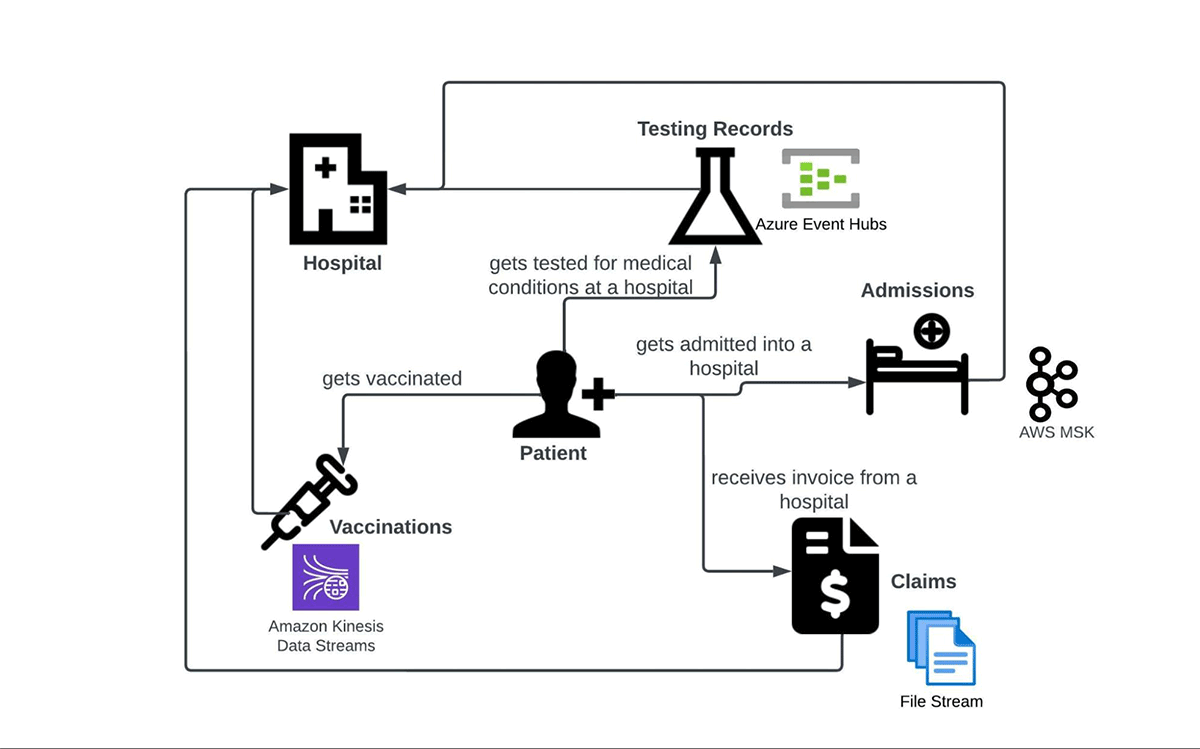
Unten sind die Datenquellen in Tabellenform zusammengefasst:
| Fakten | Datenquelle |
| Aufnahmen | Amazon MSK (Apache Kafka) |
| Testergebnisse | Azure Event Hubs |
| Impfungen | AWS Kinesis Data Streams |
| Ansprüche | Inkrementeller Stream von Dateien |
Im nächsten Abschnitt zeigen wir, wie eine einzige SDP-Pipeline Daten aus den oben genannten Streaming-Quellen gleichzeitig erfassen und darauf auch ETL ausführen kann. Wir haben AWS-Infrastruktur verwendet, um die Ressourcen und die Pipeline für diesen Blog einzurichten, aber die Szenarien sollten sich in anderen Public Clouds wie Azure und GCP ähnlich konfigurieren lassen.
Verarbeitung mehrerer Streams über SDP
Das Diagramm unten veranschaulicht, wie eine gängige SDP-Pipeline aussehen würde. Während die Erfassung und Transformation von Streaming-Daten aus unterschiedlichen Quellen den Rahmen dieses Blogs abdeckt, gibt es zusätzliche Funktionen von SDP, die ebenfalls Aufmerksamkeit verdienen. So ist beispielsweise das Datenqualitätsmanagement eine Schlüssel Funktion, die Teams dabei helfen kann, nur die Daten zu verarbeiten, die bestimmte „Erwartungen“ erfüllen. Teams können dann Korrektur- und Präventivmaßnahmen für fehlerhafte Daten ergreifen. Weitere Vorteile von SDP sind verwaltetes Checkpointing und verbessertes Autoscaling. Sie können mehr über diese und weitere Funktionen in diesem Artikel nachlesen: Konzepte von Spark Declarative Pipelines.
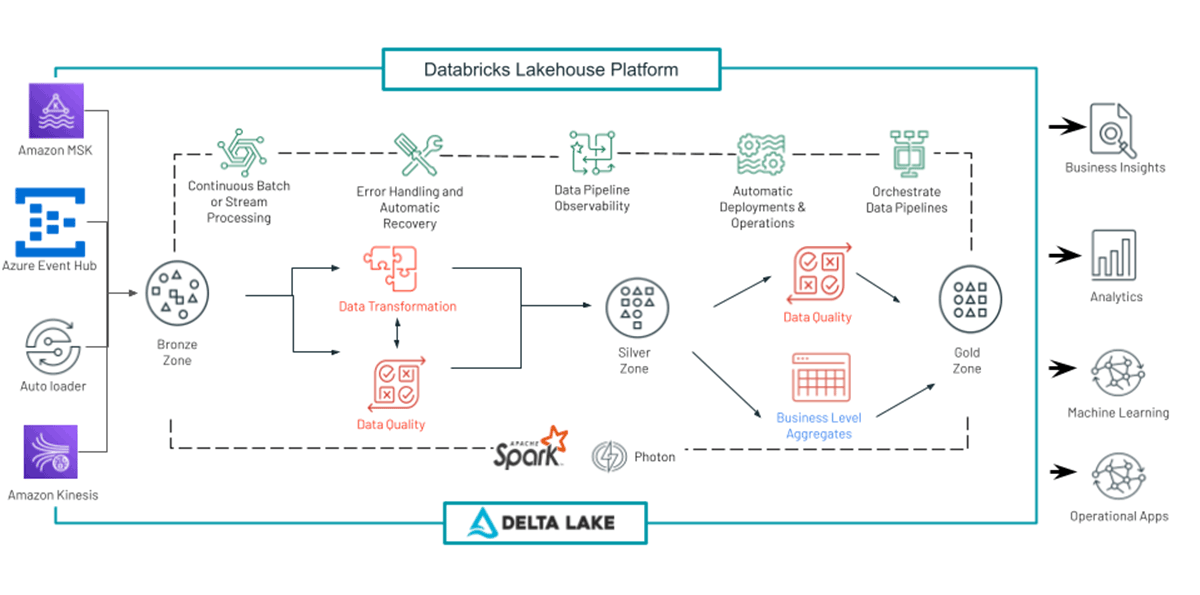
Unsere SDP-Pipeline zur Verarbeitung mehrerer Streams (der Einfachheit halber sdp_multistream_consumer genannt) umfasst die folgenden Vorgänge:
- Laden von Streaming-Daten aus den Message Brokern in eine Raw-Schicht von Delta Lake-Tabellen.
- Parsen und Anwenden von Schemas auf die Rohdaten, um aussagekräftige Fakten (Faktentabellen) aus Message-Nutzdaten zu generieren.
- Generieren aggregierter Datensätze für die Nutzung durch BI- und Analytics-Teams. Dies geschieht durch das Verknüpfen verschiedener Fakten- und Dimensionstabellen sowie das Aufteilen und Analysieren der generierten Datensätze.
Eine SDP-Pipeline kann so konfiguriert werden, dass sie in den folgenden Modi betrieben wird:
- Kontinuierlich: Ein Live-Cluster verarbeitet die Daten kontinuierlich, sobald sie eintreffen. Dies wird für Streaming-Szenarien empfohlen, bei denen die Latenz von größter Bedeutung ist.
- Ausgelöst: Ein Cluster wird nach einem gewünschten Zeitplan hochgefahren und verarbeitet die zu diesem Zeitpunkt verfügbaren Daten. Sobald keine weiteren Daten mehr zur Verarbeitung anstehen (für einen bestimmten Schwellenwert der Zeitdauer), wird der Cluster heruntergefahren. Dieser Modus wird empfohlen, wenn Kosteneinsparungen und Durchsatz Vorrang vor Latenz haben.
Für diesen Blogbeitrag verwenden wir den continuous-Modus aus zwei Gründen. Erstens möchten wir ein „echtes“ Stream-Processing-Szenario demonstrieren, bei dem die Daten in Echtzeit erfasst und verarbeitet werden. Zweitens unterstützt der Amazon Kinesis Data Streams-Connector für Apache Spark zum Zeitpunkt der Veröffentlichung dieses Blogs keinen Batch-Innahmemodus (d. h. „Trigger Once“ oder „Available Now“), wie es bei einem getriggerten Modus der Fall ist. Das wird jedoch bald verfügbar sein.
Ein weiterer wichtiger Punkt ist, dass in einer Produktionsumgebung nach der Erfassung der Rohdaten in der Regel viele Verarbeitungs- und Anreicherungsstufen durchlaufen werden. Diese Stufen bereinigen, transformieren und aggregieren die Daten für geschäftliche Anwendungsfälle wie Datenanalyse sowie historische und prädiktive Datenanalysen. Wir bezeichnen die schrittweise Verbesserung der Struktur und Qualität von Daten, während sie jede Schicht der Architektur durchlaufen, als Medallion Lakehouse Architecture. Während die Medallion-Architektur eine Best Practice für gängige Anwendungsfälle darstellt, überspringen wir zur Vereinfachung dieses Blogs den Datentransformationsteil und führen stattdessen direkt die Datenanalyse zur Unterstützung geschäftlicher Anwendungsfälle durch.
Schauen wir uns nun an, wie wir Streaming-Daten mit SDP auf einmal aus einer Vielzahl von Streaming-Systemen in Delta Lake erfassen und diese Daten analysieren können, um aussagekräftige Erkenntnisse zu gewinnen.
Erfassen von Daten aus Streams
In diesem Abschnitt zeigen wir Ihnen, wie wir Daten von mehreren Streaming-Plattformen erfassen werden.
Erfassen von Daten von Amazon MSK
Amazon Managed Streaming for Apache Kafka (Amazon MSK) ist ein vollständig verwalteter Dienst, mit dem Sie Anwendungen erstellen und ausführen können, die Apache Kafka zur Verarbeitung von Streaming-Daten verwenden. Amazon MSK stellt die Steuerungsebenenvorgänge bereit, wie etwa solche zum Erstellen, Aktualisieren und Löschen von Clustern.
Wir haben für diesen Blog einen MSK-Cluster mit den folgenden Konfigurationen verwendet:
- Cluster-Typ – Provisioniert
- Gesamtzahl der Broker – 2
- Apache Kafka-Version – 2.5.1
- Broker-Typ – kafka.m5.large
- Anzahl der Availability Zones – 2
- EBS-Speichervolumen pro Broker – 300 GiB
- Verschlüsselung zwischen Clients und Brokern:
- TLS-Verschlüsselung – Aktiviert
- Klartext – Aktiviert
Für die Authentifizierung in der AWS-Umgebung haben wir ein Instanzprofil an den SDP-Cluster angehängt. Dieses verweist auf eine IAM-Rolle mit den entsprechenden Lese- und Schreibberechtigungen, wie sie in der Rollendefinition konfiguriert sind.
Die Pipeline sdp_multistream_consumer erfasst das Krankenhausaufnahme-Dataset aus dem MSK-Topic admission in der Delta Lake-Tabelle namens msk_admissions_tbl_raw. Die Kafka-Nutzlast (als String dargestellte Binärdatei) für einen Aufnahmefakt sieht wie folgt aus:
Wir haben den folgenden Code in einem Python-Notebook für die Datenerfassung verwendet und ihn an unsere SDP-Pipeline sdp_multistream_consumer angehängt.
Wenn die Pipeline sdp_multistream_consumer gestartet wird, erstellt sie die Tabelle msk_admissions_tbl_raw in der gewünschten Datenbank bzw. dem gewünschten Schema und befüllt sie mit den aus dem admission-Topic gelesenen Daten. Anschließend liest sie kontinuierlich weitere Daten ein, sobald neue Daten in dieses Topic geschrieben werden.
Zusätzlich zu den vier aus dem Kafka-Topic erfassten Feldern haben wir der Tabelle msk_admissions_tbl_raw eine Spalte msk_event_timestamp hinzugefügt (abgeleitet von dem von Kafka generierten Ereignis-Timestamp). Die Nachrichten werden im Feld value der Kafka-Nutzlast im Binärformat empfangen. Sie müssen in Strings konvertiert werden, damit nachgeschaltete Prozesse sie analysieren können.
Erfassung von Amazon Kinesis
Amazon Kinesis Data Streams erleichtert das Sammeln, Verarbeiten und Analysieren von Echtzeit-Streaming-Daten. Bei den Daten kann es sich um Video-, Audio-, Anwendungsprotokolle, Website-Klickströme und IoT-Telemetriedaten für maschinelles Lernen, Analysen und andere Anwendungen handeln. Für unseren Blog haben wir einen Kinesis Data Stream mit den folgenden Konfigurationen verwendet:
- Daten-Stream-Name: test_vaccination_data
- Kapazitätsmodus: On-Demand
- Schreibkapazität: 200 MiB/Sekunde oder 200.000 Datensätze/Sekunde (Standardmaximum)
- Lesekapazität: 400 MiB/Sekunde (Standard)
Für einen besseren Durchsatz kann in Produktionsszenarien die Funktion Amazon Kinesis Enhanced Fan-Out (EFO) des Databricks Runtime Kinesis-Connectors verwendet werden.
Der Stream test_vaccination_data enthält in unserem Anwendungsfall die Impffakten (Ereignisse) für einen Patienten. Unten sehen Sie eine Beispiel-Nutzlast:
Der SDP-Code zum Abrufen der Daten aus dem Kinesis Data Stream in die Landing Zone im Lakehouse sieht wie folgt aus:
Die Pipeline sdp_multistream_consumer befüllt die Zieltabelle kinesis_vaccination_tbl_raw mit den im Kinesis Data Stream verfügbaren Daten und führt einen Checkpoint durch, um ein erneutes Lesen der Daten zu vermeiden. Die Nachrichten werden im Feld data der Kinesis-Nutzlast im Binärformat empfangen. Sie müssen in Strings konvertiert werden, damit nachgeschaltete Prozesse sie analysieren können.
Erfassung von Azure Event Hubs
Azure Event Hubs ist eine beliebte Streaming-Plattform von Microsoft. Event Hubs unterstützt mehrere Protokolle zum Lesen und Schreiben, wie AMQP, HTTPS und Apache Kafka. Für diesen Blog verwendet unsere SDP-Pipeline sdp_multistream_consumer die Kafka-Schnittstelle von Event Hubs, um die Nachrichten zu verarbeiten, da der Kafka-Connector für Spark standardmäßig in Databricks Runtime enthalten ist und keine zusätzlichen Bibliotheken erforderlich sind. Wir verwenden den Standard-Preistarif für unseren Event Hubs-Namespace mit 2 Throughput Units.
Die Azure-Dokumentation beschreibt Namespaces als Verwaltungskontainer für Event Hubs (oder Topics in der Kafka-Terminologie). Der für uns interessante Event Hub (bzw. das Topic) ist testing_records_stream, der Ereignisse zu den Labortestergebnissen eines Patienten enthält. Jede Nachricht sieht wie folgt aus:
Der SDP-Code zum Abrufen von Nachrichten aus dem Event Hub testing_records_stream sieht dem Ingestion-Muster von Amazon MSK sehr ähnlich (schließlich verwenden beide das Kafka-Protokoll).
Die SDP-Pipeline liest die Testdatendatensätze inkrementell aus Event Hubs ein und fügt sie als neue Zeilen in die Delta Lake-Tabelle eventhubs_testing_records_tbl_raw ein. Die Nachrichten werden im Feldwert der Kafka-Nutzlast im Binärformat empfangen. Sie müssen in Strings konvertiert werden, damit nachgeschaltete Prozesse sie analysieren können.
Dateien mit Auto Loader einlesen
Auto Loader ist eines der leistungsstärksten und robustesten Tools zum Laden von Datendateien in der Branche. Es verarbeitet neue Datendateien, sobald sie im Cloud-Speicher eintreffen, inkrementell und effizient, ohne dass zusätzliche Einrichtungsschritte erforderlich sind. Bis heute können die Dateiformate JSON, CSV, PARQUET, AVRO, ORC, TEXT und BINARYFILE eingelesen werden.
Mit Auto Loader können Benutzer eine Structured Streaming-Quelle namens cloudFiles konfigurieren. Zu den Konfigurationsoptionen gehören Cloud-Speicher-Dateipfade, DateifilterMuster, Datei-Ereignisoptionen für Warteschlangen wie Azure Queue Storage, AWS SQS, AWS SNS usw. Die SDP-Pipeline verwendet diese Optionen, um neue Dateien beim Eintreffen automatisch einzulesen, wobei optional auch bereits vorhandene Dateien in diesem Verzeichnis verarbeitet werden können. Auto Loader unterstützt sowohl Python als auch SQL in SDP-Pipelines. Kunden haben Auto Loader verwendet, um Milliarden von Dateien zu verarbeiten, um Daten zu migrieren oder eine Tabelle nachträglich zu füllen. Er skaliert so, dass das nahezu in Echtzeit erfolgende Einlesen von Millionen von Dateien pro Stunde unterstützt wird.
In diesem Blog haben wir Patientendaten mit Auto Loader und dem folgenden Beispiel eingelesen:
In der Pipeline sdp_multistream_consumer werden die JSON-Dateien für Patientenansprüche über Auto Loader eingelesen, sobald sie am Quellort eintreffen, wie im folgenden Code dargestellt:
Analysieren eingelesener Daten zur Generierung von Geschäftserkenntnissen
Wie bereits erwähnt, haben wir für diesen Blog die Datensätze von Patienten aus vier verschiedenen Quellen bereits eingelesen – Amazon MSK, Amazon Kinesis Data Streams, Azure Event Hubs und Databricks Auto Loader. Der Kürze halber haben wir den Datentransformationsteil auf die Schema-Durchsetzung beschränkt und gehen nun dazu über, Datenanalysen für diese Datensätze durchzuführen, um Anwendungsfälle im Geschäftsbereich zu unterstützen.
Wir haben für diesen Blog zwei geschäftliche Analyse-Anwendungsfälle erstellt. Die Idee dahinter ist zu zeigen, wie Benutzer die von SDP erstellten Delta Lake-Tabellen für Datenanalysen nutzen können, um geschäftliche Fragen zu beantworten.
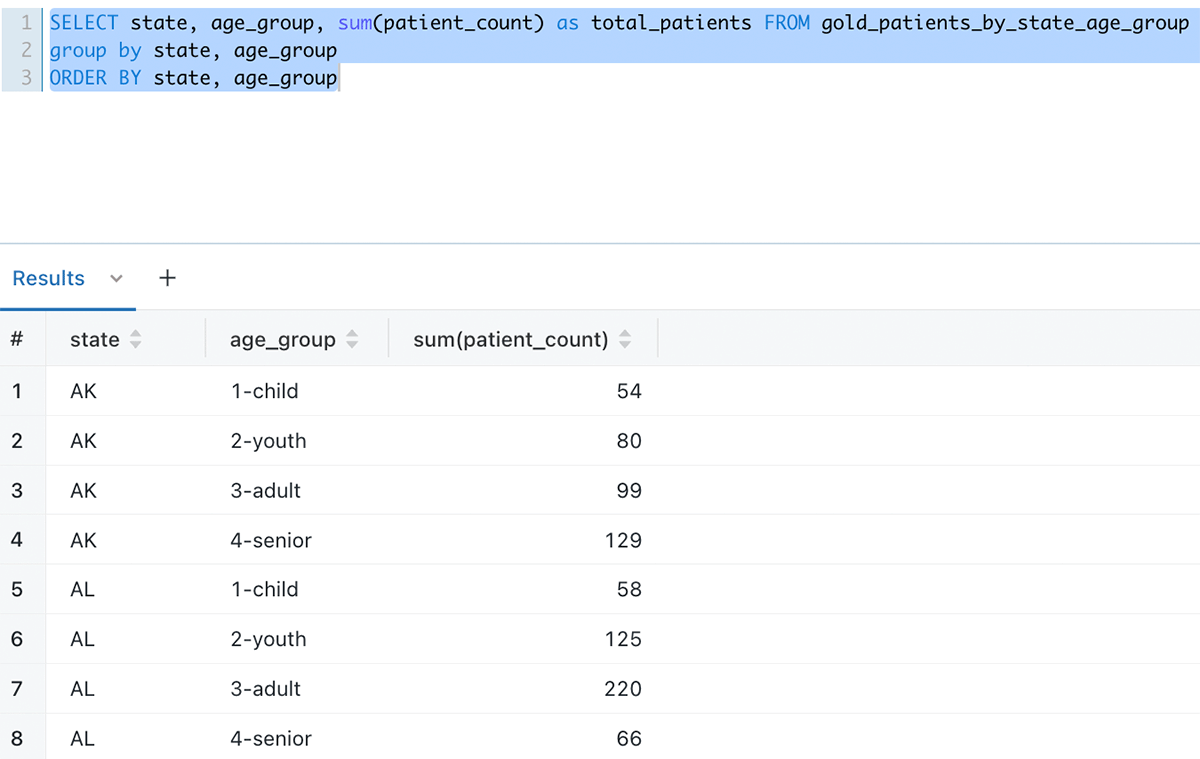
Anzahl der Patienten nach Bundesstaat und Altersgruppen, die nach einer COVID-Impfung positiv auf COVID getestet wurden
Die Tabelle gold_patients_by_state_age_group wird in SDP durch das Verknüpfen der Tabellen erstellt, die über die Dateneingabe mit SDP gefüllt wurden. Wenn neue Daten in der Ingestion-Schicht eintreffen, liest die kontinuierliche SDP-Pipeline diese Daten ein und aktualisiert diese gold_patients_by_state_age_group-Tabelle für die Datenanalyse. --
So sehen die Daten aus, wenn sie über den Databricks SQL-Abfrage-Editor abgefragt werden:
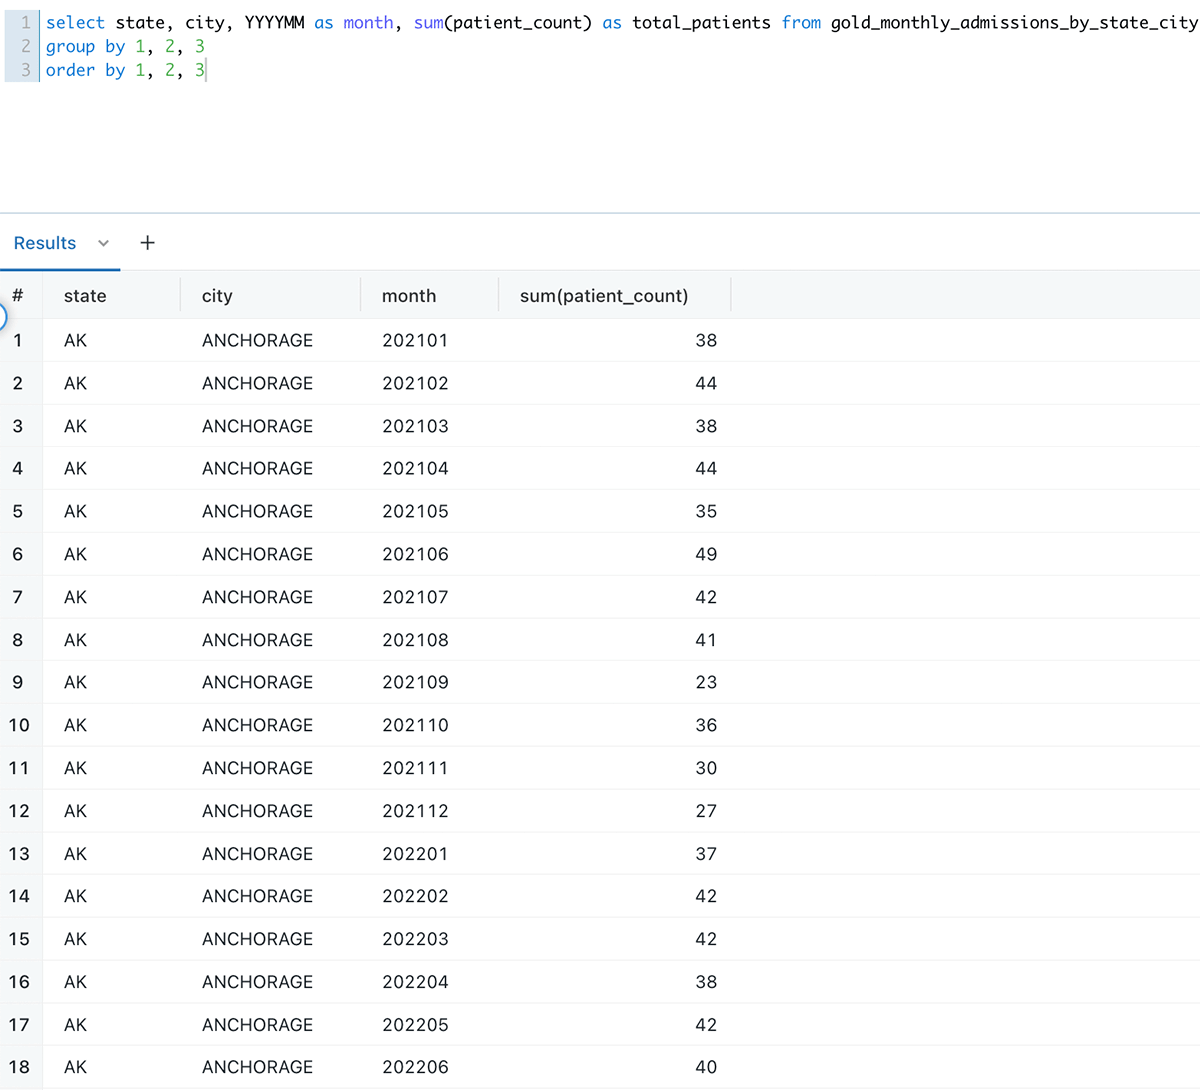
Anzahl der Aufnahmen nach Monat pro Stadt und Bundesstaat
Die Anzahl der Aufnahmen pro Stadt und Bundesstaat pro Monat ist ein weiterer Anwendungsfall, der durch das Abfragen der Tabelle gold_monthly_admissions_by_state_city unterstützt wird.
So sieht die Data aus, wenn sie über den Databricks SQL-Abfrage-Editor abgefragt wird:
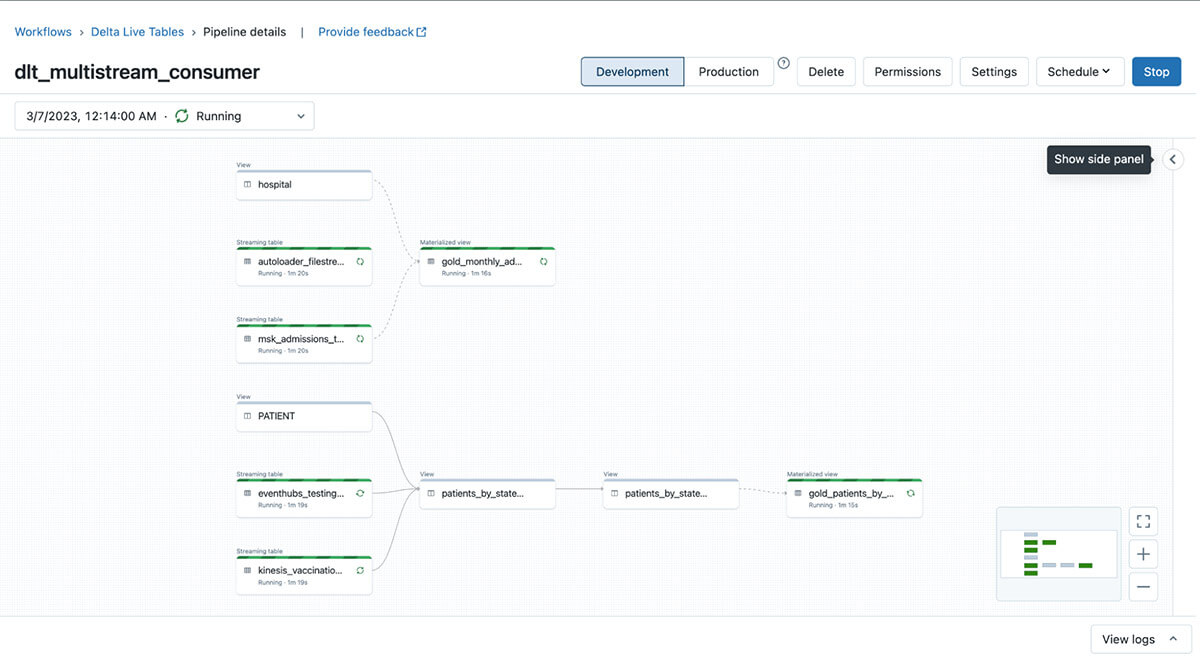
Gesamtansicht der SDP Pipeline
Eines der Hauptfeatures von SDP ist die Fähigkeit, alle tabellenbasierten Abhängigkeiten zwischen den Code-Artefakten zu durchsuchen, die Teil der Pipeline sind, und sie als Abstammungsgraph anzuzeigen. Dieser Graph ist „live“. Während die ETL-Vorgänge ablaufen, werden erfolgreiche Vorgänge in Grün und fehlerhafte in Rot angezeigt. Unten sehen Sie einen Screenshot unserer kontinuierlich laufenden SDP Data Pipeline:
Fazit
In diesem Blog haben wir gezeigt, wie Sie Data von verschiedenen Streaming-Plattformen über mehrere Clouds hinweg mit Databricks Spark Declarative Pipelines über eine einzige Data Pipeline erfassen und nutzen können. Der ETL-Prozess läuft kontinuierlich ab, sobald die Data eintrifft. Die durch Transformationen generierte Data steht sofort für die Data-Analyse zur Verfügung, um Antworten auf Ihre geschäftlichen Fragen zu erhalten. Eine solche Lösung vereinfacht die gesamte technische Architektur erheblich und macht sie einfach zu pflegen und zu skalieren. Da Databricks regelmäßig neue Features in SDP einführt, findet es bei Kunden große Beliebtheit für ETL-Workloads. Probieren Sie Spark Declarative Pipelines noch heute aus.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.