Come ottenere il massimo dall'esecuzione di dbt su Databricks
Rendi le pipeline dbt su Databricks più economiche, veloci e semplici da gestire.
- Evita di unire strumenti diversi e mantieni l'intera pipeline in un unico progetto dbt su Databricks, dall'ingestione in streaming fino alle definizioni delle metriche governate
- Orchestra dbt in modo nativo in Lakeflow Jobs senza la necessità di un orchestratore esterno.
- Definisci la governance direttamente nel progetto dbt, in modo che le regole di accesso vengano applicate da Unity Catalog subito dalle configurazioni del progetto.
Decine di migliaia di organizzazioni si affidano a dbt per la trasformazione dei dati. Il luogo in cui lo esegui incide su tutto: quanto costa eseguire le tue pipeline dbt, quanto velocemente vengono distribuite e quanto lavoro operativo comportano. L'esecuzione di dbt su Databricks offre ai tuoi carichi di lavoro dbt una piattaforma aperta e una pipeline unificata.
Oltre 3000 organizzazioni eseguono dbt su Databricks e la maggior parte dei team potrebbe ottenerne molto di più. Questo post del blog evidenzia le pratiche che rendono le pipeline dbt più economiche, veloci e semplici da gestire su Databricks.
Rendi le tue pipeline dbt più economiche e veloci
I costi di dbt aumentano a causa del lavoro inutile che viene ripetuto. La ricreazione completa ricalcola i dati che non sono cambiati, per mantenere le query veloci serve un'ottimizzazione manuale e, quando la fattura impenna, non c'è una chiara attribuzione ai modelli dbt che l'hanno causata. Adotta le pratiche di questa sezione e le tue pipeline potranno:
- Ricostruire solo i dati effettivamente modificati
- Rimanere veloci senza dover scegliere o rielaborare le chiavi di partizione
- Eseguire la manutenzione delle tabelle in modo automatico senza post-hook
- Rintracciare ogni dollaro speso fino a un modello specifico
1. Crea solo ciò che è cambiato con le strategie incrementali
La ricreazione completa delle tabelle rappresenta il più grande costo evitabile nella maggior parte dei progetti dbt. Quando solo una piccola frazione di dati cambia tra un'esecuzione e l'altra, ricalcolare l'intera tabella spreca risorse di calcolo e fa salire la fattura. Le strategie incrementali di dbt, tutte supportate su dbt-databricks, consentono a ciascun modello di elaborare solo i nuovi dati; la scelta giusta dipende da come arrivano effettivamente i dati.
Strategia | Uscala quando |
|---|---|
append | Le righe vengono solo inserite, mai aggiornate |
merge | La stessa chiave può arrivare più di una volta e richiede un'operazione di upsert (slowly changing dimensions, deduplicazione, aggiornamenti in ritardo) |
replace_where | Il modello ricalcola una finestra temporale ristretta a ogni esecuzione, ad esempio gli ultimi giorni di attività |
insert_overwrite | La query restituisce intere partizioni |
delete+insert | Vuoi che i record vengano sostituiti per chiave, senza logica di aggiornamento a livello di colonna |
microbatch | Dati di serie temporali con una colonna event_time ed esigenze di backfill strutturato |
La maggior parte dei progetti usa per impostazione predefinita merge quando basterebbe una strategia più specifica. Se puoi descrivere i dati modificati con un predicato, replace_where compie meno lavoro rispetto a un merge che deve scansionare la destinazione per trovare le corrispondenze. Se non puoi farlo, incremental_predicates su merge riduce notevolmente tale scansione.
Ogni strategia descritta sopra è una decisione che prendi e devi mantenere. La pratica successiva permette alla piattaforma di occuparsene al posto tuo.
2. Lascia che siano le viste materializzate a gestire l'incrementalizzazione
Le viste materializzate automatizzano l'incrementalizzazione. Puoi definire il modello in semplice SQL e Databricks rileva quali dati sottostanti sono cambiati e aggiorna solo i risultati interessati. Su dbt-databricks, una vista materializzata è una materializzazione nativa, quindi si tratta di una modifica di configurazione di una sola riga:
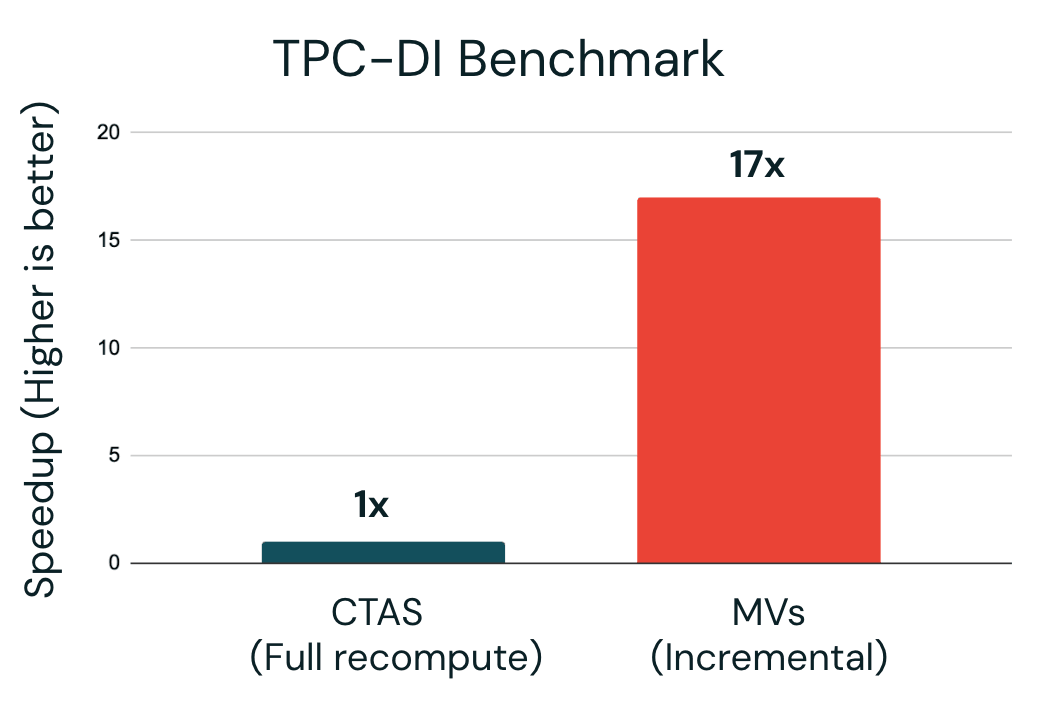
Le viste materializzate sono ideali per il serving layer: aggregazioni su origini dati che cambiano frequentemente, specialmente quelle onerose che alimentano le dashboard e devono rimanere aggiornate. Nel nostro benchmark TPC-DI, il passaggio da ricalcoli completi a viste materializzate nel serving layer ha prodotto un'accelerazione di 17 volte.
3. Automatizza il data layout per l'ottimizzazione delle prestazioni
Scegliere le chiavi di partizione, rielaborarle quando cambiano i pattern delle query e pianificare OPTIMIZE, VACUUM e ANALYZE nei post-hook richiede del tempo di ingegnerizzazione.
Predictive Optimization esegue automaticamente OPTIMIZE, VACUUM e la raccolta delle statistiche sulle tabelle gestite, scegliendo cosa eseguire e quando in base a come viene interrogata ciascuna tabella. Abilitalo una volta a livello di catalogo o schema, e potrai eliminare i post-hook che i progetti dbt solitamente accumulano per la manutenzione delle tabelle.
Per la disposizione dei dati, Liquid Clustering sostituisce la progettazione delle partizioni con un layout che si autottimizza. Organizza i dati in base a come la tabella viene effettivamente interrogata, evita l'esplosione dei file di piccole dimensioni tipica delle tabelle con troppe partizioni e si adatta all'evolversi dei pattern delle query. In alternativa, lascia che sia Databricks a sceglierli e adeguarli in base alla cronologia delle query tramite Liquid Clustering automatico (CLUSTER BY AUTO), basato su Predictive Optimization. Un'unica configurazione a livello di progetto applica il clustering a ogni nuova tabella creata nel progetto.
Entrambe le funzionalità sono concepite come decisioni da prendere una sola volta. Con gli aggiornamenti automatici, le tabelle gestite di Unity Catalog continuano ad acquisire nuove ottimizzazioni man mano che Databricks le rilascia.
4. Attribuisci ogni dollaro con i tag query
Alla fine del trimestre, il reparto amministrativo chiede perché la fattura del data warehouse è aumentata. Nella maggior parte delle configurazioni nessuno sa rispondere, perché una query nei dati di utilizzo non possiede alcun collegamento con il modello dbt che l'ha generata.
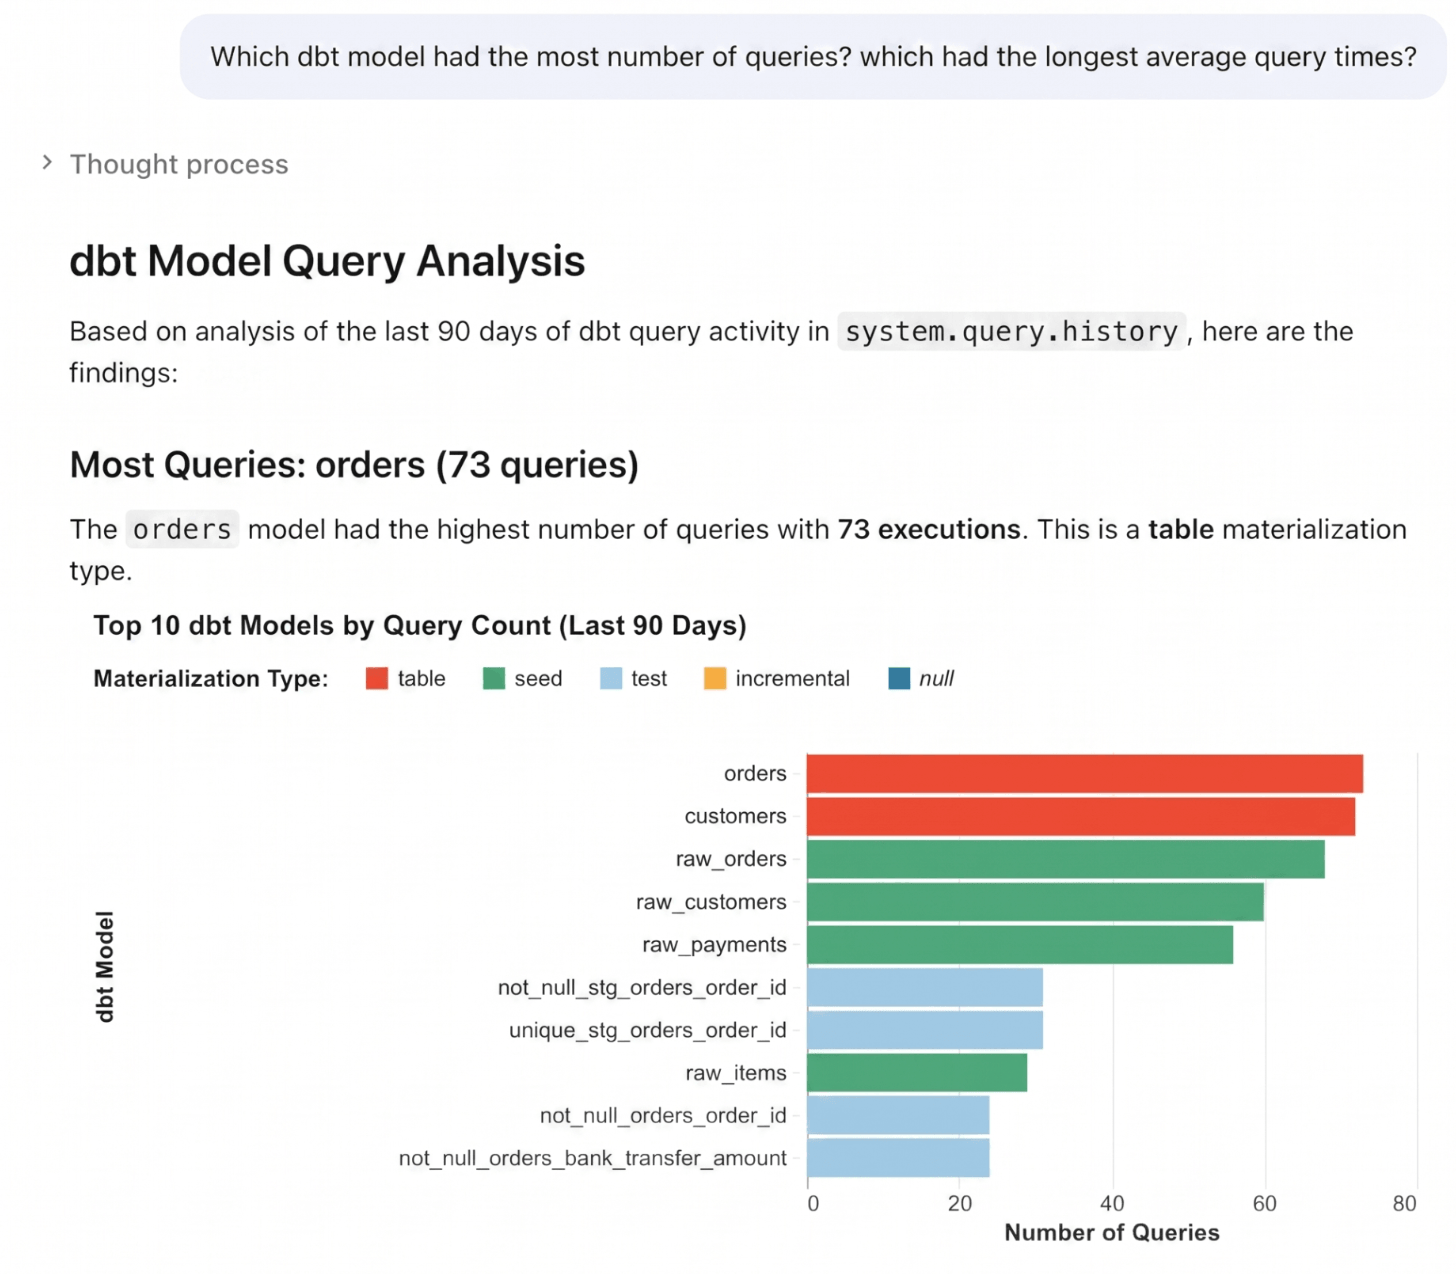
I tag query rendono questo collegamento automatico. Ogni query eseguita da dbt su Databricks viene etichettata automaticamente con il nome del modello, la versione di dbt e il tipo di materializzazione. Aggiungi i tuoi tag personalizzati per le dimensioni in base alle quali la tua organizzazione definisce il budget:
I tag compaiono in system.query.history e il join con system.billing.usage attribuisce la spesa del warehouse serverless a qualsiasi raggruppamento supportato dai tag: costo per modello, per team, per dominio, per materializzazione. Puoi vedere esattamente quali modelli costano di più.
Semplifica le tue pipeline dbt
Una configurazione dbt tipica si basa su un insieme di altri strumenti: un sistema separato per l'ingestione dei dati, un orchestratore esterno per eseguire il progetto, strumenti di BI che ridefiniscono le stesse metriche e una governance esterna al progetto dbt. Ogni elemento rappresenta uno strumento in più da gestire e una potenziale fonte di disallineamento. Adotta le pratiche di questa sezione e un singolo progetto dbt potrà:
- Ingerire i dati direttamente nel progetto
- Eseguire ed effettuare il deployment da Databricks, senza dover gestire orchestratori di terze parti
- Fornire un'unica definizione di metrica regolamentata a tutti gli strumenti
- Gestire le proprie regole di governance, sottoposte a controllo versione insieme ai modelli dbt
1. Includi l'ingestione nel progetto dbt con le Streaming Table
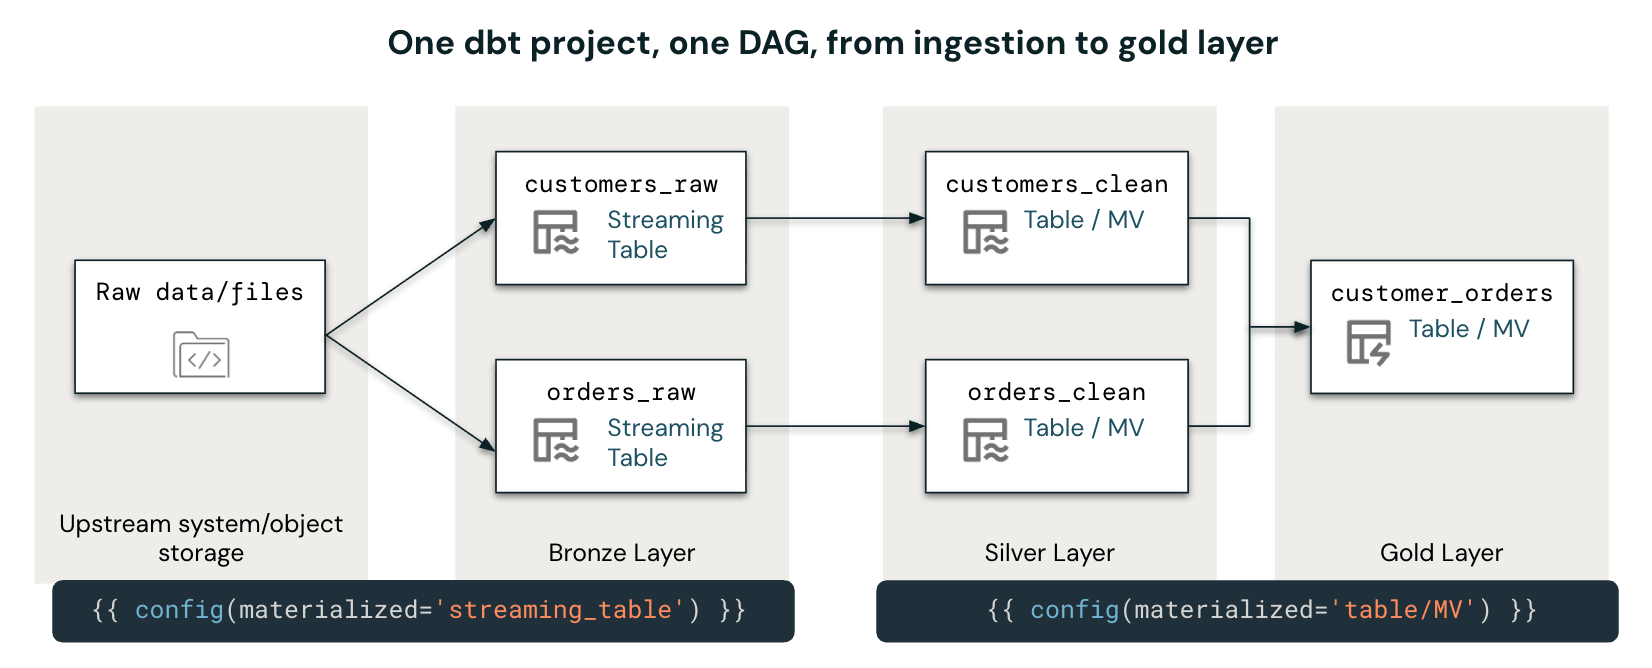
L'ingestione è la parte della pipeline che tradizionalmente risiede all'esterno di dbt, generando un'architettura frammentata senza una visione unica della lineage. La materializzazione streaming_table elimina questa frammentazione. Un modello dbt materializzato come streaming table acquisisce in modo incrementale nuovi file o eventi man mano che arrivano, trasformando l'ingestione in un semplice modello aggiuntivo all'interno del DAG.
Da lì, il resto della pipeline (modelli silver e gold) può fare riferimento alla streaming table con ref(), i test e la documentazione si applicano a ogni livello e la lineage copre l'intero percorso dai file grezzi fino al mart finale.
2. Standardizza le metriche con Unity Catalog Semantics
Ogni strumento di BI, agente o altro utente di dati crea le proprie definizioni di metriche, generando confusione e discrepanze tra gli stakeholder. Una metric view sposta la definizione in un unico luogo gestito: dichiari le misure e le dimensioni una sola volta e ogni utente interroga la stessa logica.
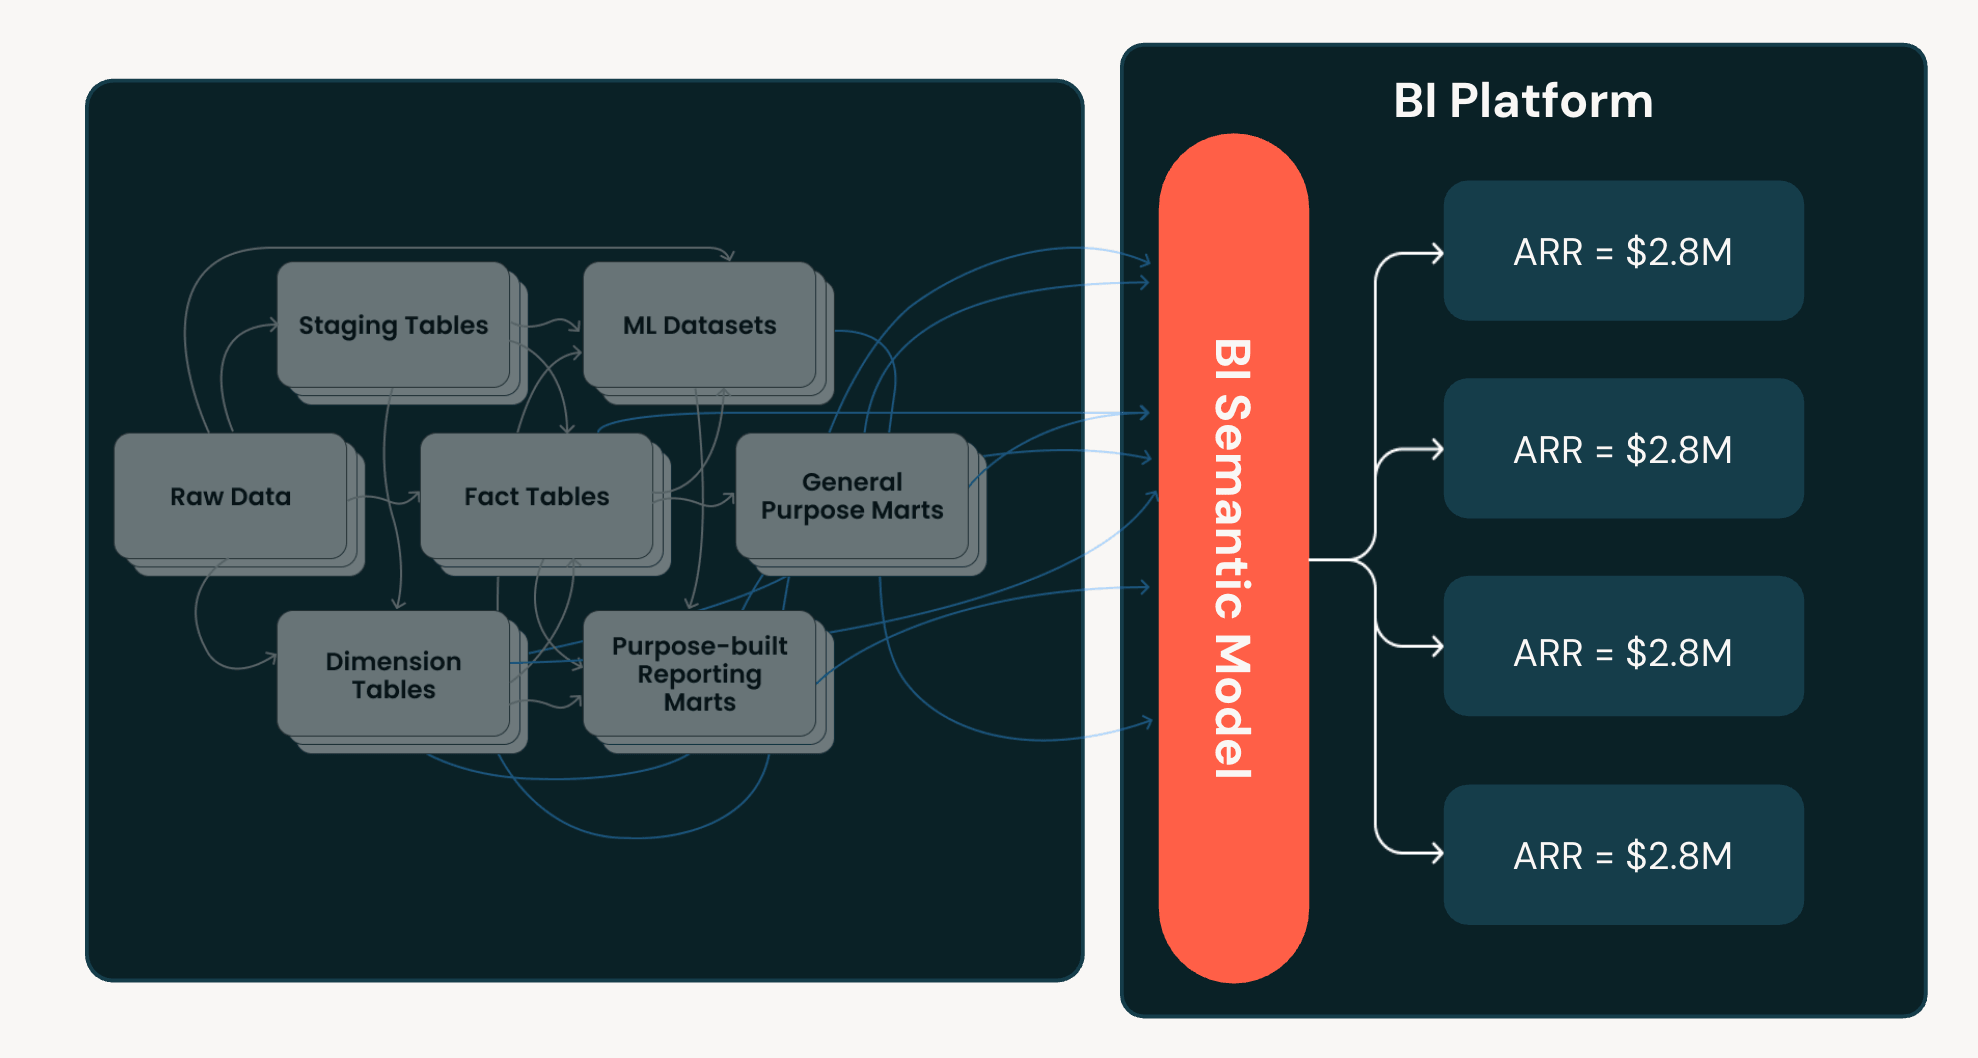
dbt-databricks espone le metric view come tipo di materializzazione nativo, così la definizione risiede direttamente nel tuo progetto dbt, sottoposta a controllo versione e revisionata come qualsiasi altro modello.
Gli utenti possono scegliere i propri raggruppamenti al momento della query tramite la funzione MEASURE(), permettendo alla stessa definizione di servire l'editor SQL, le dashboard di BI, i notebook e Genie.
3. Orchestra dbt in modo nativo tramite Lakeflow Jobs
Un'esecuzione dbt rappresenta raramente l'intera pipeline. Quando i passaggi a monte e a valle risiedono in strumenti diversi, i costi di gestione aumentano: ulteriori strumenti da gestire, pagare e proteggere, oltre a una lineage frammentata.
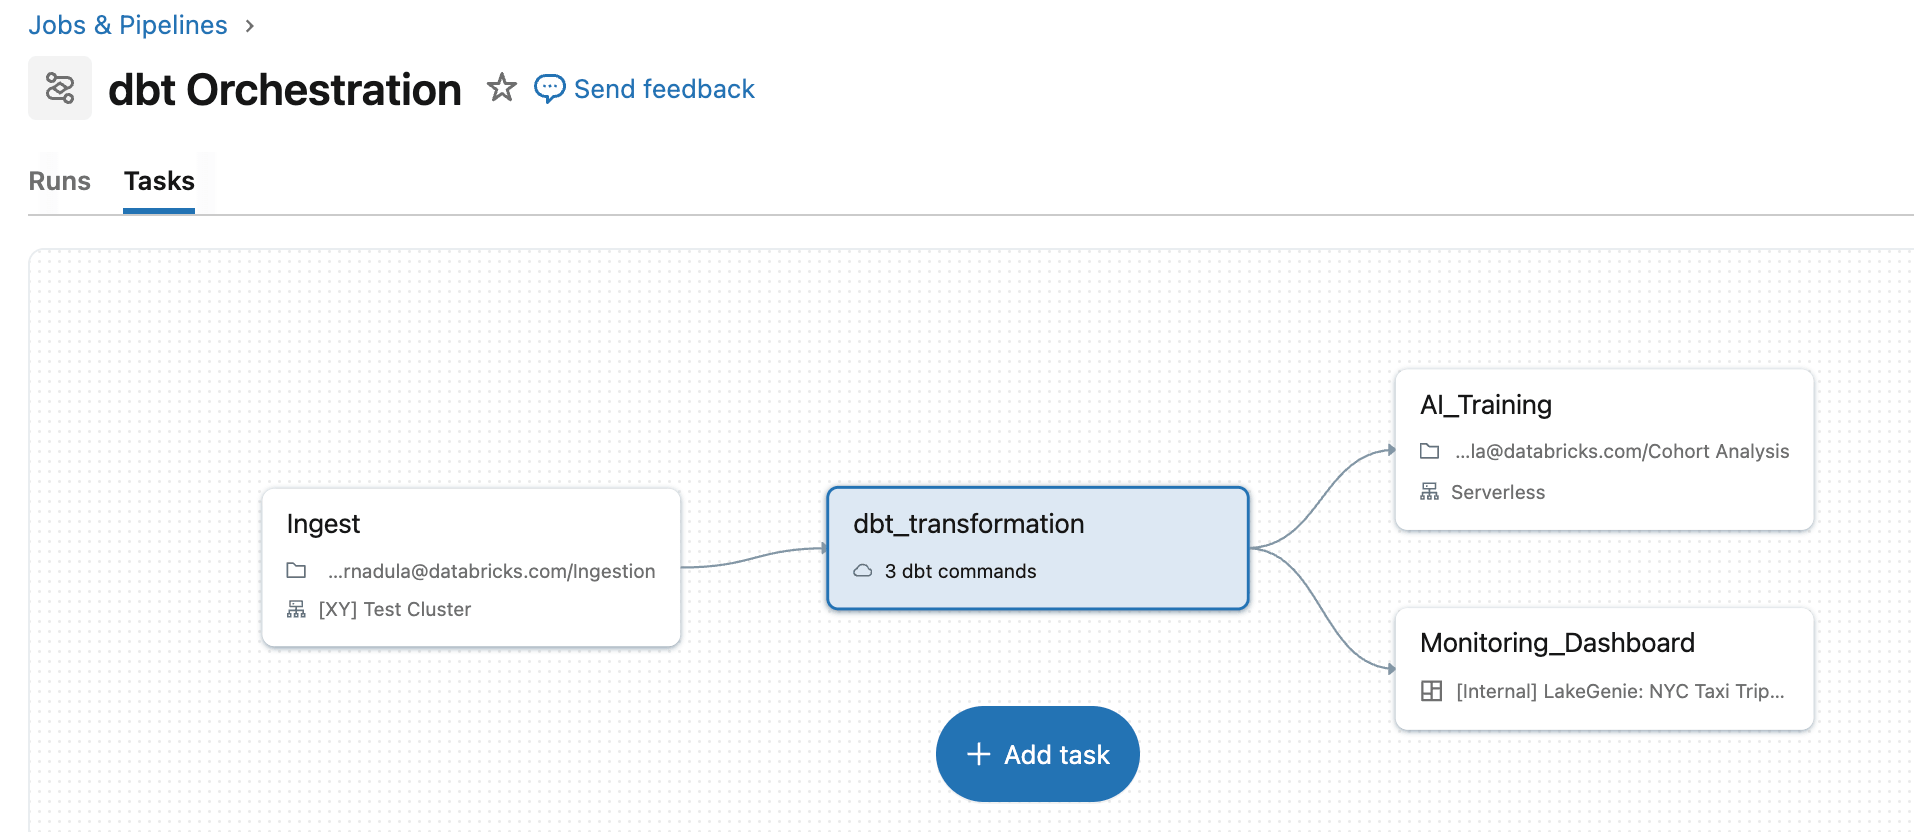
Lakeflow Jobs unifica tutto in un unico Directed Acyclic Graph (DAG) con dbt come task nativo. Un task di ingestione alimenta il task dbt e i task a valle si attivano al completamento, con le dipendenze gestite dalla piattaforma. Il livello operativo è integrato e include pianificazione, tentativi automatici, cronologia delle esecuzioni e avvisi, senza alcuna infrastruttura aggiuntiva da gestire. Jobs supporta dbt Core e dbt Platform, e il supporto per dbt Core v2.0 sarà disponibile a breve.
4. Effettua il deployment come codice con i Declarative Automation Bundle
Un job creato manualmente nell'interfaccia utente è difficile da sottoporre a controllo versione, revisionare o riprodurre. I Declarative Automation Bundle (DAB) risolvono questo problema rendendo la definizione del job parte del repository di codice. Il job Lakeflow, la sua pianificazione, le impostazioni di calcolo e il progetto dbt vengono tutti dichiarati in YAML ed eseguiti tramite deployment come un unico pacchetto.
Il deployment con --target dev crea una copia isolata dell'intera pipeline; --target prod la promuove.
Non tutti i modelli all'interno di un progetto devono essere eseguiti con la stessa frequenza. Aggiungi tag ai modelli in base alla frequenza nel file YAML di dbt e assegna a ciascuna frequenza un job dedicato che crea solo i modelli con quel tag. Spostare un modello da una frequenza giornaliera a una oraria richiede la modifica di una sola riga:
5. Definisci la governance nel progetto
La governance viene generalmente configurata dopo l'esecuzione dei modelli, separatamente dal progetto dbt che crea i dati. Poiché la governance risiede all'esterno del progetto dbt, rischia di non essere sincronizzata con le esecuzioni di dbt.
Definisci la governance direttamente nel progetto dbt in cui si trovano i modelli. Trattandosi di una configurazione di progetto, viene distribuita con il codice, revisionata come il codice e applicata da Unity Catalog a ogni query.
Tag, autorizzazioni (grant) e protezioni a livello di riga e colonna possono essere tutti definiti nella configurazione dell'intero progetto in dbt_project.yml. databricks_tags gestisce la classificazione e i criteri, grants controlla chi può leggere la tabella, mentre row_filters e column_masks controllano ciò che ciascun utente visualizza:
Su larga scala, il controllo dell'accesso basato su attributi (ABAC) elimina le ripetizioni. Definisci un'unica policy su un tag governato e questa applicherà i giusti filtri di riga e maschere di colonna a ogni tabella che presenta quel tag, in modo che un nuovo modello con il tag pii sia coperto dal momento in cui viene generato. Ricorri a filtri e maschere per singolo modello solo quando la logica è davvero specifica per il modello, come nel caso dell'isolamento multi-tenant.
Il filo conduttore di queste pratiche consiste nell'affidare il lavoro operativo alla piattaforma: elaborazione incrementale, layout dei dati, manutenzione delle tabelle, applicazione della governance e orchestrazione. Ciò che rimane nel tuo progetto dbt è la tua logica di trasformazione testata e sottoposta a controllo di versione. Scegli la pratica che risolve i problemi attuali del tuo progetto e comincia da lì.
Unisciti alle oltre 3000 organizzazioni che eseguono già dbt su Databricks. Inizia subito con l' adattatore dbt-databricks.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.