MemCurrent: progettazione della memoria persistente per gli agenti in produzione
Gli strumenti di IA hanno reso facile fare "vibe coding" con gli agenti. Tuttavia, la creazione e la manutenzione di un agente aziendale in produzione restano sfide notevolmente più complesse. In particolare, gli sviluppatori sono spesso costretti a scendere a compromessi tra qualità (ottenere buone risposte, specialmente su attività long-tail) ed efficienza (tenere sotto controllo costi e latenza su scala). Spesso le tecniche portano vantaggi in una dimensione a scapito di un'altra.
La memoria è un modo promettente per migliorare entrambi gli aspetti contemporaneamente. Può aiutare gli agenti a portare un contesto utile tra le varie attività, come le preferenze dell'utente, le correzioni precedenti, le definizioni delle metriche e i workflow di successo. In linea di principio, questo può migliorare l'accuratezza, ridurre gli errori ripetuti ed evitare inutili riscoperte. Ma una cronologia più ampia non significa necessariamente una memoria migliore. Fornire ogni singola interazione passata è costoso e può introdurre un contesto obsoleto, contrastante o irrilevante. La sfida principale consiste nel decidere cosa conservare, come mantenerlo e come misurarne l'utilità.
In questo post presentiamo MemCurrent, un'architettura di memoria persistente per agenti in produzione, che ora alimenta i nuovi Agent Bricks Memory e Genie. Gli agenti leggono e scrivono nella memoria mentre lavorano, e una pipeline di "dreaming" offline consolida la memoria per mantenerla coerente e aggiornata. Nel nostro benchmark interno, basato su attività aziendali realistiche, MemCurrent triplica il pass rate dell'agente rispetto all'assenza di memoria, utilizzando il 31% in meno di token ed eseguendo le operazioni il 26% più velocemente. Il resto di questo post descrive come lo abbiamo progettato e valutato, e cosa abbiamo imparato lungo il percorso.
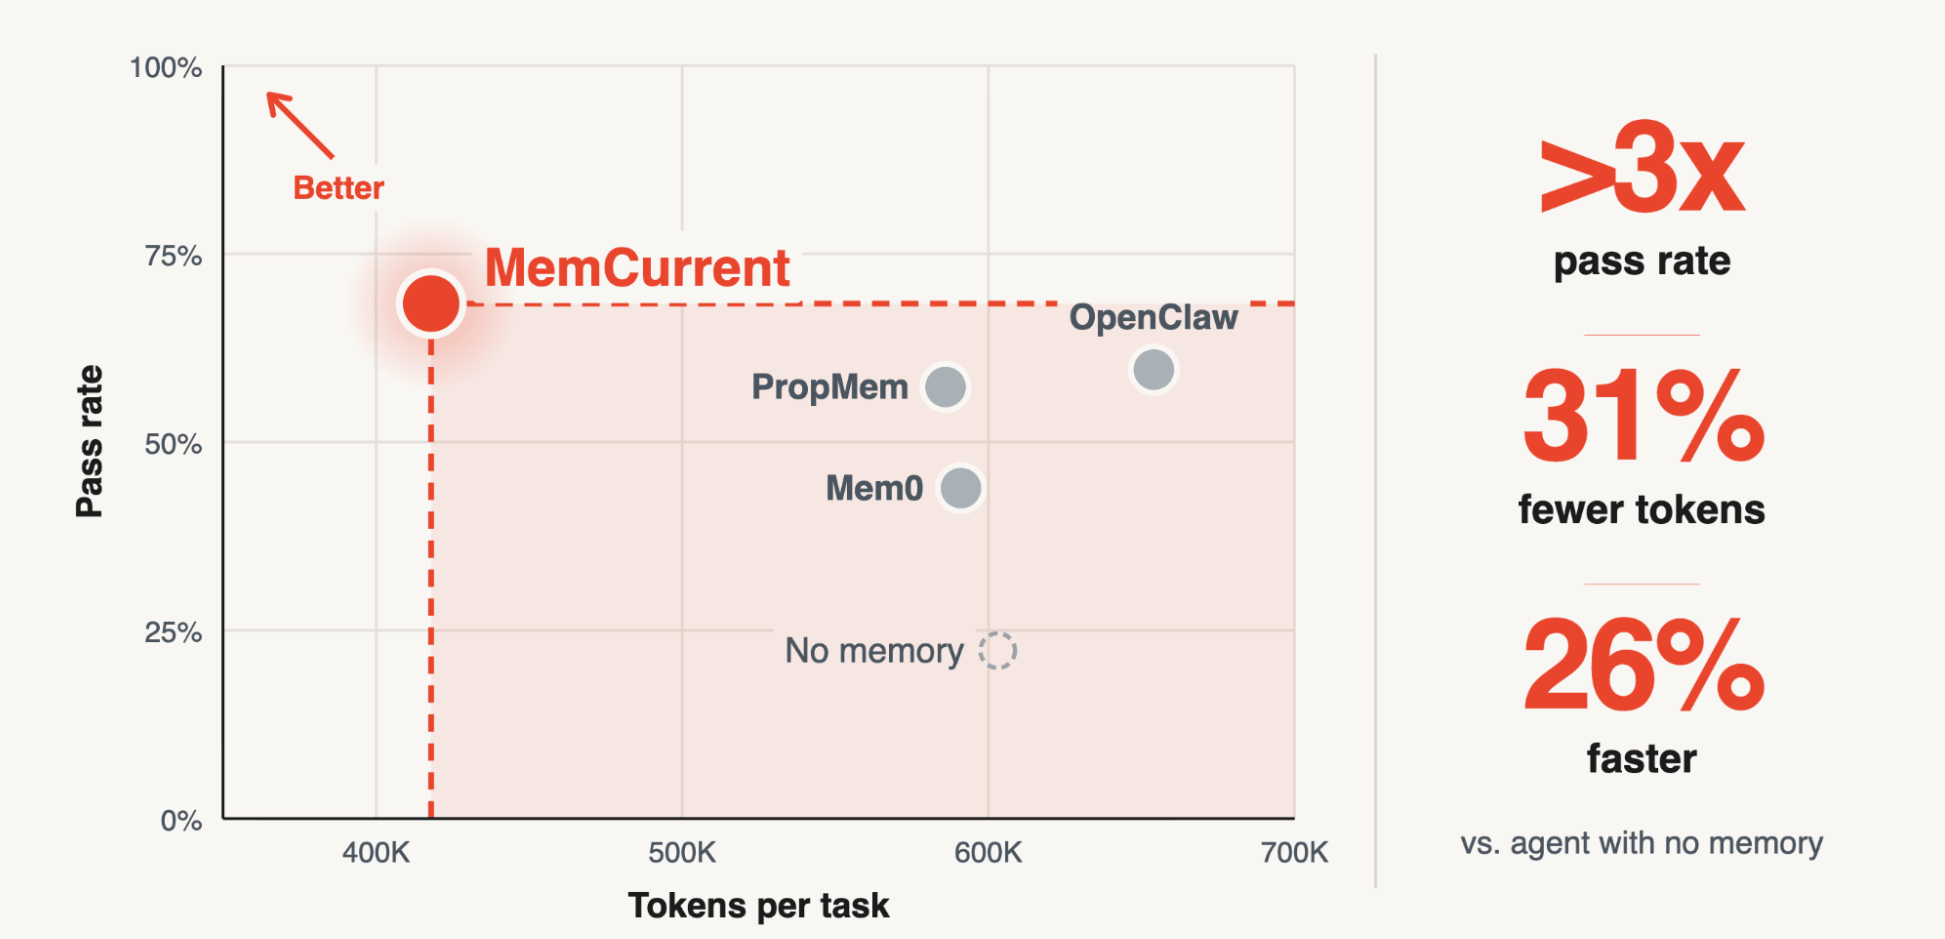
Figura 1. Pass rate rispetto ai token per attività nel nostro Internal Memory Benchmark. MemCurrent si trova sulla frontiera di Pareto, superando la memoria di Mem0, PropMem e OpenClaw su entrambe le dimensioni.
Come abbiamo progettato la memoria
Esistono tre modi per integrare la memoria in un agente. Come plugin (come il nostro lavoro precedente su MemAlign e Memory Scaling), la memoria viene letta e scritta automaticamente in punti fissi di una sessione. Come strumenti, l'agente decide cosa e quando leggere e scrivere. Come pipeline offline, la memoria viene aggiornata in background in base a una pianificazione o a un trigger e utilizzata nelle sessioni successive. Ciascuna modalità comporta dei compromessi:
Memoria come… | Attivata da | Momento di calcolo | Pro | Contro |
Plugin | In automatico | Online |
|
|
Strumento | Agente | Online |
|
|
| Pipeline | Pianificazione o trigger | Offline |
|
|
Tabella 1. Tre modelli di accesso alla memoria: plugin, strumento o pipeline offline.
MemCurrent li utilizza tutti e tre, ciascuno dove risulta più adatto.
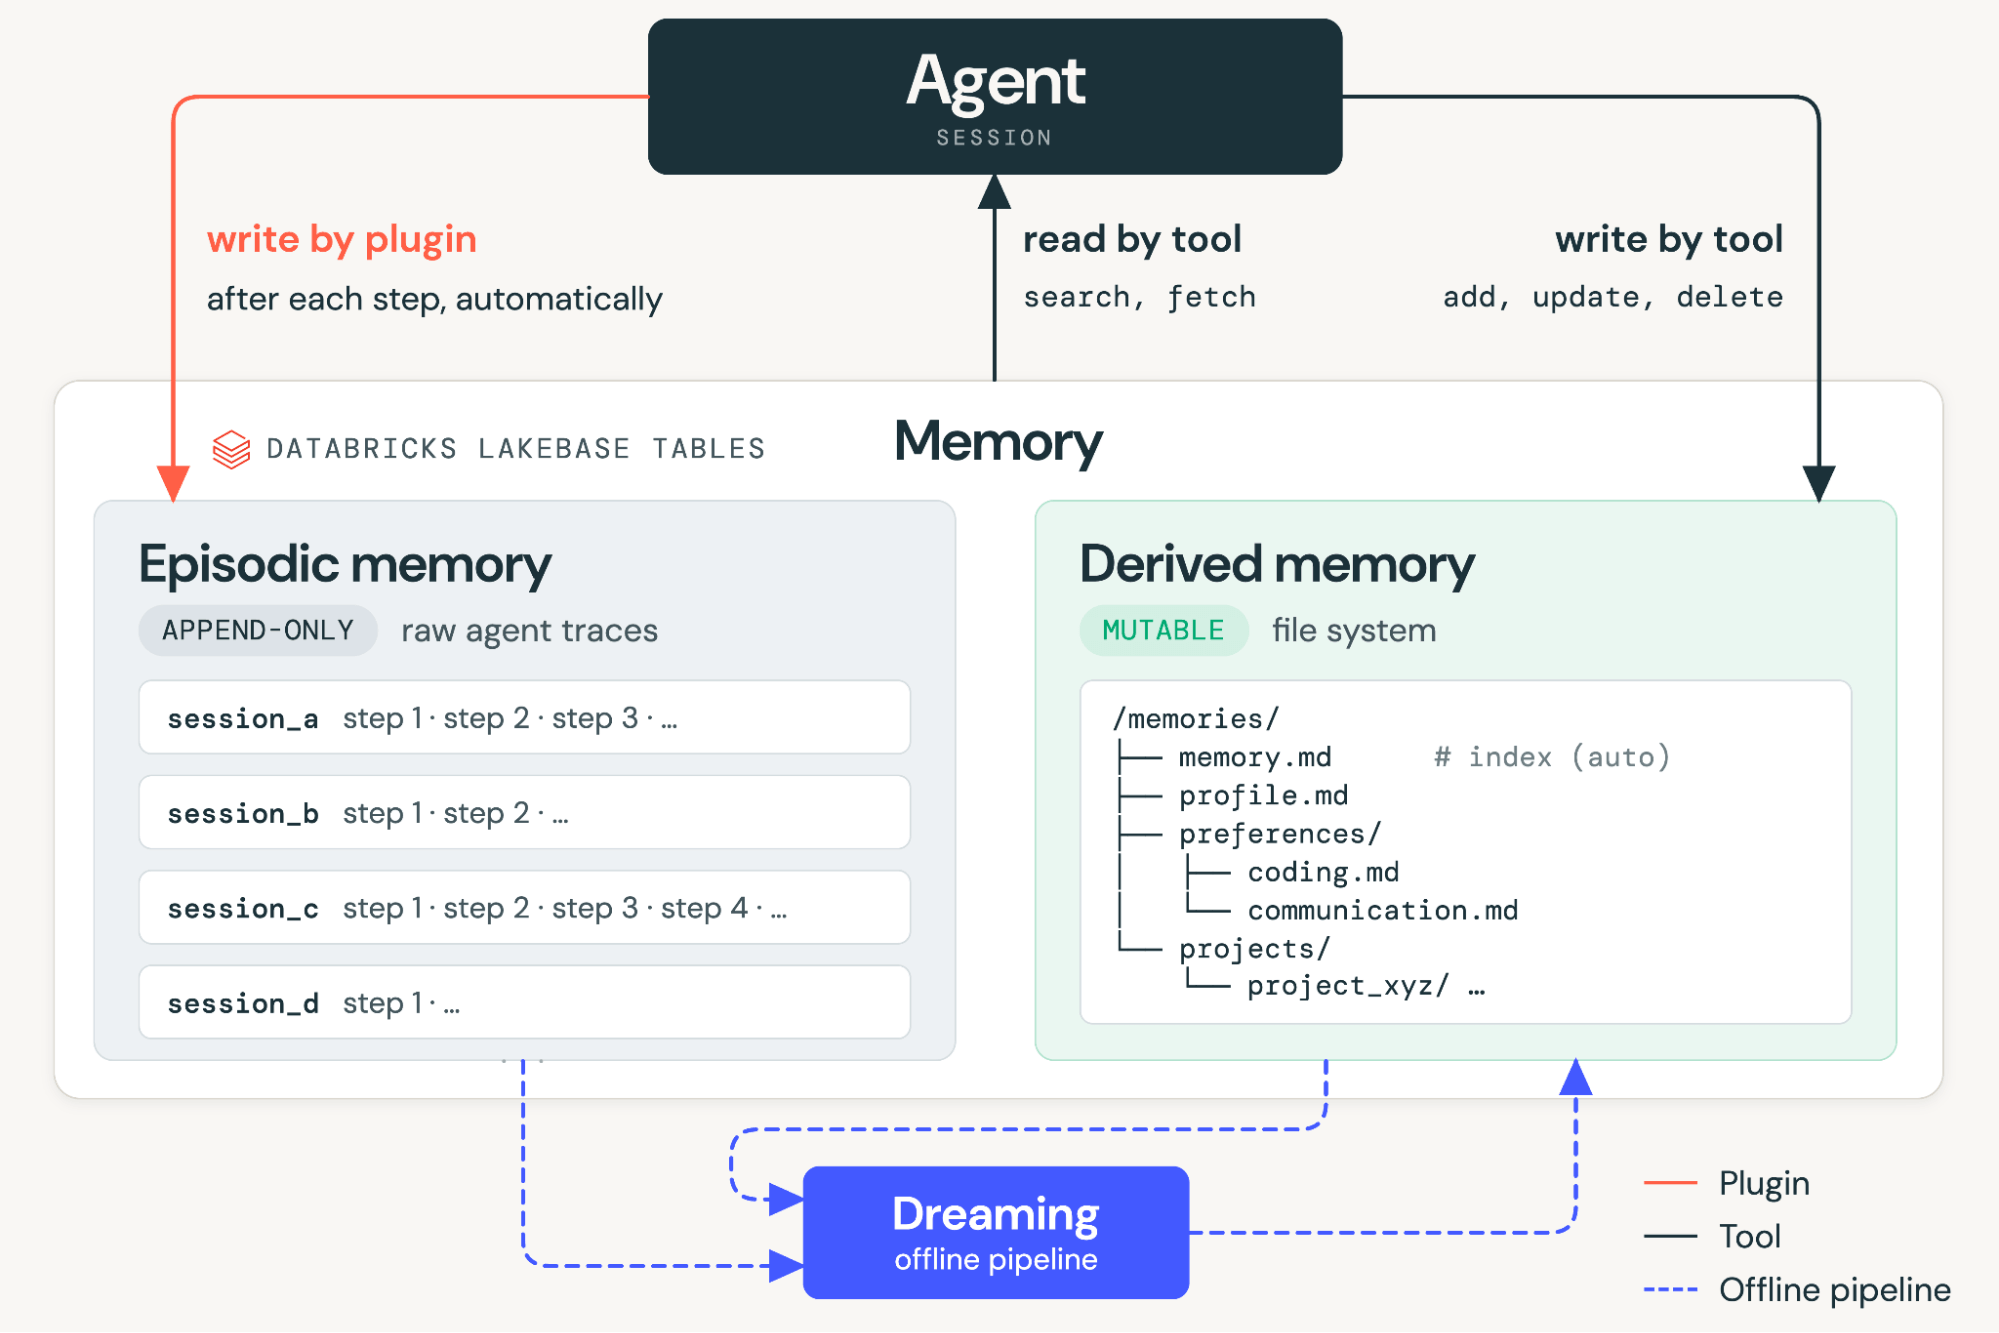
Figura 2. Panoramica di MemCurrent.
MemCurrent dispone di due tipi di memoria: memoria episodica, che memorizza le tracce grezze della sessione; e memoria derivata, che contiene le informazioni distillate da queste tracce, memorizzate come file in una knowledge base strutturata. Un indice generato automaticamente memory.md si trova in alto, descrivendo la struttura dei file e il contenuto di ciascun file.
Sia la memoria episodica che quella derivata risiedono in un database di livello enterprise in grado di scalare su molti utenti fornendo al contempo risposte a bassa latenza. La memoria episodica è di tipo append-only, in cui un plugin registra ciascun passaggio durante l'esecuzione della sessione. La memoria derivata è una tabella modificabile che simula un file system gerarchico, dove la scrittura avviene in due modi. Gli strumenti dell'agente (add_memory, update_memory, delete_memory) gestiscono richieste esplicite come "Non scrivere mai script nella directory /tmp". Una pipeline di dreaming offline cattura il resto, distillando le informazioni implicite da ogni nuova sessione nei file pertinenti. Inoltre, pulisce l'intero archivio, suddividento i file di dimensioni eccessive, unendo i duplicati e risolvendo i conflitti.
La lettura funziona a livelli. All'inizio della sessione, un plugin inserisce l'indice di memoria, in modo che l'agente sappia cosa conosce prima di iniziare. Durante la sessione, l'agente dispone di due strumenti che funzionano su entrambi i tipi di memoria: search_memory restituisce i risultati principali per una query (un passaggio in una traccia passata o una riga in un file di memoria) e fetch_memory restituisce l'voce completa tramite identificativo (ID sessione o percorso file).
Come abbiamo valutato la memoria
Benchmark
Iniziamo con tre popolari benchmark open source: LoCoMo, LongMemEval, e ConvoMem. Tutti e tre testano se un agente è in grado di rievocare fatti dichiarati in precedenza in conversazioni sintetiche aperte.
Inoltre, abbiamo creato un Internal Memory Benchmark a partire da conversazioni reali di Genie, in cui gli utenti pongono qualsiasi tipo di domanda sui propri dati. Come mostrato nella Figura 3, siamo partiti da oltre 12.000 sessioni, abbiamo estratto 3.000 candidati contenenti segnali meritevoli di memoria e abbiamo redatto una domanda di follow-up con rubriche di valutazione. Le altre sessioni dello stesso utente fungono da elementi di riempimento per il caso di test. Un giudice avversario ha quindi verificato ogni caso di test rispetto a 7 criteri, come la presenza effettiva delle conoscenze, la loro specificità per l'utente, la loro necessità per la risposta, la loro naturalezza e la loro verificabilità. Dopo una revisione manuale finale, il benchmark presenta un totale di 114 casi di test, con 29 utenti e 2.233 sessioni di cronologia.
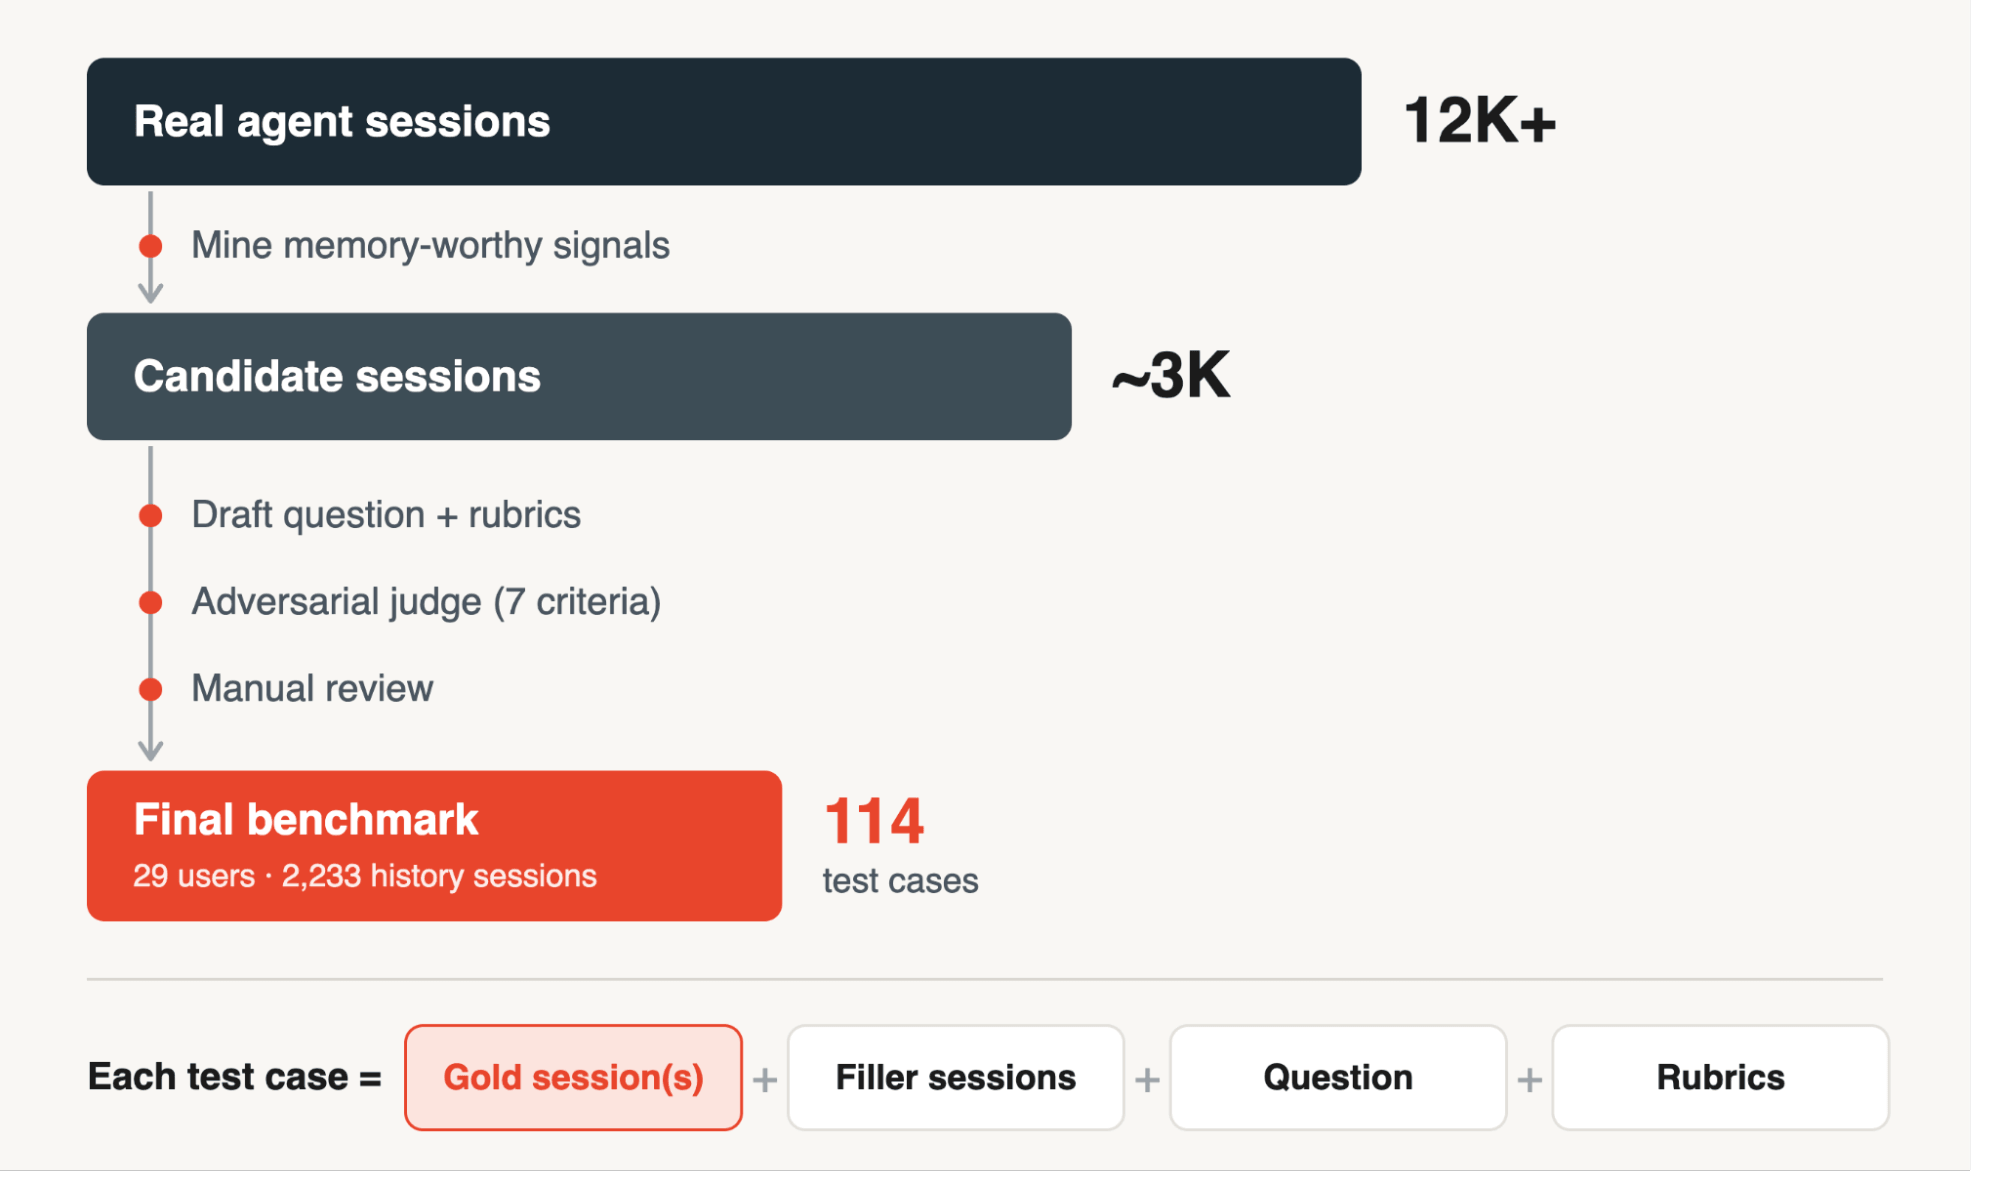
Figura 3. Come abbiamo realizzato il nostro Internal Memory Benchmark.
Ecco un esempio:
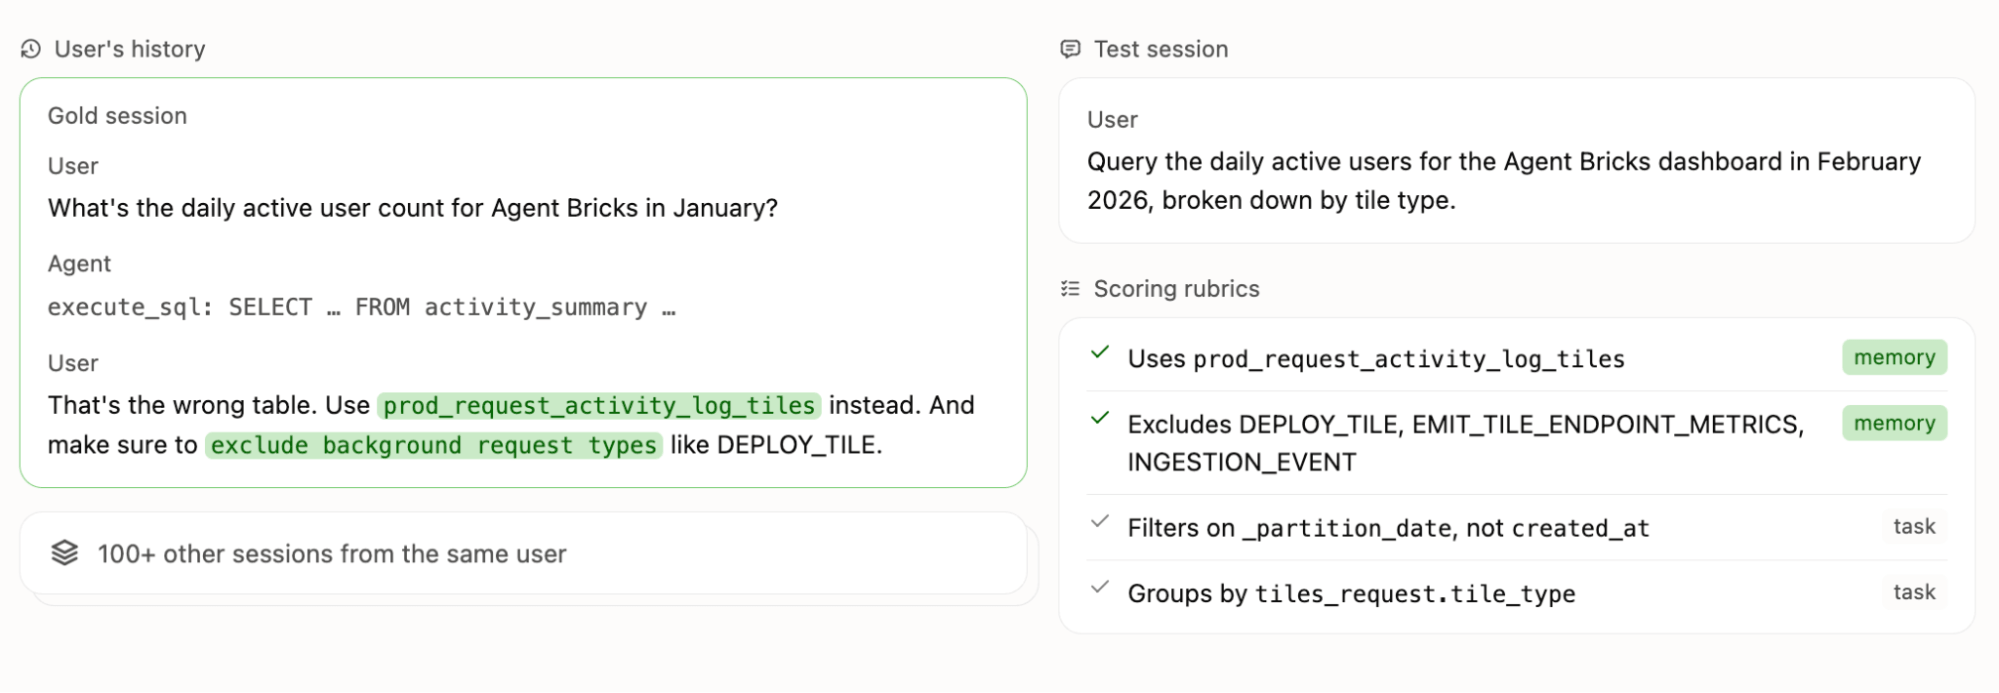
Figura 4. Un esempio di caso di test dal nostro Internal Memory Benchmark. In una sessione passata, l'utente corregge la scelta della tabella da parte dell'agente e gli dice di escludere le richieste in background. In seguito, l'agente si trova di fronte a una domanda diversa ma correlata e deve trovare quella sessione tra oltre 100 altre e applicare ciò che ha imparato. L'output viene valutato da un giudice LLM in base a un elenco di rubriche (alcune dipendenti dalla memoria, altre intrinseche all'attività).
Il nostro benchmark differisce da quelli esistenti sotto tre aspetti:
Dominio aziendale. I benchmark esistenti sono chat a risposta aperta sulla vita di persona simulate. Il nostro deriva da un lavoro reale in un workspace di dati, che coinvolge una ricca conoscenza aziendale come la semantica delle tabelle, le definizioni delle metriche e i workflow.
La memoria alimenta le azioni, non le risposte. Trovare la stringa corretta nelle conversazioni passate non basta; gli agenti devono applicare le conoscenze recuperate per completare task multi-step.
Diversità. I casi di test coprono 5 tipi di memoria (profilo, preferenze, conoscenza del dominio, progetti, workflow) incrociati con 11 scenari (istruzione diretta, fatti modificati o obsoleti, aggregazione multi-sessione, domande indipendenti dalla memoria e altro ancora).
Risultati
Confrontiamo MemCurrent con tre backend di memoria open source, Mem0, PropMem e memoria di OpenClaw, utilizzando lo stesso LLM sottostante.
Benchmark open source. Abbiamo associato ciascun backend di memoria a un semplice agente di question-answering, realizzato con due harness di agenti (LangGraph e OpenAI Agents SDK). Eseguiamo anche due baseline: un limite inferiore con nessuna memoria e un limite superiore con contesto completo, in cui ogni sessione passata entra nel contesto dell'agente. In tutti e tre i benchmark, MemCurrent ottiene il punteggio più alto tra tutti i backend di memoria e rimane sulla frontiera di Pareto costo-accuratezza. In media, MemCurrent (88,1%) offre prestazioni in linea con il contesto completo (87,8%) con circa 12 volte meno token di input per domanda (8,4K rispetto a 103K). Nei due benchmark con le cronologie più lunghe, supera persino il contesto completo, dove l'inserimento indistinto di tutte le informazioni nel prompt finisce per confondere l'agente.
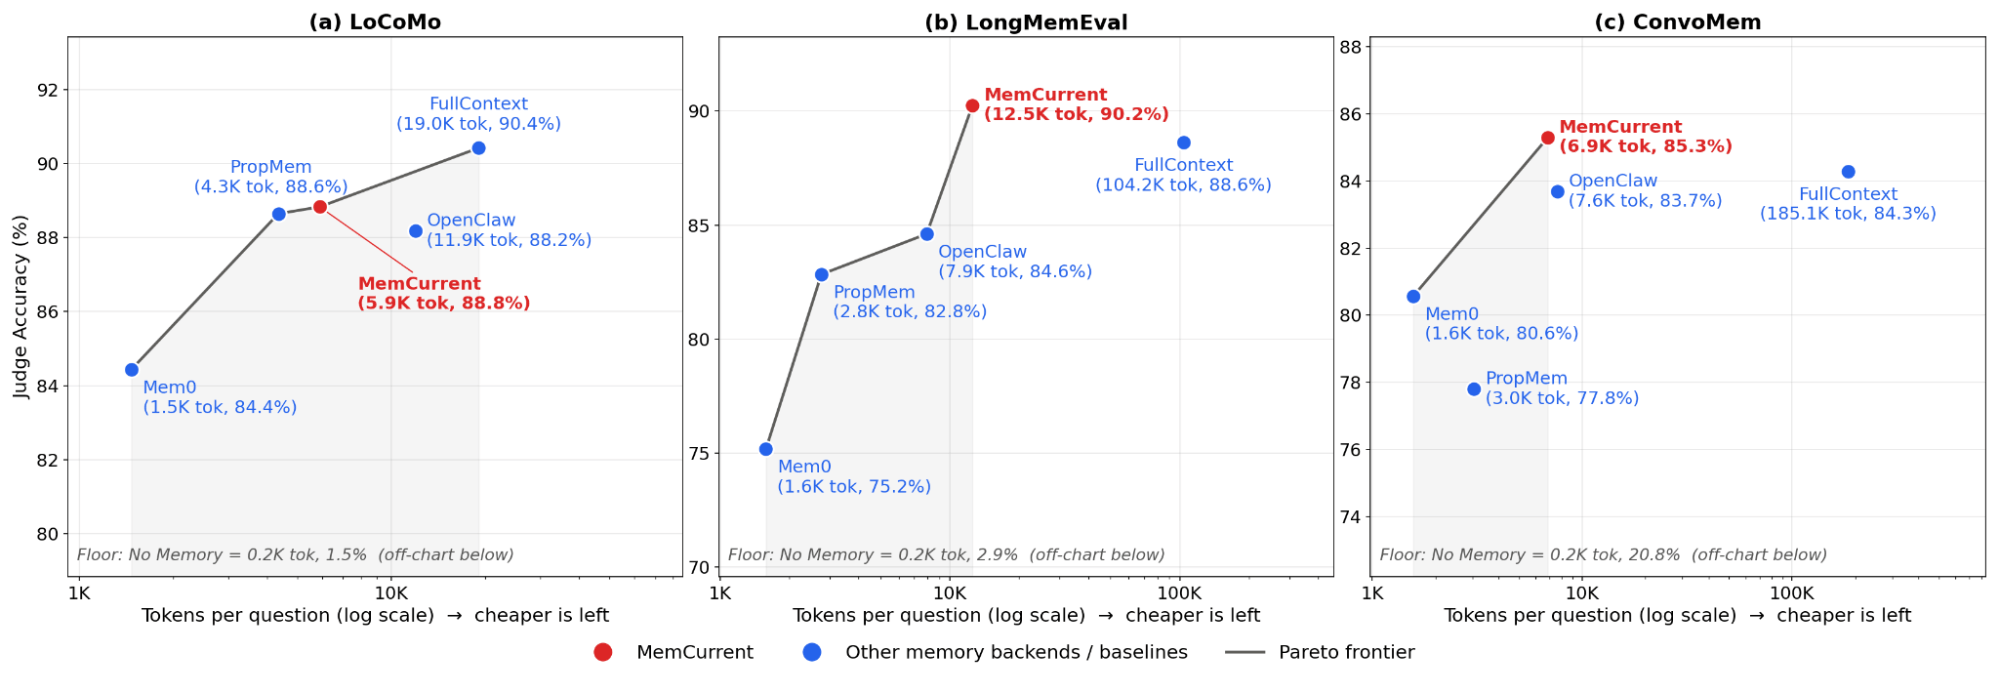
Figura 5. Trade-off costo-accuratezza1 dei backend di memoria su (a) LoCoMo (19–32 sessioni/campione), (b) LongMemEval (s split) (38–62 sessioni/campione) e (c) ConvoMem (sottoinsieme stratificato di 500 campioni, 100 sessioni/campione). Utilizziamo GPT 5.6 luna come modello di agente e di memoria. Tutti i backend di memoria vengono eseguiti come plugin, che cerca automaticamente le memorie correlate alla domanda e le inserisce nel contesto dell'agente all'inizio della sessione.2 L'accuratezza è la media sugli harness LangGraph e OpenAI Agents SDK e 3 ripetizioni. Il costo rappresenta la media dei token di input per domanda (scala logaritmica).
Benchmark di memoria interno. Nel nostro benchmark, il divario si amplifica. Qui, ciascun backend di memoria viene eseguito all'interno del nostro Genie interno, lo stesso agente da cui provengono le sessioni del benchmark. Le cronologie sono troppo lunghe per rientrare nel contesto, quindi il nostro limite superiore è la gold injection: inserire solo le memorie "gold" nel contesto dell'agente. Tra tutti i backend di memoria, MemCurrent presenta il pass rate più elevato (68,4%), la latenza più bassa (252s) e il minor utilizzo di token (418K), colmando oltre l'80% del divario tra nessuna memoria (22,3%) e gold injection (78,6%). Notabilmente, mentre anche Mem0 si trovava sulla frontiera nei benchmark precedenti, qui rimane indietro al 43,9% con latenza e costi superiori. Rispetto a nessuna memoria, MemCurrent triplica il pass rate dell'agente (22,3% → 68,4%) rendendolo al contempo 1,35 volte più veloce e 1,44 volte più economico.
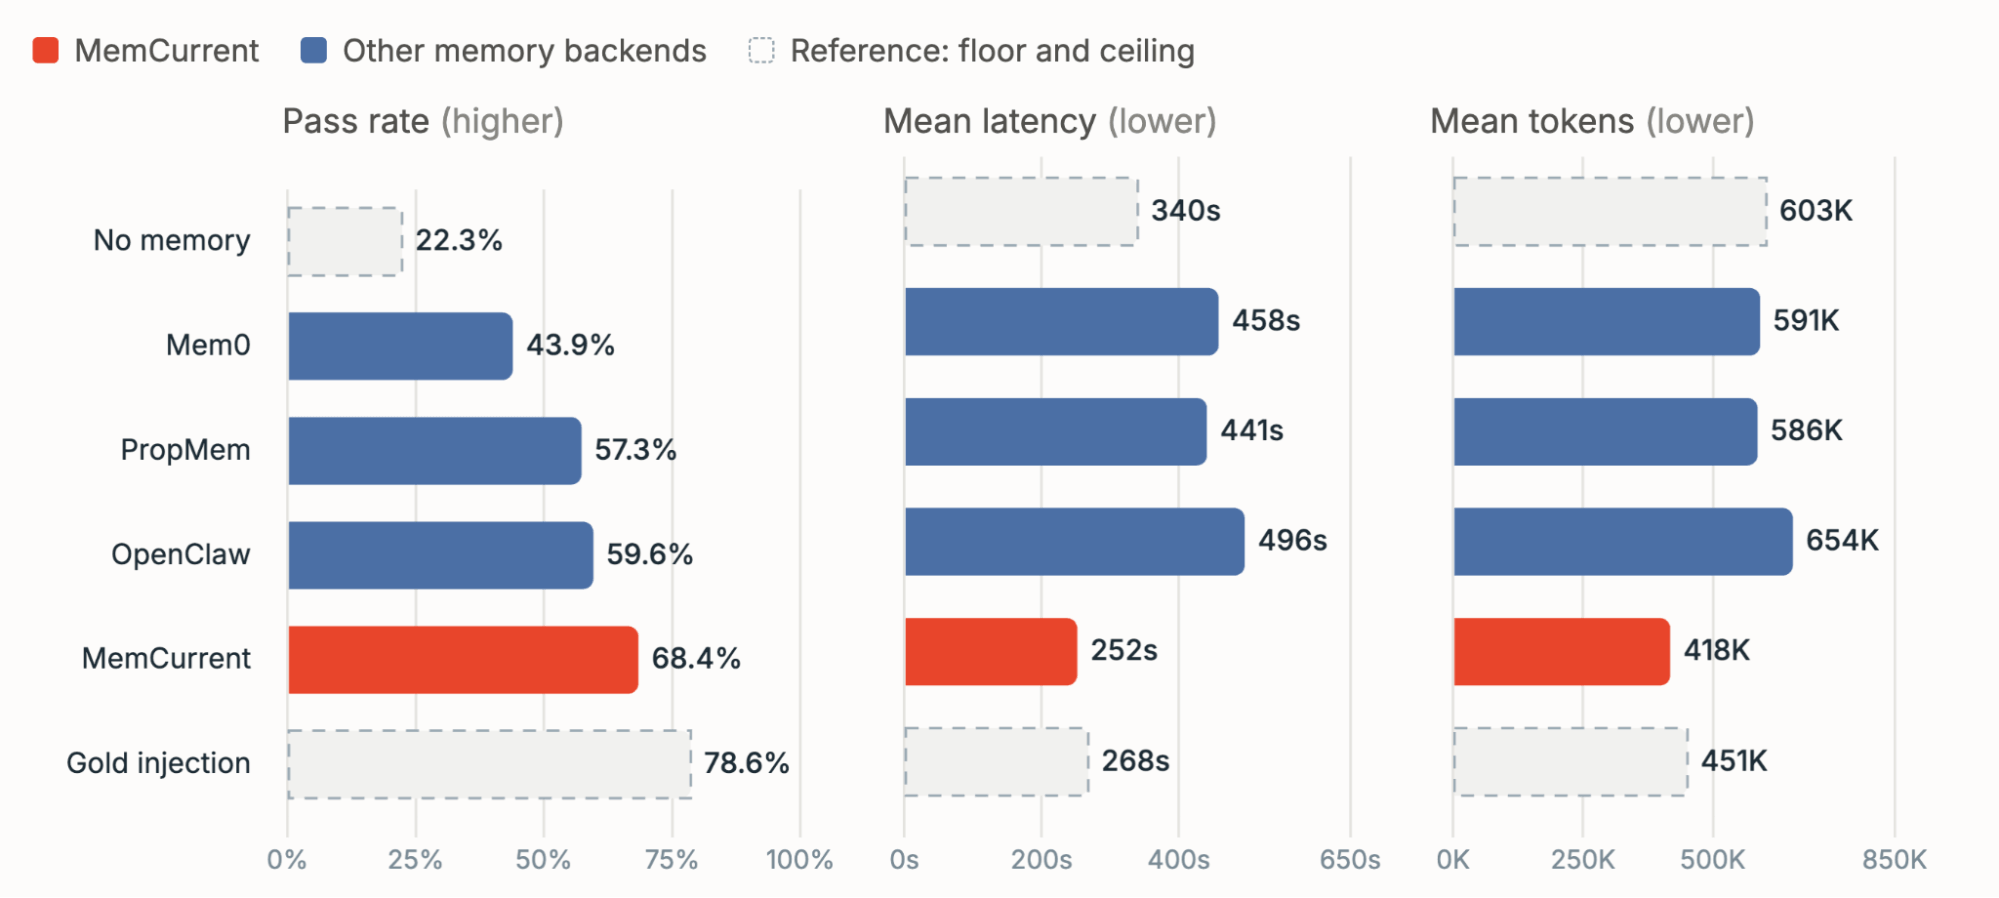
Figura 6. Pass rate, latenza media e utilizzo medio di token per task nel nostro Internal Memory Benchmark su 3 ripetizioni. Utilizziamo Claude Opus 4.6 come modello di agente e GPT 5.6 sol come modello di memoria. Tutti i backend di memoria sono forniti come tool di agente e plugin di avvio sessione.
MemCurrent in azione
Oltre ai numeri del benchmark, esaminiamo due esempi reali dell'utilità di MemCurrent, tratti dalle sessioni interne di Genie.
Esempio 1: La memoria evita un errore occasionale di allucinazione. Nella Figura 7, un utente ha chiesto all'agente i primi 20 utenti del Prodotto X negli ultimi due mesi. L'agente ha scritto una query SQL corretta, ma non ha mai letto i risultati di esecuzione effettivi salvati su file. Ha comunque generato con sicurezza una tabella con contenuti frutto di allucinazione. A seguito del feedback dell'utente, l'agente ha salvato la lezione in memoria. La volta successiva, una volta eseguita la query, l'agente ha prima letto i risultati e poi ha restituito la tabella corretta. Una singola correzione della memoria ha evitato che uno sbaglio isolato diventasse un'abitudine.
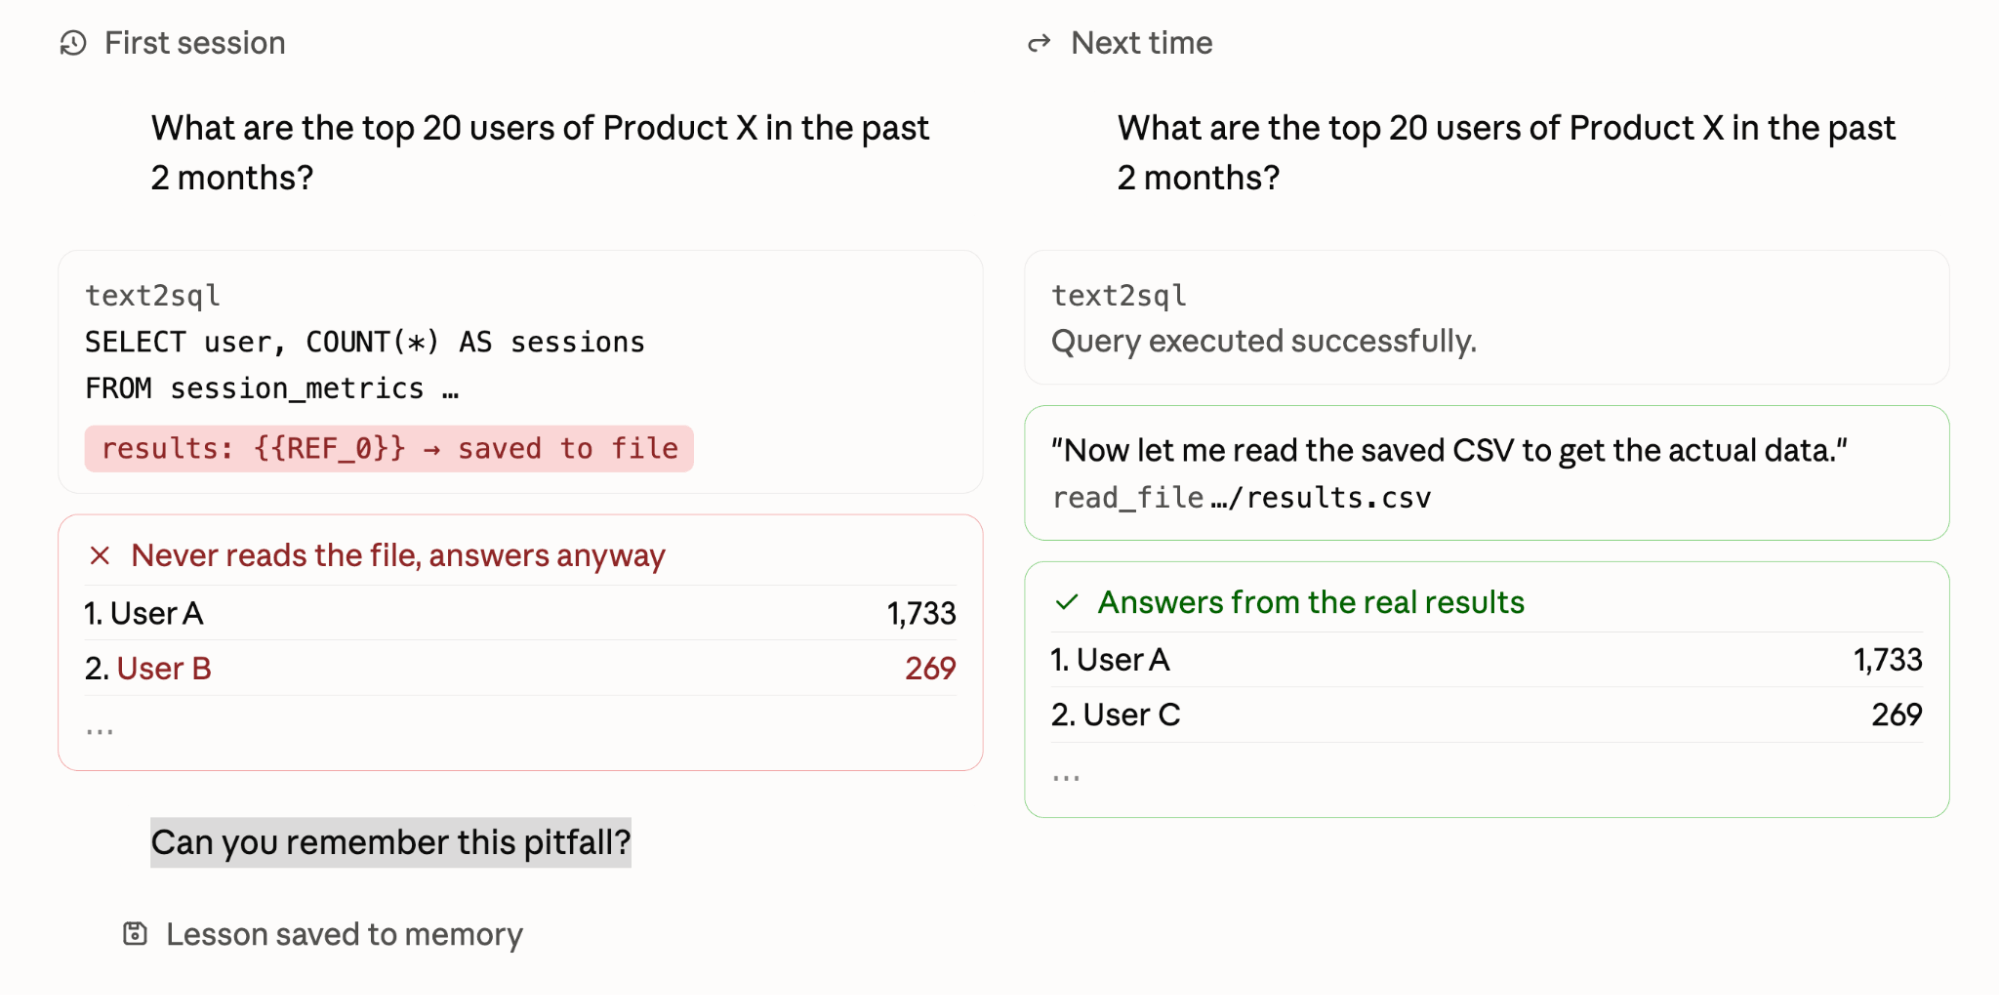
Figura 7. Un esempio anonimizzato di come la memoria aiuti l'agente a evitare un errore di allucinazione ripetuto.
Esempio 2: La memoria risparmia risorse di calcolo sui task correlati. Nella Figura 8, un utente ha richiesto i "primi 5 clienti SDP". L'agente ha dovuto ricostruire tutto da capo: cosa significasse "SDP", quali tabelle contenessero i dati di utilizzo e come unirle e filtrarle. Sono servite 11 chiamate ai tool, 8 sub-agenti e quasi sei minuti. L'agente ha salvato questi passaggi sotto forma di file di workflow in memoria, per poterne riutilizzare la procedura in task correlati. In seguito, l'utente ha posto una domanda diversa: quanti clienti SDP hanno avuto più di 5K esecuzioni di pipeline il mese scorso. Utilizzando il workflow, l'agente ha risposto con 2 chiamate ai tool e 1 sub-agente in 41 secondi. La domanda era nuova, ma il percorso verso la risposta no, e la memoria ha consentito all'agente di saltare passaggi di esplorazione non necessari.
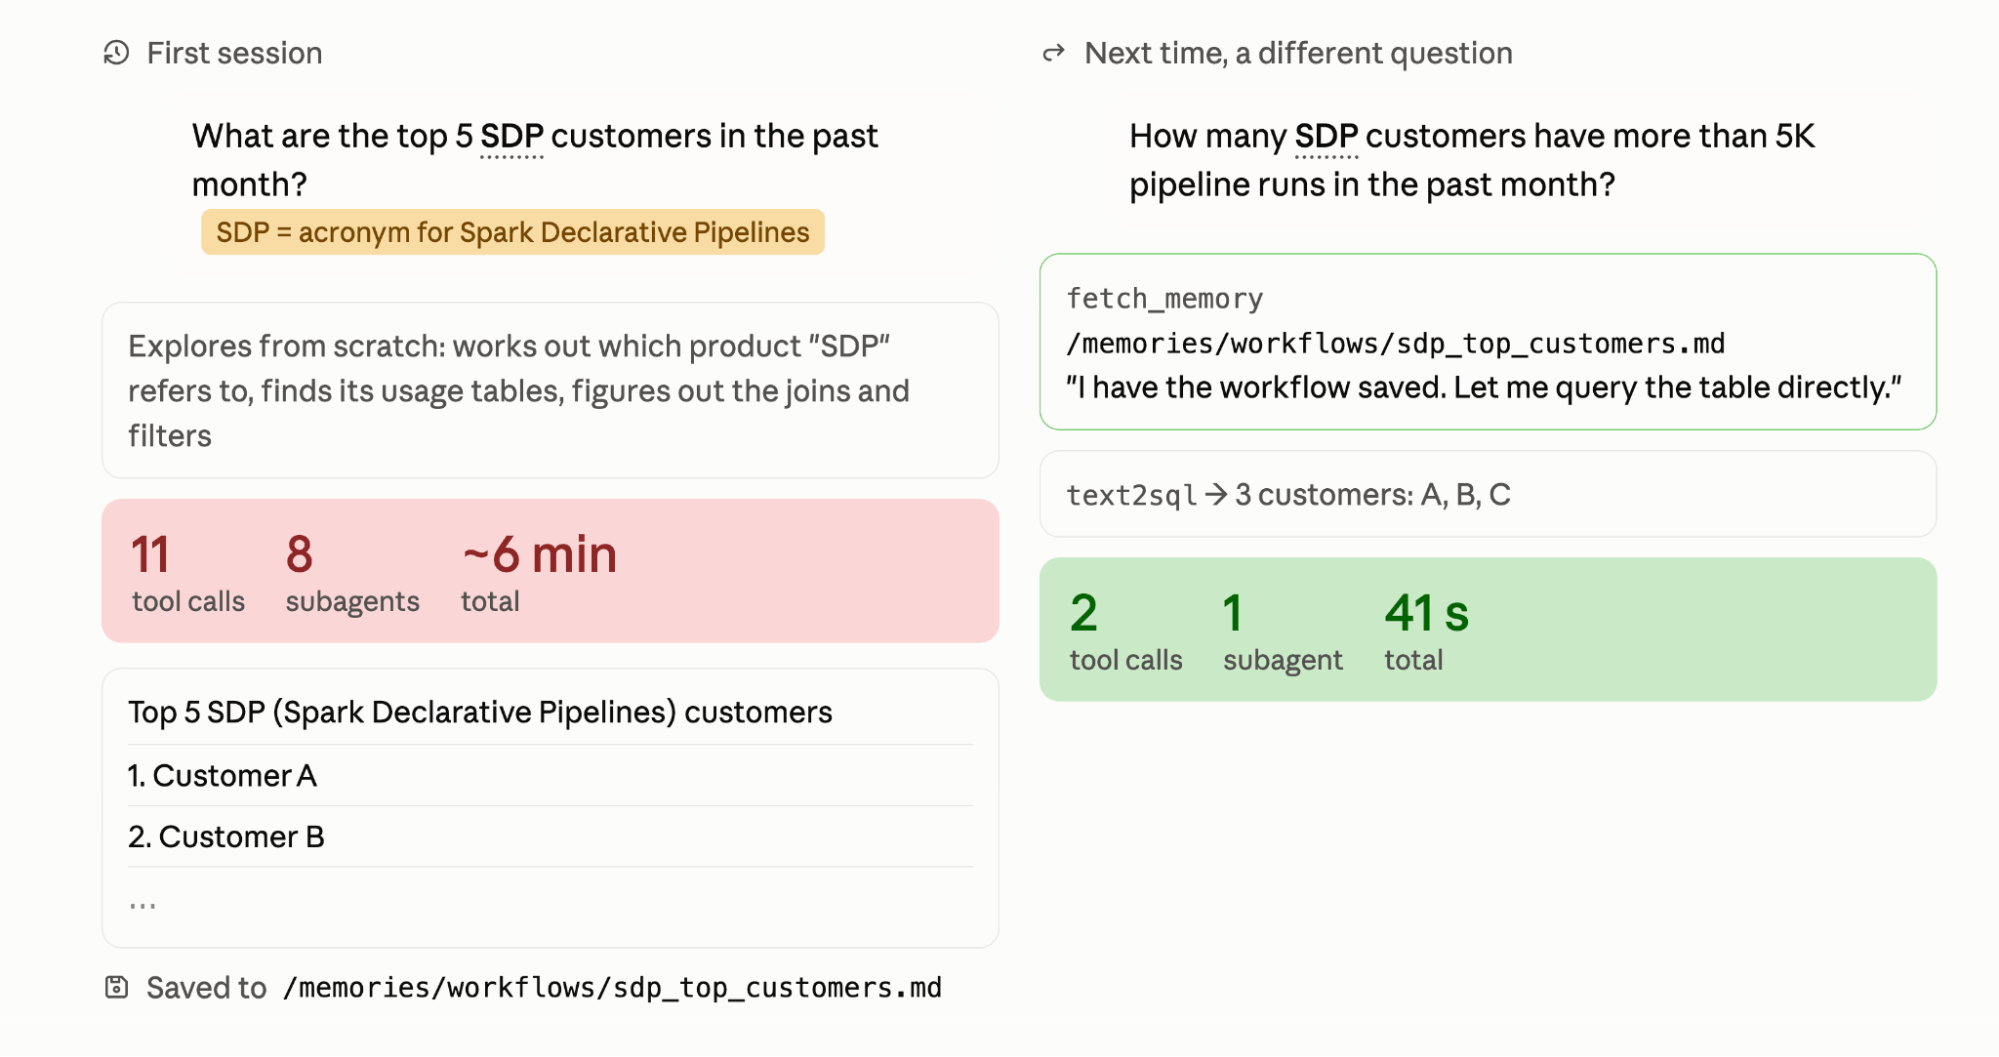
Figura 8. Un esempio anonimizzato di come la memoria trasformi un task da 6 minuti in uno da 41 secondi.
Cosa rende efficace MemCurrent
Per comprendere i motivi delle prestazioni superiori di MemCurrent, abbiamo condotto studi di ablazione sul nostro Internal Memory Benchmark relativamente a due scelte architetturali: i tipi di memoria e la strategia di estrazione.
Servono entrambi i tipi di memoria? La sola memoria episodica offre un aiuto moderato: 35,8%, in aumento rispetto al 22,3% registrato senza memoria. La cronologia grezza è utile, ma l'agente la ricerca solo in circa un terzo dei casi di test (anche se in quei casi supera il test il 60% delle volte). La memoria derivata evita questo problema, in quanto l'indice di memoria inserito all'inizio della sessione fornisce all'agente informazioni su cosa sia disponibile in memoria e quando cercarlo, elevando il pass rate al 66,1%. L'aggiunta della memoria episodica a questo impianto offre il risultato migliore, con il 68,4%. Il guadagno è ridotto, ma suggerisce che le tracce grezze consentono di recuperare dettagli tralasciati dalla distillazione.
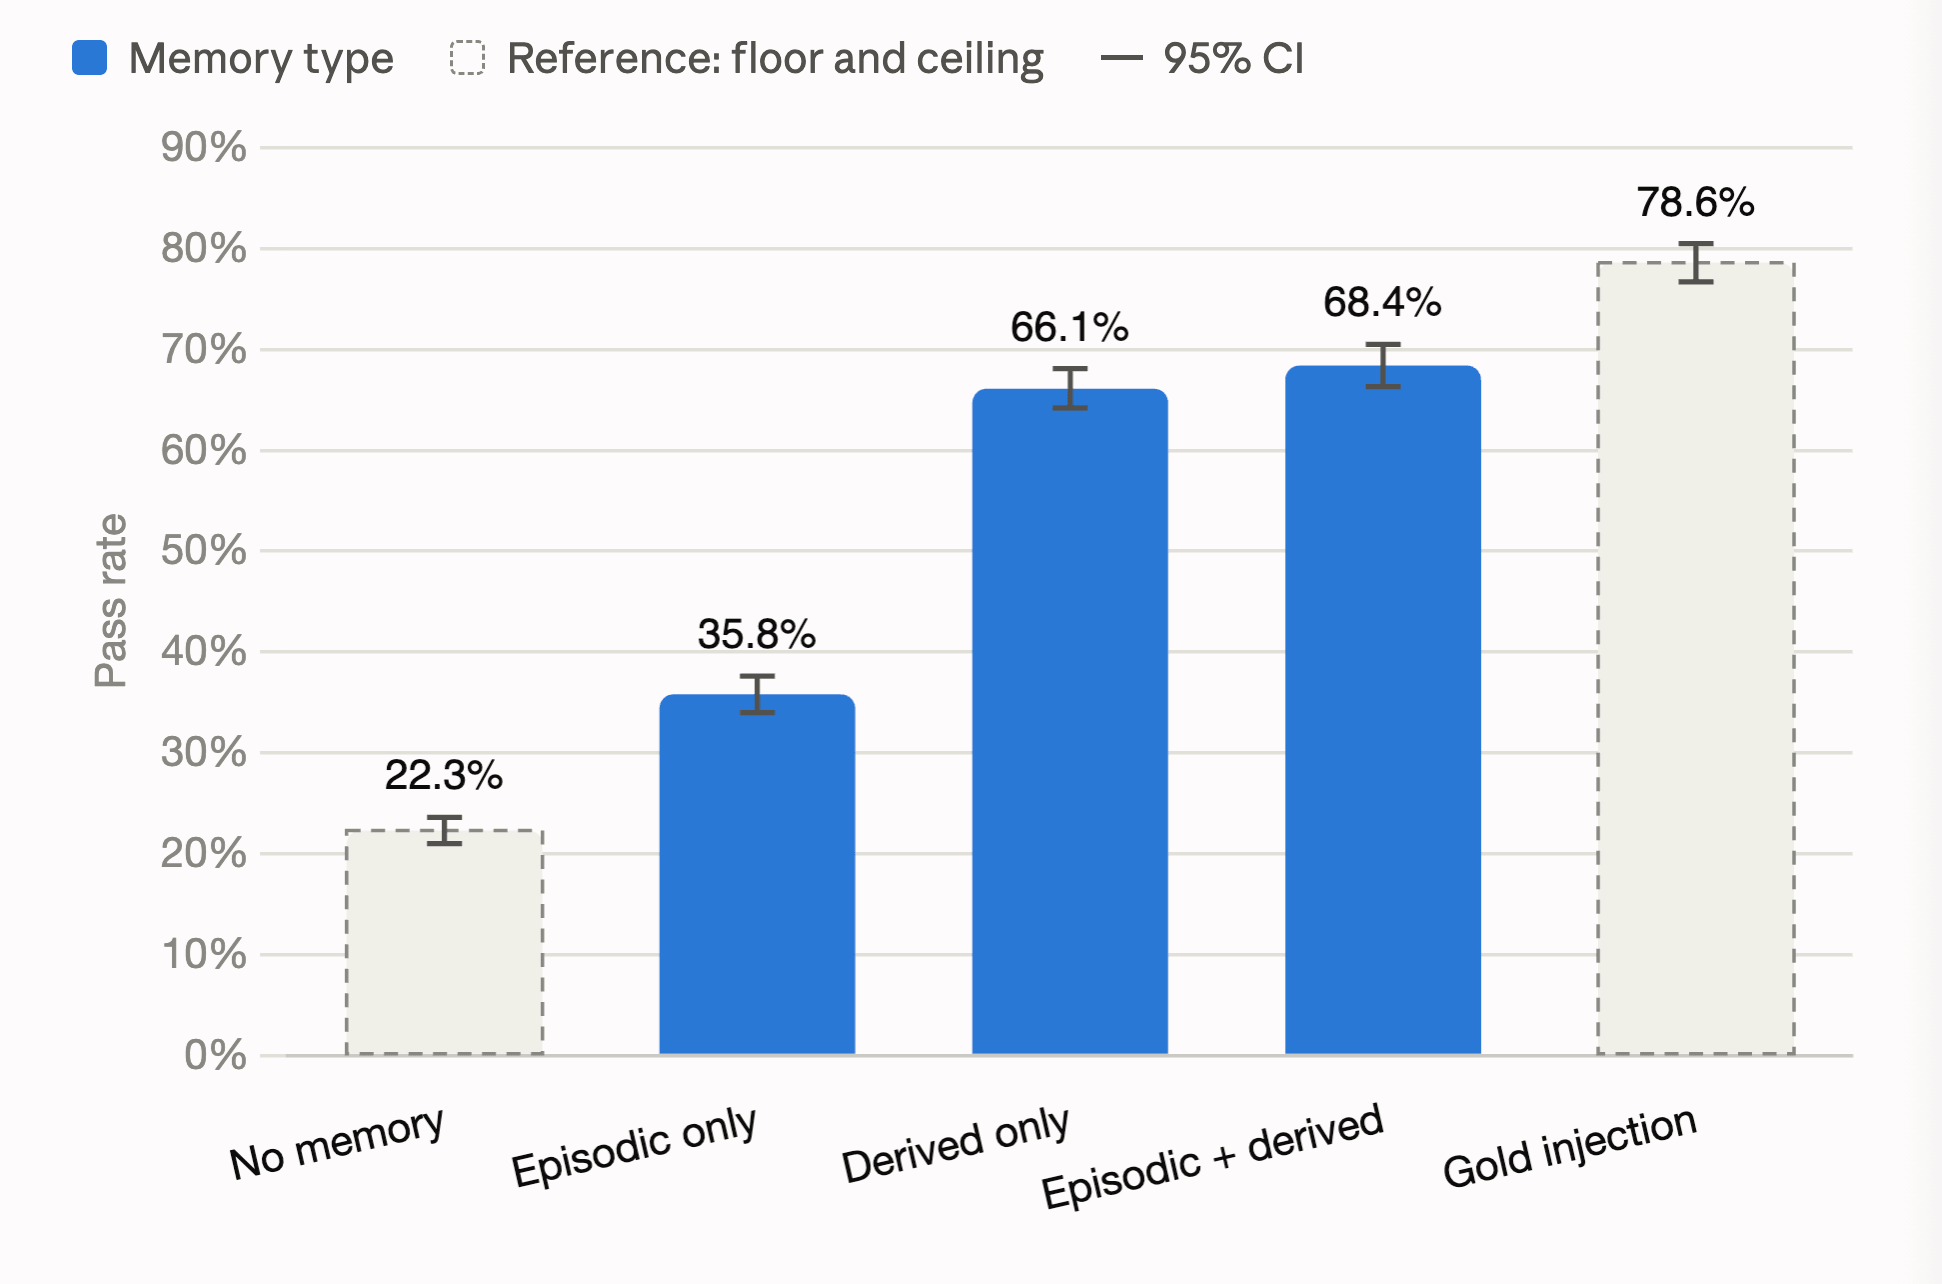
Figura 9. Pass rate per tipo di memoria.
Qual è una buona strategia di estrazione della memoria? Come mostrato nella Figura 2, due canali estraggono la memoria derivata: i tool online e il dreaming offline. Se analizzato isolatamente, il dreaming offline (63,5%) supera i tool online (53,9%) di quasi 10 punti. La loro combinazione produce il pass rate più elevato, pari al 66,1%. Questo risultato conferma la suddivisione dei compiti: il dreaming gestisce l'estrazione e il consolidamento in background, mentre i tool online rendono immediatamente effettive le richieste esplicite.
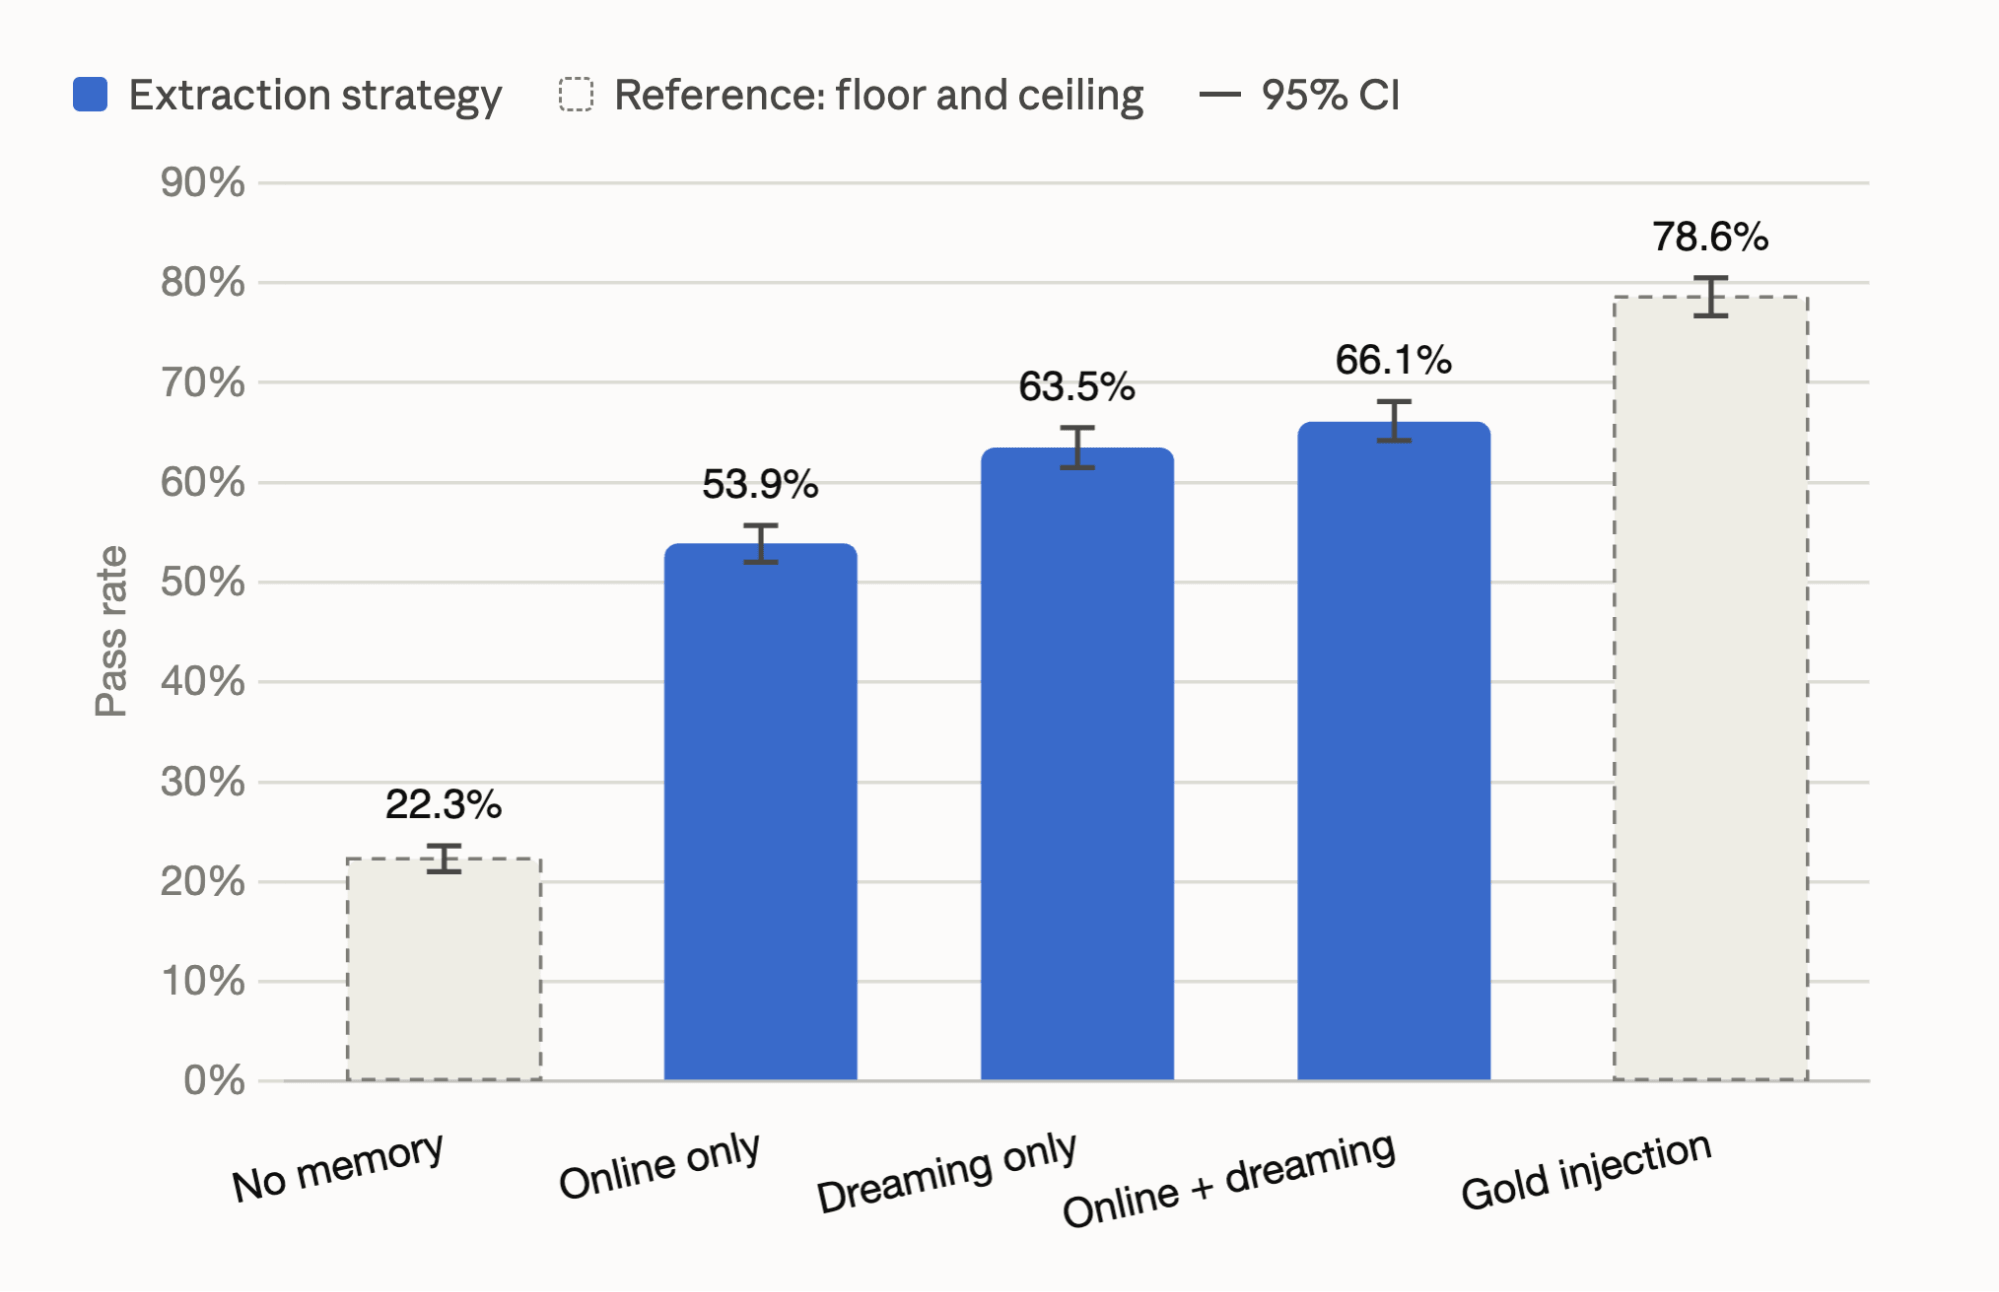
Figura 10. Pass rate per strategia di estrazione.
Conclusione
La memoria è ciò che consente a un agente di evitare di ripartire ogni volta da zero. In questo post abbiamo presentato MemCurrent, un'architettura di memoria per agenti in produzione che combina memoria episodica e memoria derivata con tre pattern di accesso: plugin per registrare e caricare automaticamente il contesto, tool che l'agente invoca su richiesta e una pipeline di dreaming offline che consolida la memoria in background.
In tutti i benchmark eseguiti, MemCurrent migliora contemporaneamente qualità ed efficienza, superando il trade-off che ci eravamo proposti di superare. Nei benchmark open source offre prestazioni in linea con il contesto completo con circa 12 volte meno token di input. Nel nostro Internal Memory Benchmark, basato su lavoro reale sui dati, triplica il pass rate dell'agente rispetto all'assenza di memoria, rendendolo al contempo più veloce ed economico.
Gli studi di ablazione evidenziano l'origine di questo valore. La memoria derivata svolge la maggior parte del lavoro, mentre la memoria episodica fornisce un ulteriore piccolo contributo recuperando dettagli tralasciati dalla distillazione. La combinazione di tool online e dreaming offline rappresenta la strategia di estrazione migliore: le richieste esplicite diventano immediatamente effettive, mentre il dreaming distilla gli apprendimenti impliciti e consolida l'archivio in background.
Al di là dei numeri, la memoria offre una base di conoscenza non vincolata a un singolo agente o LLM. Può seguire gli utenti verso nuovi agenti o LLM e potrebbe costituire il punto di partenza per conoscenze condivise nell'intera organizzazione, una direzione che esploreremo prossimamente.
Per iniziare
Stiamo applicando queste scoperte per guidare il miglioramento di tutti i prodotti Databricks:
Per gli sviluppatori di agenti. Agent Bricks è la piattaforma di sviluppo di Databricks per la creazione di agenti personalizzati. MemCurrent è integrato nell'offerta Memory di Agent Bricks, basata su Lakebase. L'offerta include:
- Store di sessione per la memoria episodica
- Memory store per la memoria derivata
- Una pipeline automatica di dreaming
- Tracciamento e valutazione della qualità dell'agente, incluso l'impatto della memoria
- Una CLI che ti consente di iniziare rapidamente con un agente di esempio end-to-end completo di tutto ciò in <10 minuti
Inizia subito a creare il tuo agente personalizzato.
Per gli utenti di Databricks Genie. Genie è un'interfaccia con cui gli utenti Databricks possono conversare con i propri dati in linguaggio naturale. MemCurrent è già attivo dietro le quinte, contribuendo a migliorare la qualità delle risposte e riducendo al contempo la latenza e i costi.
Inizia subito con Genie.
Autori: Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen
Ringraziamo Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu e i partecipanti allo studio interno sugli utenti per il loro feedback e supporto durante questo progetto.
1 La latenza è simile (4-7 s/domanda) in tutti i backend di memoria, poiché alla maggior parte delle domande è possibile rispondere in un singolo passaggio.
2 Riteniamo che la memoria basata su plugin sia sufficiente per i benchmark esistenti. I risultati derivanti dall'aggiunta di strumenti sono strettamente dominati e quindi omessi.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.