So holen Sie das Beste aus der Ausführung von dbt auf Databricks heraus
Machen Sie dbt-Pipelines auf Databricks günstiger, schneller und einfacher zu betreiben.
von Srilekha Dornadula und Luís Cabral
- Vermeiden Sie das Zusammenflicken separater Tools und behalten Sie die gesamte Pipeline in einem einzigen dbt-Projekt auf Databricks – von der Streaming-Ingestion bis hin zu verwalteten Metrikdefinitionen
- Orchestrieren Sie dbt nativ in Lakeflow Jobs, ohne dass ein externer Orchestrator erforderlich ist.
- Definieren Sie Governance direkt im dbt-Projekt, sodass Zugriffsregeln durch Unity Catalog direkt aus Ihren Projektkonfigurationen durchgesetzt werden.
Zehntausende von Organisationen verlassen sich bei der Datentransformation auf dbt. Wo Sie es ausführen, prägt alles: wie viel die Ausführung Ihrer dbt-Pipelines kostet, wie schnell sie bereitgestellt werden und wie viel operativer Aufwand damit verbunden ist. Die Ausführung von dbt auf Databricks bietet Ihren dbt-Workloads eine offene Plattform und eine einheitliche Pipeline.
Über 3.000 Organisationen nutzen dbt auf Databricks, und die meisten Teams könnten noch viel mehr herausholen. Dieser Blogbeitrag stellt Best Practices vor, mit denen dbt-Pipelines auf Databricks günstiger, schneller und einfacher zu betreiben sind.
Machen Sie Ihre dbt-Pipelines günstiger und schneller
dbt-Kosten steigen durch Arbeiten, die Sie nicht wiederholen müssten. Vollständige Neuerstellungen berechnen Daten neu, die sich nicht geändert haben, die Aufrechterhaltung schneller Abfragen erfordert manuelles Tuning, und wenn die Kosten steigen, gibt es keine klare Zuordnung zu den verursachenden dbt-Modellen. Wenden Sie die Praktiken in diesem Abschnitt an, und Ihre Pipelines werden:
- Nur die Daten neu erstellen, die sich tatsächlich geändert haben
- Schnell bleiben, ohne dass Sie Partitionsschlüssel auswählen oder überarbeiten müssen
- Tabellenwartung automatisch ohne Post-Hooks ausführen
- Jeden Dollar an Ausgaben bis zu einem bestimmten Modell zurückverfolgen
1. Bauen Sie mit inkrementellen Strategien nur das auf, was sich geändert hat
Vollständige Tabellen-Rebuilds sind in den meisten dbt-Projekten der größte vermeidbare Kostenfaktor. Wenn sich zwischen den Ausführungen nur ein kleiner Teil der Daten ändert, verschwendet die Neuberechnung der gesamten Tabelle Ihre Rechenleistung und erhöht Ihre Rechnung. Die inkrementellen Strategien von dbt, die alle auf dbt-databricks unterstützt werden, sorgen dafür, dass jedes Modell nur neue Daten verarbeitet. Die richtige Wahl hängt davon ab, wie Ihre Daten tatsächlich eintreffen.
Strategie | Verwenden Sie sie, wenn |
|---|---|
append | Zeilen immer nur eingefügt und nie aktualisiert werden |
merge | Derselbe Schlüssel mehr als einmal eintreffen kann und ein Upsert erforderlich ist (Slowly Changing Dimensions, Deduplizierung, spät eintreffende Aktualisierungen) |
replace_where | Das Modell bei jedem Durchlauf ein enges Zeitfenster neu ableitet, wie z. B. die Aktivitäten der letzten Tage |
insert_overwrite | Ihre Abfrage ganze Partitionen zurückgibt |
delete+insert | Sie Datensätze nach Schlüssel ersetzen möchten, ohne Aktualisierungslogik auf Spaltenebene |
microbatch | Zeitreihendaten mit einer event_time-Spalte und strukturierten Backfill-Anforderungen vorliegen |
Die meisten Projekte nutzen standardmäßig merge, obwohl eine gezieltere Strategie ausreichen würde. Wenn Sie die geänderten Daten mit einem Prädikat beschreiben können, erfordert replace_where weniger Aufwand als ein merge, das das Ziel scannen muss, um Übereinstimmungen zu finden. Wenn das nicht möglich ist, schränkt incremental_predicates auf das merge diesen Scan erheblich ein.
Jede der obigen Strategien ist eine Entscheidung, die Sie treffen und pflegen müssen. Die nächste Best Practice sorgt dafür, dass die Plattform dies für Sie übernimmt.
2. Überlassen Sie Materialized Views die Inkrementierung
Materialized Views automatisieren die Inkrementierung. Sie können das Modell in einfachem SQL definieren, und Databricks verfolgt, welche zugrunde liegenden Daten sich geändert haben, und aktualisiert nur die betroffenen Ergebnisse. Auf dbt-databricks ist eine Materialized View eine native Materialisierung, sodass dies nur eine einzeilige Konfigurationsänderung ist:
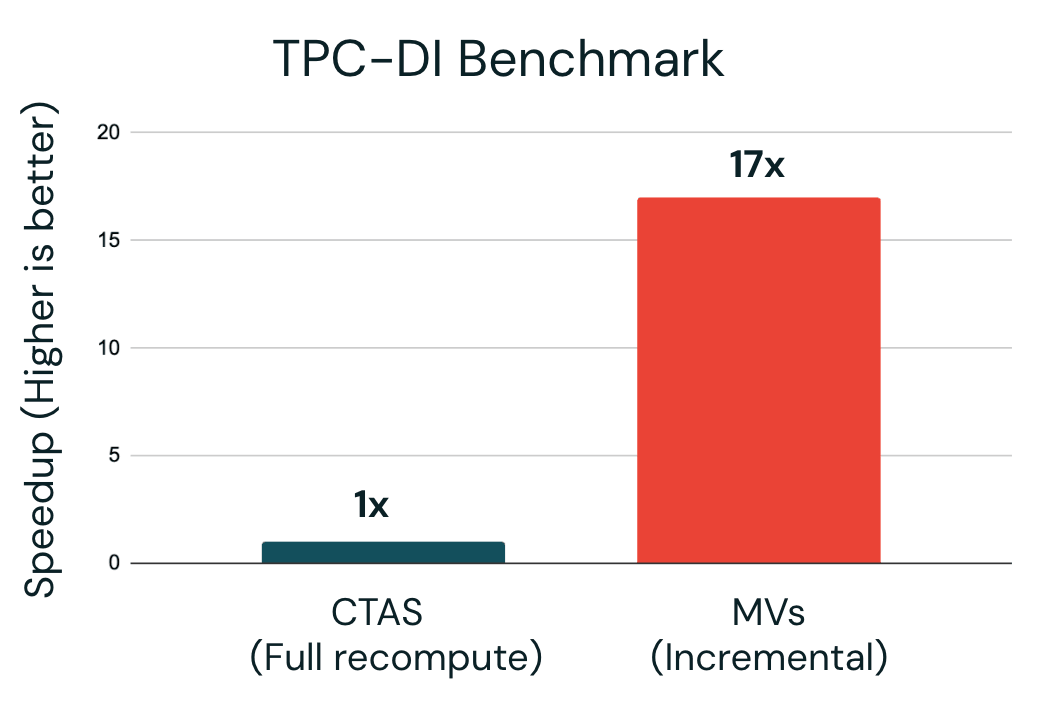
Materialized Views eignen sich am besten auf dem Serving-Layer: Aggregationen über sich häufig ändernde Quellen, insbesondere die kostenintensiven, die Dashboards unterstützen und aktuell bleiben müssen. In unserem TPC-DI-Benchmark brachte die Umstellung von vollständigen Neuberechnungen auf Materialized Views auf dem Serving-Layer eine 17-fache Beschleunigung.
3. Automatisieren Sie das Datenlayout für Performance-Tuning
Das Auswählen von Partitionsschlüsseln, deren Überarbeitung bei sich ändernden Abfragemustern und das Planen von OPTIMIZE, VACUUM und ANALYZE in Post-Hooks erfordern Entwicklungszeit.
Predictive Optimization führt OPTIMIZE, VACUUM und die Erfassung von Statistiken auf verwalteten Tabellen automatisch aus und wählt basierend auf der Abfrage der jeweiligen Tabelle aus, was wann ausgeführt wird. Aktivieren Sie es einmal auf Katalog- oder Schema-Ebene, und die Post-Hooks, die sich in dbt-Projekten üblicherweise für die Tabellenwartung ansammeln, können ausgemustert werden.
Für das Datenlayout ersetzt Liquid Clustering das Partitionsdesign durch ein sich selbst optimierendes Layout. Es organisiert Daten basierend darauf, wie die Tabelle tatsächlich abgefragt wird, vermeidet die Ansammlung kleiner Dateien, die bei übermäßig partitionierten Tabellen auftritt, und passt sich an, wenn sich Abfragemuster ändern. Oder lassen Sie Databricks diese Entscheidungen anhand des Abfrageverlaufs mit automatischem Liquid Clustering (CLUSTER BY AUTO) treffen und anpassen, unterstützt durch Predictive Optimization. Eine einzige Konfiguration auf Projektebene clustert jede neue Tabelle, die das Projekt erstellt.
Beide Funktionen sind als einmalige Entscheidungen konzipiert. Mit automatischen Upgrades nutzen von Unity Catalog verwaltete Tabellen fortlaufend neue Optimierungen, sobald Databricks diese bereitstellt.
4. Ordnen Sie jeden Dollar mithilfe von Query-Tags zu
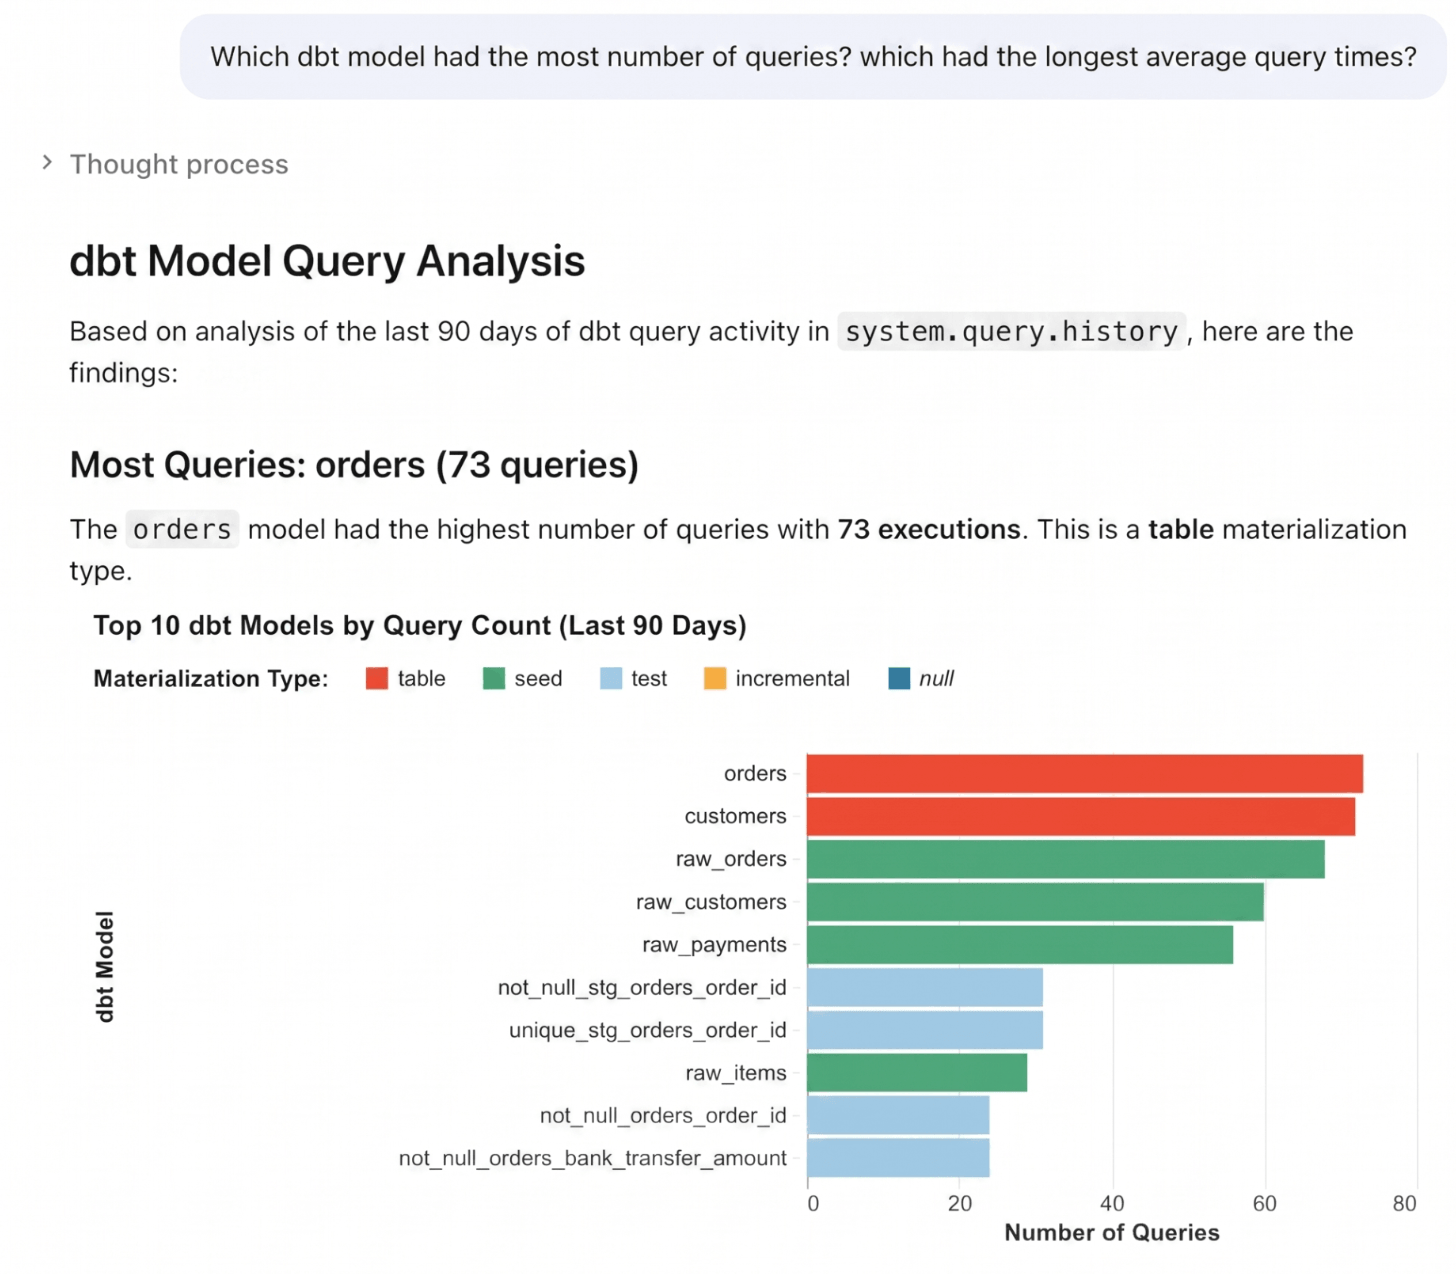
Am Ende des Quartals fragt die Finanzabteilung, warum die Rechnung für das Data Warehouse gestiegen ist. In den meisten Setups kann das niemand beantworten, da eine Abfrage in den Nutzungsdaten keine Verbindung zu dem dbt-Modell aufweist, das sie ausgelöst hat.
Query-Tags stellen die Verbindung automatisch her. Jede Abfrage, die dbt auf Databricks ausführt, wird automatisch mit dem Modellnamen, der dbt-Version und dem Materialisierungstyp versehen. Füge eigene benutzerdefinierte Tags für die Dimensionen hinzu, nach denen Ihre Organisation ihr Budget plant:
Die Tags werden in system.query.history angezeigt, und durch einen Join mit system.billing.usage können Ausgaben für Serverless Warehouses jeder von den Tags unterstützten Gruppierung zugeordnet werden: Kosten nach Modell, nach Team, nach Domain oder nach Materialisierung. Sie sehen genau, welche Modelle am meisten kosten.
Vereinfachen Sie Ihre dbt-Pipelines
Eine typische dbt-Einrichtung stützt sich auf einen Stack weiterer Tools: ein separates System für die Datenerfassung, einen externen Orchestrator zur Ausführung des Projekts, BI-Tools, die dieselben Metriken jeweils neu definieren, sowie Governance außerhalb Ihres dbt-Projekts. Jedes davon bedeutet zusätzlichen Wartungsaufwand und ein weiteres Risiko für Abweichungen. Nutzen Sie die Best Practices in diesem Abschnitt, damit ein einziges dbt-Projekt Folgendes leistet:
- Daten direkt in das Projekt erfassen
- Ausführung und Deployment direkt über Databricks, ohne externen Orchestrator
- Jedem Tool eine einheitliche, kontrollierte Metrikdefinition bereitstellen
- Eigene Governance-Regeln enthalten, die zusammen mit Ihren dbt-Modellen versioniert werden
1. Datenerfassung mit Streaming Tables in das dbt-Projekt integrieren
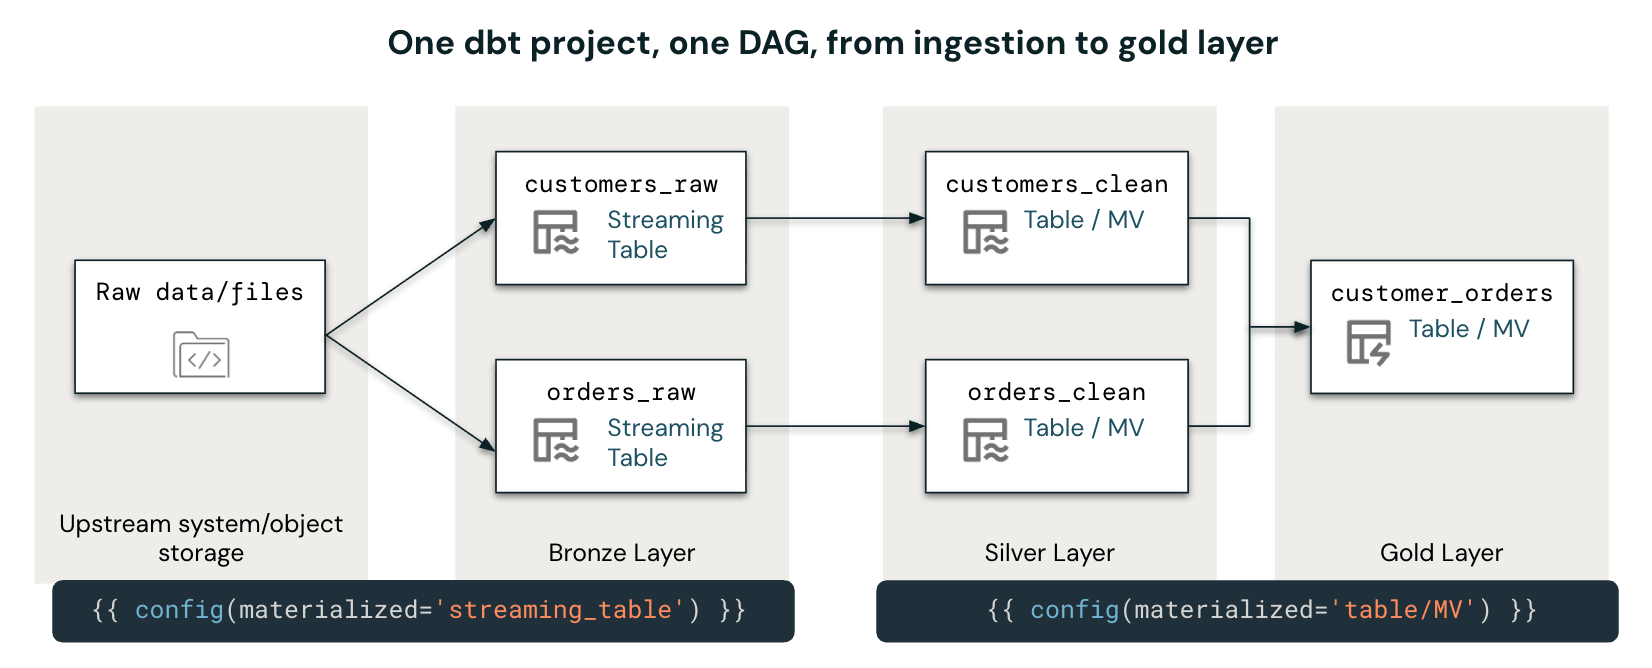
Die Datenerfassung ist der Teil der Pipeline, der traditionell außerhalb von dbt angesiedelt war. Das führte zu einer getrennten Architektur ohne zentralen Lineage-Überblick. Die streaming_table-Materialisierung hebt diese Trennung auf. Ein dbt-Modell, das als Streaming Table materialisiert wird, nimmt inkrementell neue Dateien oder Ereignisse beim Eintreffen auf. So wird die Datenerfassung zu einem weiteren Modell im DAG.
Von dort aus kann der Rest der Pipeline (Silver- und Gold-Modelle) mit ref() auf die Streaming Table verweisen. Tests und Dokumentation gelten für jede Schicht, und die Lineage deckt den gesamten Pfad von den Rohdateien bis zum finalen Mart ab.
2. Metriken mit Unity Catalog Semantics standardisieren
Jedes BI-Tool, jeder Agent und jeder andere Datenkonsument erstellt eigene Metrikdefinitionen, was zu Verwirrung und Uneinigkeit unter den Stakeholdern führt. Eine Metric View verlagert die Definition an einen zentralen, verwalteten Ort: Sie deklarieren Kennzahlen und Dimensionen einmal, und alle Konsumenten fragen dieselbe Logik ab.
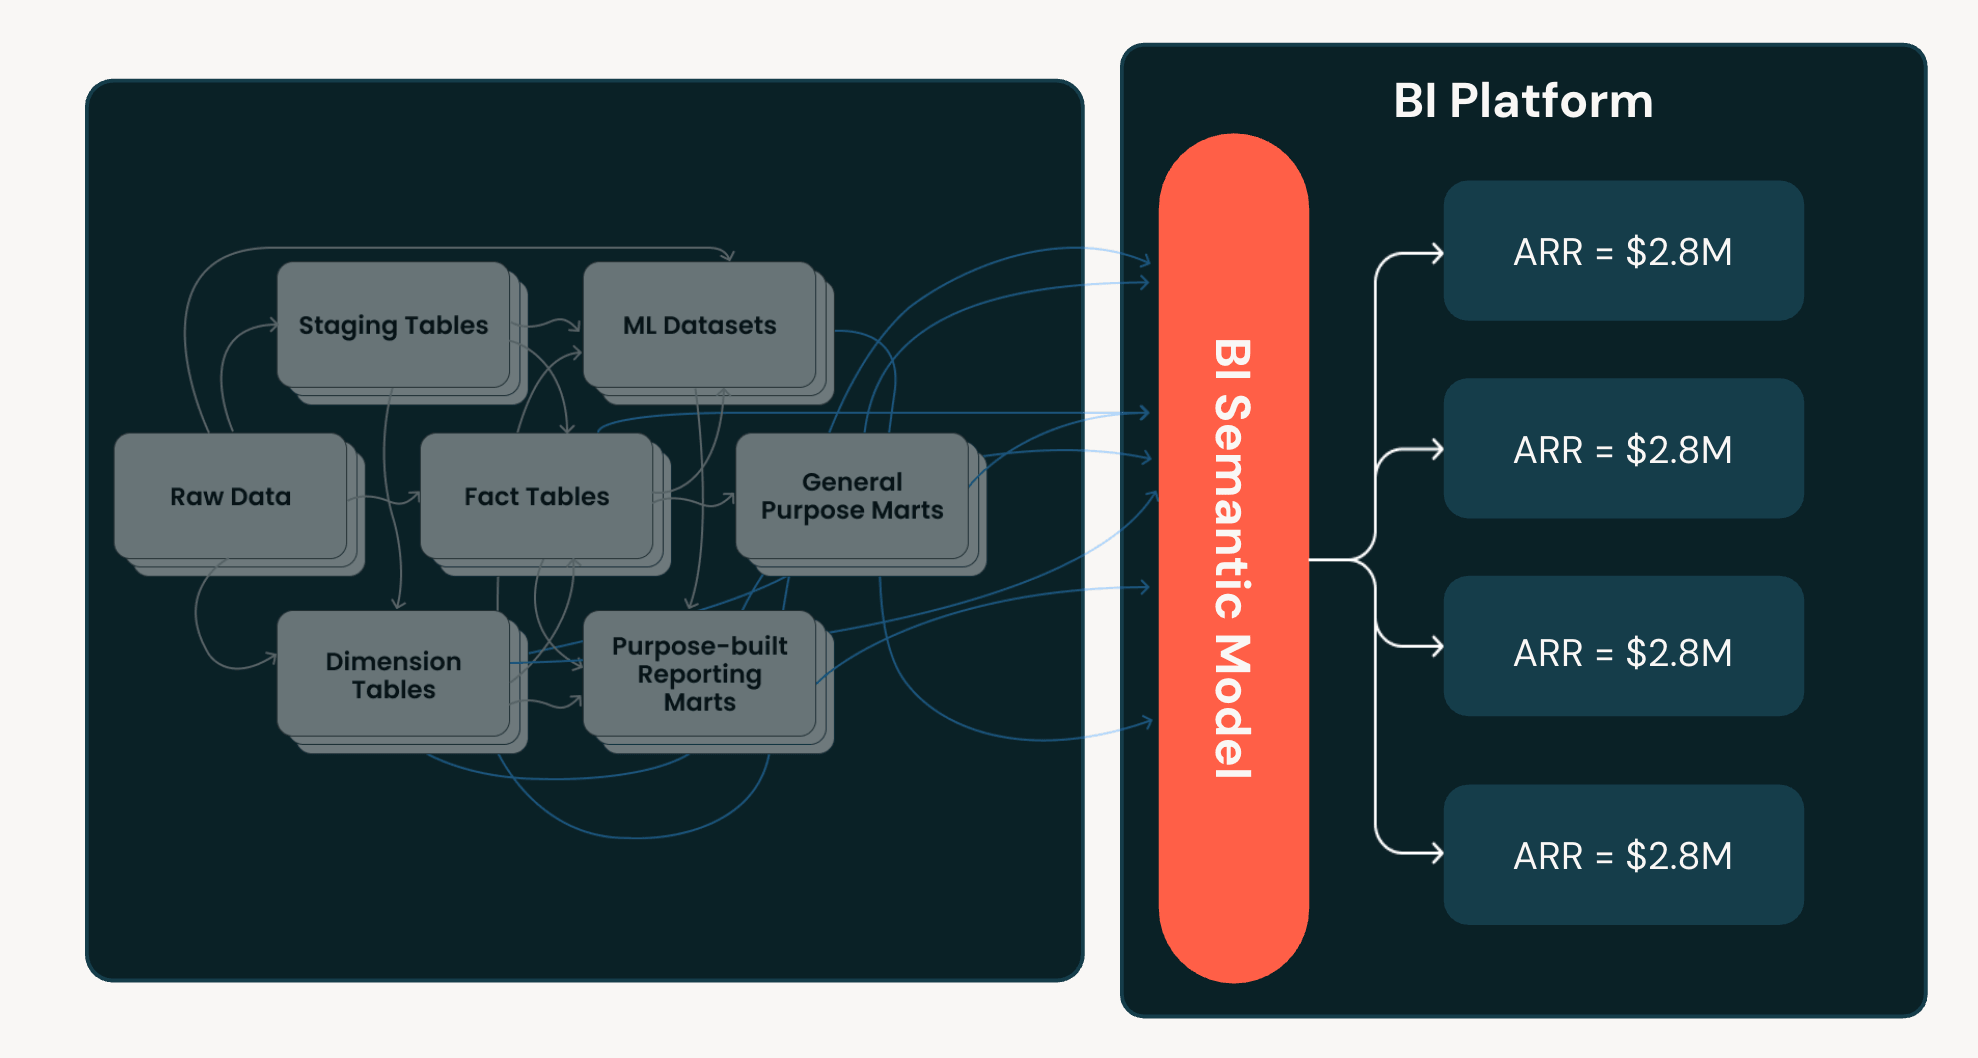
dbt-databricks stellt Metric Views als nativen Materialisierungstyp bereit, sodass die Definition direkt in Ihrem dbt-Projekt liegt – versioniert und geprüft wie jedes andere Modell.
Benutzer können bei der Abfrage über die Funktion MEASURE() eigene Gruppierungen wählen, sodass dieselbe Definition für den SQL-Editor, BI-Dashboards, Notebooks und Genie dient.
3. dbt nativ über Lakeflow Jobs orchestrieren
Ein dbt-Durchlauf deckt selten die gesamte Pipeline ab. Wenn vor- und nachgelagerte Schritte in unterschiedlichen Tools liegen, summiert sich der Aufwand: zusätzliche Tools zum Verwalten, Bezahlen und Sichern sowie eine verteilte Lineage.
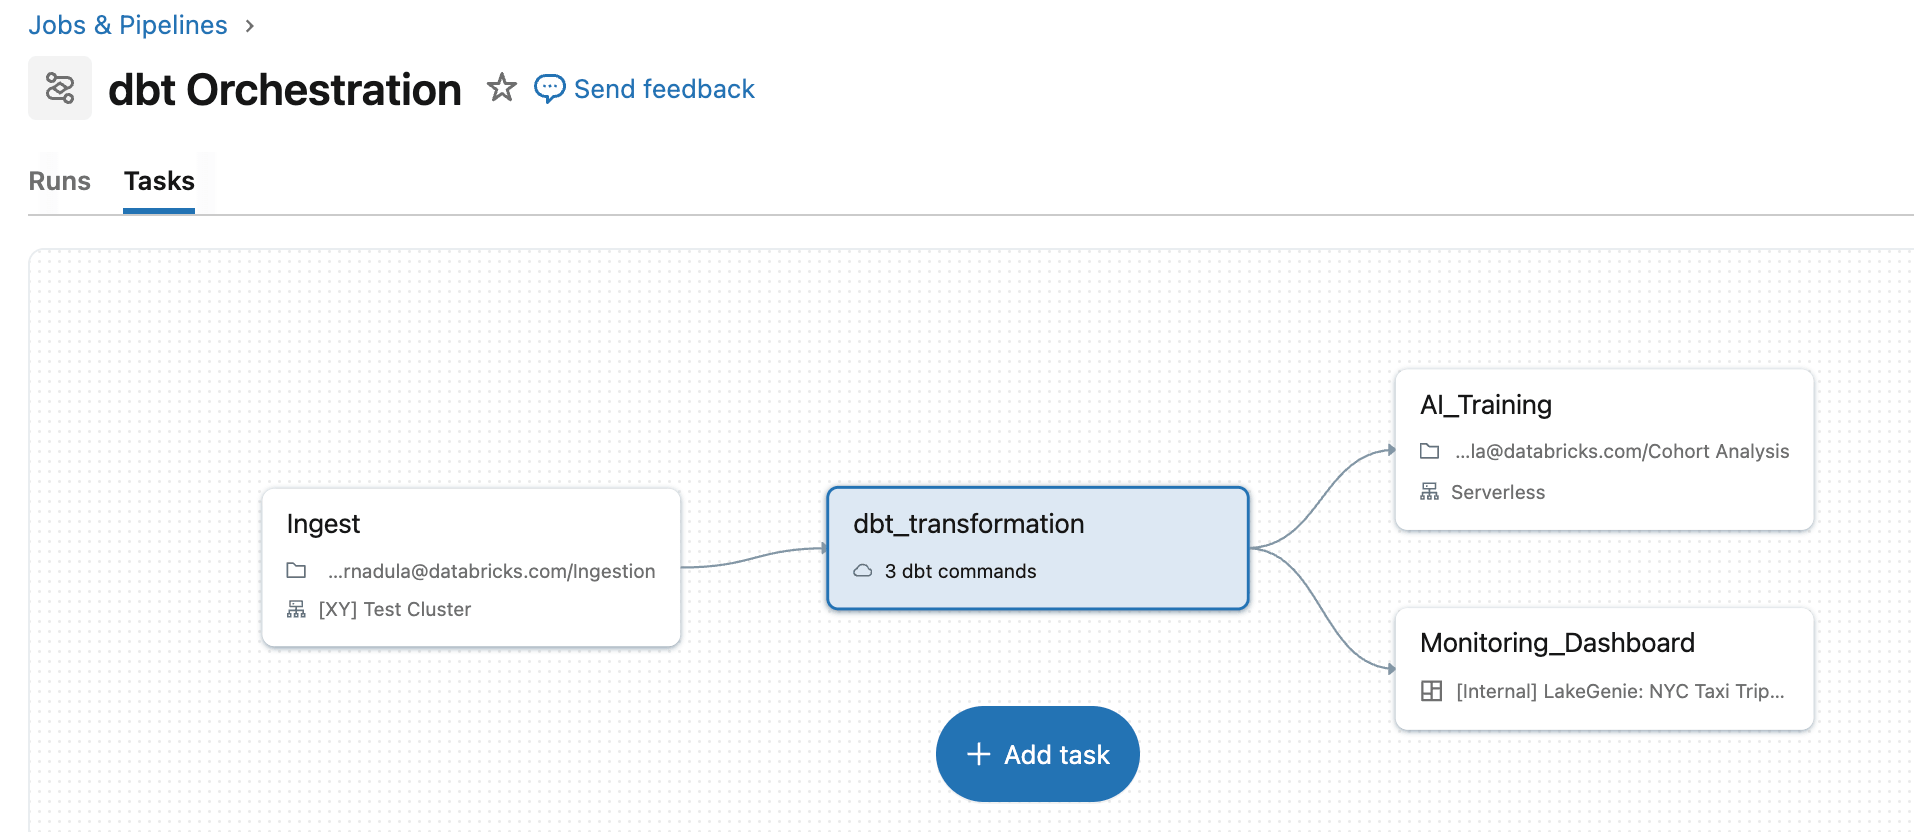
Lakeflow Jobs fasst all das in einem Directed Acyclic Graph (DAG) mit dbt als nativer Aufgabe zusammen. Eine Ingestion-Aufgabe speist die dbt-Aufgabe, und nachgelagerte Aufgaben werden nach Abschluss ausgelöst, wobei Abhängigkeiten von der Plattform durchgesetzt werden. Die operative Ebene bietet integrierte Funktionen für Zeitplanung, automatische Wiederholungsversuche, Ausführungsverlauf und Benachrichtigungen – ohne zusätzliche Infrastruktur. Jobs unterstützt dbt Core sowie dbt Platform, und die Unterstützung für dbt Core v2.0 ist in Vorbereitung.
4. Als Code mit Declarative Automation Bundles bereitstellen
Ein manuell in der Benutzeroberfläche erstellter Job lässt sich schwer versionieren, überprüfen oder reproduzieren. Declarative Automation Bundles (DABs) beheben dies, indem sie die Jobdefinition zum Bestandteil des Code-Repositorys machen: Lakeflow Job, dessen Zeitplan, Compute-Einstellungen und das dbt-Projekt werden vollständig in YAML deklariert und als einzelnes Paket bereitgestellt.
Das Deployment mit --target dev erstellt eine isolierte Kopie der gesamten Pipeline; --target prod bringt sie in die Produktion.
Nicht jedes Modell in einem Projekt muss nach jedem Zeitplan ausgeführt werden. Taggen Sie Modelle in der dbt-YAML-Datei nach Frequenz und weisen Sie jeder Frequenz einen eigenen Job zu, der nur die Modelle mit dem entsprechenden Tag baut. Die Umstellung eines Modells von täglich auf stündlich erfordert nur eine einzige Zeile:
5. Governance im Projekt definieren
Governance wird gewöhnlich erst nach dem Ausführen Ihrer Modelle konfiguriert, getrennt vom dbt-Projekt, das die Daten erstellt. Da die Governance außerhalb Ihres dbt-Projekts liegt, kann sie asynchron zu Ihren dbt-Durchläufen werden.
Definieren Sie die Governance direkt im dbt-Projekt, in dem sich die Modelle bereits befinden. Als Projektkonfiguration wird sie zusammen mit dem Code bereitgestellt, wie Code überprüft und von Unity Catalog bei jeder Abfrage durchgesetzt.
Tags, Berechtigungen (Grants) sowie Schutz auf Zeilen- und Spaltenebene können in der projektweiten Konfiguration in dbt_project.yml definiert werden. databricks_tags steuert Klassifizierung und Richtlinien, grants regelt die Lesezugriffe auf Tabellen, und row_filters sowie column_masks steuern, was der jeweilige Benutzer sieht:
In großem Maßstab eliminiert die attributbasierte Zugriffssteuerung (ABAC) Wiederholungen. Definieren Sie eine Richtlinie für ein verwaltetes Tag, und sie wendet die richtigen Zeilenfilter und Spaltenmasken auf jede Tabelle mit diesem Tag an. So ist ein neues Modell mit dem Tag pii direkt ab seiner Erstellung abgedeckt. Greifen Sie nur dann auf modellspezifische Filter und Masken zurück, wenn die Logik wirklich modellspezifisch ist, wie etwa bei einer mandantenfähigen Isolierung.
Der gemeinsame Nenner all dieser Verfahren besteht darin, operative Aufgaben an die Plattform zu übergeben: inkrementelle Verarbeitung, Datenlayout, Tabellenwartung, Durchsetzung von Governance und Orchestrierung. In Ihrem dbt-Projekt verbleibt lediglich Ihre versionskontrollierte und getestete Transformationslogik. Wählen Sie das Verfahren, das die aktuellen Herausforderungen Ihres Projekts löst, und beginnen Sie damit.
Schließen Sie sich den über 3.000 Organisationen an, die dbt bereits auf Databricks ausführen. Starten Sie mit dem dbt-databricks-Adapter.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.