MemCurrent: Entwicklung von persistentem Speicher für Produktions-Agenten
KI-Tools haben es leicht gemacht, Code-Agenten spontan zu entwickeln. Die Erstellung und Wartung eines Enterprise-Agenten in der Produktion bleibt jedoch eine deutlich größere Herausforderung. Insbesondere Entwickler sind oft gezwungen, einen Kompromiss zwischen Qualität (gute Antworten erhalten, besonders bei Long-Tail-Aufgaben) und Effizienz (Kosten und Latenz im großen Maßstab unter Kontrolle halten) einzugehen. Oft bringen Techniken Vorteile in einer Dimension auf Kosten einer anderen.
Ein Gedächtnis (Memory) ist ein vielversprechender Weg, beides gleichzeitig zu verbessern. Es kann Agenten helfen, nützlichen Kontext über Aufgaben hinweg mitzuführen, wie etwa Benutzereinstellungen, frühere Korrekturen, Metrikdefinitionen und erfolgreiche Arbeitsabläufe. Im Prinzip kann dies die Genauigkeit verbessern, wiederholte Fehler reduzieren und unnötige Neuerkundungen vermeiden. Aber mehr Verlauf bedeutet nicht zwangsläufig ein besseres Gedächtnis. Das Bereitstellen jeder vergangenen Interaktion ist kostspielig und kann veralteten, widersprüchlichen oder irrelevanten Kontext einführen. Die zentrale Herausforderung besteht darin, zu entscheiden, was aufbewahrt werden soll, wie es gepflegt wird und wie die Nützlichkeit gemessen werden kann.
In diesem Beitrag stellen wir MemCurrent vor, eine transparente und persistente Memory-Architektur für Produktions-Agenten, die jetzt das neue Agent Bricks Memory und Genie antreibt. Agenten lesen und schreiben Daten in den Speicher, während sie arbeiten, und eine Offline-„Dreaming“-Pipeline konsolidiert das Gedächtnis, um es konsistent und aktuell zu halten. In unserem internen Benchmark, der aus realistischen Unternehmensaufgaben besteht, verdreifacht MemCurrent die Erfolgsquote des Agenten im Vergleich zu Systemen ohne Gedächtnis – bei 31 % weniger Token und 26 % schnellerer Ausführung. Der Rest dieses Beitrags beschreibt, wie wir es entwickelt und evaluiert haben und was wir auf diesem Weg gelernt haben.
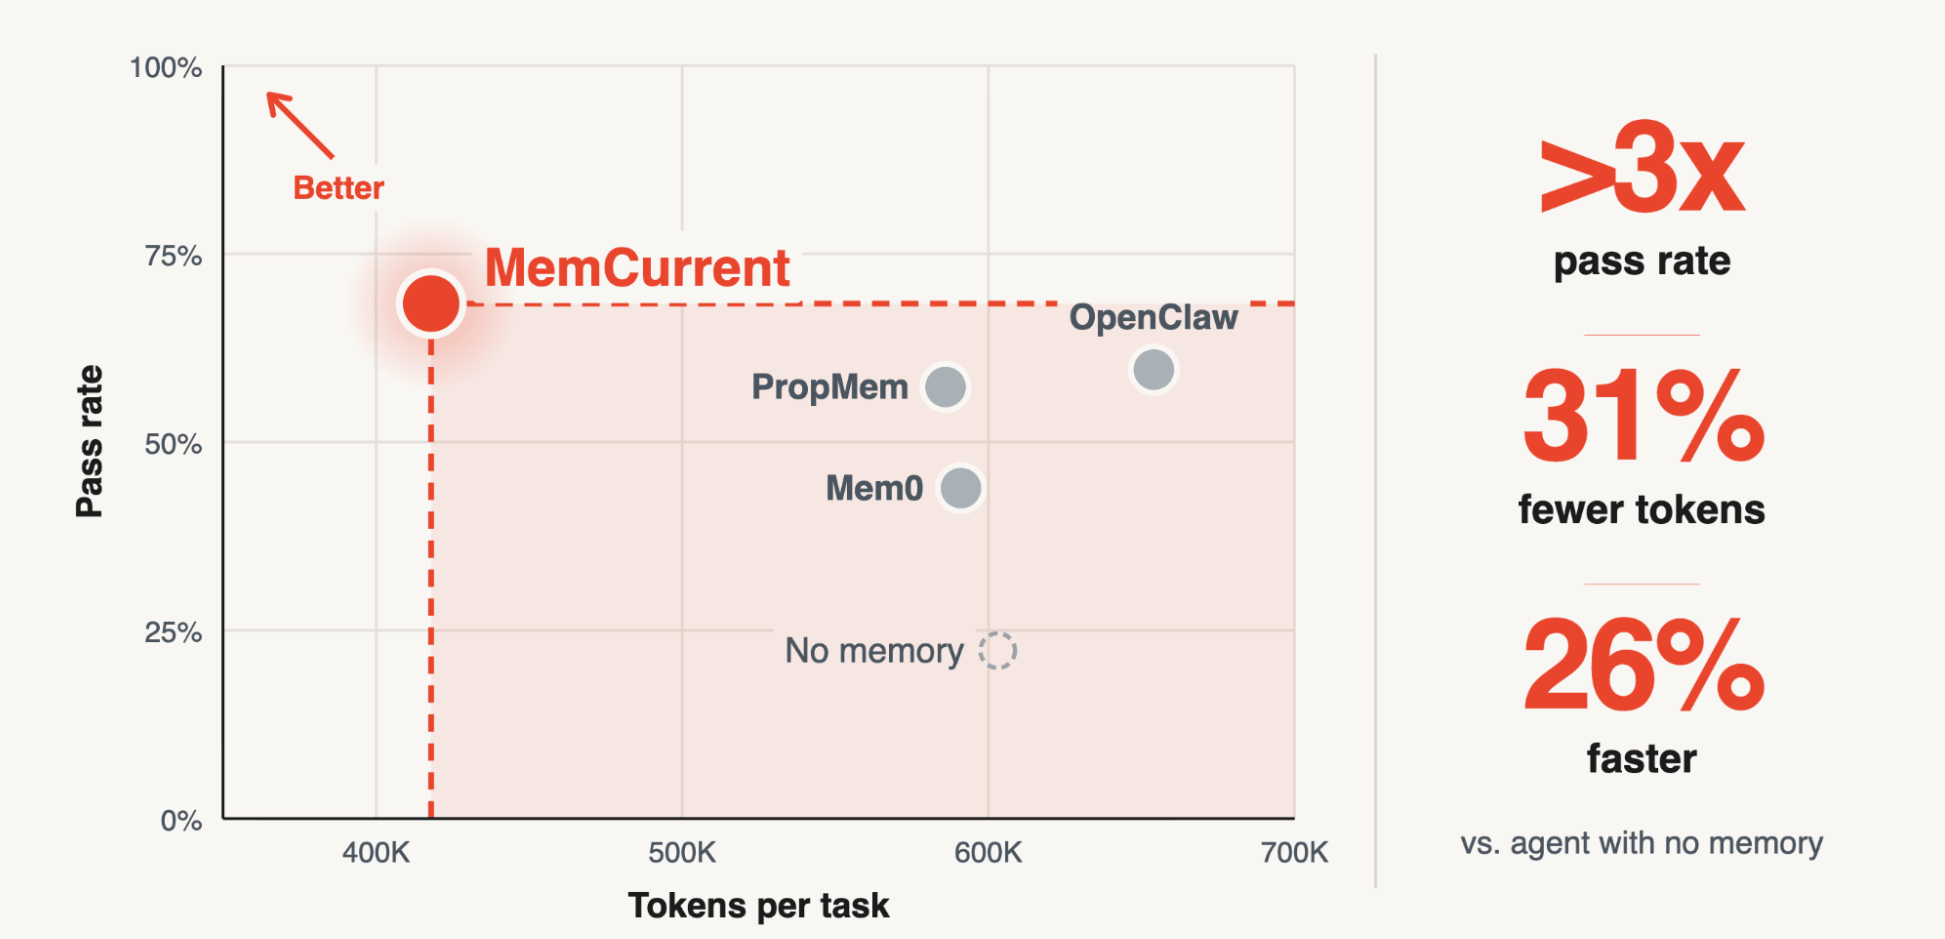
Abbildung 1: Erfolgsquote vs. Token pro Aufgabe in unserem internen Memory-Benchmark. MemCurrent liegt auf der Pareto-Front und übertrifft den Speicher von Mem0, PropMem und OpenClaw in beiden Dimensionen.
Wie wir das Gedächtnis konzipiert haben
Es gibt drei Möglichkeiten, ein Gedächtnis in einen Agenten einzubinden. Als Plugin (wie in unseren früheren Arbeiten zu MemAlign und Memory Scaling) wird der Speicher an festen Punkten in einer Sitzung automatisch gelesen und geschrieben. Als Tools entscheidet der Agent selbst, was und wann er liest und schreibt. Als Offline-Pipeline wird der Speicher im Hintergrund nach einem Zeitplan oder Auslöser aktualisiert und in späteren Sitzungen verwendet. Jedes Modell bringt Vor- und Nachteile mit sich:
Speicher als … | Ausgelöst durch | Berechnungszeitpunkt | Vorteile | Nachteile |
Plugin | Automatisch | Online |
|
|
Tool | Agent | Online |
|
|
| Pipeline | Zeitplan oder Auslöser | Offline |
|
|
Tabelle 1: Drei Zugriffsmuster auf den Speicher: Plugin, Tool oder Offline-Pipeline.
MemCurrent nutzt alle drei Ansätze, jeweils dort, wo sie am besten passen.
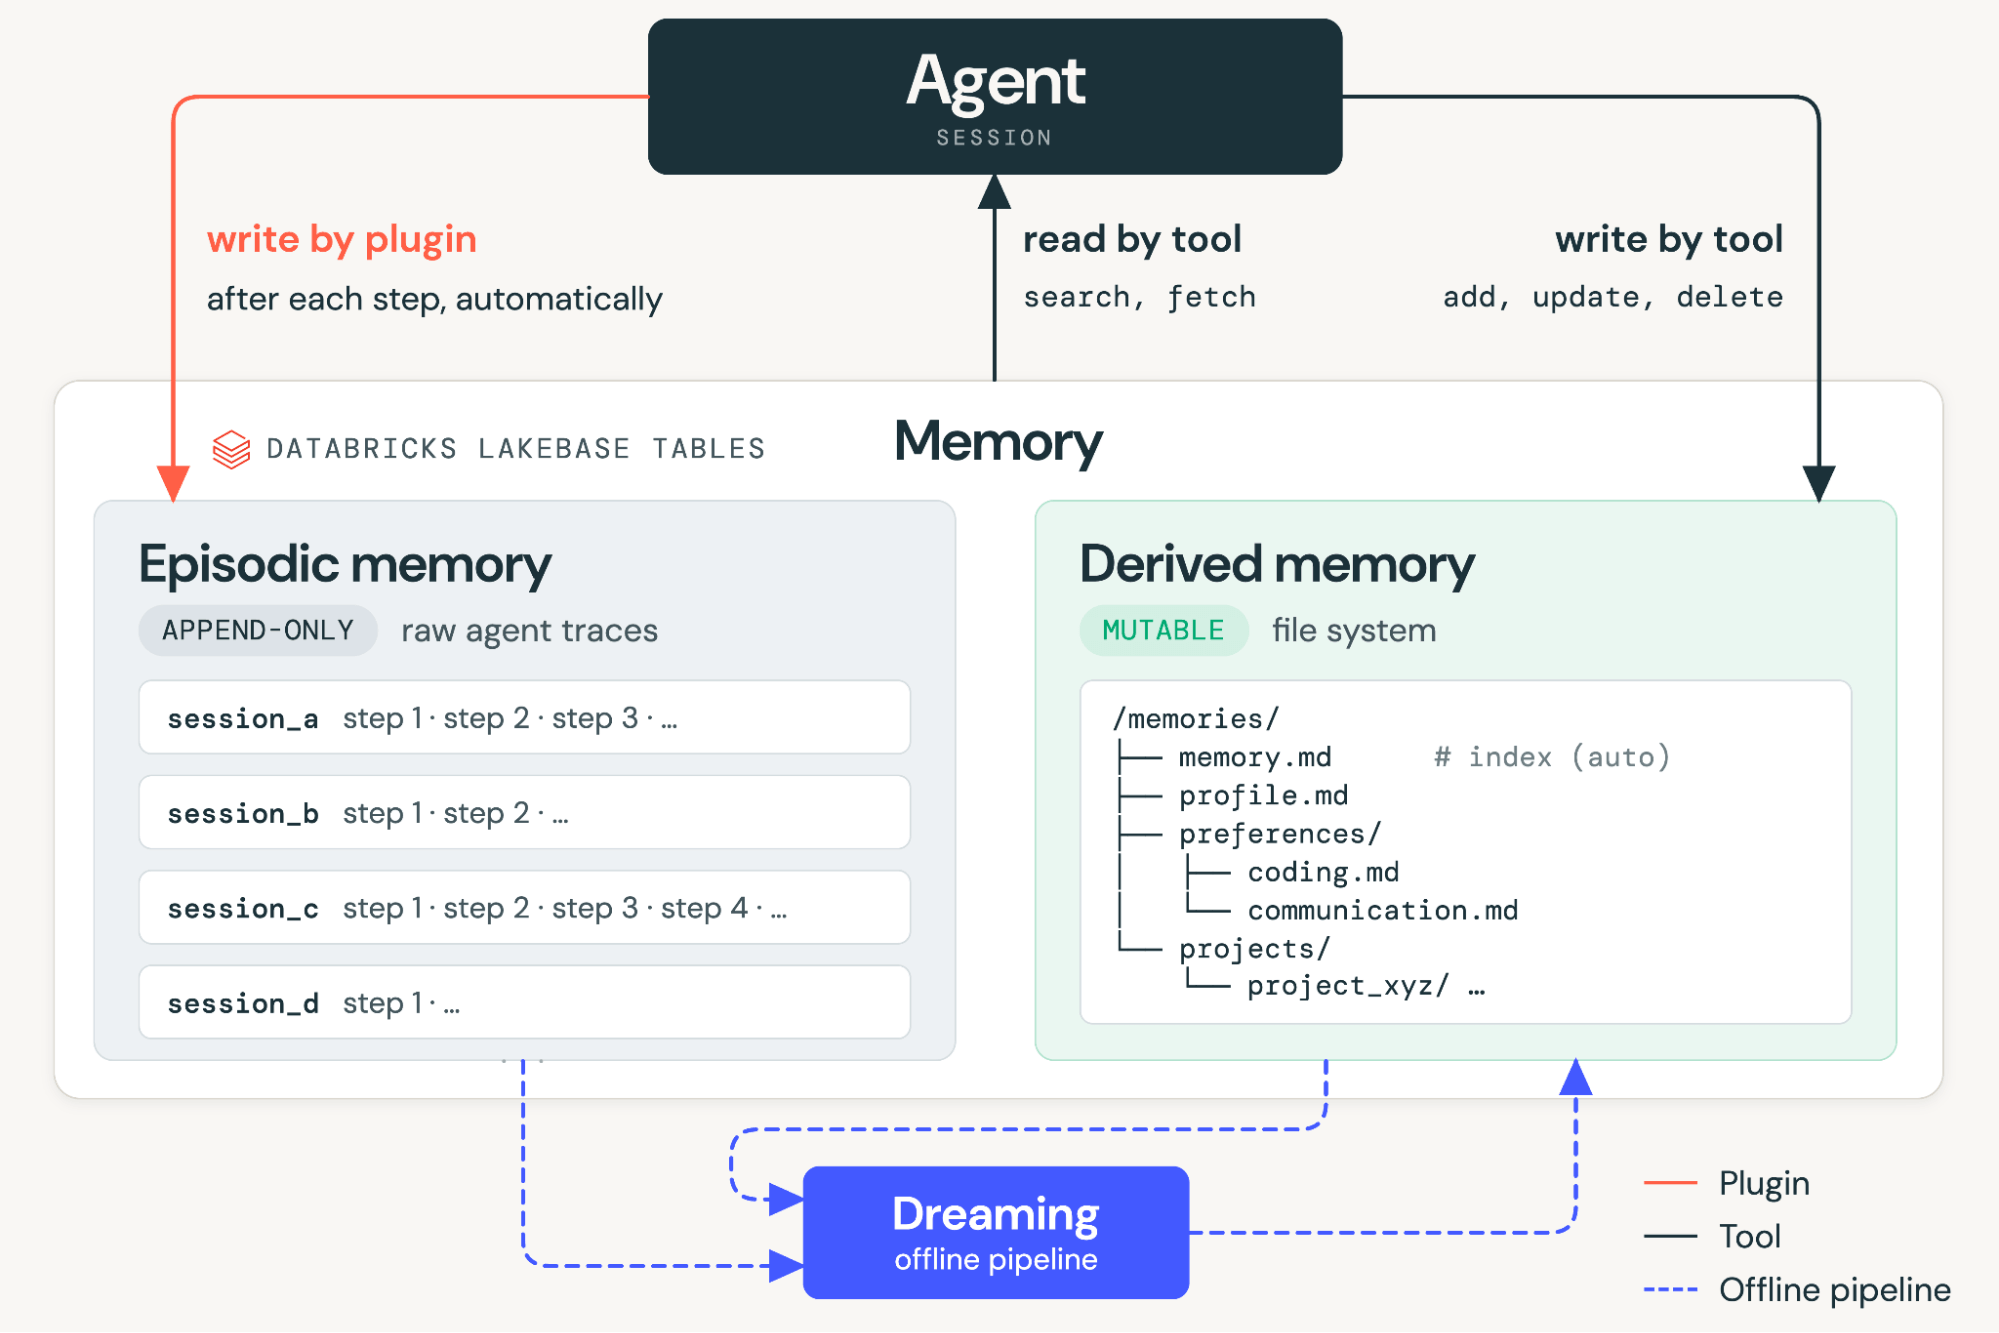
Abbildung 2: Übersicht über MemCurrent.
MemCurrent verfügt über zwei Arten von Speicher: episodischer Speicher, der rohe Sitzungsverläufe speichert; und abgeleiteter Speicher, der die destillierten Erkenntnisse aus diesen Verläufen enthält, gespeichert als Dateien in einer strukturierten Wissensdatenbank. Ein automatisch generierter Index memory.md steht an oberster Stelle und beschreibt die Dateistruktur sowie den Inhalt jeder Datei.
Sowohl der episodische als auch der abgeleitete Speicher befinden sich in einer produktionsfähigen Datenbank, die für viele Benutzer skaliert werden kann und gleichzeitig Antworten mit geringer Latenz liefert. Der episodische Speicher ist rein anfügbar (Append-only), wobei ein Plugin jeden Schritt aufzeichnet, während die Sitzung läuft. Der abgeleitete Speicher ist eine veränderbare Tabelle, die ein hierarchisches Dateisystem simuliert, bei dem das Schreiben auf zwei Arten erfolgt. Agenten-Tools (add_memory, update_memory, delete_memory) verarbeiten explizite Anfragen wie „Schreibe niemals Skripte in das Verzeichnis /tmp“. Eine Offline-Dreaming-Pipeline erfasst den Rest und destilliert implizite Erkenntnisse aus jeder neuen Sitzung in die relevanten Dateien. Sie bereinigt außerdem den gesamten Speicher, teilt zu große Dateien auf, führt Duplikate zusammen und löst Konflikte.
Das Lesen funktioniert in Schichten. Zu Beginn einer Sitzung fügt ein Plugin den Speicherindex ein, sodass der Agent bereits vor dem Start weiß, was er weiß. Während der Sitzung verfügt der Agent über zwei Tools, die über beide Speichertypen hinweg funktionieren: search_memory liefert die besten Ergebnisse für eine Suchanfrage (einen Schritt in einem früheren Verlauf oder eine Zeile in einer Speicherdatei) zurück, und fetch_memory gibt den vollständigen Eintrag nach Kennung (Sitzungs-ID oder Dateipfad) zurück.
Wie wir das Gedächtnis evaluiert haben
Benchmarks
Wir beginnen mit drei beliebten Open-Source-Benchmarks: LoCoMo, LongMemEval und ConvoMem. Alle drei testen, ob ein Agent Fakten abrufen kann, die früher in ergebnisoffenen, synthetischen Gesprächen genannt wurden.
Zusätzlich haben wir einen internen Memory-Benchmark aus echten Genie-Gesprächen erstellt, in denen Benutzer verschiedenste Fragen zu ihren Daten stellen. Wie in Abbildung 3 zu sehen ist, sind wir von über 12.000 Sitzungen ausgegangen, haben 3.000 Kandidaten mit speicherwürdigen Signalen extrahiert und eine Folgefrage mit Bewertungskriterien entworfen. Die anderen Sitzungen desselben Benutzers dienen als Füllmaterial für den Testfall. Ein gegnerischer Judge (Adversarial Judge) prüfte anschließend jeden Testfall anhand von 7 Kriterien, etwa ob das Wissen tatsächlich vorhanden, benutzerspezifisch, für die Antwort erforderlich, natürlich und überprüfbar ist. Nach einer abschließenden manuellen Überprüfung umfasst der Benchmark insgesamt 114 Testfälle mit 29 Benutzern und 2.233 vorherigen Sitzungen.
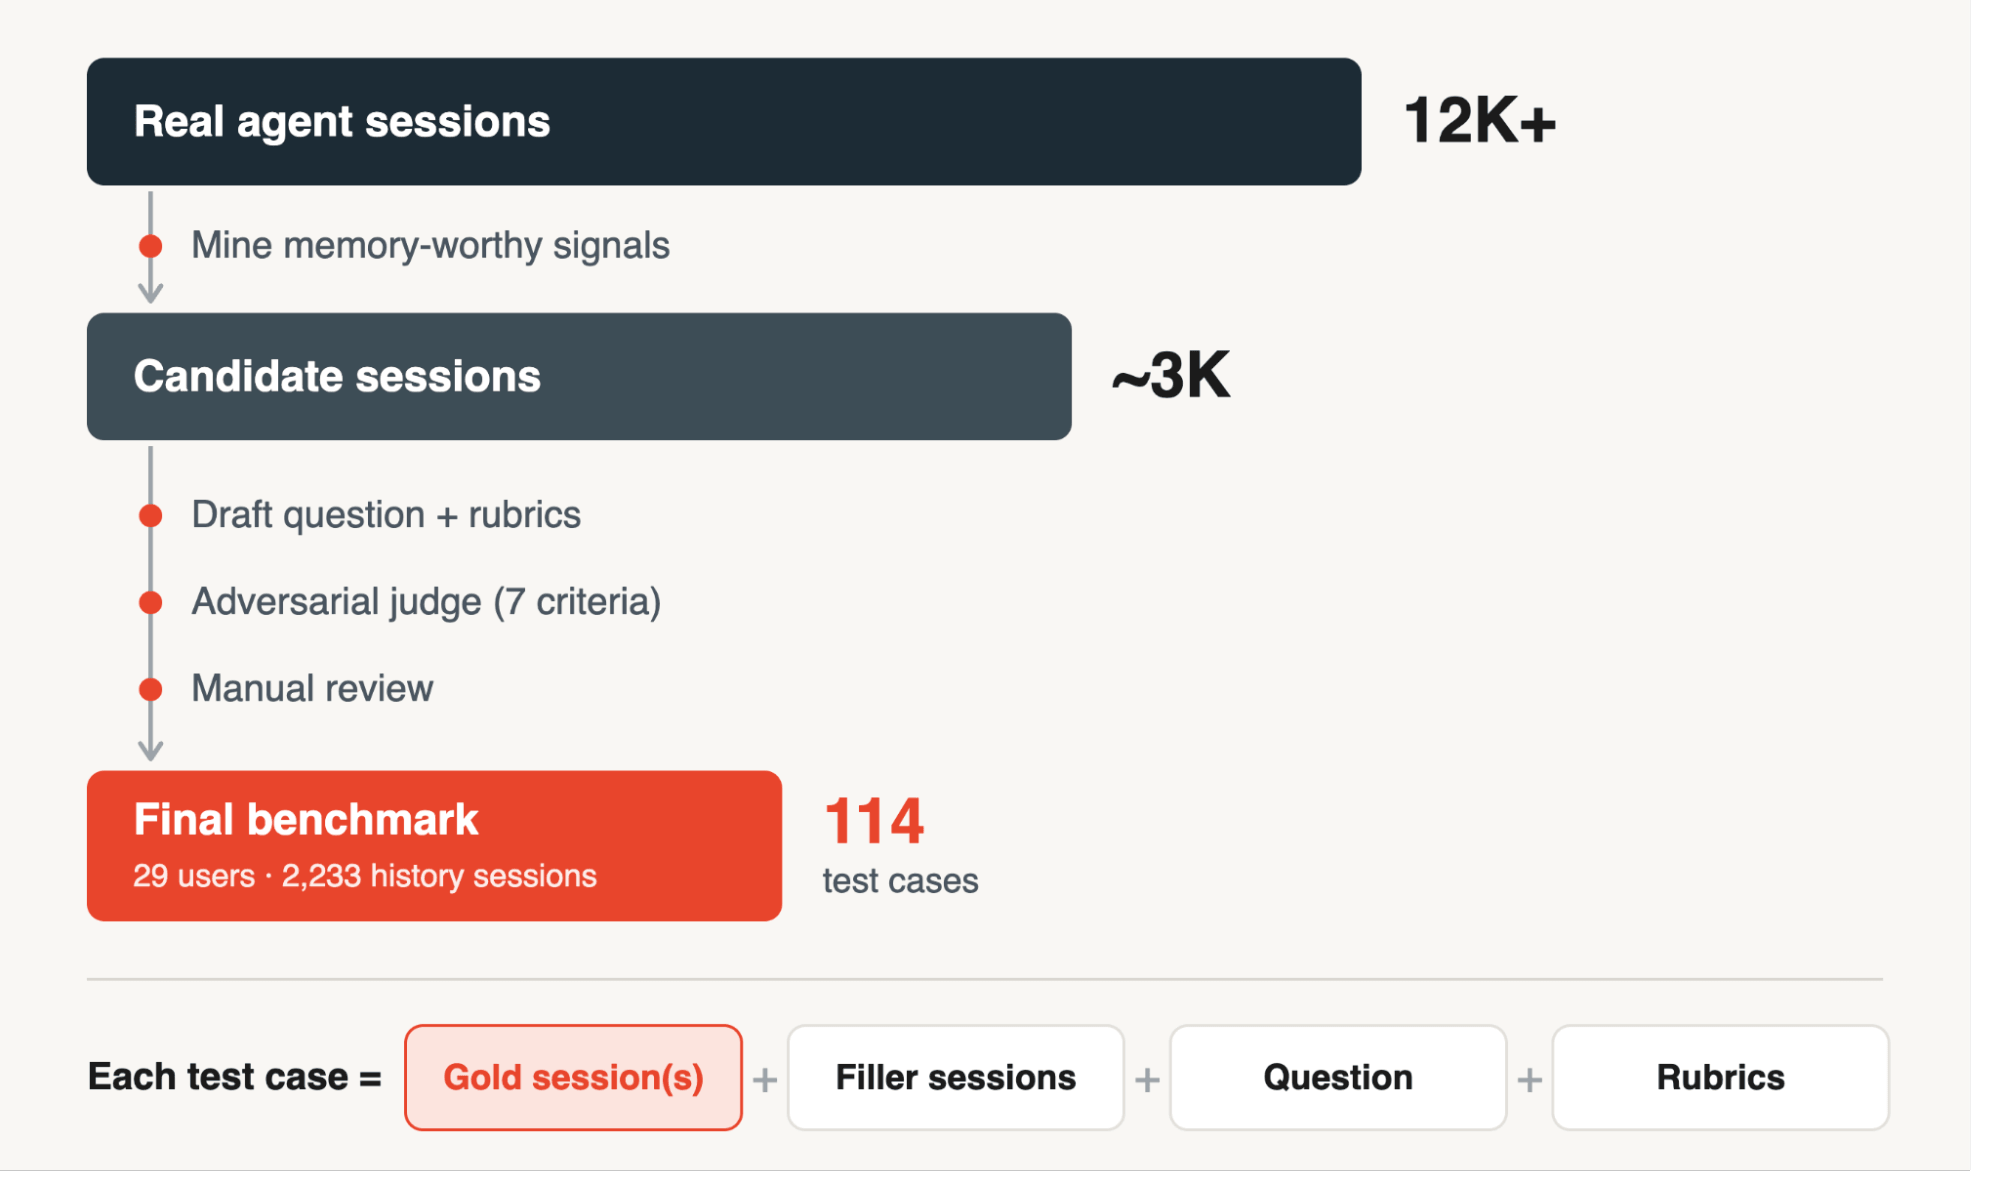
Abbildung 3: Wie wir unseren internen Memory-Benchmark aufgebaut haben.
Hier ist ein Beispiel:
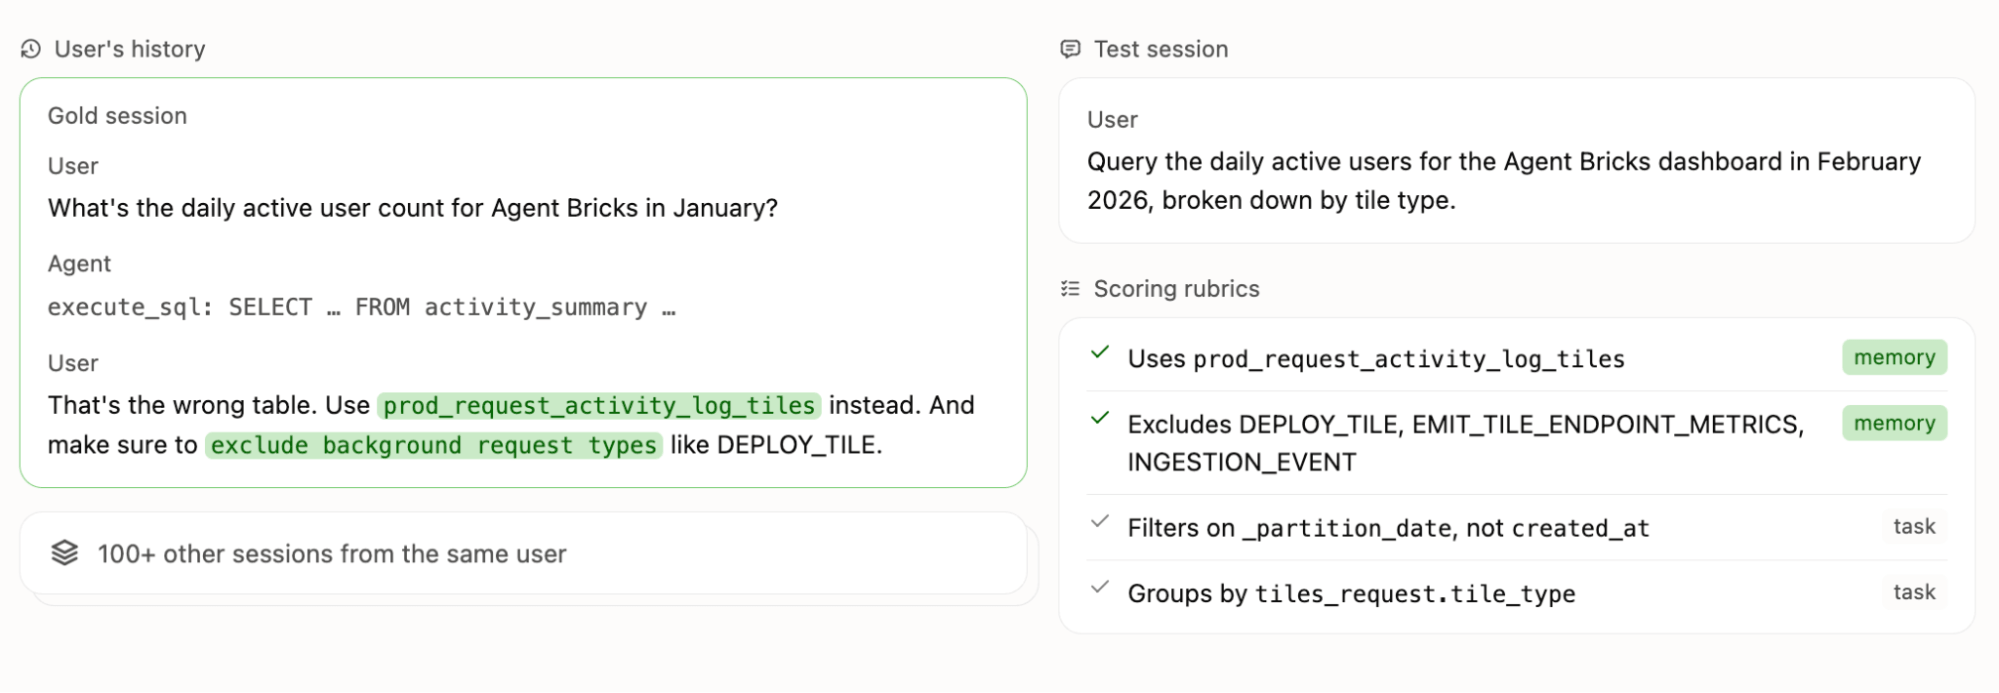
Abbildung 4: Ein Beispieltestfall aus unserem internen Memory-Benchmark. In einer früheren Sitzung korrigiert der Benutzer die Tabellenauswahl des Agenten und weist ihn an, Hintergrundanfragen auszuschließen. Später steht der Agent vor einer anderen, aber verwandten Frage und muss diese Sitzung unter mehr als 100 anderen finden und das Gelernte anwenden. Die Ausgabe wird von einem LLM-Judge basierend auf einer Liste von Kriterien bewertet (einige speicherabhängig, einige aufgabenbezogen).
Unser Benchmark unterscheidet sich in drei Punkten von bestehenden:
Unternehmensbereich. Bestehende Benchmarks sind ergebnisoffene Chats über das Leben simulierter Personen. Unserer basiert auf realer Arbeit in einem Daten-Workspace und umfasst umfassendes Unternehmenswissen wie Tabellensemantik, Metrikdefinitionen und Workflows.
Gedächtnis speist Aktionen, keine Antworten. Das Finden der richtigen Zeichenkette in vergangenen Unterhaltungen reicht nicht aus; Agenten müssen abgerufenes Wissen anwenden, um mehrstufige Aufgaben zu erledigen.
Vielfalt. Testfälle decken 5 Gedächtnistypen ab (Profil, Präferenzen, Domänenwissen, Projekte, Workflows), gekoppelt mit 11 Szenarien (direkte Anweisung, sich ändernde oder veraltete Fakten, sitzungsübergreifende Aggregation, gedächtnisunabhängige Fragen und mehr).
Ergebnisse
Wir vergleichen MemCurrent mit drei Open-Source-Gedächtnis-Backends, Mem0, PropMem, OpenClaw memory, unter Verwendung desselben zugrunde liegenden LLM.
Open-Source-Benchmarks. Wir kombinieren jedes Gedächtnis-Backend mit einem einfachen Frage-Antwort-Agenten, der mit zwei Agenten-Harnesses (LangGraph und OpenAI Agents SDK) erstellt wurde. Wir führen außerdem zwei Baselines aus: ein Minimum ohne Gedächtnis und ein Maximum mit vollständigem Kontext, bei dem jede vergangene Sitzung in den Kontext des Agenten einfließt. Über alle drei Benchmarks hinweg erzielt MemCurrent die höchste Punktzahl unter allen Gedächtnis-Backends und bleibt auf der Pareto-Grenze von Kosten und Genauigkeit. Im Durchschnitt schneidet MemCurrent (88,1 %) ebenso gut ab wie der vollständige Kontext (87,8 %) bei etwa 12-mal weniger Eingabe-Tokens pro Frage (8,4K vs. 103K). Bei den zwei Benchmarks mit den längsten Historien übertrifft es sogar den vollständigen Kontext, bei dem das Einfügen aller Daten in den Prompt den Agenten letztlich verwirrt.
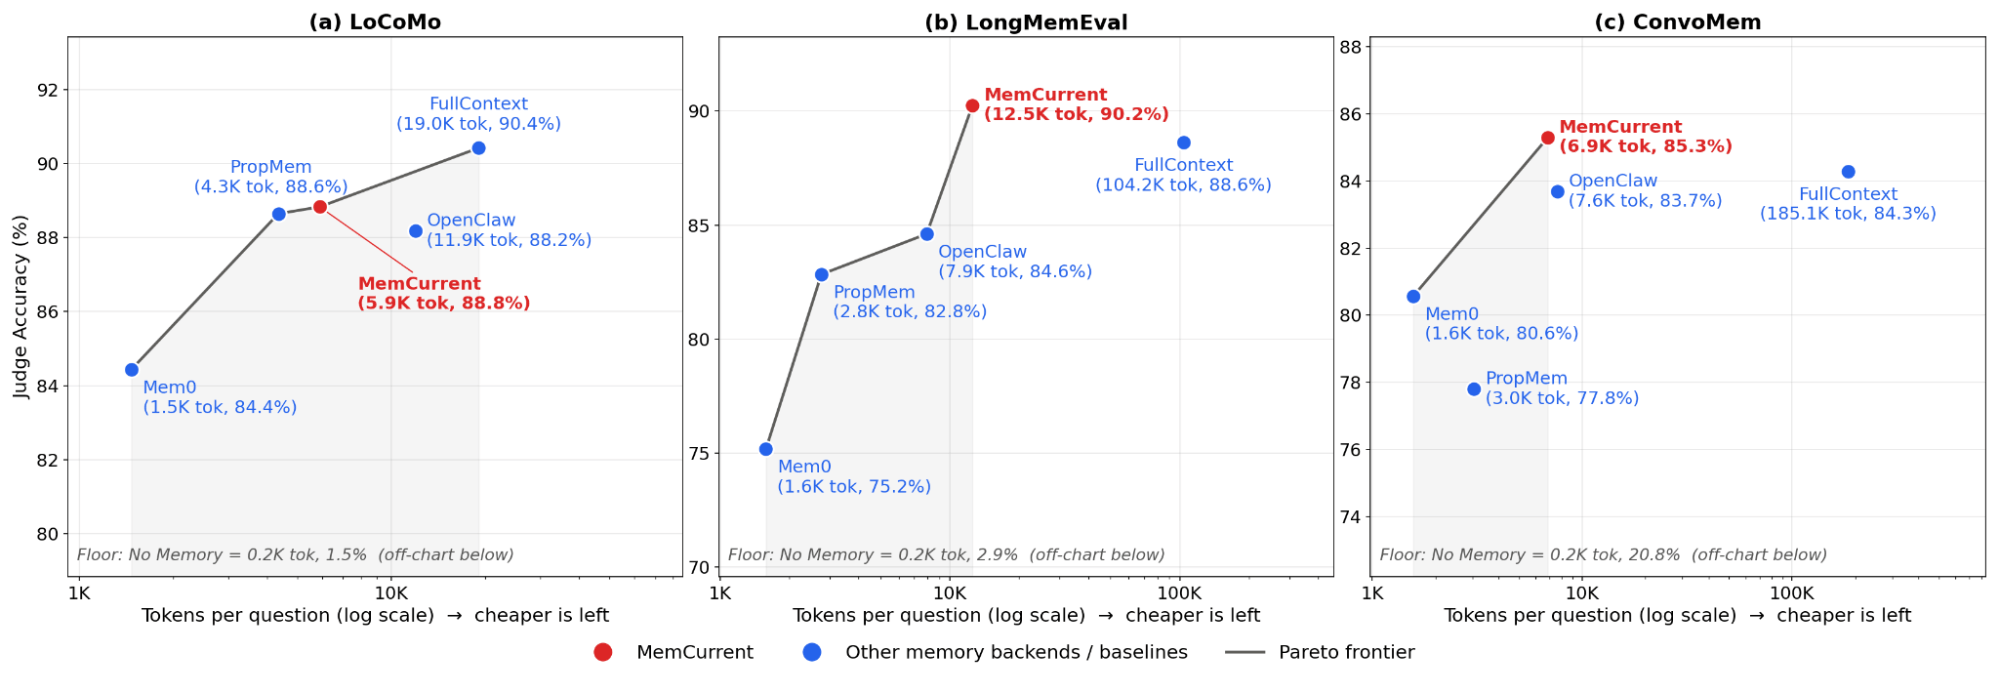
Abbildung 5. Kosten-Genauigkeits-Trade-off1 von Gedächtnis-Backends auf (a) LoCoMo (19–32 Sitzungen/Stichprobe), (b) LongMemEval (s-Split) (38–62 Sitzungen/Stichprobe) und (c) ConvoMem (stratifizierte Teilmenge von 500 Stichproben, 100 Sitzungen/Stichprobe). Wir verwenden GPT 5.6 luna als Agenten- und Gedächtnismodell. Alle Gedächtnis-Backends werden als Plugin ausgeführt, das automatisch nach für die Frage relevanten Erinnerungen sucht und diese zu Beginn der Sitzung in den Agentenkontext einfügt.2 Die Genauigkeit ist der Mittelwert über die Harnesses LangGraph und OpenAI Agents SDK sowie 3 Wiederholungen. Die Kosten sind der Mittelwert der Eingabe-Tokens pro Frage (logarithmische Skala).
Interner Gedächtnis-Benchmark. Bei unserem Benchmark vergrößert sich der Abstand. Hier läuft jedes Gedächtnis-Backend in unserem internen Genie, demselben Agenten, aus dem die Benchmark-Sitzungen stammen. Die Historien sind zu lang, um in den Kontext zu passen, sodass unsere Obergrenze die Gold-Injektion ist: Nur die optimalen Erinnerungen ("Gold-Memories") werden in den Kontext des Agenten eingefügt. Unter allen Gedächtnis-Backends weist MemCurrent die höchste Erfolgsquote (68,4 %) sowie die geringste Latenz (252 s) und den niedrigsten Token-Verbrauch (418K) auf und schließt über 80 % der Lücke zwischen keinem Gedächtnis (22,3 %) und der Gold-Injektion (78,6 %). Während Mem0 bei früheren Benchmarks ebenfalls an der Pareto-Grenze lag, liegt es hier mit 43,9 % bei höherer Latenz und höheren Kosten zurück. Im Vergleich zu keinem Gedächtnis verdreifacht MemCurrent die Erfolgsquote des Agenten (22,3 % → 68,4 %), während es ihn 1,35-mal schneller und 1,44-mal günstiger macht.
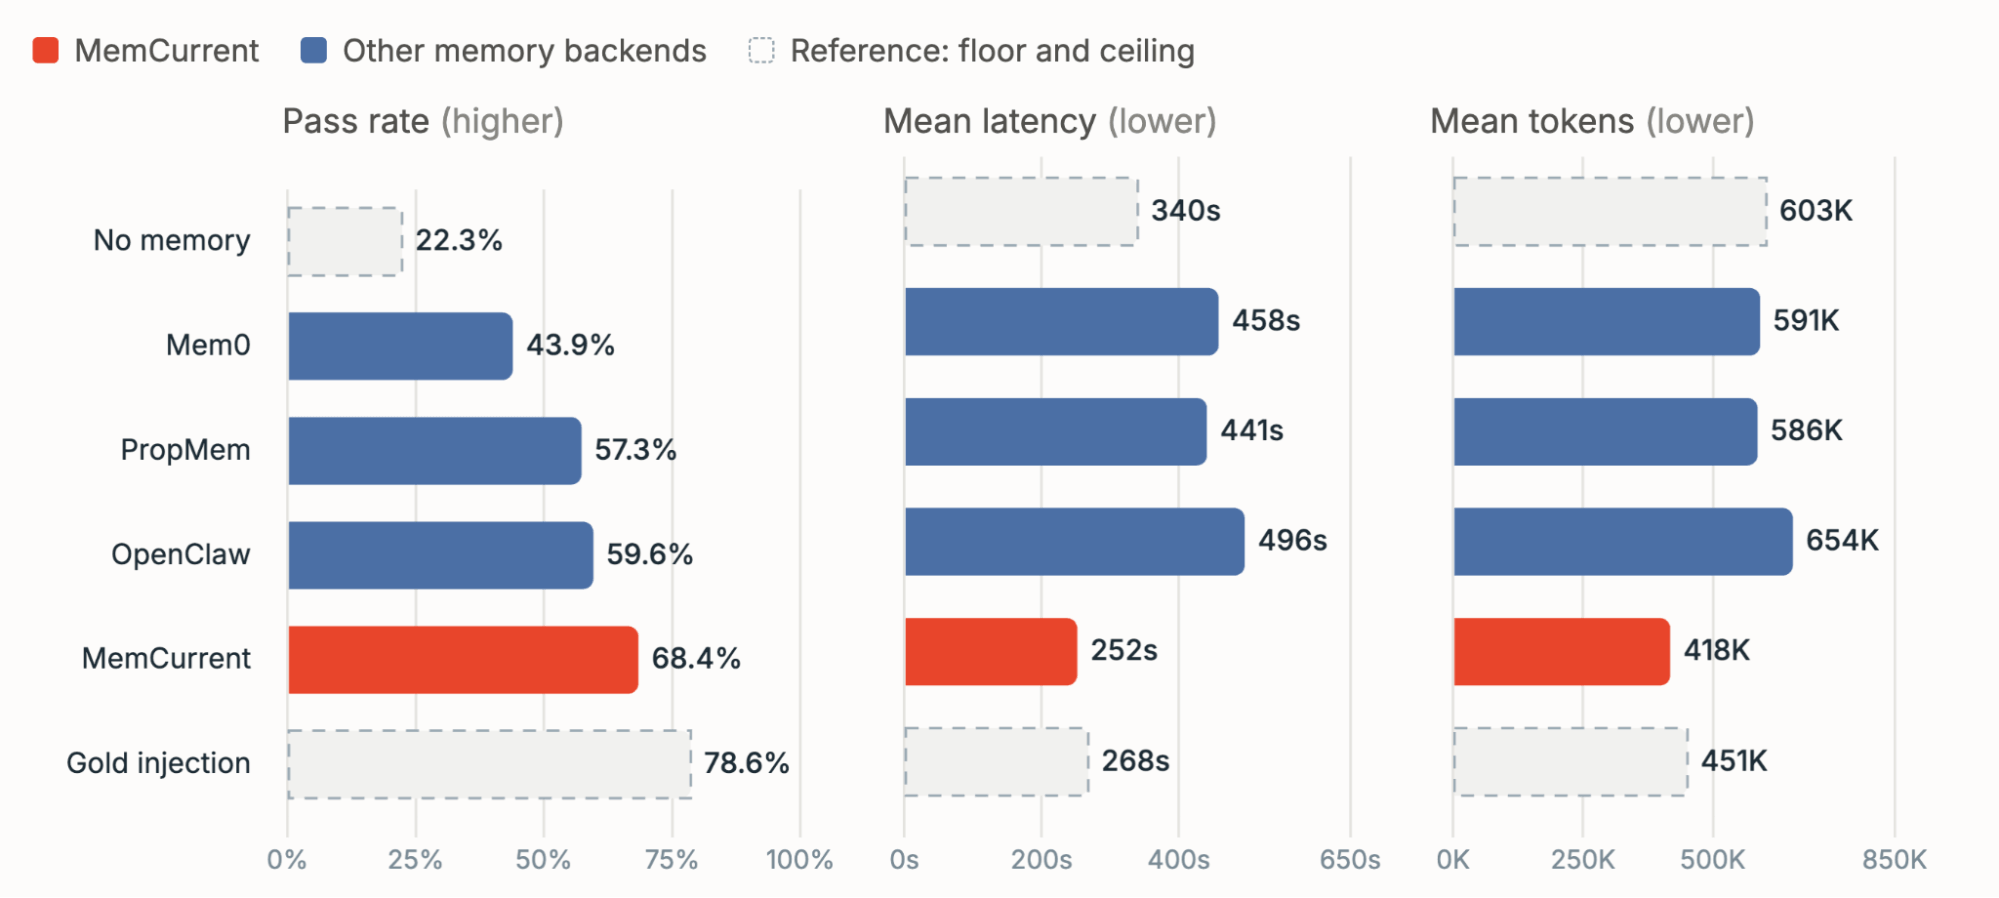
Abbildung 6. Erfolgsquote, mittlere Latenz und mittlerer Token-Verbrauch pro Aufgabe bei unserem internen Gedächtnis-Benchmark über 3 Wiederholungen. Wir verwenden Claude Opus 4.6 als Agentenmodell und GPT 5.6 sol als Gedächtnismodell. Alle Gedächtnis-Backends werden als Agenten-Tools und als Plugin zum Sitzungsstart bereitgestellt.
MemCurrent in der Praxis
Neben den Benchmark-Zahlen wollen wir anhand von zwei Beispielen aus internen Genie-Sitzungen untersuchen, wie MemCurrent in der Praxis hilft.
Beispiel 1: Das Gedächtnis verhindert gelegentliche Halluzinationsfehler. In Abbildung 7 bat ein Benutzer den Agenten um die Top 20 der Benutzer von Produkt X in den letzten zwei Monaten. Der Agent schrieb eine korrekte SQL-Abfrage, las aber nie die tatsächlichen Ausführungsergebnisse, die in einer Datei gespeichert wurden. Dennoch erzeugte er selbstbewusst eine Tabelle mit halluziniertem Inhalt. Nach dem Feedback des Benutzers speicherte der Agent die Erkenntnis im Gedächtnis. Beim nächsten Mal, als die Abfrage ausgeführt wurde, las der Agent zuerst die Ergebnisse und lieferte die richtige Tabelle zurück. Eine Gedächtniskorrektur verhinderte, dass ein einmaliger Ausrutscher zur Gewohnheit wurde.
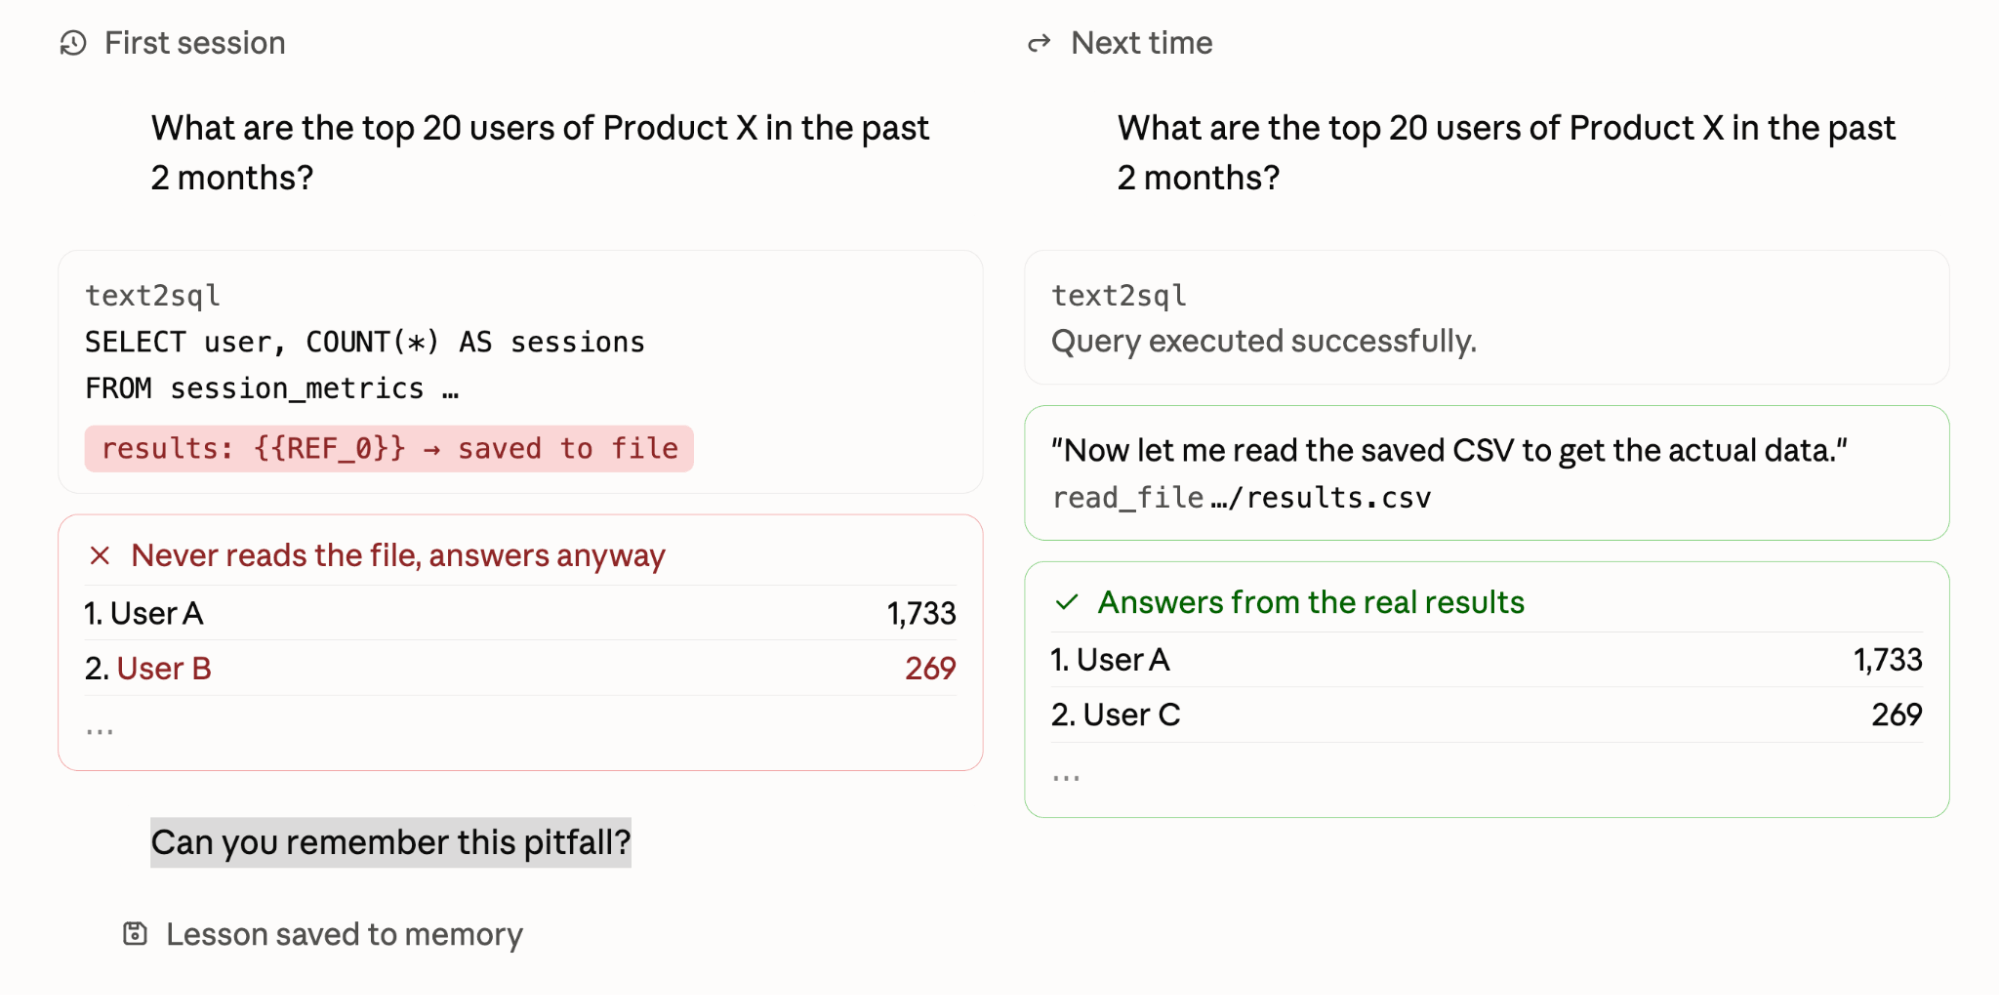
Abbildung 7. Ein anonymisiertes Beispiel dafür, wie das Gedächtnis dem Agenten hilft, einen wiederholten Halluzinationsfehler zu vermeiden.
Beispiel 2: Das Gedächtnis spart Rechenaufwand bei ähnlichen Aufgaben. In Abbildung 8 fragte ein Benutzer nach den „Top 5 SDP-Kunden“. Der Agent musste alles von Grund auf herausfinden: wofür „SDP“ steht, welche Tabellen Nutzungsdaten enthielten und wie diese verknüpft und gefiltert werden. Er benötigte 11 Tool-Aufrufe, 8 Subagenten und fast sechs Minuten. Der Agent speicherte diese Schritte als Workflow-Datei im Gedächtnis, die er bei ähnlichen Aufgaben wiederverwenden konnte. Später stellte der Benutzer eine andere Frage: Wie viele SDP-Kunden hatten im vergangenen Monat mehr als 5K Pipeline-Ausführungen. Unter Verwendung des Workflows antwortete der Agent mit 2 Tool-Aufrufen und 1 Subagenten in 41 Sekunden. Die Frage war neu, aber der Weg zur Antwort nicht, und das Gedächtnis ermöglichte es dem Agenten, unnötige Erkundungen zu überspringen.
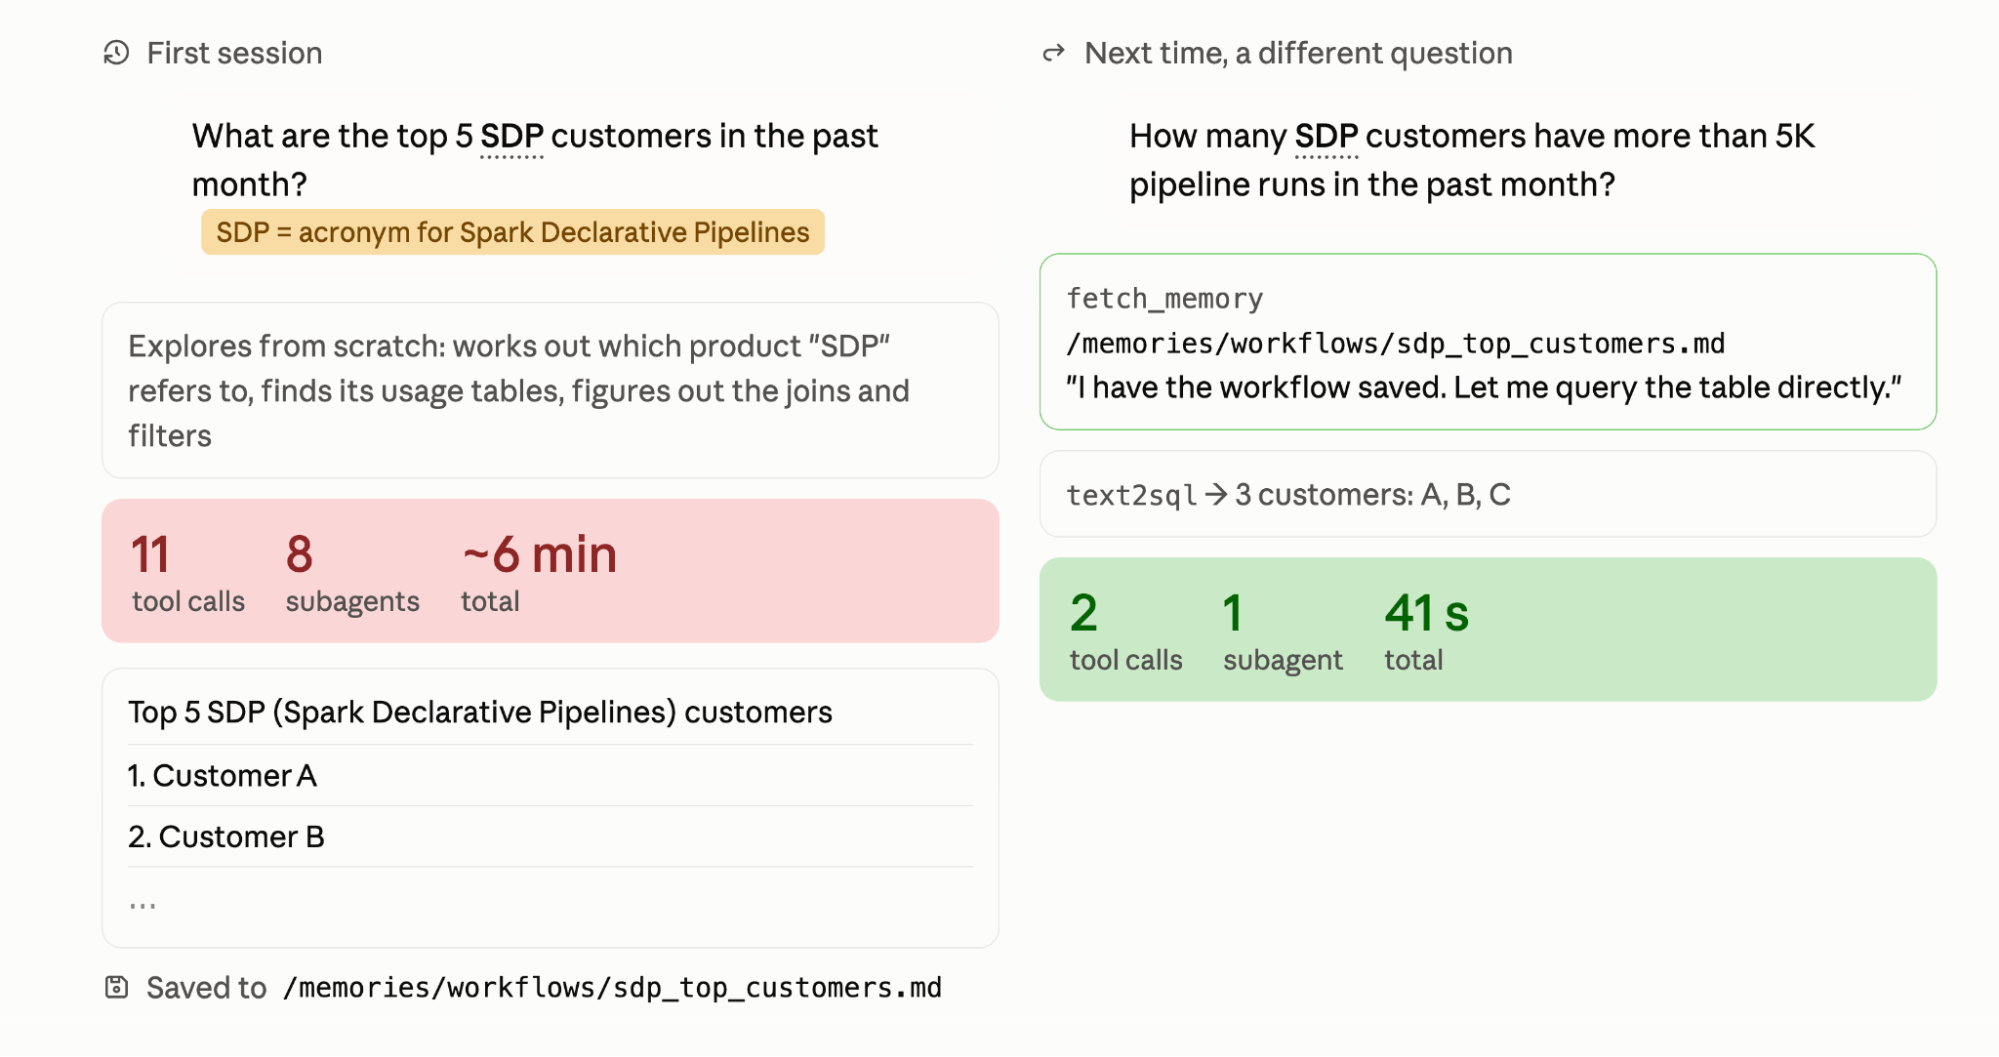
Abbildung 8. Ein anonymisiertes Beispiel dafür, wie das Gedächtnis eine 6-Minuten-Aufgabe auf 41 Sekunden verkürzt.
Warum MemCurrent funktioniert
Um zu verstehen, worauf die überlegene Leistung von MemCurrent zurückzuführen ist, haben wir bei unserem internen Gedächtnis-Benchmark Ablationen für zwei Designentscheidungen durchgeführt: Gedächtnistypen und Extraktionsstrategie.
Brauchen wir beide Gedächtnistypen? Das episodische Gedächtnis allein hilft mäßig: 35,8 %, verglichen mit 22,3 % ohne Gedächtnis. Die unveränderte Historie ist nützlich, aber der Agent durchsucht sie nur in etwa einem Drittel der Testfälle, bestand davon dann jedoch 60 %. Das abgeleitete Gedächtnis vermeidet dieses Problem, da der eingefügte Gedächtnisindex zu Beginn der Sitzung dem Agenten Informationen darüber gibt, was im Gedächtnis verfügbar ist und wann er suchen muss, was die Erfolgsquote auf 66,1 % anhebt. Die zusätzliche Ergänzung um das episodische Gedächtnis liefert das beste Ergebnis von 68,4 %. Der Gewinn ist klein, deutet jedoch darauf hin, dass Rohdaten Details wiederherstellen können, die bei der Destillation verloren gehen.
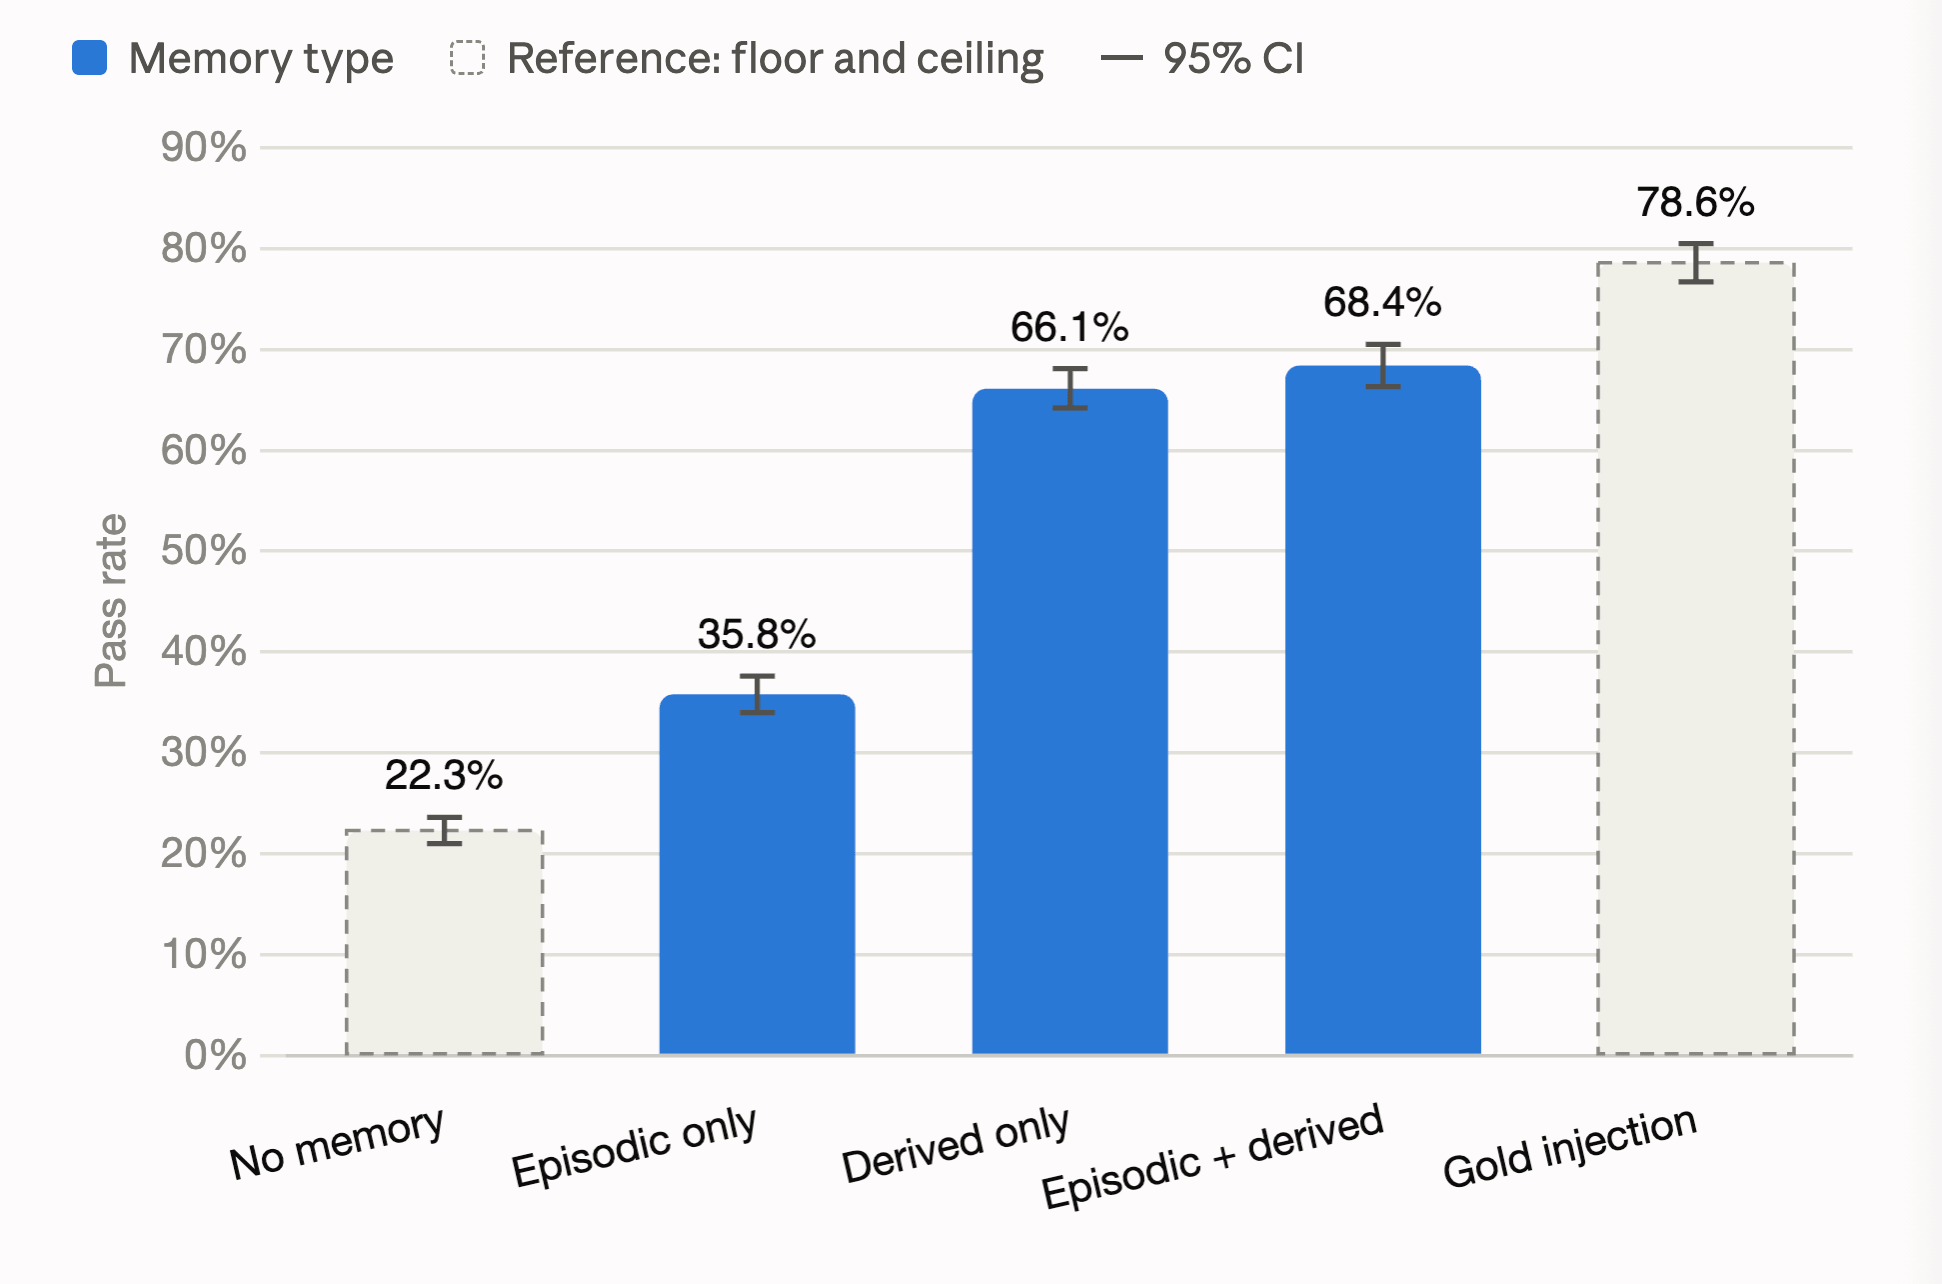
Abbildung 9. Erfolgsquote nach Gedächtnistyp.
Was ist eine gute Strategie zur Gedächtnisextraktion? Wie in Abbildung 2 gezeigt, extrahieren zwei Kanäle das abgeleitete Gedächtnis: Online-Tools und Offline-Dreaming. Isoliert betrachtet schlägt Offline-Dreaming (63,5 %) Online-Tools (53,9 %) um fast 10 Punkte. Ihre Kombination erzielt mit 66,1 % die höchste Erfolgsquote. Das spricht für eine Aufgabenteilung: Dreaming übernimmt die Extraktion und Konsolidierung im Hintergrund, während Online-Tools dafür sorgen, dass explizite Anfragen sofort wirksam werden.
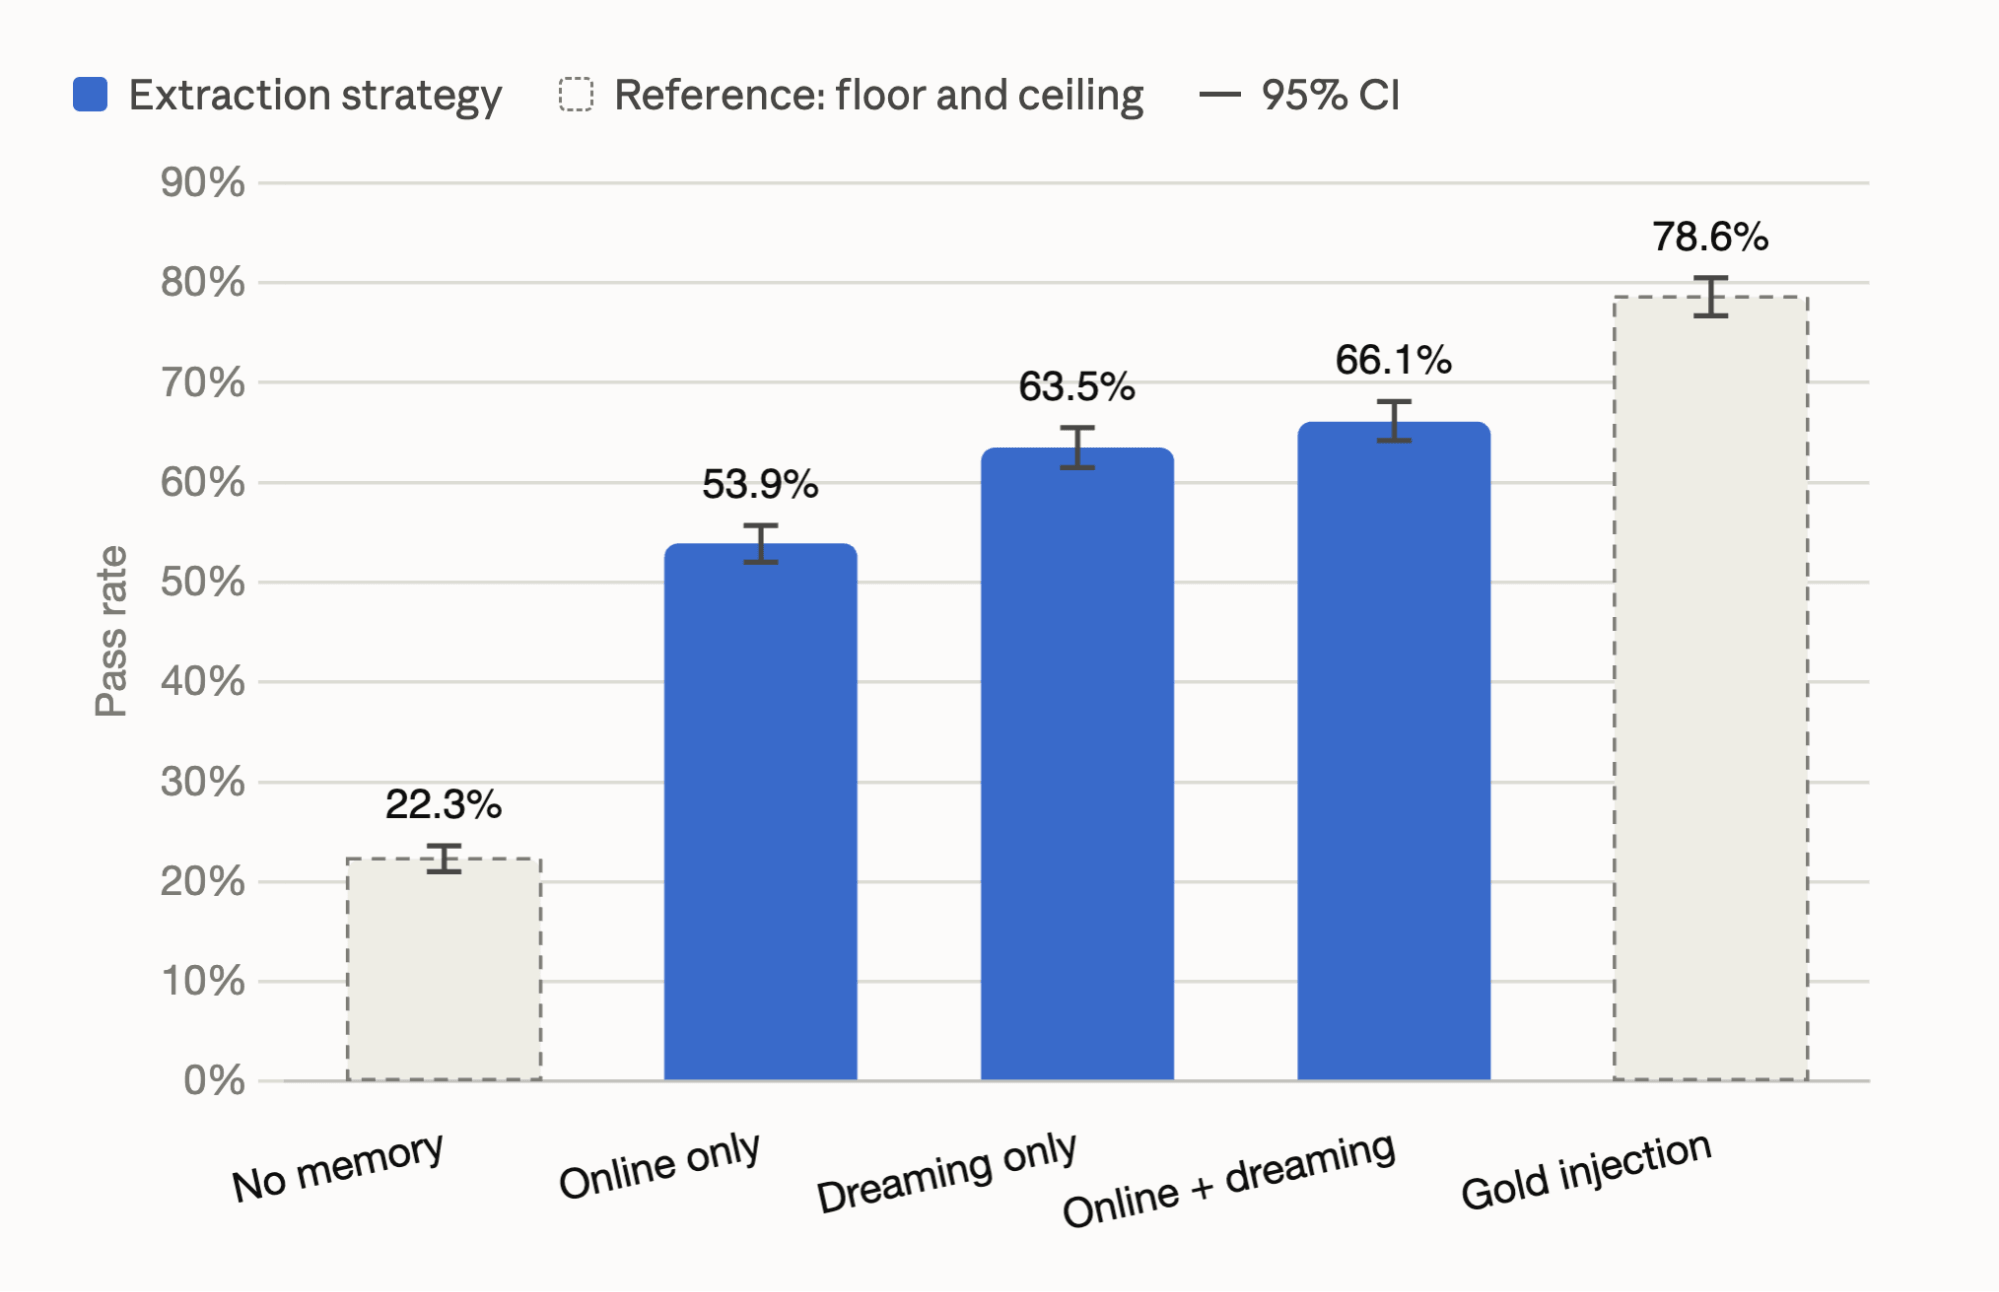
Abbildung 10. Erfolgsquote nach Extraktionsstrategie.
Fazit
Gedächtnis ist die Art und Weise, wie ein Agent aufhört, immer wieder bei Null anzufangen. In diesem Beitrag haben wir MemCurrent vorgestellt, eine Gedächtnisarchitektur für Produktionsagenten, die episodisches Gedächtnis und abgeleitetes Gedächtnis mit drei Zugriffsmustern kombiniert: Plugins zum automatischen Protokollieren und Laden des Kontexts, Tools, die der Agent bei Bedarf aufruft, und eine Offline-Dreaming-Pipeline, die das Gedächtnis im Hintergrund konsolidiert.
Über alle von uns durchgeführten Benchmarks hinweg verbessert MemCurrent gleichzeitig Qualität und Effizienz – genau den Zielkonflikt, den wir überwinden wollten. Bei Open-Source-Benchmarks erreicht es die Leistung des vollständigen Kontexts bei etwa 12-mal weniger Eingabe-Tokens. Bei unserem internen Gedächtnis-Benchmark, der auf realer Datenarbeit basiert, verdreifacht es die Erfolgsquote des Agenten im Vergleich zu keinem Gedächtnis und macht ihn gleichzeitig schneller und günstiger.
Die Ablationen zeigen, woher der Mehrwert stammt. Das abgeleitete Gedächtnis leistet den Großteil der Arbeit, und das episodische Gedächtnis sorgt für einen kleineren Schub, indem es Details wiederherstellt, die bei der Destillation verloren gehen. Die Kombination von Online-Tools mit Offline-Dreaming ergibt die beste Extraktionsstrategie: Explizite Anfragen werden sofort wirksam, während Dreaming implizite Erkenntnisse destilliert und den Speicher im Hintergrund konsolidiert.
Über die Zahlen hinaus bietet das Gedächtnis eine Wissensbasis, die nicht an einen einzelnen Agenten oder ein einzelnes LLM gebunden ist. Es kann mit Benutzern zu neuen Agenten oder LLMs mitwandern und als Basis für Wissen dienen, das in der gesamten Organisation geteilt wird – eine Richtung, die wir als Nächstes erkunden.
Erste Schritte
Wir nutzen diese Erkenntnisse, um Verbesserungen in allen Databricks-Produkten voranzutreiben:
Für Agenten-Entwickler. Agent Bricks ist die Entwicklerplattform von Databricks zur Erstellung benutzerdefinierter Agenten. MemCurrent ist in das Memory-Angebot von Agent Bricks integriert und basiert auf Lakebase. Das Angebot umfasst:
- Session-Speicher für episodisches Gedächtnis
- Memory-Speicher für abgeleitetes Gedächtnis
- Eine automatische Dreaming-Pipeline
- Tracing und Evaluierung der Agentenqualität, einschließlich der Auswirkungen des Gedächtnisses
- Ein CLI, das Ihnen hilft, in <10 Minuten schnell mit einem End-to-End-Beispielagenten inklusive aller oben genannten Funktionen zu starten
Legen Sie los und erstellen Sie noch heute Ihren benutzerdefinierten Agenten.
Für Databricks Genie-Benutzer. Genie ist eine Schnittstelle, über die Databricks-Benutzer in natürlicher Sprache mit ihren Daten kommunizieren können. MemCurrent ist bereits hinter den Kulissen im Einsatz und hilft dabei, die Antwortqualität zu verbessern und gleichzeitig Antwortlatenz und Kosten zu reduzieren.
Erste Schritte mit Genie.
Autoren: Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen
Wir danken Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu und den Teilnehmern unserer internen Nutzerstudie für ihr Feedback und ihre Unterstützung während dieses gesamten Projekts.
1 Die Latenz ist über alle Memory-Backends hinweg ähnlich (4-7s/Frage), da die meisten Fragen innerhalb eines einzigen Hops beantwortet werden können.
2 Wir halten plugin-basiertes Gedächtnis für die bestehenden Benchmarks für ausreichend. Ergebnisse durch das Hinzufügen von Tools werden strikt dominiert und daher weggelassen.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.