Worauf Sie bei einem verwalteten Postgres-Dienst achten sollten: Eine Checkliste für technische Einkäufer
Traditionelles, verwaltetes Postgres glänzt bei transaktionalen Workloads, schwächelt jedoch bei Analyseabfragen – und die meisten Checklisten zur Evaluierung übersehen diese Lücke. Wenn Sie Postgres als hybride transaktional-analytische Engine...
- Ein verwalteter Postgres-Dienst sollte danach bewertet werden, was er bei Ausfall, Wiederherstellung und unter Produktionslast leisten kann, und nicht nur nach den angepriesenen Funktionen.
- Zu den wichtigsten Prüfpunkten gehören Hochverfügbarkeit, Notfallwiederherstellung, PostgreSQL-Kompatibilität, Sicherheit, Skalierung, Gesamtkosten, operative Kontrolle und Portabilität.
- Ein Produktions-Workflow sollte die Versprechungen des Anbieters durch Failover-, Point-in-Time-Recovery-, Last- und Migrationstests überprüfen, bevor der Dienst übernommen wird.
- Lakebase Postgres bietet verwaltetes, serverloses Postgres mit automatischer Hochverfügbarkeit, Autoscaling sowie Sicherheits- und Governance-Funktionen von Databricks.
Managed ist eine Bezeichnung, keine Spezifikation. Bewerten Sie einen verwalteten Clouddatenbank-Dienst danach, was er bei Fehlern und Wiederherstellungen leistet, und nicht danach, was auf der Funktionsseite steht.
Ein verwalteter Postgres-Dienst ist eine PostgreSQL-Datenbank, bei der der Anbieter die zugrundeliegende Infrastruktur betreibt und die Datenbankverwaltung automatisiert, wie zum Beispiel Patches, Backups, Failover und Skalierung. Wie viel der Anbieter tatsächlich verwaltet, unterscheidet sich je nach Dienst, weshalb „managed“ eher eine Bezeichnung als eine vollständige Spezifikation ist. Große Cloud-Anbieter wie AWS, Microsoft Azure und Google Cloud bieten verwaltete PostgreSQL-Dienste an, ebenso wie auf Datenbanken spezialisierte Anbieter.
Ein Anbieter wirbt möglicherweise mit hoher Verfügbarkeit, automatisierten Backups oder Unternehmenssicherheit, aber diese Aussagen verraten Plattform-Ingenieuren oder DBAs nicht, was passiert, wenn ein Primärsystem ausfällt, wie schnell eine Datenbank wiederhergestellt werden kann oder ob eine erforderliche PostgreSQL-Erweiterung unterstützt wird. Wenn in der Produktion ein Problem auftritt, zählt nur, wie schnell das Team es finden und lösen kann.
Plattform-Ingenieure, DBAs, Datenarchitekten und Engineering Manager bewerten einen verwalteten Postgres-Dienst für die Produktion. Er deckt die Bereiche ab, die nach einer Migration häufig Probleme verursachen, wie Betriebskontrolle, hohe Verfügbarkeit, Notfallwiederherstellung, Skalierung und so weiter. Jeder Abschnitt beleuchtet, was der Anbieter unterstützen sollte, welche Fragen bei einer Evaluierung gestellt werden sollten und wie man die Antworten in einem Pilotprojekt testet. Wenn Sie ein DBA oder Plattform-Ingenieur sind und einen Wechsel planen, nutzen Sie diesen Artikel als Arbeits-Checkliste statt als einmalige Lektüre.
Die Checkliste für verwaltete Postgres-Dienste auf einen Blick
Eine verwaltete Postgres-Evaluierung sollte mehr als nur die Datenbankbereitstellung und die tägliche Verwaltung abdecken. Die folgende Tabelle bietet Teams einen Ausgangspunkt für die zu überprüfenden Funktionen und die Antworten, die eine genauere Prüfung erfordern sollten.
| Bereich | Was zu überprüfen ist | Warnsignal |
|---|---|---|
| Betriebsumfang | Wer kümmert sich um Patches, Upgrades und Optimierung und welche Datenbanksteuerelemente bleiben verfügbar | „Managed“ deckt nur die virtuelle Maschine und das Betriebssystem ab |
| Hohe Verfügbarkeit | Automatisches Failover, Garantien für festgeschriebene Transaktionen und ob das Failover über Verfügbarkeitszonen hinweg funktioniert | Kein angegebenes Recovery Point Objective (RPO) oder manuelles Hochstufen |
| Backups und Notfallwiederherstellung | Point-in-Time-Recovery (PITR), Wiederherstellungsoptionen, Aufbewahrung, regionenübergreifende Wiederherstellung und Wiederherstellungsziele | Die Notfallwiederherstellung ist nur über eine Support-Anfrage ohne angegebenes RPO oder Recovery Time Objective (RTO) verfügbar |
| Skalierung und Leistung | Größenänderungsverhalten, Lesereplikate, Verbindungspooling, Speicher und Modell für Ein-/Ausgabeoperationen pro Sekunde (IOPS) | Die vertikale Skalierung erfordert eine längere Ausfallzeit |
| Sicherheit und Compliance | Private Konnektivität, Identitäts- und Zugriffskontrollen, vom Kunden verwaltete Schlüssel, Audit-Protokolle und Compliance-Umfang | Öffentliche Konnektivität ist erforderlich oder Verschlüsselungsschlüssel können nur vom Anbieter kontrolliert werden |
| Kompatibilität und Erweiterungen | Unterstützte PostgreSQL-Versionen, Erweiterungen, Treiber, Parameter und Superuser-Einschränkungen | Eine wichtige Erweiterung oder erforderliche PostgreSQL-Funktion wird nicht unterstützt |
| Migration | Unterstützte Migrationspfade, logische Replikation und Change Data Capture (CDC)-Optionen | Große Datenbanken können nur durch Dump und Restore migriert werden |
| Preise und Gesamtkosten | Rechenleistung, Speicher, IOPS, Backups, Replikate, Netzwerkausgang und Kosten für erweiterten Support | Nur der Preis für die Rechenleistung ist klar |
| Betrieb | Datenbankmetriken, Protokolle, Benachrichtigungen und Zugriff auf Support auf PostgreSQL-Ebene | Eingeschränkte Datenbank-Observability oder keine Eskalation an PostgreSQL-Experten |
| Portabilität und Ausstieg | Standardexporte und logische Replikation in eine andere PostgreSQL-Umgebung | Daten können nur über ein proprietäres Format oder eine Support-Anfrage exportiert werden |
1. Betriebsumfang und Kontrolle
Als Erstes muss überprüft werden, wo die Verantwortung des Anbieters endet und die des Datenbankteams beginnt. Ein verwalteter Dienst sollte sich um die Infrastruktur und routinemäßige Datenbankvorgänge kümmern, ohne die PostgreSQL-Steuerelemente einzuschränken, von denen eine Produktions-Workload abhängt. Wenn Anbieter einen Dienst als vollständig verwaltet bezeichnen, bedeutet das nicht immer dasselbe.
Beginnen Sie mit der Wartung. Fragen Sie, ob Nebenversionsupdates automatisch erfolgen, ob Teams ein Wartungsfenster wählen können, wie viel Vorlaufzeit Anbieter vor Änderungen geben und ob Updates einen Neustart oder ein Failover erfordern. Hauptversionsupgrades verdienen besondere Aufmerksamkeit. PostgreSQL unterstützt jede Hauptversion fünf Jahre lang. Daher sollten Teams wissen, wie lange der Anbieter jede Version unterstützt und was passiert, wenn dieser Support endet. Fragen Sie nach dem Datum für das Lebensende (End-of-Life), das der Anbieter für jede Version angibt. Je weniger Vorlaufzeit ein Anbieter im Allgemeinen vor der Aktualisierung einer Datenbank gibt, desto schwieriger ist es, dies einzuplanen.
Der Zugriff auf die Konfiguration ist eine weitere häufige Quelle für Überraschungen. Verwaltete Dienste schränken häufig den Superuser-Zugriff ein und begrenzen Parameter oder Befehle, die sich auf die zugrundeliegende Infrastruktur auswirken könnten. Überprüfen Sie vor der Migration, welche Rollen verfügbar sind, welche Parameter geändert werden können, ob ALTER SYSTEM unterstützt wird und welche PostgreSQL-Befehle eingeschränkt sind. Einige Dienste ermöglichen es Ihnen beispielsweise, eine Reihe von Parametern über eine Konsole oder API zu bearbeiten, blockieren jedoch den Befehl ALTER SYSTEM vollständig.
- Fragen Sie, wie Neben- und Hauptversionsupgrades ablaufen, einschließlich Wartungsfenstern, Benachrichtigungen und Support-Ende-Richtlinien.
- Fragen Sie, welche PostgreSQL-Rollen, -Parameter und -Befehle eingeschränkt sind.
- Bewίhren Sie dies, indem Sie ein Nebenupdate im Pilotprojekt anwenden und die Auswirkungen auf aktive Verbindungen und Anwendungsdatenverkehr messen.
- Ein Warnsignal ist ein Dienst, der sich als vollständig verwaltet bezeichnet, während er Patches, Upgrades oder kritische Wartungsaufgaben dem Datenbankteam überlässt, oder ein Dienst, der seine Konfigurations- und Updatelimits nicht klar dokumentieren kann.
2. Hohe Verfügbarkeit und automatisches Failover
Ein automatisches Failover in Postgres-Datenbanken bedeutet, dass der Dienst automatisch ein Standby-System in einer anderen Verfügbarkeitszone hochstufen und klar angeben kann, was während des Failovers mit festgeschriebenen Transaktionen passiert. Hohe Verfügbarkeit schützt vor Ausfällen innerhalb einer Region, ist aber nicht dasselbe wie Notfallwiederherstellung.
Fragen Sie, ob das Standby-System synchrone oder asynchrone Replikation verwendet, welchen Wiederherstellungspunkt der Anbieter unterstützt und ob der Datenbankendpunkt nach der Hochstufung derselbe bleibt. Anwendungen müssen sich nach dem Abbruch bestehender Verbindungen normalerweise neu verbinden, daher sollte der Anbieter das erwartete Verhalten dokumentieren. Bestätigen Sie in einem Cluster mit mehreren Knoten, welche Knoten hochgestuft werden können und wie Anwendungen das neue Primärsystem finden. Stellen Sie sicher, dass Ihre Verbindungspools und Treiber, ob in Java, Python oder einer anderen Sprache, Wiederverbindungen sauber verarbeiten.
- Fragen Sie, ob für die hohe Verfügbarkeit synchrone Replikation verwendet wird und ob das Standby in einer separaten Verfügbarkeitszone läuft.
- Fragen Sie, wie lange ein Failover normalerweise dauert und ob festgeschriebene Transaktionen erhalten bleiben.
- Bewίhren Sie dies, indem Sie ein Failover auslösen, die Wiederherstellungszeit messen und Anwendungsfehler, festgeschriebene Schreibvorgänge sowie das Replikationsverhalten überprüfen.
- Ein Warnsignal ist eine manuelle Hochstufung oder keine klare Garantie für festgeschriebene Transaktionen.
3. Backups, Point-in-Time-Recovery und Notfallwiederherstellung
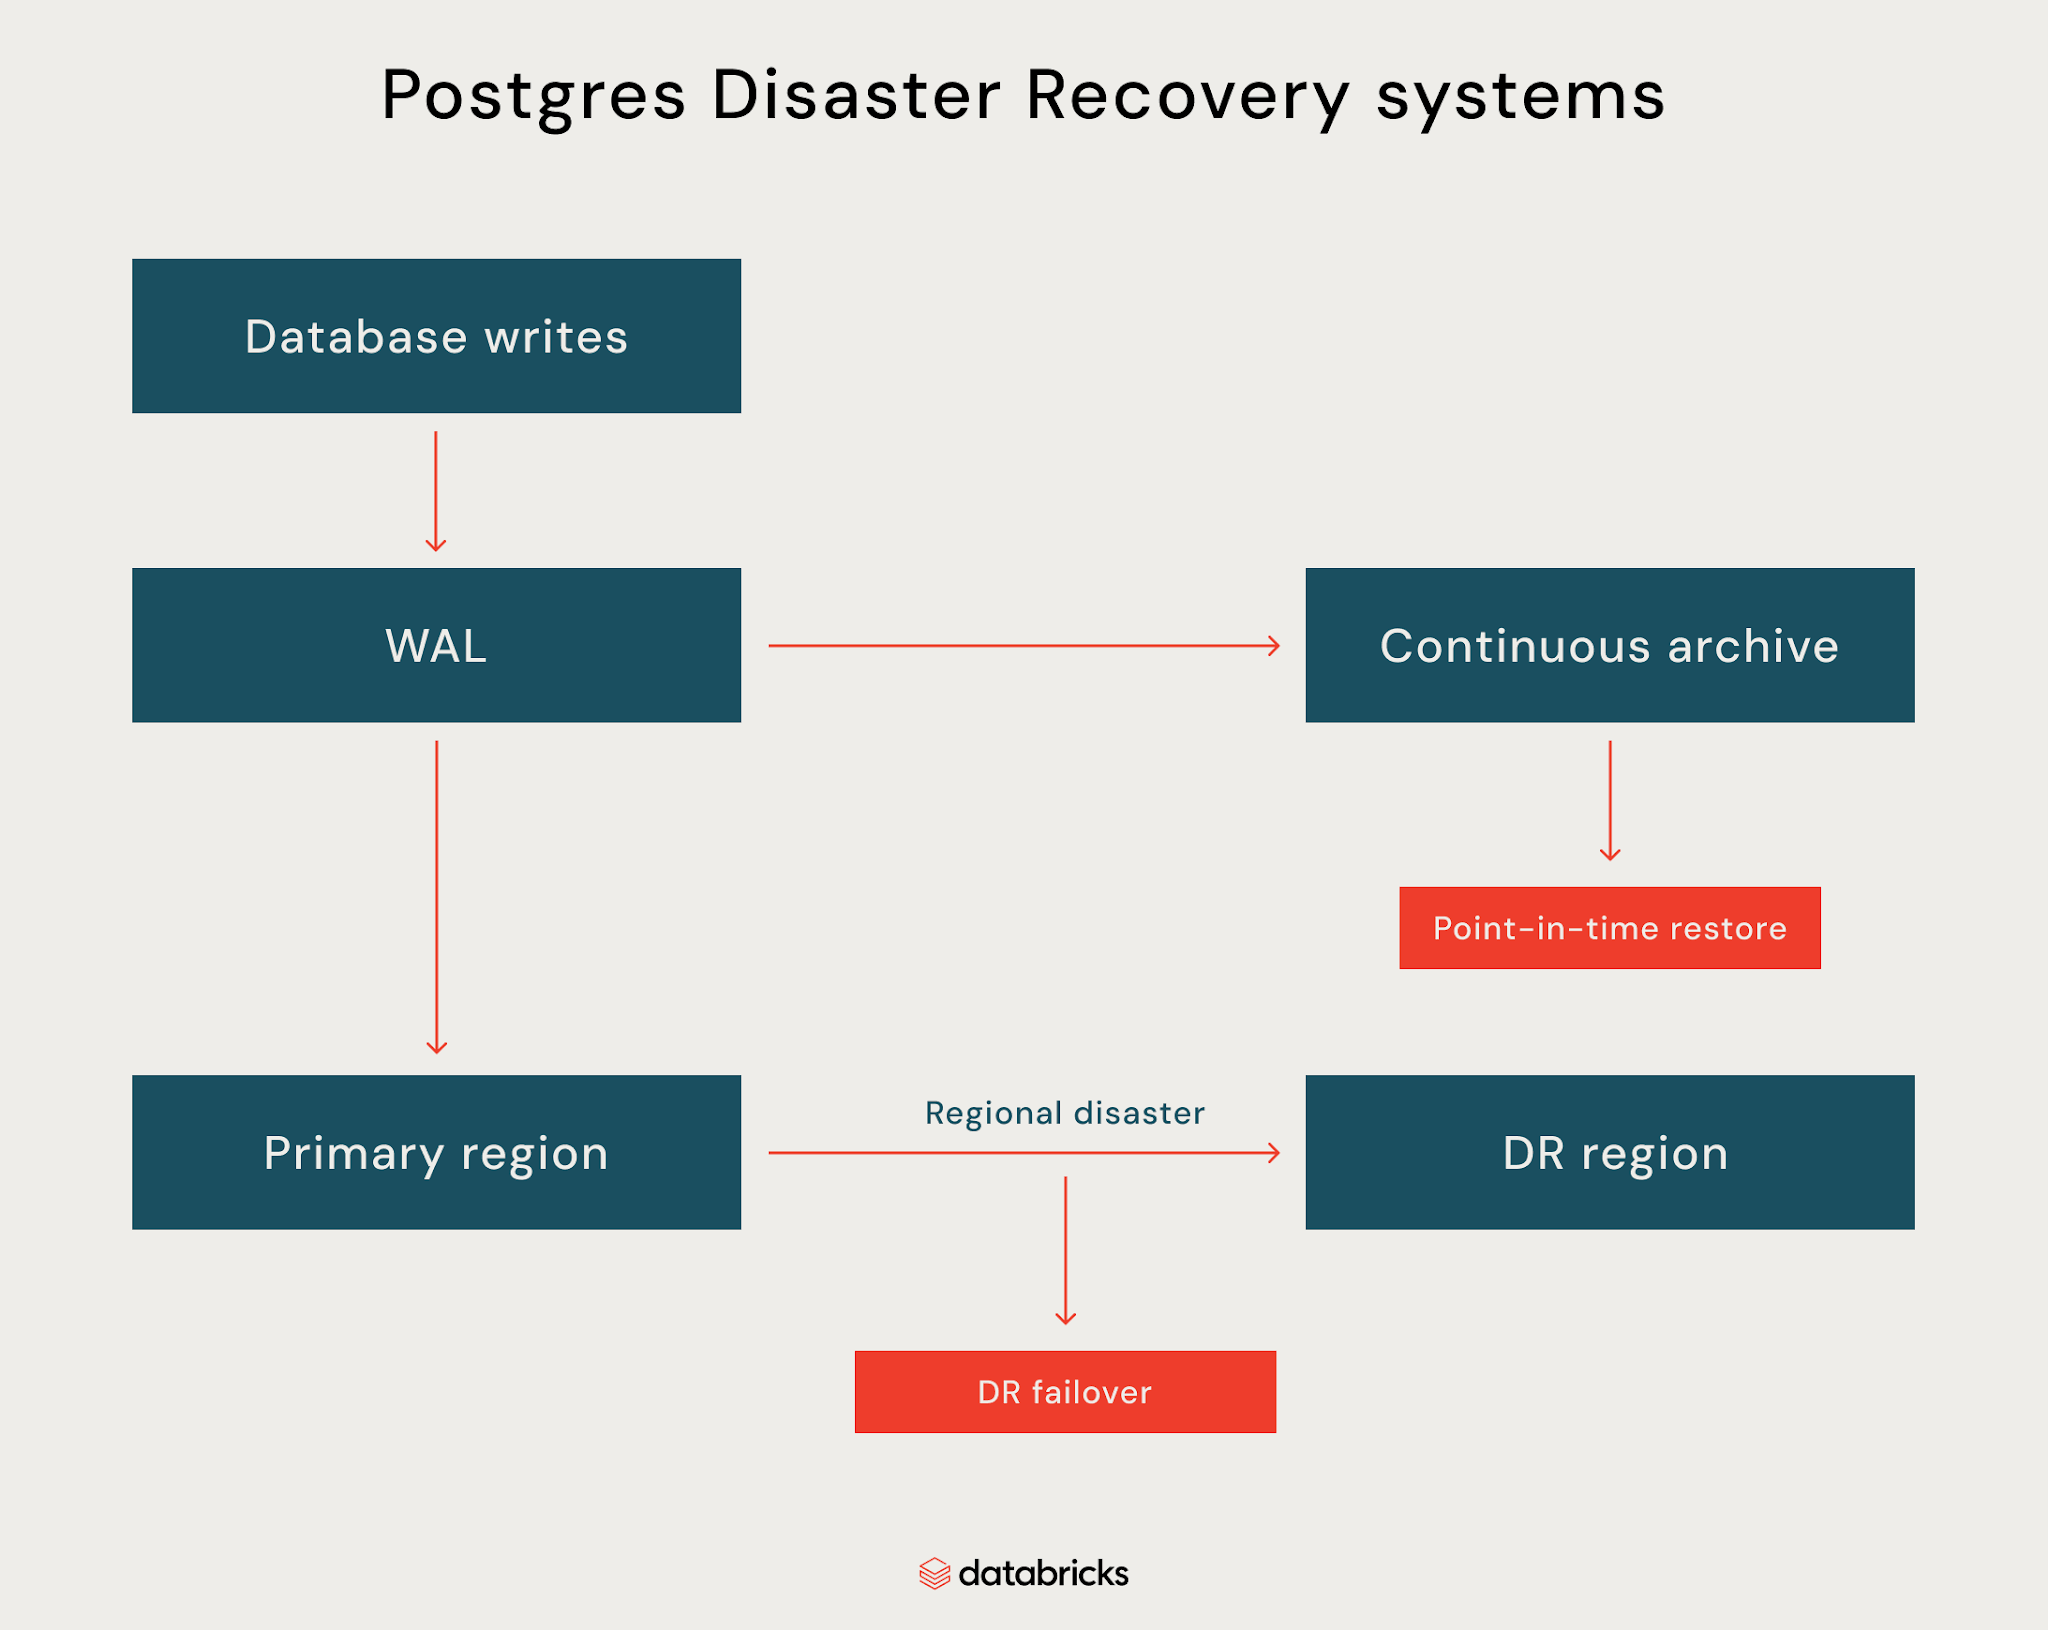
Backups und Notfallwiederherstellung (DR) sind bei Datenbanken wichtig. Stellen Sie sicher, dass Backups die Datenbank zu einem bekannten Zeitpunkt wiederherstellen können und dass der Anbieter seine Wiederherstellungsziele klar angibt. RPO definiert, wie viele Daten eine Workload verlieren darf. RTO definiert, wie lange die Datenbank nicht verfügbar sein kann.
Fragen Sie, ob der Dienst das Write-Ahead Log (WAL) kontinuierlich archiviert, wie lange Point-in-Time-Recovery verfügbar bleibt und ob Wiederherstellungen im Self-Service durchgeführt werden können. Überprüfen Sie für die Notfallwiederherstellung, ob die regionenübergreifende Replikation kontinuierlich oder periodisch erfolgt, ob das Failover automatisch oder manuell ist und ob der Anbieter RPO- und RTO-Ziele veröffentlicht. Automatisierte Backups in Kombination mit kontinuierlicher WAL-Archivierung machen Point-in-Time-Recovery und eine zuverlässige Datenwiederherstellung möglich.
- Fragen Sie, ob Sie die Datenbank auf einen bestimmten Zeitstempel zurücksetzen können und wie lange der Vorgang normalerweise dauert.
- Überprüfe wichtige Datensätze und Anwendungslesevorgänge nach der Wiederherstellung.
- Führe eine Notfallwiederherstellungsübung durch, falls der Anbieter eine solche unterstützt, und dokumentiere die Schritte zur Wiederherstellung.
- Ein Warnsignal ist eine Notfallwiederherstellung, die nur über eine Support-Anfrage verfügbar ist oder keine veröffentlichten RPO- oder RTO-Werte aufweist.
4. Skalierung und Leistung
Überprüfe, wie der Dienst mit dem Wachstum von Rechenleistung, Speicher, Verbindungen und Lesedatenverkehr umgeht. Die Skalierung sollte keine unerwarteten Ausfallzeiten verursachen oder erfordern, dass du die Infrastruktur manuell verwaltest.
Frage nach, ob sich die Rechenleistung vertikal skalieren lässt, ob Leserepliken verfügbar sind, wie Speicher und Ein-/Ausgabeoperationen pro Sekunde (IOPS) skalieren und ob Connection Pooling integriert ist. Bei Diensten mit Autoscaling solltest du prüfen, was die Skalierung auslöst, wie schnell sich die Kapazität anpasst und ob die Skalierung aktive Verbindungen oder Transaktionen beeinflusst. Bei den meisten verwalteten Diensten lässt sich die Skalierung von CPU und RAM in der Regel mit wenigen Klicks oder einem einzigen API-Aufruf durchführen, sodass Teams ihre Kapazität an das Nutzerwachstum anpassen können, anstatt neue Infrastruktur starten zu müssen.
- Frage, ob für die vertikale Skalierung ein Neustart oder Failover erforderlich ist.
- Frage, wie der Speicher wächst und ob es Limits für Verbindungen, IOPS oder Repliken gibt.
- Belege dies, indem du repräsentative Produktionslasten ausführst und ein Scale-up bei aktivem Datenverkehr testest.
- Messe die Abfragelatenz, Verbindungsfehler und das Anwendungsverhalten vor und nach der Skalierung.
- Ein Warnsignal ist eine Skalierung, die längere Ausfallzeiten erfordert oder undokumentierte Kapazitätslimits hat.
5. Sicherheit, Compliance und Zugriffskontrolle
Überprüfe, wie der Dienst Daten bei der Übertragung und im Ruhezustand schützt, den Datenbankzugriff steuert und die Verbindung zum Netzwerk herstellt. Die Sicherheitsfunktionen sollten den bestehenden Identitäts- und Compliance-Anforderungen der Organisation entsprechen, anstatt ein separates Betriebsmodell zu erfordern.
Frage nach, ob private Konnektivität unterstützt wird, wie sich das Identitäts- und Zugriffsmanagement (IAM) in Datenbankrollen integriert und ob kundenseitig verwaltete Schlüssel (CMK) verfügbar sind. Prüfe außerdem die Audit-Protokollierung, Verschlüsselungssteuerungen und den Compliance-Umfang des Anbieters. Frage, ob sich Anwendungen über eine private IP-Adresse, eine öffentliche oder beide verbinden können. Die meisten verwalteten Anbieter erzwingen Verschlüsselung im Ruhezustand und bei der Übertragung und wenden routinemäßig Betriebssystem-Patches sowie Sicherheitsupdates automatisch an. Bestätige daher, welche Compliance-Frameworks wie HIPAA oder GDPR der Dienst unterstützt.
- Frage, ob Datenbanken ohne öffentlichen Internetzugang betrieben werden können.
- Frage, wie Datenbankaktivitäten, administrative Aktionen und Authentifizierungsereignisse protokolliert werden.
- Stelle sicher, dass Verschlüsselungsschlüssel rotiert oder widerrufen werden können, ohne die Datenbank zu beeinträchtigen.
- Belege dies, indem du die Verbindung über den vorgesehenen privaten Netzwerkpfad herstellst und den Zugriff mit verschiedenen Rollen testest.
- Ein Warnsignal ist ein Dienst, der öffentliche Konnektivität erfordert, eine eingeschränkte Audit-Transparenz bietet oder die von der Organisation geforderten Sicherheitskontrollen nicht unterstützt.
6. PostgreSQL-Kompatibilität und Erweiterungen
Du solltest prüfen, ob der Dienst die PostgreSQL-Versionen, -Erweiterungen, -Treiber und -Konfigurationsoptionen unterstützt, von denen deine Workload abhängt. Die Kompatibilität sollte anhand der tatsächlichen Anwendung getestet werden, anstatt sich auf die Behauptung des Anbieters zu verlassen, er unterstütze PostgreSQL.
Überprüfe, welche PostgreSQL-Versionen verfügbar sind, wie schnell neue Major-Versionen unterstützt werden und welche Erweiterungen aktiviert sind. Prüfe die Unterstützung für Erweiterungen wie pgvector, PostGIS und alle anwendungsspezifischen Abhängigkeiten. Bestätige auch, welche Parameter, Rollen und PostgreSQL-Befehle eingeschränkt sind. Prüfe, ob Einschränkungen für Superuser Auswirkungen auf bestehende Tabellen, Funktionen oder Erweiterungen haben und ob Objekte, die in deiner aktuellen Datenbank existieren, geändert werden müssen. Eigenständig verwaltete Teams betreiben PostgreSQL oft auf Ubuntu oder einer anderen Linux-Distribution mit vollständigem Betriebssystemzugriff, weshalb Abhängigkeiten vom Betriebssystem frühzeitig identifiziert werden sollten.
- Fordere die vollständige Liste der unterstützten Erweiterungen und versionsspezifischen Einschränkungen an.
- Frage, ob Anwendungstreiber, ORMs und Standard-PostgreSQL-Tools ohne Modifikationen funktionieren.
- Teste alle erforderlichen Erweiterungen und Datenbankparameter vor der Migration.
- Belege dies, indem du ein repräsentatives Schema wiederherstellst und die Migrationen sowie Integrationstests der Anwendung ausführst.
- Ein Warnsignal ist eine wichtige Erweiterung, die nicht unterstützt wird, oder eine Kompatibilität, die von undokumentierten Workarounds abhängt.
Für KI-Workloads ist die pgvector-Unterstützung neben transaktionalen Workloads für die Vektorsuche wichtig.
Das Playbook für agentenbasierte KI für Unternehmen

7. Migrationspfade von PostgreSQL und anderen Datenbanken
Überprüfe, wie der Anbieter sowohl die initiale Datenmigration als auch die finale Umstellung unterstützt. Eine Migrationsmethode, die für eine kleine Datenbank funktioniert, ist für ein Produktsystem, das während des Umzugs den Datenverkehr weiter bedienen muss, möglicherweise nicht praktikabel.
Frage, ob der Dienst logische Replikation, Change Data Capture (CDC), native PostgreSQL-Tools und Migrationsdienste von Drittanbietern unterstützt. Prüfe bei Migrationen von anderen Datenbank-Engines, welche Quellsysteme unterstützt werden und wie Schemakonvertierung, Datenvalidierung sowie Anwendungsänderungen gehandhabt werden. Das Verschieben einer Produktions-DB von anderen Datenbanken wie Oracle oder SQL Server erfordert ebenfalls Schemakonvertierung und Anwendungstests.
- Frage, ob große Datenbanken ohne längere Ausfallzeiten migriert werden können.
- Frage, wie laufende Änderungen während des Migrationsfensters repliziert werden.
- Belege dies, indem du einen repräsentativen Datensatz migrierst, Validierungsprüfungen durchführst und die finale Umstellungszeit misst.
- Ein Warnsignal ist ein Migrationsprozess, der vollständig von Dump und Restore abhängt oder längere Anwendungsausfallzeiten erfordert.
Deine Migrationslösung sollte Abhängigkeiten in deiner gesamten Datenumgebung berücksichtigen und Ausfallzeiten minimieren.
8. Preise und Total Cost of Ownership
Ein verwalteter Dienst kann zusätzliche Kosten für Speicher, Backups, hohe Verfügbarkeit, Repliken, Netzwerkübertragung und andere nutzungsbasierte Ressourcen verursachen. Ein Großteil der Einsparungen im Vergleich zu selbst verwalteten Bereitstellungen ergibt sich daraus, dass On-Premises-Hardware und -Wartung entfallen. Finde daher heraus, welche Funktionen im Basispreis enthalten sind und welche kostenpflichtige Zusatzoptionen darstellen.
Prüfe, wie Rechenleistung, Speicher, IOPS, Backups, Repliken und Netzwerk-Egress abgerechnet werden. Überprüfe, ob sich die Preise bei Autoscaling, Standby-Kapazität oder Konfigurationen mit höherer Verfügbarkeit ändern.
- Modelliere sowohl die normale als auch die Spitzenlast, einschließlich Speicherwachstum und Backup-Aufbewahrung.
- Berechne die Total Cost of Ownership (TCO) über den voraussichtlichen Vertrag zeitraum.
- Belege dies, indem du ein 12-Monats-TCO-Modell erstellst, das Rechenleistung, hochverfügbare Standby-Kapazität, IOPS, Backups, Repliken und Netzwerk-Egress für deine erwartete Workload abdeckt. Verwende nicht nur die Rechenleistung als Kostenfaktor.
- Ein Warnsignal ist eine Preisgestaltung, die nur die Datenbank-Rechenleistung ausweist, während Speicher, Backups, Repliken oder Netzwerkkosten unklar bleiben.
Eine nutzungsbasierte Preisgestaltung kann es erleichtern, die Kosten an den Workload-Bedarf anzupassen, aber Teams sollten vor einer Festlegung realistische Verkehrsmuster modellieren.
9. Betrieb, Überwachung und Fehlerbehebung
Ein Produktionsdienst benötigt ausreichend Transparenz, damit Datenbankteams verstehen, was passiert, wenn Leistung oder Zuverlässigkeit nachlassen. Metriken zur Infrastruktur allein reichen selten aus, um PostgreSQL-Probleme zu diagnostizieren.
Frage Sie, ob der Dienst Datenbank-Metriken, -Protokolle und Informationen auf Abfrageebene bereitstellt und ob Teams Benachrichtigungen für wichtige Zustände konfigurieren können. Finden Sie heraus, welchen Zugriff Support-Ingenieure bei Vorfällen haben und ob PostgreSQL-Spezialisten für Eskalationen verfügbar sind. Achten Sie auf Dashboards mit Echtzeit-Einblick in Systemmetriken und prüfen Sie, ob Protokolle nach Datenbank oder Benutzer gefiltert werden können und ob Sie Ereignisse nach Zeit oder Schweregrad sortieren können. Überlegen Sie auch, ob Ihr Team über die erforderlichen Fähigkeiten verfügt, um PostgreSQL-Probleme ausschließlich mit den Tools des Anbieters zu beheben.
- Fragen Sie, welche PostgreSQL-Metriken, -Protokolle und -Abfragestatistiken verfügbar sind.
- Fragen Sie, ob Überwachungsdaten in die bestehende Observability-Plattform des Unternehmens exportiert werden können.
- Beweisen Sie dies, indem Sie ein kontrolliertes Leistungsproblem erzeugen und die verfügbaren Tools verwenden, um die Ursache zu identifizieren.
- Ein Warnsignal ist eine eingeschränkte Transparenz auf Datenbankebene oder ein Support-Modell, das PostgreSQL-spezifische Probleme nicht untersuchen kann.
Fragen Sie bei großen Bereitstellungen, ob die Tools des Anbieters Muster über alle Ihre Datenbanken hinweg anzeigen können, und nicht nur Metriken pro Instanz.
10. Portabilität und Ausstieg
Ein verwalteter Postgres-Dienst sollte es ermöglichen, Daten und Anwendungen in eine andere PostgreSQL-Umgebung zu verschieben, ohne von proprietären Exportprozessen abhängig zu sein.
Fragen Sie, ob Standard-PostgreSQL-Tools und logische Replikation verwendet werden können, um Daten herauszubekommen. Finden Sie heraus, ob anbieterspezifische Erweiterungen, APIs oder Speicherformats einen Ausstieg erschweren würden. Je mehr einzigartige, anbieterspezifische Funktionen eine Anwendung erfordert, desto schwieriger wird ein Ausstieg.
- Fragen Sie, wie ein vollständiger Datenbankexport funktioniert und ob er ohne Support des Anbieters ausgeführt werden kann.
- Fragen Sie, ob die logische Replikation Daten in eine andere PostgreSQL-Umgebung streamen kann.
- Beweisen Sie dies, indem Sie einen Export in einer separaten PostgreSQL-Umgebung wiederherstellen und Anwendungstests durchführen.
- Ein Warnsignal sind Daten, die nur über eine Support-Anfrage oder ein proprietäres Format exportiert werden können.
So führen Sie einen Piloten vor der Einführung durch
Ein Pilot sollte die Behauptungen des Anbieters anhand einer Workload testen, die der Produktion ähnelt. Eine Checkliste mit Funktionen kann zeigen, was ein Dienst bietet, aber kontrollierte Fehler- und Wiederherstellungstests zeigen, ob diese Funktionen im Ernstfall auch tatsächlich funktionieren.
Beginnen Sie mit einer repräsentativen Datenbank, Anwendungsverkehr und den PostgreSQL-Erweiterungen, die das Produktsystem benötigt. Testen Sie dann die Bereiche, die Ihre Entscheidung am wahrscheinlichsten beeinflussen. Wenn Sie einen schrittweisen Ansatz bevorzugen, beginnen Sie mit einer unkritischen Workload und erweitern Sie den Piloten nach und nach.
- Führen Sie ein Failover durch und messen Sie die Wiederherstellungszeit, die Verbindungswiederherstellung und verlorene Transaktionen.
- Stellen Sie die Datenbank auf einen bestimmten Zeitpunkt wieder her und vergleichen Sie das Ergebnis mit dem erwarteten RPO und RTO.
- Wenden Sie eine repräsentative Spitzenlast an und testen Sie die Skalierung, während die Anwendung aktiv bleibt.
- Führen Sie Migrations- und Rollback-Tests durch, einschließlich aller erforderlichen Erweiterungen und Anwendungsänderungen.
- Testen Sie die Überwachung und die Support-Eskalation.

Protokollieren Sie die Ergebnisse im Vergleich zu den ursprünglichen Anforderungen und betrachten Sie fehlgeschlagene Tests als Entscheidungspunkte. Datenbank-Branching kann Teams auch dabei helfen, isolierte Umgebungen für Migrations- und Anwendungstests zu erstellen. Erfassen Sie die Ergebnisse in einer einheitlichen Form, damit die Diskussion nach dem Piloten zwischen den Teams für Engineering, Sicherheit und Finanzen objektiv bleibt.
Wie Lakebase zu dieser Checkliste passt
Lakebase passt gut zu mehreren in dieser Checkliste behandelten Bereichen. Die folgende Tabelle zeigt, wo die Funktionen mit den allgemeinen Produktionsanforderungen übereinstimmen, sowie Bereiche, die noch genauer evaluiert werden müssen.
| Checklistenbereich | Wie Lakebase dazu passt |
|---|---|
| Betrieb | Verwaltetes, serverloses Postgres mit automatisierten Infrastrukturoperationen. |
| Hohe Verfügbarkeit | Automatisches Hochstufen über Availability Zones hinweg bei gleichzeitiger Beibehaltung committeter Transaktionen. Bestehende Verbindungen müssen sich nach einem Failover neu verbinden. |
| Skalierung | Autoscaling mit von Speicher getrennter Compute-Komponente, sodass sich die Kapazität an die Workload-Anfrage anpasst. |
| Sicherheit | Unterstützt private Netzwerke und vom Kunden verwaltete Schlüssel neben den Governance-Funktionen von Databricks. |
| PostgreSQL-Kompatibilität | Unterstützt PostgreSQL-Tools und -Erweiterungen, einschließlich pgvector. |
| Notfallwiederherstellung | regionsübergreifendes DR ist derzeit eine Private Preview auf AWS mit manuellem Failover. Wenn regionales DR eine harte Anforderung ist, wenden Sie sich an Ihr Account-Team, um weitere Informationen zu erhalten. |
| Kosten | Eine nutzungsbasierte Preisgestaltung kann die Kosten an die Workload-Anfrage anpassen, aber Teams sollten ihre erwartete Workload und ihre Nutzungsmuster modellieren. |
| Portabilität | Die Standard-PostgreSQL-Kompatibilität bietet eine Grundlage für Migrations- und Ausstiegstests, aber anbieterspezifische Abhängigkeiten sollten dennoch bewertet werden. |
Die Checkliste bietet Teams eine konsistente Möglichkeit, Lakebase, andere verwaltete Postgres-Dienste und selbst verwaltete Bereitstellungen mit ihren Produktionsanforderungen zu vergleichen.
Für Teams, die verwaltetes Postgres evaluieren, ist die wichtigste Frage, wie viel der operativen Arbeit ihnen tatsächlich abgenommen wird. Lakebase übernimmt den Großteil dieser Arbeit innerhalb einer Region, während die regionsübergreifende Notfallwiederherstellung ein Bereich bleibt, in dem Teams nach wie vor in der Verantwortung sind.
Lakebase Postgres stuft sekundäre Compute-Ressourcen über Availability Zones hinweg automatisch hoch, während committete Transaktionen beibehalten werden und die Verbindungszeichenfolge unverändert bleibt. Bestehende Verbindungen müssen sich dennoch neu verbinden.

Lakebase dokumentiert die regionsübergreifende Notfallwiederherstellung als Private Preview auf AWS mit manuellem Failover, was berücksichtigt werden sollte, wenn die regionale Wiederherstellung eine Produktionsanforderung ist.
Lakebase trennt zudem Compute von Storage und unterstützt Autoscaling, sodass sich die Kapazität an die Workload-Anfrage anpasst, anstatt sich nur auf eine feste Datenbankgröße zu verlassen.
Für Teams, die Databricks verwenden, bieten private Netzwerke und vom Kunden verwaltete Schlüssel zusätzliche Steuerelemente zur Absicherung von Lakebase-Bereitstellungen.
Häufig gestellte Fragen
Worauf sollte ich bei einem verwalteten Postgres-Dienst achten?
Konzentrieren Sie sich auf die Funktionen, die sich auf die Produktionszuverlässigkeit und den Betrieb auswirken. Hohe Verfügbarkeit, Backups, Point-in-Time-Recovery, Notfallwiederherstellung, Skalierung, Sicherheit, PostgreSQL-Kompatibilität, Migration, Kosten und Portabilität sollten klare Antworten haben. Anbieter sollten wichtige Aussagen auch anhand von Dokumentationen und einem produktionsähnlichen Piloten nachweisen können. Zu jedem Thema in dieser Checkliste sollte vor der Entscheidung eine dokumentierte Antwort vorliegen.
Welche Vorteile bietet ein verwalteter Postgres-Dienst?
Ein verwalteter Dienst kann den operativen Aufwand beim Betrieb von PostgreSQL verringern, indem er die Verantwortung für Infrastruktur, Wartung, Backups und andere Routineaufgaben übernimmt. Er kann auch integrierte Funktionen für Verfügbarkeit, Skalierung, Sicherheit und Überwachung bereitstellen. Der Nutzen hängt davon ab, wie viel operative Verantwortung der Anbieter tatsächlich übernimmt und ob der Dienst dennoch die von der Workload geforderten Steuerungsmöglichkeiten bietet.
Was ist der Unterschied zwischen verwaltetem Postgres und selbst verwaltetem Postgres?
Verwaltetes Postgres verlagert einen Großteil der Infrastruktur- und Datenbankadministrationsarbeit auf den Anbieter. Selbst verwaltetes Postgres gibt Engineering-Teams mehr Kontrolle über Infrastruktur, Konfiguration, Erweiterungen und Upgrades, macht sie aber auch für den Betrieb dieser Komponenten verantwortlich. Die richtige Wahl hängt von den operativen Kapazitäten, den Kontrollanforderungen und der Workload der Organisation ab.
Wie sollte ich einen verwalteten Postgres-Dienst vor der Migration testen?
Verwenden Sie eine repräsentative Workload und testen Sie die Funktionen, die für die Produktion am wichtigsten sind. Führen Sie Failover-, Point-in-Time-Recovery-, Skalierungs-, Migrations- und Rollback-Tests durch. Messen Sie Wiederherstellungszeiten, das Verbindungsverhalten, die Datenintegrität und die Anwendungsleistung. Der Pilot sollte auch Überwachung, Support-Eskalation und Datenexport abdecken. Jede Funktion, die nicht demonstriert werden kann, bleibt ein offenes Risiko.
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.