Photon
Photon: die Engine der nächsten Generation für das Lakehouse
Photon ist die Engine der nächsten Generation auf der Databricks Lakehouse-Plattform, die eine extrem schnelle Abfrageleistung zu niedrigeren Kosten bietet – Dateneingabe, ETL, Streaming, Data Science und interaktive Abfragen – direkt in Ihrem Data Lake. Photon ist mit Apache Spark™-APIs kompatibel, sodass der Einstieg so einfach ist wie das Einschalten – keine Codeänderungen und keine Anbieterbindung.

Billiger und schneller
Photon wurde von Grund auf für die schnellste Leistung bei geringeren Kosten entwickelt und bietet Einsparungen von bis zu 80 % bei den Gesamtbetriebskosten bei gleichzeitiger bis zu 12-facher Beschleunigung von Daten- und Analys-eWorkloads.

Für alle Anwendungsfälle konzipiert
Photon ist die erste Engine, mit der Datenteams einen Satz von APIs für alle Workloads – ETL, Analytics und Data Science – im Batch- oder Streaming-Modus standardisieren können.

Keine Codeänderungen
Die ANSI-konforme Engine Photon ist so konzipiert, dass sie mit modernen Apache Spark-APIs kompatibel ist und einfach mit Ihrem vorhandenen Code funktioniert – SQL, Python, R, Scala und Java. Es muss kein Code umgeschrieben werden.
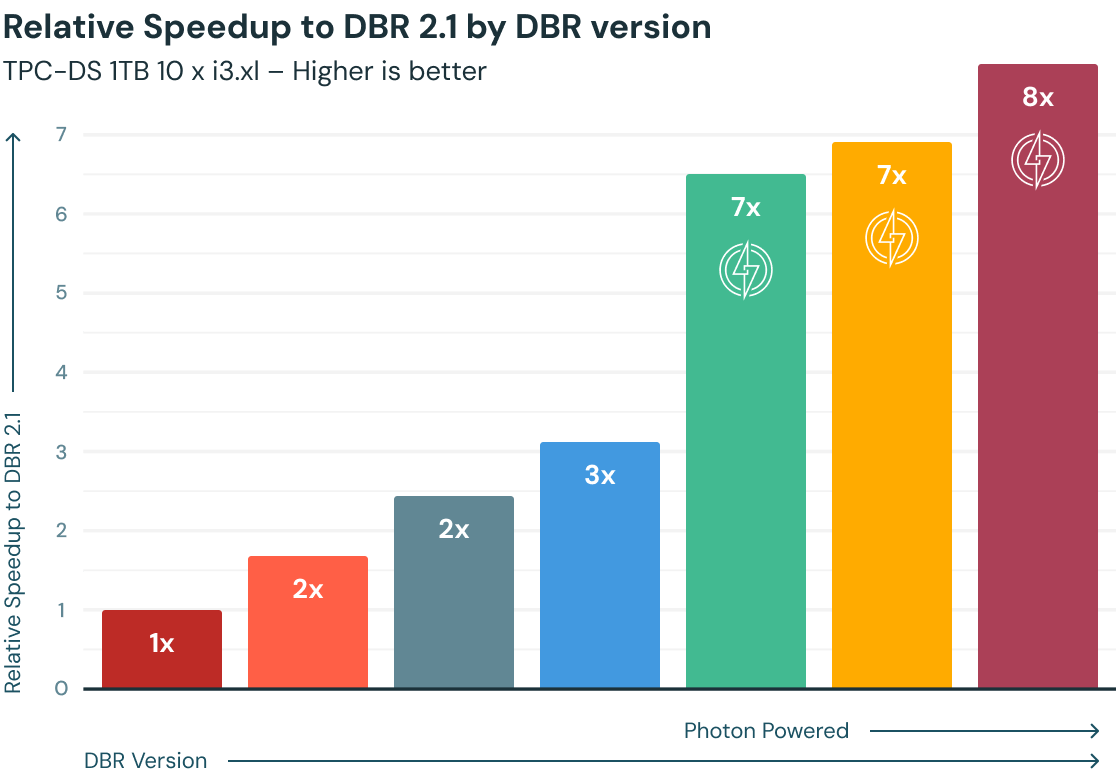
Wie viel schneller ist Photon als Databricks Runtime?
Die Abfrageleistung in Databricks hat sich im Laufe der Jahre stetig erhöht, unterstützt von Apache Spark und Tausenden von Optimierungen, die als Teil der Databricks Runtimes (DBR) bereitgestellt wurden. Photon, eine neue native vektorisierte Engine, die vollständig in C++ geschrieben ist. Sie bietet eine zusätzliche 2-fache Beschleunigung pro TPC-DS-Benchmark (1 TB). Kunden haben basierend auf ihren Workloads im Vergleich zu den neuesten DBR-Versionen durchschnittlich 3- bis 8-fache Beschleunigungen beobachtet.
Häufige Anwendungsfälle für Photon

PRODUKTIONSJOBS
Umfangreiche Produktionsaufträge auf SQL- und Spark-DataFrames beschleunigen

IoT-Anwendungen
Schnellere Zeitreihenanalyse mit Photon im Vergleich zu Spark und herkömmlicher Databricks Runtime

Datenschutz und Compliance
Abfragen im Petabyte-Bereich, um Datensätze zu identifizieren und zu löschen, ohne Daten in Delta Lake, Produktionsjobs und Photon zu duplizieren

Laden von Daten in Delta Lake und Parquet
Das vektorisierte I/O von Photon beschleunigt das Laden von Daten für Delta Lake- sowie Parquet-Tabellen und senkt die Gesamtlaufzeit und die Kosten für Data-Engineering-Jobs.
Wie funktioniert Photon?
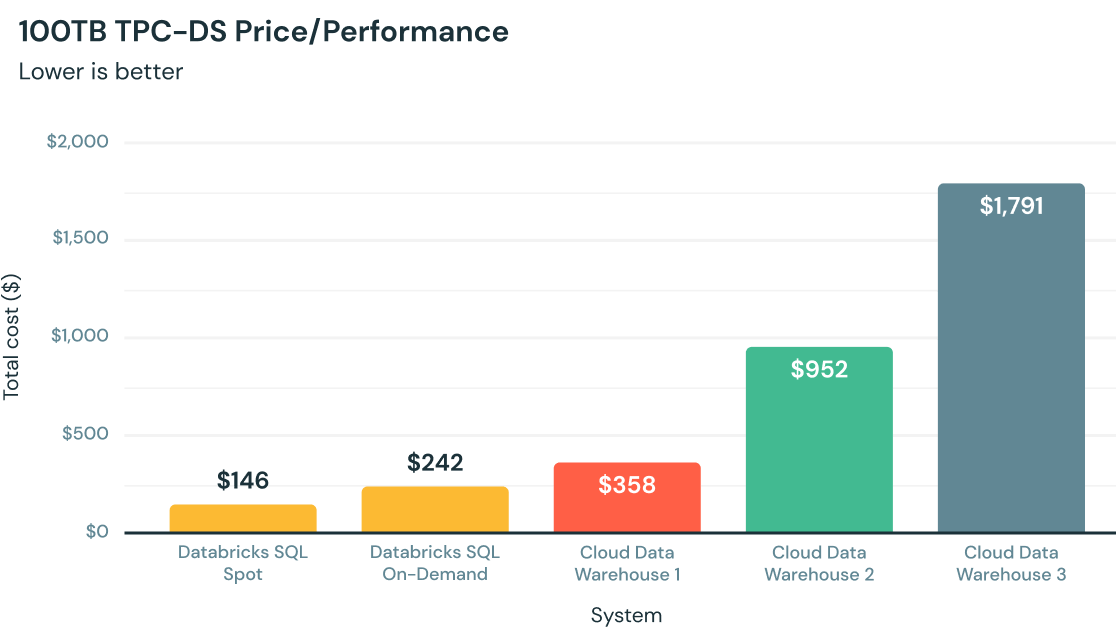
Bestes Preis-Leistungs-Verhältnis bei Analysen in der Cloud
Von Grund auf in C++ geschrieben nutzt Photon moderne Hardware für schnellere Abfragen und bietet ein bis zu 12-mal besseres Preis-Leistungs-Verhältnis im Vergleich zu anderen Cloud Data Warehouses – alles nativ in Ihrem Data Lake.
Funktioniert mit Ihrem vorhandenen Code und umgeht eine Anbieterbindung
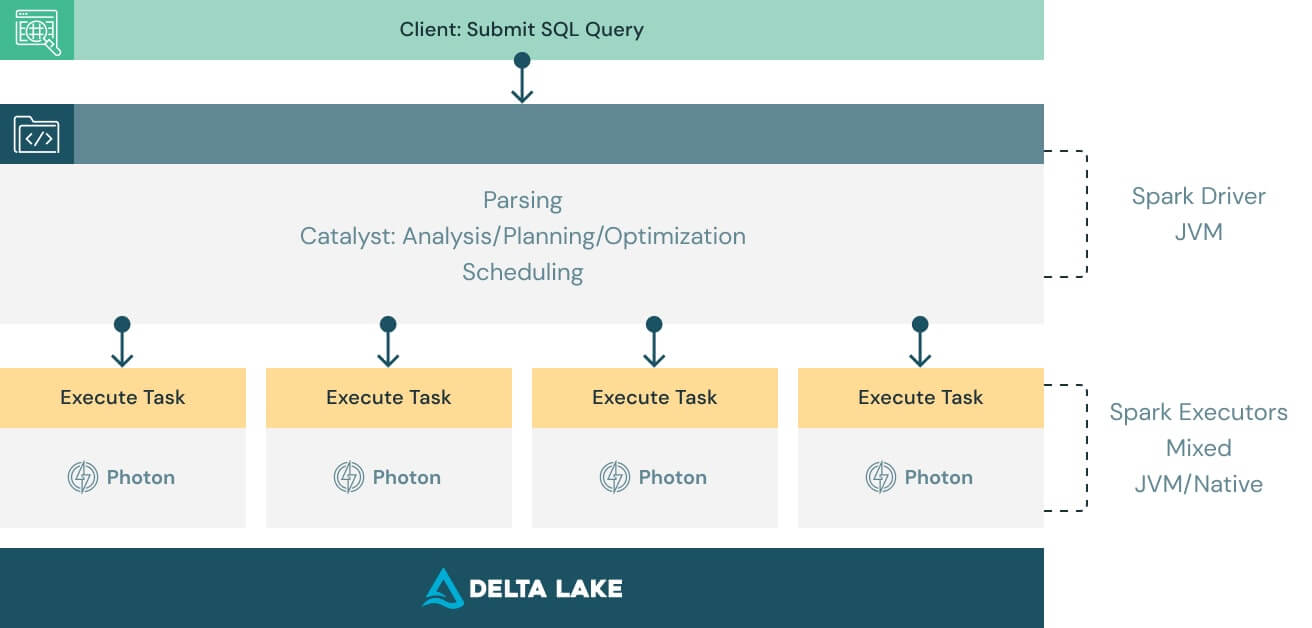
Photon ist so konzipiert, dass es mit Apache Spark DataFrame und SQL-APIs kompatibel ist, um sicherzustellen, dass Workloads nahtlos und ohne Codeänderungen ausgeführt werden. Alles, was Sie tun müssen, um von Photon zu profitieren, ist die Engine einzuschalten. Photon wird Arbeit und Ressourcen nahtlos koordinieren und Teile Ihrer SQL- und Spark-Abfragen transparent beschleunigen. Keine Feinabstimmung und kein Benutzereingriff erforderlich.

Optimieren aller Datenanwendungsfälle und Workloads
Während wir uns zu Beginn mit Photon in erster Linie auf SQL konzentriert hatten, um unseren Kunden eine erstklassige Data-Warehousing-Leistung für ihre Data Lakes zu bieten, haben wir seither den Umfang der von Photon unterstützten Aufnahmequellen, Formate, APIs und Methoden erheblich erweitert. Infolgedessen haben Kunden mit Photon enorme Einsparungen bei den Infrastrukturkosten und Beschleunigungen in all ihren modernen Spark-Workloads (z. B. Spark SQL und DataFrame) festgestellt.
Verwandte Databricks-Produkte


Photon-Ressourcen
Forschungsunterlagen zu Photon
Photon-Konferenzsitzungen
Blogs über Photon
Häufig gestellte Fragen
Photon ist die Abfrage-Engine der nächsten Generation auf der Databricks Data + AI Platform, die von Grund auf in C++ als native vektorisierte Engine entwickelt wurde. Es beschleunigt Datenaufnahme, ETL, Streaming, Data Science und interaktive Abfragen direkt in Ihrem Data Lake. Photon ist mit Apache Spark-APIs kompatibel und funktioniert daher mit SQL, Python, R, Scala und Java, ohne dass vorhandener Code umgeschrieben werden muss.
Möchten Sie loslegen?