Databricks for Good et Virtue Foundation : un partenariat pour mettre en relation des bénévoles médicaux et des services de santé essentiels dans 72 pays
par Priyanka Mehta et Shaunak Sen
- La Virtue Foundation s'est associée à Databricks for Good pour tirer parti de l'AI afin d'améliorer les résultats en matière de santé mondiale.
- Grâce à cette collaboration, la Virtue Foundation est en mesure de mieux faire correspondre les compétences des cliniciens aux opportunités de bénévolat dans les pays en développement où ces compétences sont les plus nécessaires.
- Ensemble, les équipes de Databricks et de la Virtue Foundation fournissent des jeux de données de référence mis à jour dans un format facilement accessible et exploitable.
Introduction
Virtue Foundation est une organisation à but non lucratif qui se consacre à la prestation de soins de santé mondiaux et à la création d'un marché efficace pour la santé philanthropique mondiale. À ce jour, elle a prodigué des soins à plus de 50 000 patients, en se concentrant particulièrement sur le Ghana et la Mongolie. Le pilier de ce marché est la curation de données sur les établissements de santé mondiaux via VF Match, une plateforme qui met en relation des professionnels de la santé avec des opportunités de bénévolat dans 72 pays à revenu faible et intermédiaire de la tranche inférieure. Databricks for Good collabore étroitement avec Virtue Foundation depuis 2024 afin de tirer parti de l'IA pour agréger les données de ces pays et les rendre exploitables.
Une preuve de concept initiale a démontré que les LLM pouvaient extraire des informations structurées à partir de sources de données web disparates afin de créer une carte des infrastructures de santé et, surtout, d'identifier les lacunes dans les services des zones sous-équipées. Cependant, le passage à l'échelle de cette fonctionnalité et sa mise en production ont posé de nombreux défis. Depuis cette première itération, nous avons conçu une plateforme basée sur Databricks qui a transformé le POC en un système de niveau production, agrégeant les données de milliers d'établissements de santé et d'organisations à but non lucratif à travers le monde.
Dans cet article, nous détaillons comment nous avons amélioré nos travaux précédents pour permettre à Virtue Foundation de mieux faire correspondre sa communauté de bénévoles médicaux avec les besoins critiques de ces pays.
Bâtir les fondations : les données de santé de 72 pays
Le cœur de VF Match est le Foundational Data Refresh (FDR) : un ensemble complet de données sur les établissements de santé et les organisations à but non lucratif, entièrement conçu à partir de diverses sources web. Nous ingérons et actualisons systématiquement les données de 72 pays à revenu faible et intermédiaire de la tranche inférieure à travers le monde.
Deux sources de données complémentaires alimentent cette actualisation :
- Overture Maps : un ensemble de données géospatiales open source de Meta et Microsoft, fournissant des localisations de référence pour les établissements de santé.
- Bright Data : une infrastructure de web-scraping industrielle qui capture des informations en temps réel sur l'ensemble du web.
Le cœur de FDR est un pipeline d'extraction d'informations alimenté par les modèles GPT d'OpenAI. Le traitement de plus de 25 millions de pages web via des LLM avec des garanties de production a nécessité de repenser les pipelines d'inférence LLM traditionnels. Plutôt que de tenter une extraction en une seule étape (one-shot), notre pipeline divise la tâche en étapes ciblées : classification de la pertinence médicale, identification du type d'organisation (établissement médical ou NGO) et extraction des spécialités, des équipements et des procédures.
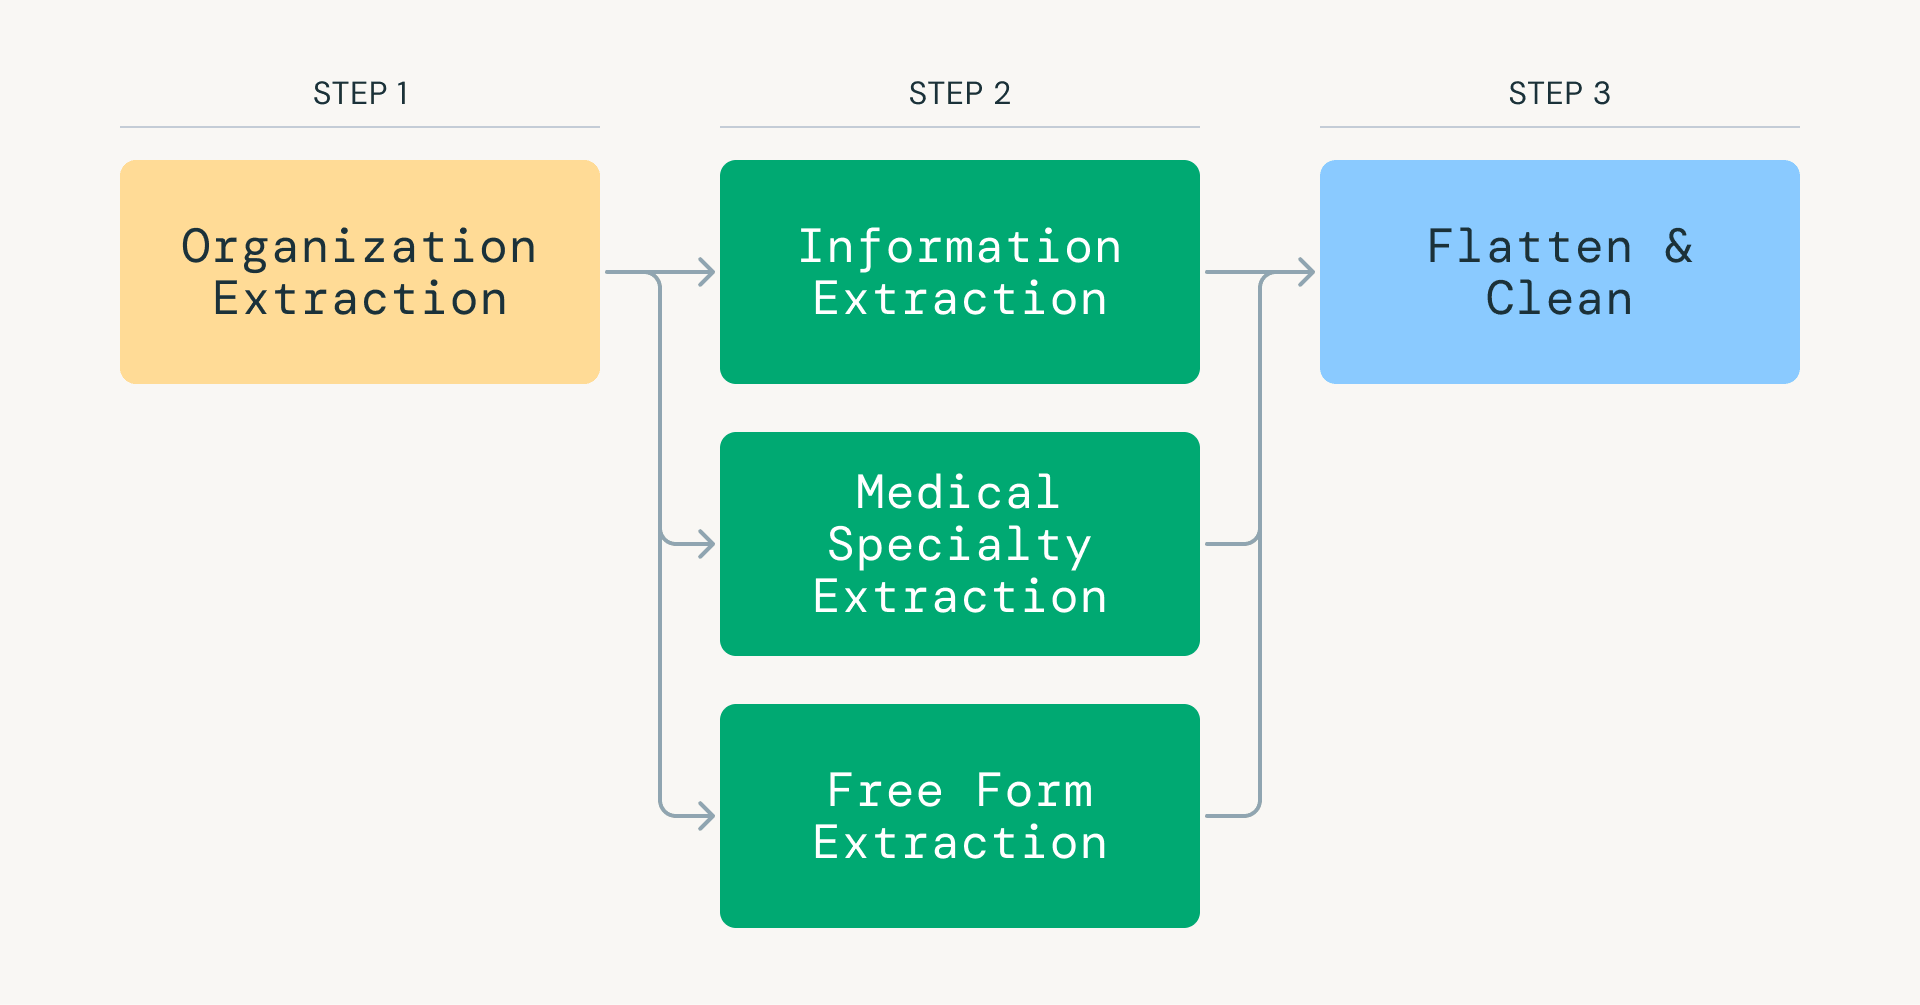
Cette approche réduit considérablement la consommation de jetons (tokens) tout en concentrant chaque appel de modèle sur une tâche précise et ciblée. Databricks et Apache Spark sont utilisés pour orchestrer et paralléliser efficacement les données récupérées, en répartissant les charges de travail sur des milliers d'exécuteurs et en permettant une inférence LLM à haut débit.
Plusieurs fonctionnalités critiques rendent ce pipeline évolutif et prêt pour la production :
- Modélisation des données extensible : les données de chaque étape sont stockées dans un schéma en étoile, ce qui simplifie les analyses en aval et améliore les performances des requêtes.
- Points de contrôle basés sur le statut : chaque enregistrement suit son état de traitement, ce qui permet aux pipelines de reprendre à partir de n'importe quel point sans retraiter les lignes avec des appels LLM coûteux.
- Registre d'extraction configurable : chaque méthode d'extraction est contrôlée par un objet structuré spécifiant le prompt système, ce qui rend la logique d'extraction modulaire, reproductible et extensible.
- Traitement distribué évolutif : le système traite des charges de travail asymétriques de plusieurs téraoctets en utilisant Spark pour le parallélisme, Photon pour les performances à l'échelle et une orchestration de niveau production.
Ces garanties sont appliquées via Lakeflow Jobs, qui orchestrent plus de 15 tâches interdépendantes avec des branchements conditionnels, une exécution parallèle et des politiques de relance intelligentes. Le résultat est un système qui traite les données des établissements de santé à grande échelle avec la précision d'experts médicaux.
Résolution d'entités à grande échelle
Une fois les données des établissements et des organisations à but non lucratif récupérées et extraites à l'aide d'un LLM, un défi classique apparaît : la résolution d'entités. Le même établissement peut apparaître dans plusieurs sources de données avec des variations de nom, des adresses incohérentes ou des coordonnées manquantes. La déduplication traditionnelle échoue dans ces scénarios en raison de données désordonnées ; nous utilisons donc Splink, un framework open source de liaison probabiliste d'enregistrements. En utilisant les informations issues de notre étape IE, Splink évalue les paires de correspondances via des comparaisons pondérées sur des champs tels que le numéro de téléphone, l'adresse postale, etc. Le résultat est une clé unifiée par établissement, garantissant que les utilisateurs finaux voient un enregistrement de référence unique pour chaque établissement médical et NGO.
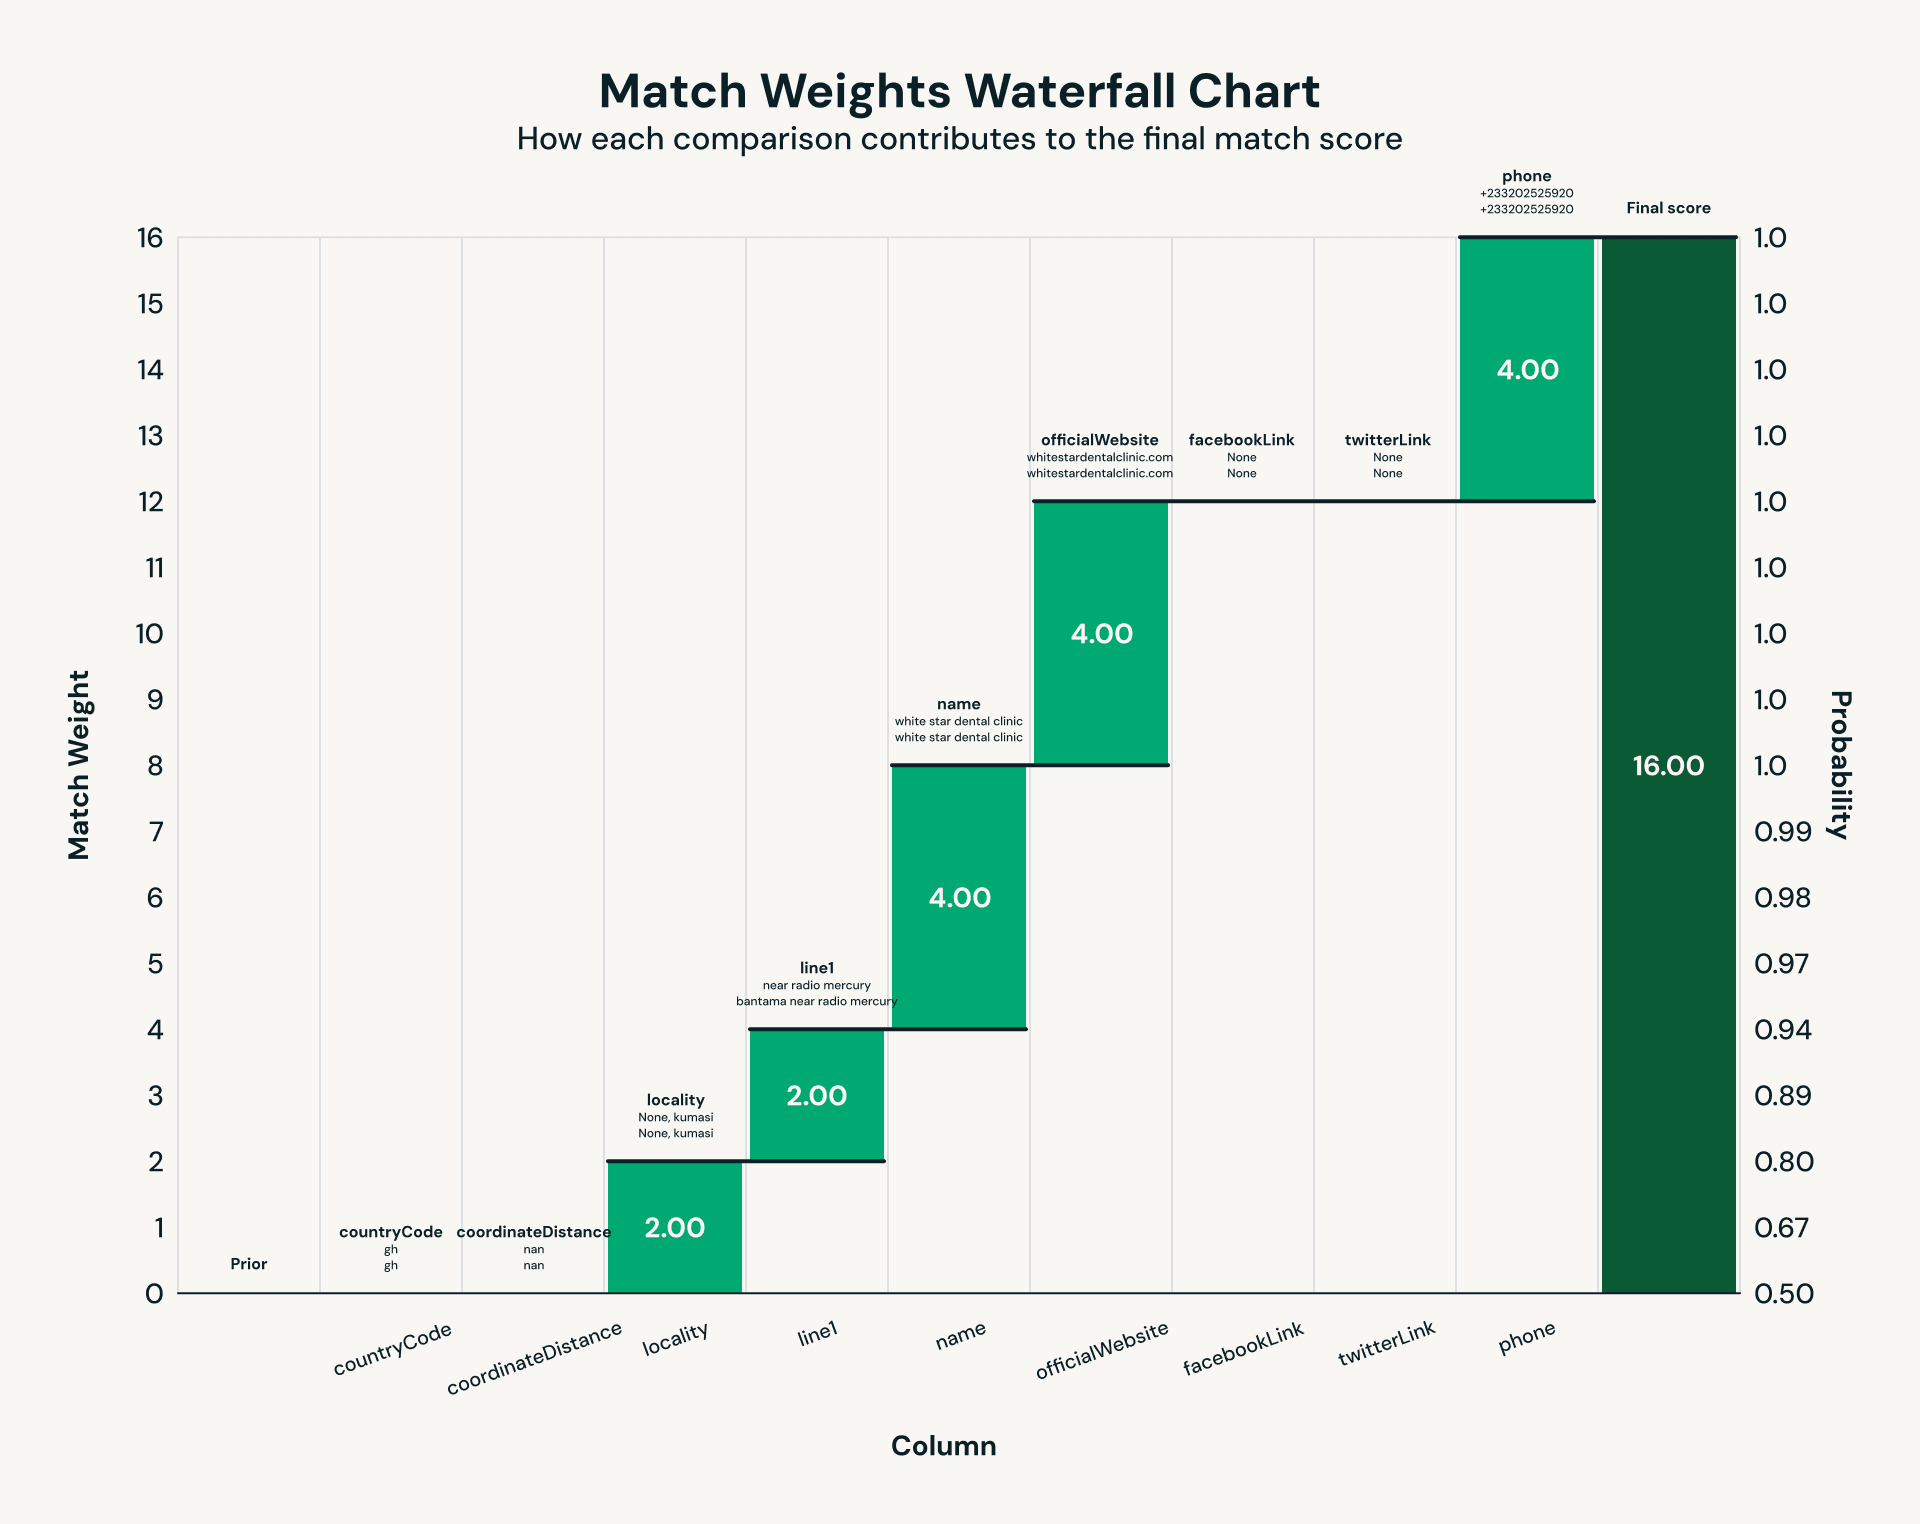
L'exécution de correspondances probabilistes sur des milliers d'établissements de santé et d'organisations à but non lucratif a révélé des goulots d'étranglement de performance classiques qui apparaissent à l'échelle du téraoctet. Le cœur de la liaison d'enregistrements est la comparaison par paires, ce qui crée des charges de travail intrinsèquement asymétriques : les comparaisons courantes produisent des partitions massives tandis que la plupart des autres restent beaucoup plus petites. Les premiers lancements l'ont clairement démontré, avec une partition Spark s'exécutant pendant 30 minutes tandis que la médiane se terminait en 52 secondes – un cas d'école de traînards (la « malédiction du dernier réducteur ») dégradant les performances des tâches. L'activation de Photon, le moteur de requête vectorisé de Databricks, a réduit le temps de traitement des partitions de données dans le pire des cas de 30 minutes à environ 2 minutes, soit une amélioration de 15 fois.
VF Agent : le langage naturel au service des données de santé
Tournés vers l'avenir, nous avons développé un prototype d'agent qui permet aux experts d'analyser les données en langage naturel. Nous utilisons une architecture multi-agent construite dans LangGraph et exploitons Databricks Model Serving, AI Search et Genie.
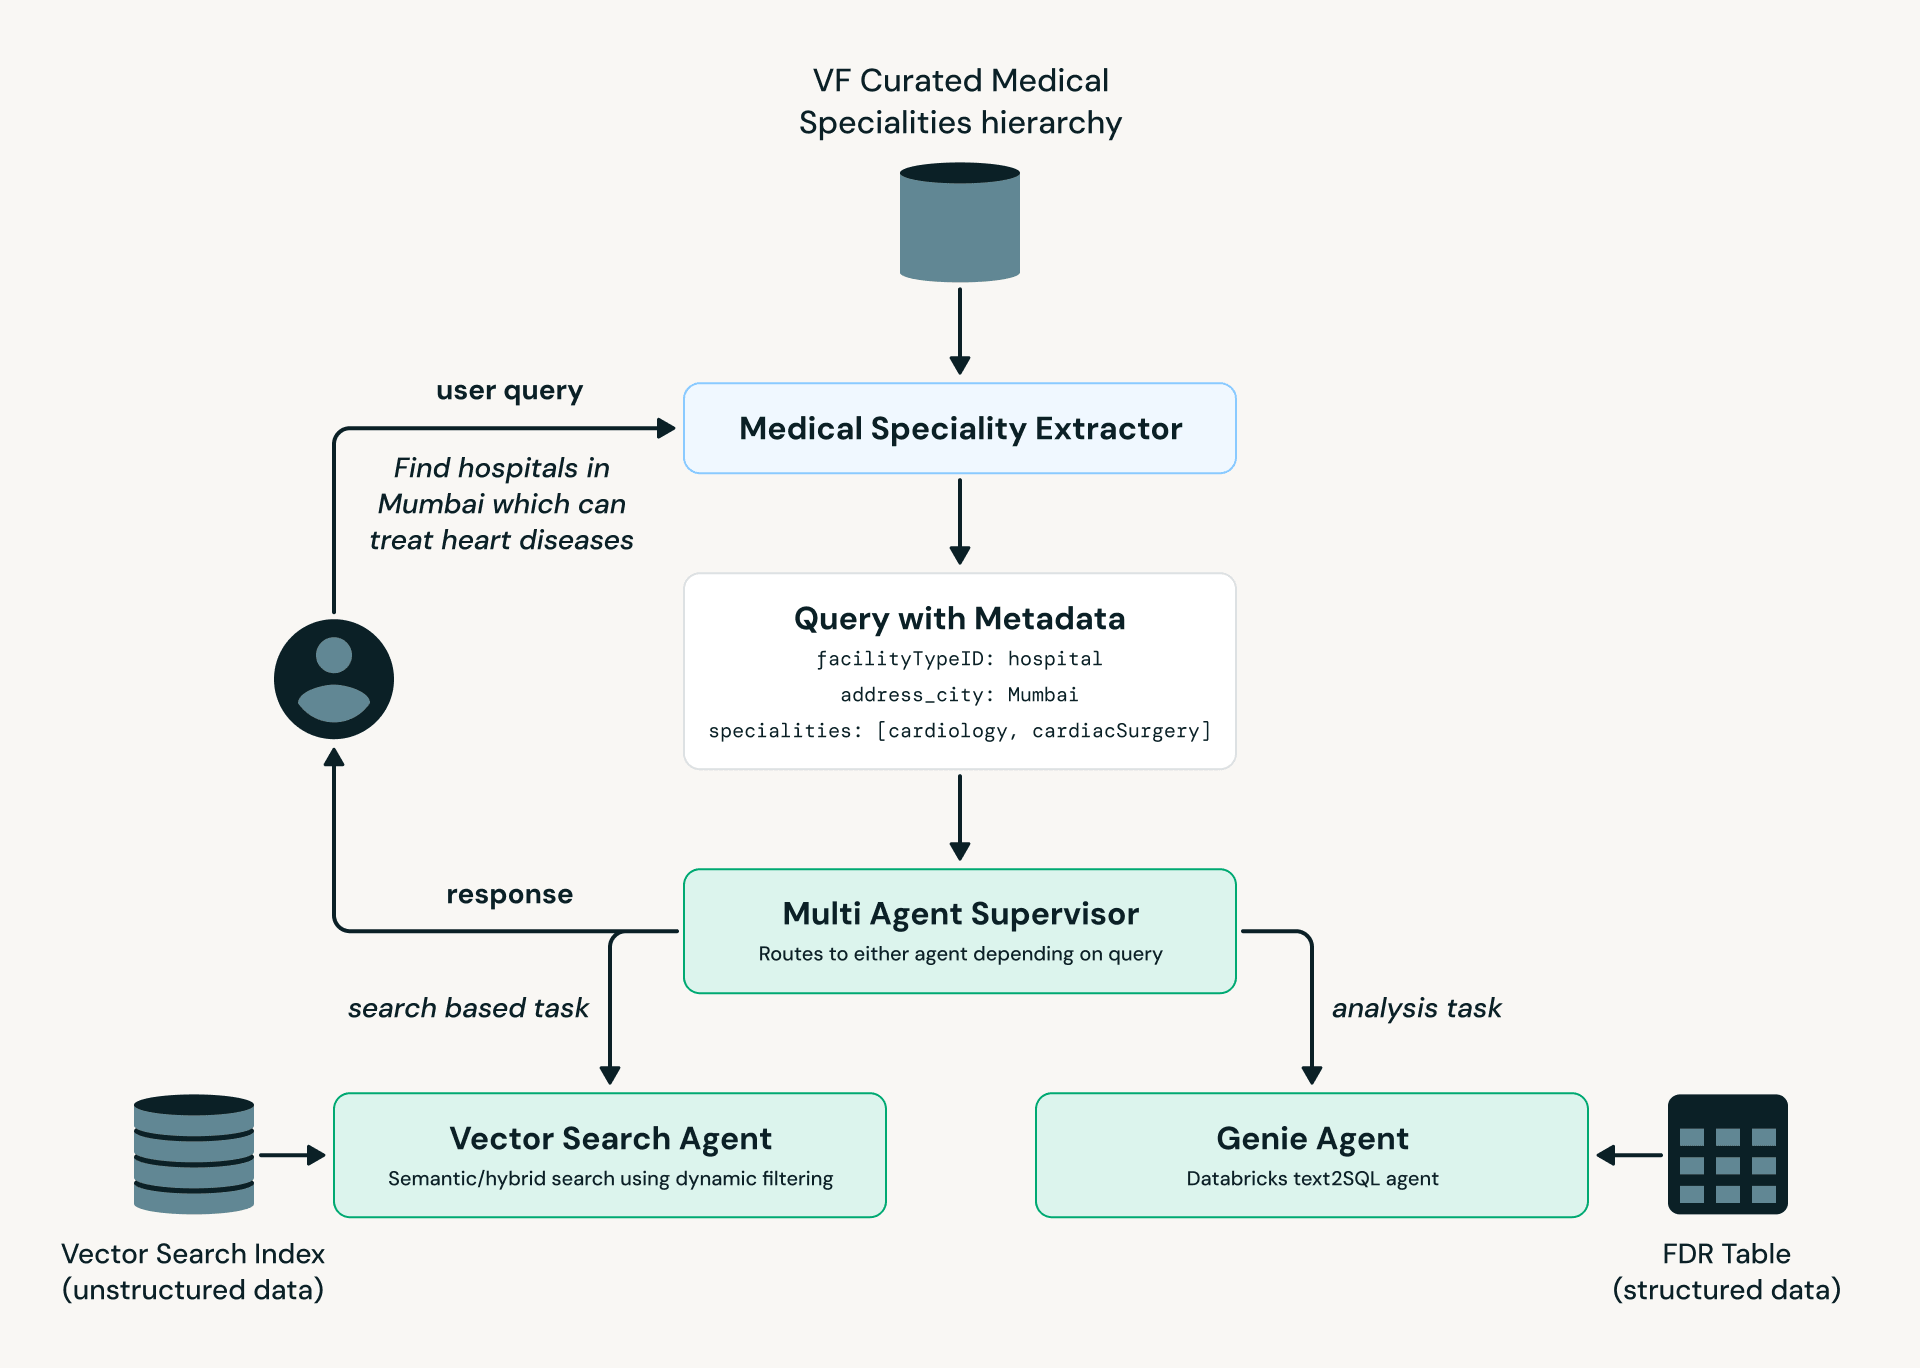
Comme l'illustre le schéma ci-dessus, le Medical Specialty Extractor convertit le langage de l'utilisateur en terminologie médicale standardisée, qui est ensuite transmise au Multi-Agent Supervisor. Selon l'intention et la complexité de la requête, celle-ci est orientée soit vers l'AI Search Agent (découverte et recherche d'établissements), soit vers l'Genie Agent (requêtes analytiques sur des données structurées).
Résumé
Les professionnels de la santé peuvent désormais découvrir plus rapidement des opportunités à jour, trouver des correspondances avec leurs spécialités médicales et accéder à des données mondiales sur des milliers d'établissements à travers le monde. Le parcours de Virtue Foundation, de la preuve de concept à la production, démontre ce qui est possible lorsque des systèmes d'IA avancés sont associés à une plateforme de données unifiée.
Le résultat final est une vision globale des infrastructures de santé, mettant en lumière les endroits où les bénévoles médicaux sont le plus nécessaires.
Si vous souhaitez en savoir plus sur ce projet, veuillez consulter :
- Présentation du projet Databricks x Virtue Foundation - YouTube
- Interview de l'ONU sur Bloomberg (YouTube) - vers la minute 38:00
- Témoignage vidéo : Bright Initiative x Virtue Foundation x Databricks
Découvrez-en plus sur certains de nos autres projets Databricks for Good ci-dessous :
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.