Cercare in un servizio gestito Postgres: una checklist per l'acquirente tecnico
Il Postgres gestito tradizionale eccelle nei carichi di lavoro transazionali ma compromette le query analitiche, e la maggior parte delle checklist di valutazione non rileva questa lacuna. Se stai valutando Postgres come un motore ibrido...
- Un servizio Postgres gestito dovrebbe essere valutato in base a ciò che è in grado di dimostrare in caso di guasto, ripristino e carico di produzione, e non solo per le funzionalità che pubblicizza.
- I controlli chiave includono alta affidabilità, disaster recovery, compatibilità con PostgreSQL, sicurezza, scalabilità, costo totale, controllo operativo e portabilità.
- Un flusso di lavoro di produzione dovrebbe testare le affermazioni del provider con test di failover, point-in-time recovery, carico e migrazione prima di adottare il servizio.
- Lakebase Postgres offre un servizio Postgres gestito e serverless con alta affidabilità automatica, autoscaling e funzionalità di sicurezza e governance di Databricks.
Managed è un'etichetta, non una specifica. Valuta un servizio di database cloud gestito in base a ciò che dimostra in caso di guasto e ripristino, e non a ciò che è elencato nella sua pagina delle funzionalità.
Un servizio Postgres gestito è un database PostgreSQL in cui il provider gestisce l'infrastruttura sottostante e automatizza l'amministrazione del database, come l'applicazione di patch, i backup, il failover e lo scaling. La quantità di attività effettivamente gestite dal provider varia a seconda del servizio, il che rende "gestito" un'etichetta anziché una specifica completa. I principali provider cloud, tra cui AWS, Microsoft Azure e Google Cloud, offrono servizi PostgreSQL gestiti, così come i vendor focalizzati sui database.
Un provider potrebbe pubblicizzare un'elevata disponibilità, backup automatizzati o sicurezza di livello enterprise, ma queste affermazioni non dicono agli ingegneri della piattaforma o ai DBA cosa succede quando si guasta un nodo primario, quanto velocemente è possibile ripristinare un database o se è supportata un'estensione PostgreSQL richiesta. Quando si presenta un problema in produzione, ciò che conta è la rapidità con cui il team riesce a individuarlo e risolverlo.
Ingegneri di piattaforma, DBA, data architect e engineering manager che valutano un servizio Postgres gestito per la produzione. Copre le aree che tendono a causare problemi dopo la migrazione, come il controllo operativo, l'elevata disponibilità, il disaster recovery, lo scaling e così via. Ogni sezione esamina ciò che il provider dovrebbe supportare, le domande da porre durante una valutazione e come testare le risposte in un pilota. Se sei un DBA o un ingegnere di piattaforma che sta pianificando una transizione, usa questo articolo come una checklist operativa piuttosto che come una lettura una tantum.
La checklist del servizio Postgres gestito in sintesi
Una valutazione di Postgres gestito dovrebbe coprire molto più del semplice provisioning del database e dell'amministrazione quotidiana. La tabella seguente offre ai team un punto di partenza per le funzionalità da verificare e le risposte che dovrebbero far scattare un controllo più approfondito.
| Area | Cosa verificare | Campanello d'allarme |
|---|---|---|
| Ambito operativo | Chi si occupa di patch, aggiornamenti e ottimizzazione e quali controlli del database rimangono disponibili | "Gestito" copre solo la macchina virtuale e il sistema operativo |
| Elevata disponibilità | Failover automatico, garanzie sulle transazioni di cui è stato fatto il commit e se il failover funziona tra zone di disponibilità | Nessun Recovery Point Objective (RPO) dichiarato o promozione manuale |
| Backup e disaster recovery | Ripristino a un punto specifico nel tempo (PITR), opzioni di ripristino, retention, ripristino cross-region e obiettivi di ripristino | Il disaster recovery è disponibile solo tramite richiesta di supporto senza alcun RPO o Recovery Time Objective (RTO) dichiarato |
| Scaling e prestazioni | Comportamento di ridimensionamento, repliche di lettura, connection pooling, storage e modello di operazioni di input/output al secondo (IOPS) | Lo scaling verticale richiede un tempo di inattività prolungato |
| Sicurezza e conformità | Connettività privata, controlli di identità e accesso, chiavi gestite dal cliente, log di audit e ambito di conformità | È richiesta la connettività pubblica o le chiavi di crittografia possono essere controllate solo dal provider |
| Compatibilità ed estensioni | Versioni di PostgreSQL supportate, estensioni, driver, parametri e restrizioni per i superuser | Un'estensione critica o una funzionalità PostgreSQL richiesta non sono supportate |
| Migrazione | Percorsi di migrazione supportati, replica logica e opzioni di change data capture (CDC) | I database di grandi dimensioni possono essere migrati solo tramite dump e ripristino |
| Prezzi e costo totale | Costi di calcolo, storage, IOPS, backup, repliche, traffico di rete in uscita e supporto esteso | Solo il prezzo del calcolo è chiaro |
| Operatività | Metriche del database, log, avvisi e accesso al supporto a livello di PostgreSQL | Osservabilità del database limitata o assenza di escalation agli esperti di PostgreSQL |
| Portabilità e uscita | Esportazioni standard e replica logica verso un altro ambiente PostgreSQL | I dati possono uscire solo tramite un formato proprietario o una richiesta di supporto |
1. Ambito operativo e controllo
La prima cosa da verificare è dove finisce la responsabilità del provider e dove inizia quella del team di database. Un servizio gestito dovrebbe occuparsi dell'infrastruttura e delle operazioni di routine del database senza rimuovere i controlli PostgreSQL da cui dipende un carico di lavoro di produzione. I provider che definiscono un servizio come completamente gestito non intendono sempre la stessa cosa.
Inizia con la manutenzione. Chiedi se gli aggiornamenti delle versioni minori sono automatici, se i team possono scegliere una finestra di manutenzione, con quanto preavviso i provider avvisano prima delle modifiche e se gli aggiornamenti richiedono un riavvio o un failover. Gli aggiornamenti delle versioni principali meritano un'attenzione particolare. PostgreSQL supporta ogni versione principale per cinque anni; pertanto, i team dovrebbero capire per quanto tempo il provider supporta ciascuna versione e cosa succede quando tale supporto termina. Richiedi la data di fine vita (end-of-life) utilizzata dal provider per ciascuna versione. In generale, minore è il preavviso dato dal provider prima di aggiornare un database, più è difficile pianificare di conseguenza.
L'accesso alla configurazione è un'altra fonte comune di sorprese. I servizi gestiti spesso limitano l'accesso come superuser e limitano i parametri o i comandi che potrebbero influenzare l'infrastruttura sottostante. Prima di effettuare la migrazione, verifica quali ruoli sono disponibili, quali parametri possono essere modificati, se ALTER SYSTEM è supportato e quali comandi PostgreSQL sono limitati. Ad esempio, alcuni servizi consentono di modificare una serie di parametri tramite una console o un'API, ma bloccano completamente il comando ALTER SYSTEM.
- Chiedi come funzionano gli aggiornamenti delle versioni minori e principali, comprese le finestre di manutenzione, le notifiche e le politiche di fine supporto.
- Chiedi quali ruoli, parametri e comandi PostgreSQL sono limitati.
- Dimostralo applicando un aggiornamento minore nel pilota e misurando l'effetto sulle connessioni attive e sul traffico dell'applicazione.
- Un campanello d'allarme è un servizio che si definisce completamente gestito ma lascia l'applicazione di patch, gli aggiornamenti o le attività di manutenzione critica al team di database, o un servizio che non è in grado di documentare chiaramente i propri limiti di configurazione e aggiornamento.
2. Elevata disponibilità e failover automatico
Il failover automatico nei database Postgres significa che il servizio può promuovere automaticamente un'istanza di standby in un'altra zona di disponibilità e dichiarare chiaramente cosa succede alle transazioni di cui è stato fatto il commit durante il failover. L'elevata disponibilità protegge dai guasti all'interno di una regione, ma non equivale al disaster recovery.
Chiedi se lo standby utilizza la replica sincrona o asincrona, quale punto di ripristino è supportato dal provider e se l'endpoint del database rimane lo stesso dopo la promozione. Di solito le applicazioni dovranno riconnettersi dopo la caduta delle connessioni esistenti, quindi il provider deve documentare il comportamento previsto. In un cluster a più nodi, conferma quali nodi possono essere promossi e come le applicazioni trovano il nuovo nodo primario. Assicurati che i connection pool e i driver, sia in Python che in un altro linguaggio, gestiscano la riconnessione in modo pulito.
- Chiedi se l'elevata disponibilità utilizza la replica sincrona e se lo standby viene eseguito in una zona di disponibilità separata.
- Chiedi quanto dura tipicamente il failover e se le transazioni di cui è stato fatto il commit vengono preservate.
- Dimostralo attivando un failover, cronometrando il ripristino e verificando gli errori dell'applicazione, le scritture di cui è stato fatto il commit e il comportamento della replica.
- Un campanello d'allarme è la promozione manuale o l'assenza di garanzie chiare sulle transazioni di cui è stato fatto il commit.
3. Backup, ripristino a un punto specifico nel tempo e disaster recovery
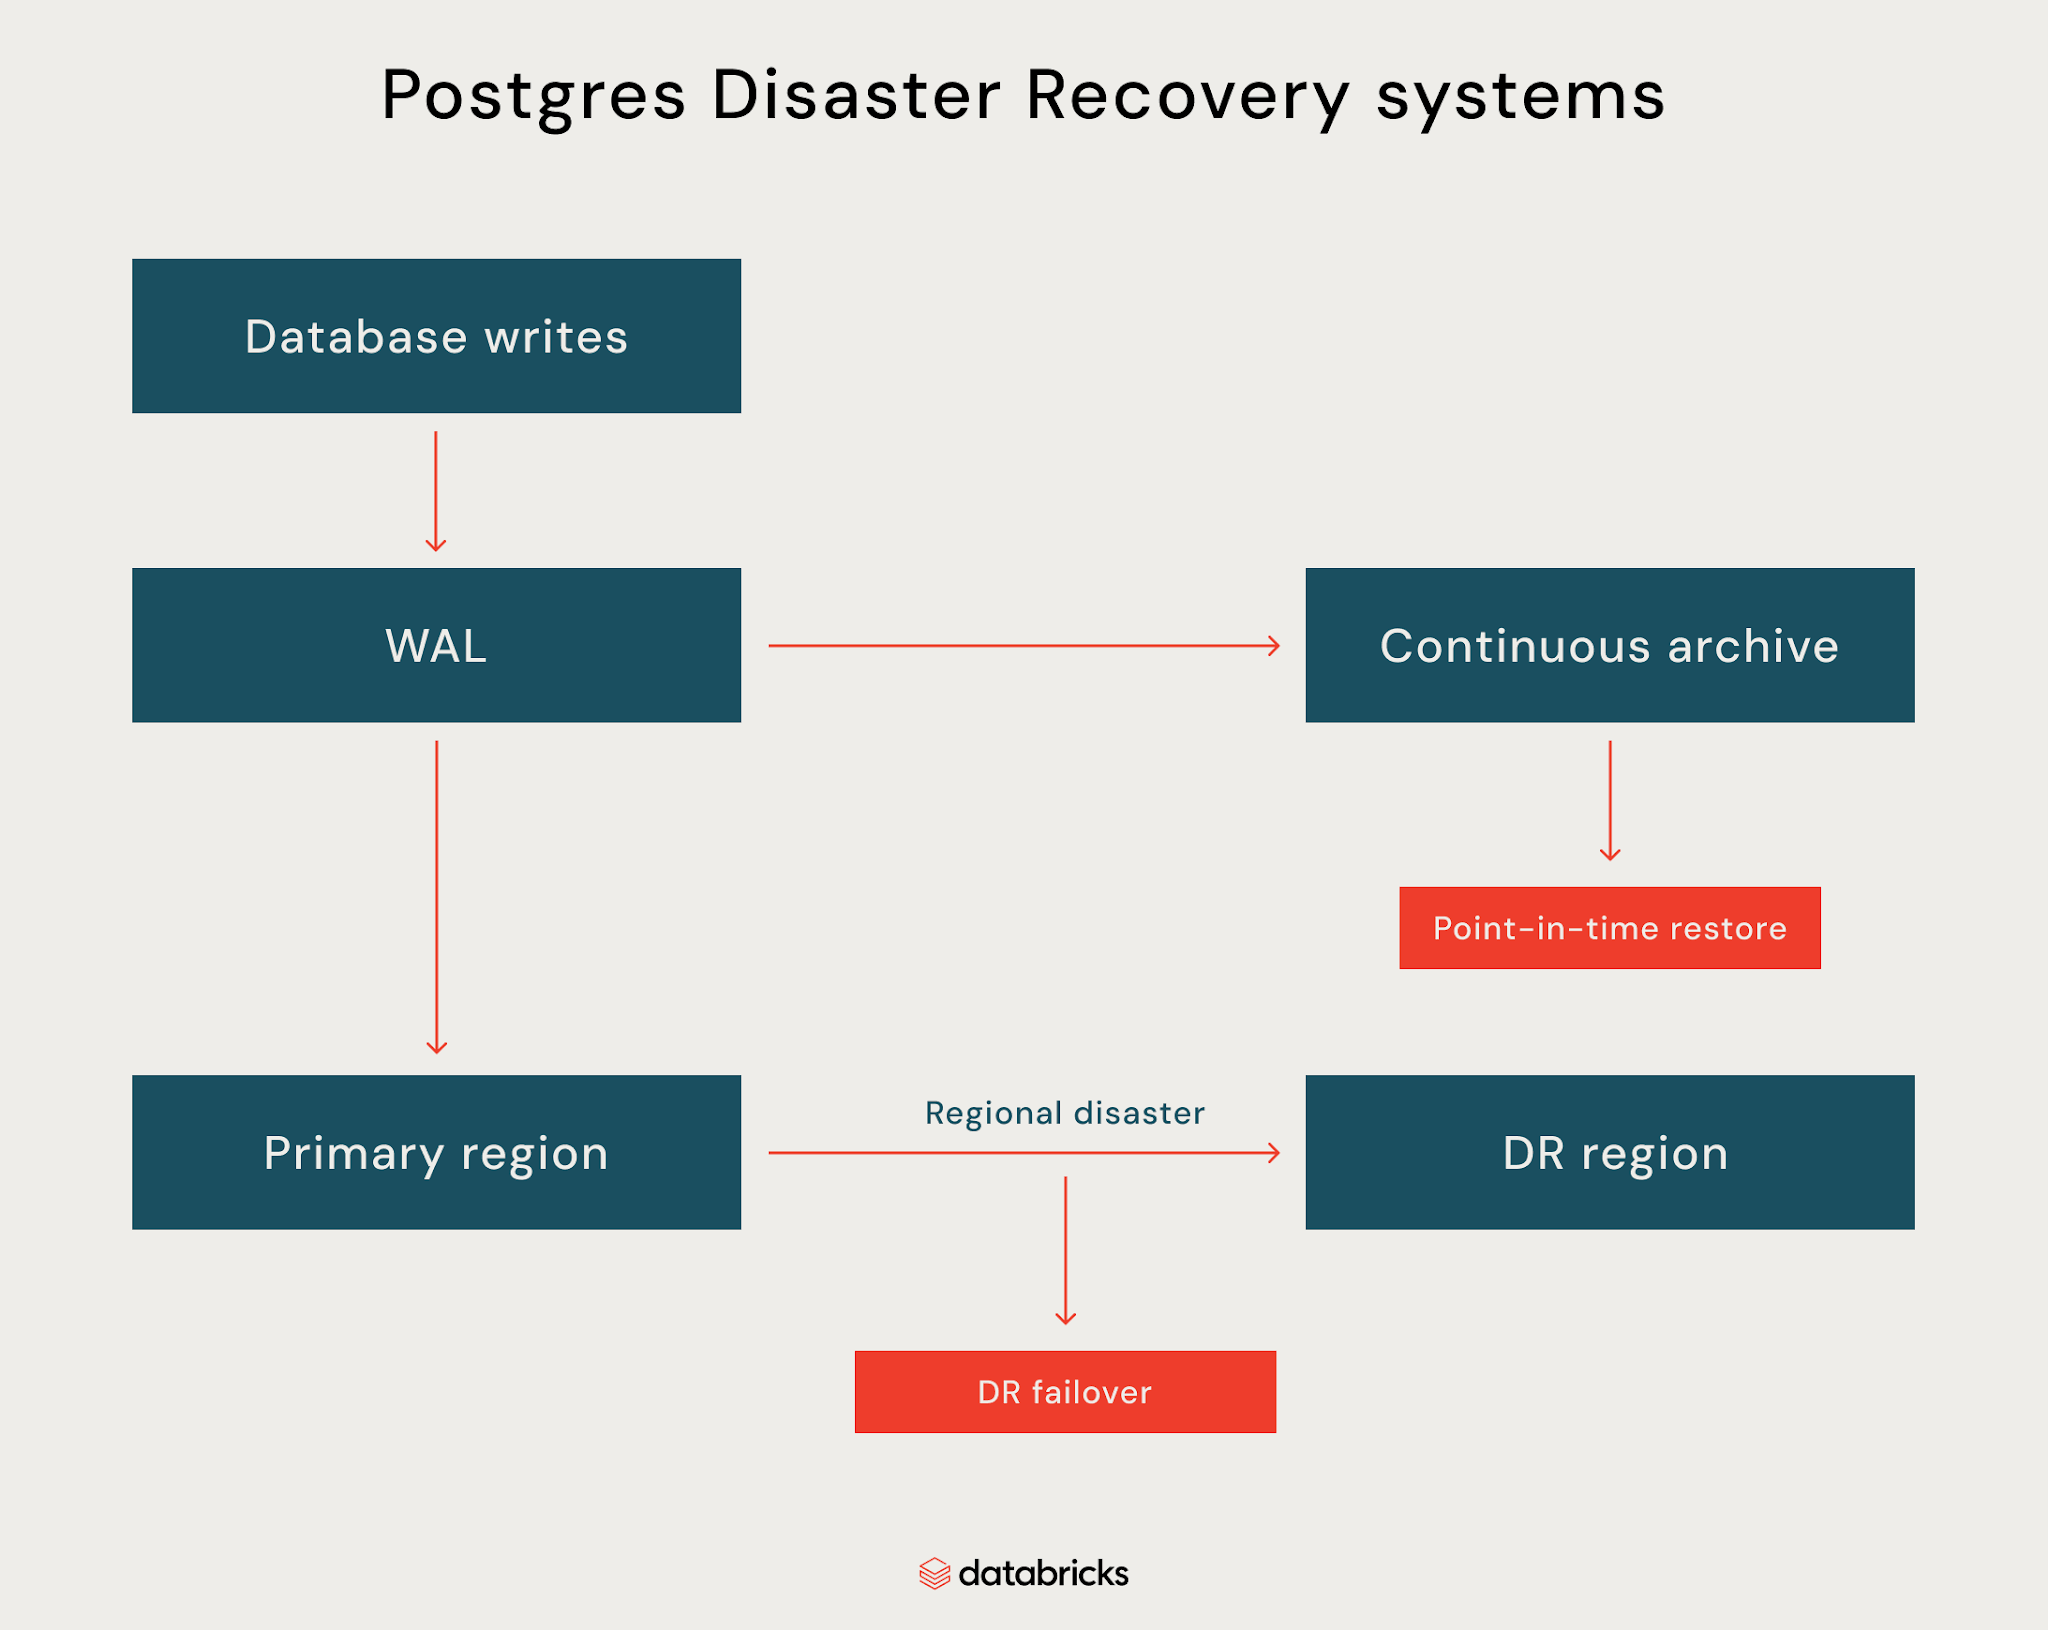
I backup e il disaster recovery (DR) sono importanti nei database. Verifica che i backup possano ripristinare il database a un punto noto nel tempo e che il provider dichiari chiaramente i suoi obiettivi di ripristino. L'RPO definisce la quantità di dati che un carico di lavoro può permettersi di perdere. L'RTO definisce per quanto tempo il database può rimanere non disponibile.
Chiedi se il servizio archivia continuamente il log Write-Ahead (WAL), per quanto tempo il ripristino a un punto specifico nel tempo rimane disponibile e se i ripristini sono self-service. Per il disaster recovery, verifica se la replica cross-region è continua o periodica, se il failover è automatico o manuale e se il provider pubblica gli obiettivi RPO e RTO. I backup automatizzati combinati con l'archiviazione continua dei WAL rendono possibili il ripristino a un punto specifico nel tempo e un recupero affidabile dei dati.
- Chiedi se è possibile ripristinare il database a un timestamp specifico e quanto tempo richiede solitamente il processo.
- Verifica i record critici e le letture dell'applicazione dopo il ripristino.
- Esegui un'esercitazione di disaster recovery se il provider ne supporta una e documenta i passaggi di ripristino.
- Un segnale d'allarme è un disaster recovery disponibile solo tramite una richiesta di supporto o privo di RPO o RTO pubblicati.
4. Scalabilità e prestazioni
Verifica come il servizio gestisce la crescita di elaborazione, archiviazione, connessioni e traffico di lettura. La scalabilità non deve introdurre tempi di inattività imprevisti né richiedere la gestione manuale dell'infrastruttura.
Chiedi se la capacità di calcolo può essere scalata verticalmente, se sono disponibili repliche di lettura, come scalano l'archiviazione e le operazioni di input/output al secondo (IOPS) e se il connection pooling è integrato. Per i servizi con scalabilità automatica, controlla cosa attiva la scalabilità, la rapidità con cui cambia la capacità e se la scalabilità influisce sulle connessioni o transazioni attive. Nella maggior parte dei servizi gestiti, la scalabilità di CPU e RAM richiede solitamente pochi clic o una singola chiamata API, consentendo ai team di adeguare la capacità alla crescita degli utenti anziché avviare nuova infrastruttura.
- Chiedi se la scalabilità verticale richiede un riavvio o un failover.
- Chiedi come cresce l'archiviazione e se esistono limiti su connessioni, IOPS o repliche.
- Dimostralo eseguendo un carico di produzione rappresentativo e testando un aumento di scala durante il traffico attivo.
- Misura la latenza delle query, gli errori di connessione e il comportamento dell'applicazione prima e dopo la scalabilità.
- Un segnale d'allarme è una scalabilità che richiede tempi di inattività prolungati o presenta limiti di capacità non documentati.
5. Sicurezza, conformità e controllo degli accessi
Verifica in che modo il servizio protegge i dati in transito e a riposo, controlla l'accesso al database e si connette alla rete. Le funzionalità di sicurezza dovrebbero essere in linea con i requisiti di identità e conformità esistenti dell'organizzazione anziché richiedere un modello operativo separato.
Chiedi se è supportata la connettività privata, come Identity and Access Management (IAM) si integra con i ruoli del database e se sono disponibili le chiavi gestite dal cliente (CMK). Controlla anche la registrazione dei controlli, i controlli di crittografia e l'ambito di conformità del provider. Chiedi se le applicazioni possono connettersi tramite un indirizzo IP privato, pubblico o entrambi. La maggior parte dei provider gestiti applica automaticamente la crittografia a riposo e in transito e applica patch di sistema operativo e aggiornamenti di sicurezza di routine, quindi conferma quali framework di conformità, come HIPAA o GDPR, sono supportati dal servizio.
- Chiedi se i database possono essere eseguiti senza accesso a Internet pubblico.
- Chiedi come vengono registrati l'attività del database, le azioni amministrative e gli eventi di autenticazione.
- Verifica che le chiavi di crittografia possano essere ruotate o revocate senza interrompere il database.
- Dimostralo connettendoti tramite il percorso di rete privata previsto e testando l'accesso con ruoli diversi.
- Un segnale d'allarme è un servizio che richiede connettività pubblica, offre visibilità di controllo limitata o non supporta i controlli di sicurezza richiesti dall'organizzazione.
6. Compatibilità con Postgres ed estensioni
Dovresti verificare che il servizio supporti le versioni di PostgreSQL, le estensioni, i driver e le opzioni di configurazione da cui dipende il carico di lavoro. La compatibilità deve essere testata sull'applicazione effettiva anziché dedotta dall'affermazione del provider di supportare PostgreSQL.
Verifica quali versioni di PostgreSQL sono disponibili, con quale rapidità vengono supportate le nuove versioni principali e quali estensioni sono abilitate. Verifica il supporto per le estensioni come pgvector, PostGIS e qualsiasi dipendenza specifica dell'applicazione. Conferma anche quali parametri, ruoli e comandi PostgreSQL sono limitati. Controlla se le restrizioni del superutente influiscono su tabelle, funzioni o estensioni esistenti e se gli oggetti presenti nel database corrente devono essere modificati. I team autogestiti spesso eseguono PostgreSQL su Ubuntu o un'altra distribuzione Linux con accesso completo al sistema operativo, quindi le dipendenze dal sistema operativo dovrebbero essere identificate tempestivamente.
- Richiedi l'elenco completo delle estensioni supportate e delle limitazioni specifiche della versione.
- Chiedi se i driver dell'applicazione, gli ORM e gli strumenti PostgreSQL standard funzionano senza modifiche.
- Testa tutte le estensioni richieste e i parametri del database prima della migrazione.
- Dimostralo ripristinando uno schema rappresentativo ed eseguendo le migrazioni e i test di integrazione dell'applicazione.
- Un segnale d'allarme è un'estensione critica non supportata o una compatibilità che dipende da soluzioni alternative non documentate.
Per i carichi di lavoro di intelligenza artificiale, il supporto per pgvector è importante per la ricerca vettoriale insieme ai carichi di lavoro transazionali.
Il playbook sull'AI agentiva per l'enterprise

7. Percorsi di migrazione da Postgres e altri database
Verifica in che modo il provider supporta sia la migrazione iniziale dei dati che il cutover finale. Un metodo di migrazione che funziona per un piccolo database potrebbe non essere pratico per un sistema di produzione che deve continuare a gestire il traffico durante lo spostamento.
Chiedi se il servizio supporta la replica logica, Change Data Capture (CDC), gli strumenti nativi PostgreSQL e servizi di migrazione di terze parti. Per le migrazioni da altri motori di database, controlla quali sistemi di origine sono supportati e come vengono gestite la conversione dello schema, la convalida dei dati e le modifiche all'applicazione. Lo spostamento di un database di produzione da altri database come Oracle o SQL Server richiede inoltre la conversione dello schema e il test dell'applicazione.
- Chiedi se i database di grandi dimensioni possono essere migrati senza tempi di inattività prolungati.
- Chiedi come vengono replicate le modifiche in corso durante la finestra di migrazione.
- Dimostralo migrando un set di dati rappresentativo, eseguendo controlli di convalida e misurando il tempo di cutover finale.
- Un segnale d'allarme è un processo di migrazione che dipende interamente dal backup e ripristino o richiede tempi di inattività dell'applicazione prolungati.
La tua soluzione di migrazione dovrebbe tenere conto delle dipendenze nell'ambiente dati e ridurre al minimo le interruzioni.
8. Prezzi e costo totale di proprietà
Un servizio gestito può comportare costi aggiuntivi per archiviazione, backup, disponibilità elevata, repliche, trasferimento di rete e altre risorse basate sull'utilizzo. Gran parte del risparmio rispetto alle distribuzioni autogestite deriva dall'evitare hardware e manutenzione locali, quindi scopri quali funzionalità sono incluse nel prezzo base e quali sono componenti aggiuntivi a pagamento.
Controlla come vengono fatturati calcolo, archiviazione, IOPS, backup, repliche e traffico di rete in uscita. Verifica se i prezzi cambiano con la scalabilità automatica, la capacità di standby o configurazioni a maggiore disponibilità.
- Modella sia l'utilizzo normale che quello di picco, inclusi la crescita dello spazio di archiviazione e la conservazione dei backup.
- Calcola il costo totale di proprietà (TCO) per il periodo di contratto previsto.
- Dimostralo creando un modello TCO di 12 mesi che copra risorse di calcolo, capacità di standby per l'alta disponibilità, IOPS, backup, repliche e traffico di rete in uscita per il carico di lavoro previsto. Non utilizzare solo la voce di calcolo.
- Un segnale d'allarme è un prezzo che mostra solo il calcolo del database lasciando incerti i costi di archiviazione, backup, repliche o rete.
I prezzi basati sull'utilizzo possono rendere più facile allineare i costi alla domanda del carico di lavoro, ma i team dovrebbero comunque modellare modelli di traffico realistici prima di impegnarsi.
9. Operazioni, monitoraggio e risoluzione dei problemi
Un servizio di produzione richiede una visibilità sufficiente affinché i team di database possano comprendere cosa sta accadendo quando le prestazioni o l'affidabilità si degradano. Le metriche dell'infrastruttura da sole sono raramente sufficienti per diagnosticare i problemi di PostgreSQL.
Chiedi se il servizio espone metriche del database, log e informazioni a livello di query, e se i team possono configurare avvisi per condizioni importanti. Scopri quale supporto hanno gli ingegneri durante gli incidenti e se gli specialisti PostgreSQL sono disponibili per le escalation. Cerca dashboard con visibilità in tempo reale sulle metriche di sistema, verifica se i log possono essere filtrati per database o utente e se puoi ordinare gli eventi per ora o gravità. Considera anche se il tuo team ha le competenze per risolvere i problemi di PostgreSQL utilizzando solo gli strumenti del provider.
- Chiedi quali metriche, log e statistiche di query di PostgreSQL sono disponibili.
- Chiedi se i dati di monitoraggio possono essere esportati nella piattaforma di osservabilità esistente dell'organizzazione.
- Dimostralo generando un problema di prestazioni controllato e utilizzando gli strumenti disponibili per identificare la causa principale.
- Un segnale d'allarme è una visibilità limitata a livello di database o un modello di supporto che non è in grado di investigare problemi specifici di PostgreSQL.
Per le distribuzioni di grandi dimensioni, chiedi se gli strumenti del provider possono far emergere modelli in tutti i tuoi database, anziché limitarsi alle metriche per singola istanza.
10. Portabilità e uscita
Un servizio Postgres gestito dovrebbe rendere possibile spostare dati e applicazioni in un altro ambiente PostgreSQL senza dipendere da processi di esportazione proprietari.
Chiedi se è possibile utilizzare strumenti PostgreSQL standard e la replica logica per estrarre i dati. Scopri se estensioni, API o formati di archiviazione specifici del provider renderebbero più difficile l'uscita. Più funzionalità uniche del provider dipendono da un'applicazione, più difficile diventa l'uscita.
- Chiedi come funziona un'esportazione completa del database e se può essere eseguita senza il supporto del provider.
- Chiedi se la replica logica può trasmettere flussi di dati a un altro ambiente PostgreSQL.
- Dimostralo ripristinando un'esportazione in un ambiente PostgreSQL separato ed eseguendo test applicativi.
- Un segnale d'allarme sono dati che possono essere esportati solo tramite una richiesta di supporto o un formato proprietario.
Come eseguire un progetto pilota prima di impegnarsi
Un progetto pilota dovrebbe testare le affermazioni del provider su un carico di lavoro che assomiglia alla produzione. Una checklist di funzionalità può mostrare cosa offre un servizio, ma i test controllati di errore e recupero mostrano se tali capacità funzionano quando conta.
Inizia con un database rappresentativo, il traffico dell'applicazione e le estensioni PostgreSQL richieste dal sistema di produzione. Quindi testa le aree con maggiori probabilità di influenzare la decisione. Se preferisci un approccio graduale, parti da un carico di lavoro non critico ed espandi il progetto pilota un po' alla volta.
- Esegui un failover e misura il tempo di recupero, il ripristino della connessione e le transazioni perse.
- Ripristina il database a un punto specifico nel tempo e confronta il risultato con RPO e RTO attesi.
- Applica un carico di picco rappresentativo e testa la scalabilità mentre l'applicazione rimane attiva.
- Esegui test di migrazione e rollback, comprese eventuali estensioni richieste e modifiche all'applicazione.
- Testa il monitoraggio e l'escalation del supporto.

Registra i risultati rispetto ai requisiti originali e tratta i test non superati come punti critici per le decisioni. Il branching del database può anche aiutare i team a creare ambienti isolati per i test di migrazione e applicativi. Raccogli i risultati in un formato coerente in modo che la discussione post-pilota tra i team di ingegneria, sicurezza e finanza rimanga oggettiva.
Come Lakebase si mappa su questa checklist
Lakebase si mappa bene su diverse aree coperte in questa checklist. La tabella seguente mostra dove le sue funzionalità si allineano con i requisiti di produzione comuni, insieme ad aree che richiedono ancora una valutazione più approfondita.
| Area della checklist | Come si mappa Lakebase |
|---|---|
| Operazioni | Postgres gestito e serverless con operazioni di infrastruttura automatizzate. |
| Alta disponibilità | Promozione automatica tra zone di disponibilità preservando le transazioni convalidate. Le connessioni esistenti devono riconnettersi dopo il failover. |
| Scalabilità | Autoscaling con risorse di calcolo separate dallo storage, consentendo alla capacità di adattarsi alla domanda del carico di lavoro. |
| Sicurezza | Supporta networking privato e chiavi gestite dal cliente, insieme alle funzionalità di governance di Databricks. |
| Compatibilità PostgreSQL | Supporta strumenti ed estensioni PostgreSQL, incluso pgvector. |
| Ripristino di emergenza | Il DR cross-region è attualmente in Private Preview su AWS con failover manuale. Se il DR regionale è un requisito fondamentale, contatta il tuo team di account per maggiori informazioni. |
| Costi | La tariffazione basata sull'utilizzo può allineare i costi alla domanda del carico di lavoro, ma i team dovrebbero modellare il carico di lavoro previsto e i modelli di utilizzo. |
| Portabilità | La compatibilità standard con PostgreSQL fornisce una base per la migrazione e i test di uscita, ma le dipendenze specifiche del provider dovrebbero comunque essere valutate. |
La checklist offre ai team un modo coerente per confrontare Lakebase, altri servizi Postgres gestiti e distribuzioni self-managed rispetto ai loro requisiti di produzione.
Per i team che valutano Postgres gestito, la domanda importante è quanta parte del lavoro operativo viene effettivamente tolta dal loro piatto. Lakebase gestisce gran parte di quel lavoro all'interno di una regione, mentre il ripristino di emergenza cross-region rimane un'area in cui i team hanno ancora responsabilità.
Lakebase Postgres promuove automaticamente le risorse di calcolo secondarie tra le zone di disponibilità preservando le transazioni convalidate e mantenendo invariata la stringa di connessione. Le connessioni esistenti devono comunque riconnettersi.

Lakebase documenta il ripristino di emergenza cross-region come Private Preview su AWS con failover manuale, di cui tenere conto quando il ripristino regionale è un requisito di produzione.
Lakebase inoltre separa le risorse di calcolo dallo storage e supporta l'autoscaling, consentendo alla capacità di adattarsi alla domanda del carico di lavoro anziché dipendere solo dal dimensionamento fisso del database.
Per i team che utilizzano Databricks, il networking privato e le chiavi gestite dal cliente offrono ulteriori controlli per proteggere le distribuzioni di Lakebase.
Domande frequenti
Cosa dovrei cercare in un servizio Postgres gestito?
Concentrati sulle funzionalità che influenzano l'affidabilità e le operazioni di produzione. Alta disponibilità, backup, point-in-time recovery, ripristino di emergenza, scalabilità, sicurezza, compatibilità PostgreSQL, migrazione, costi e portabilità dovrebbero avere risposte chiare. I provider dovrebbero anche essere in grado di dimostrare affermazioni importanti attraverso la documentazione e un progetto pilota simile alla produzione. Ogni argomento in questa checklist dovrebbe avere una risposta documentata prima di impegnarsi.
Quali sono i vantaggi di un servizio Postgres gestito?
Un servizio gestito può ridurre il lavoro operativo associato all'esecuzione di PostgreSQL assumendosi la responsabilità di infrastruttura, manutenzione, backup e altre attività di routine. Può anche fornire funzionalità integrate per disponibilità, scalabilità, sicurezza e monitoraggio. Il valore dipende da quanta responsabilità operativa si assume effettivamente il provider e se il servizio fornisce comunque i controlli richiesti dal carico di lavoro.
Qual è la differenza tra Postgres gestito e Postgres self-managed?
Postgres gestito sposta gran parte del lavoro di amministrazione di infrastruttura e database sul provider. Postgres self-managed offre ai team di ingegneria un maggiore controllo su infrastruttura, configurazione, estensioni e aggiornamenti, ma li rende anche responsabili dell'esecuzione di tali componenti. La scelta giusta dipende dalla capacità operativa dell'organizzazione, dai requisiti di controllo e dal carico di lavoro.
Come dovrei testare un servizio Postgres gestito prima della migrazione?
Usa un carico di lavoro rappresentativo e testa le funzionalità che contano di più per la produzione. Esegui test di failover, point-in-time recovery, scalabilità, migrazione e rollback. Misura i tempi di recupero, il comportamento delle connessioni, l'integrità dei dati e le prestazioni dell'applicazione. Il progetto pilota dovrebbe anche coprire il monitoraggio, l'escalation del supporto e l'esportazione dei dati. Qualsiasi funzionalità che non può essere dimostrata dovrebbe rimanere un rischio aperto.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.