Nativ verwaltete Orchestrierung für jeden Workload
Einheitliche Orchestrierung für Daten, Analytics und KI auf der Data + AI Platform.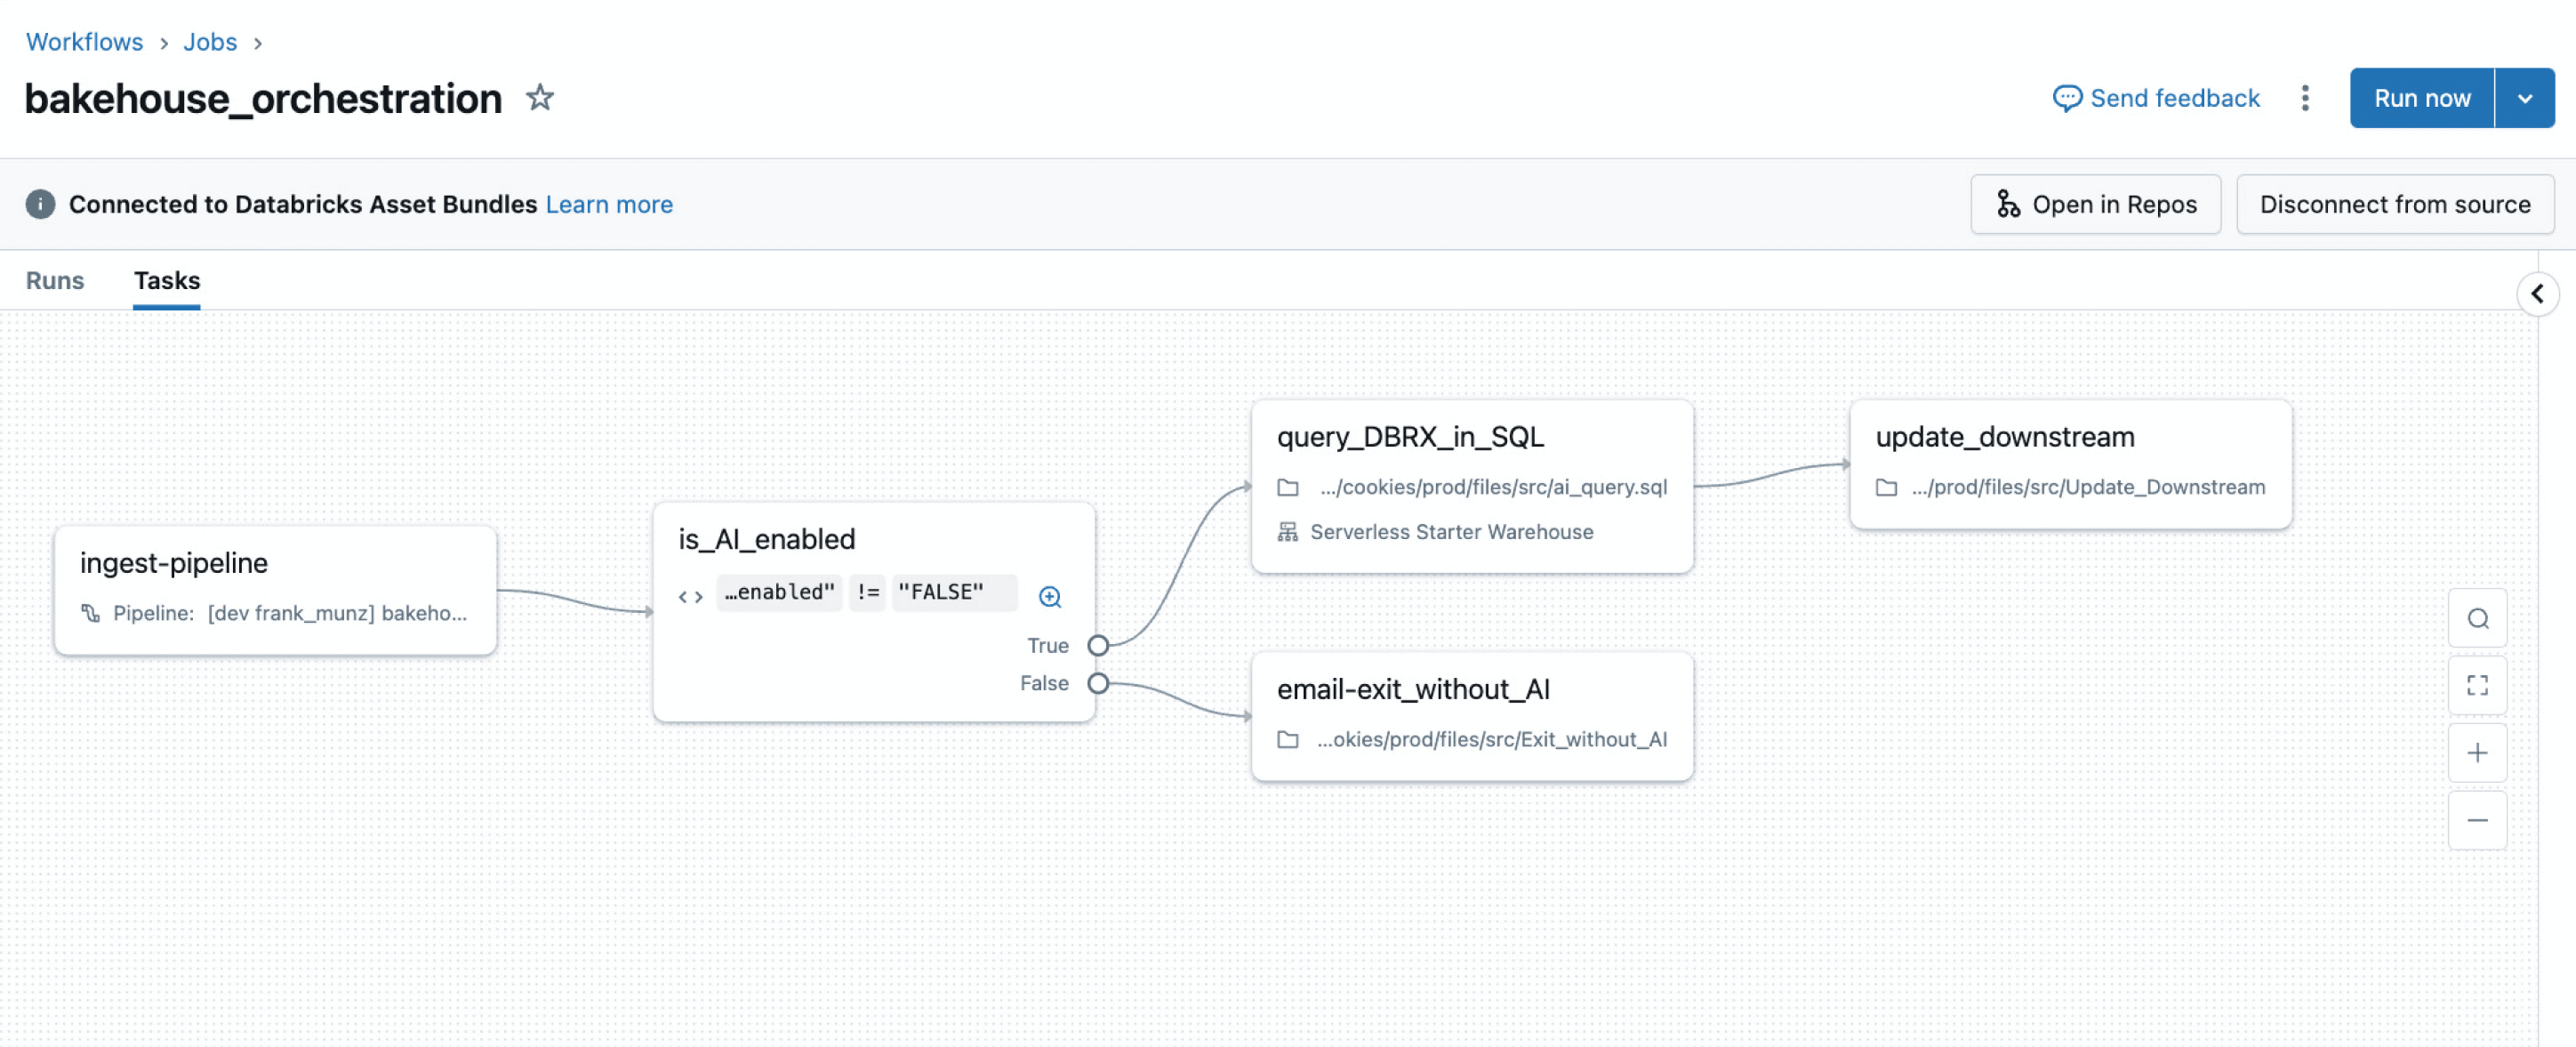
CUSTOMERS USING LAKEFLOW JOBS

Orchestrieren Sie jeden Daten-, Analyse- oder KI-Workflow
Optimieren Sie Ihre Pipelines mit einem verwalteten Orchestrierungsservice, der vollständig in Ihre Datenplattform integriert ist. Definieren, überwachen und automatisieren Sie ETL-, Analyse- und ML-Workflows mühelos – mit hoher Zuverlässigkeit und...
Einfaches Workflow-Erstellen mit Klicks oder Code
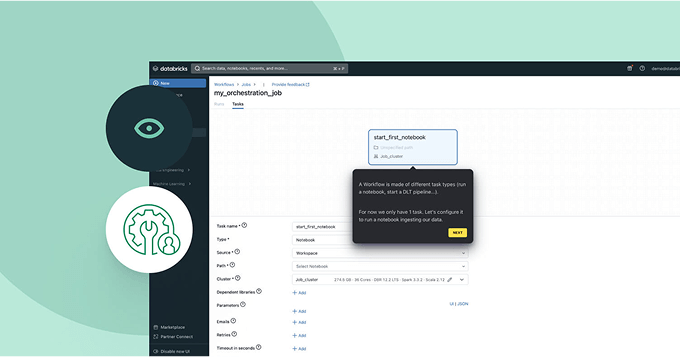
Entwerfen Sie Workflows mit einfachen, intuitiven Tools, die für Datenexperten auf jeder Ebene entwickelt wurden. Definieren Sie Aufgaben mit nur wenigen Klicks oder in Ihrer bevorzugten IDE, um die Job-Erstellung zu vereinfachen.

Echtzeitüberwachung des Status von Jobs
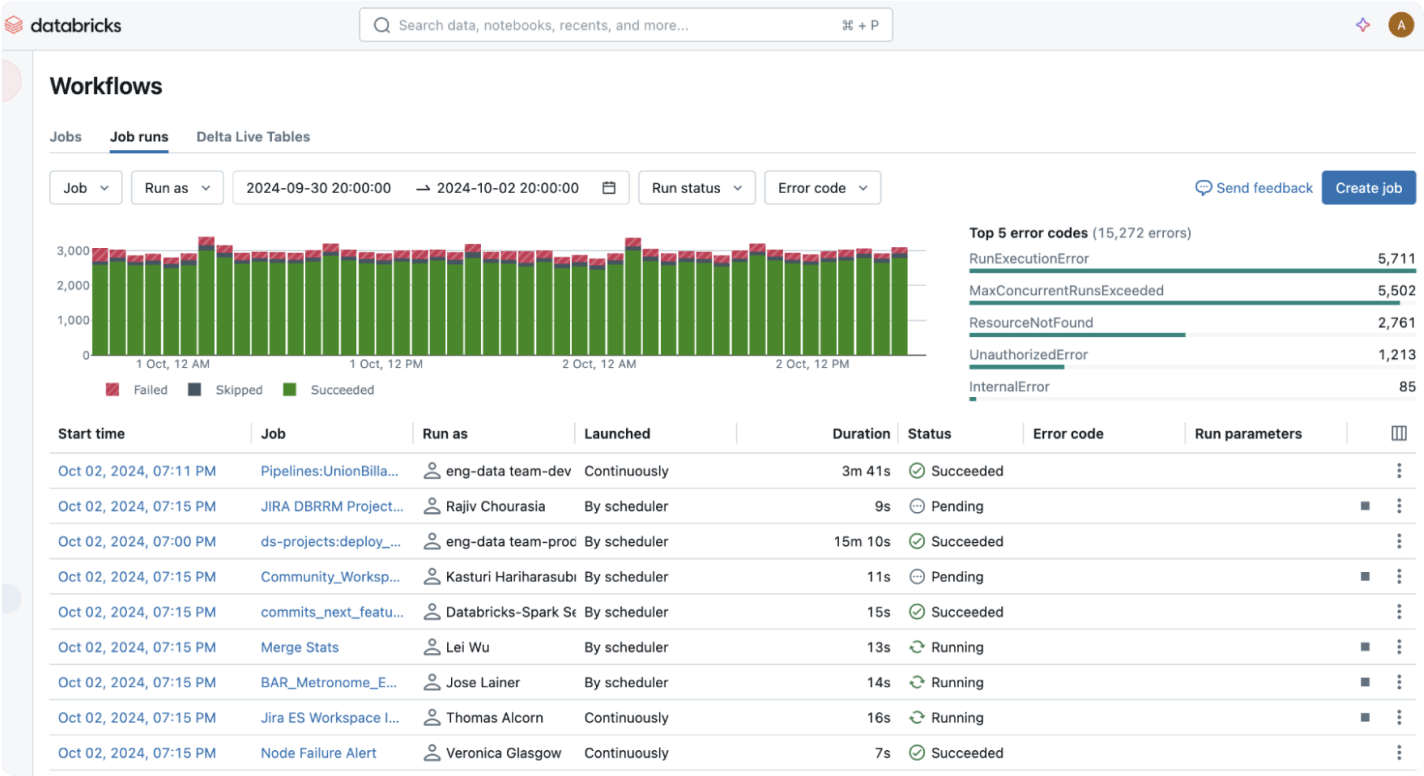
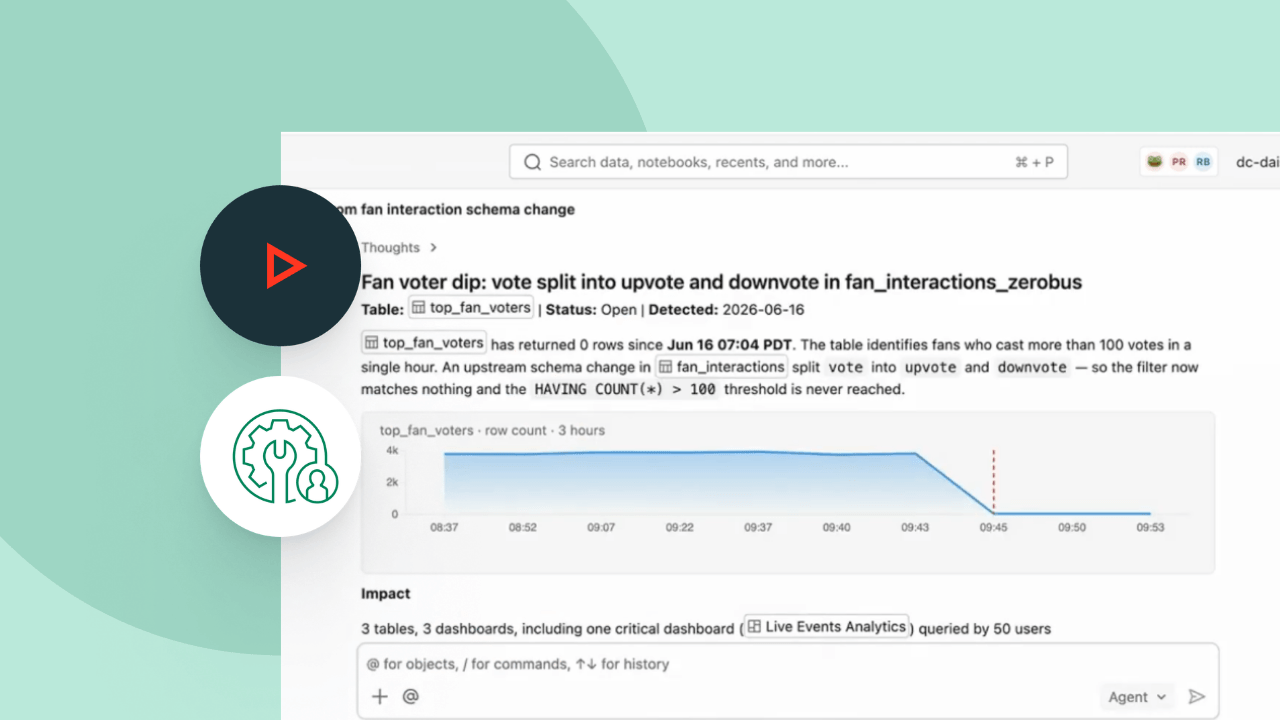
Gewinnen Sie mit Echtzeitüberwachung vollständige Transparenz für jede Aufgabe. Verwenden Sie detaillierte Metriken und Analysen, um proaktiv den Zustand der Produktion zu bewerten, Engpässe schnell zu identifizieren, Probleme zu beheben und einen nahtlosen Betrieb in Ihren Datenpipelines sicherzustellen.

Bewährte Zuverlässigkeit für Produktionsworkflows
Vertrauen Sie einem vollständig verwalteten Orchestrierungsservice, um einen reibungslosen und zuverlässigen Ablauf Ihrer Produktionsworkflows zu gewährleisten. Aufgrund der bewährten Leistung und Skalierbarkeit von Lakeflow Jobs vertrauen Tausende von Organisationen darauf, um ihre kritischsten Datenpipelines zu verwalten.
Funktionen von Lakeflow Jobs für die Pipeline-Orchestrierung
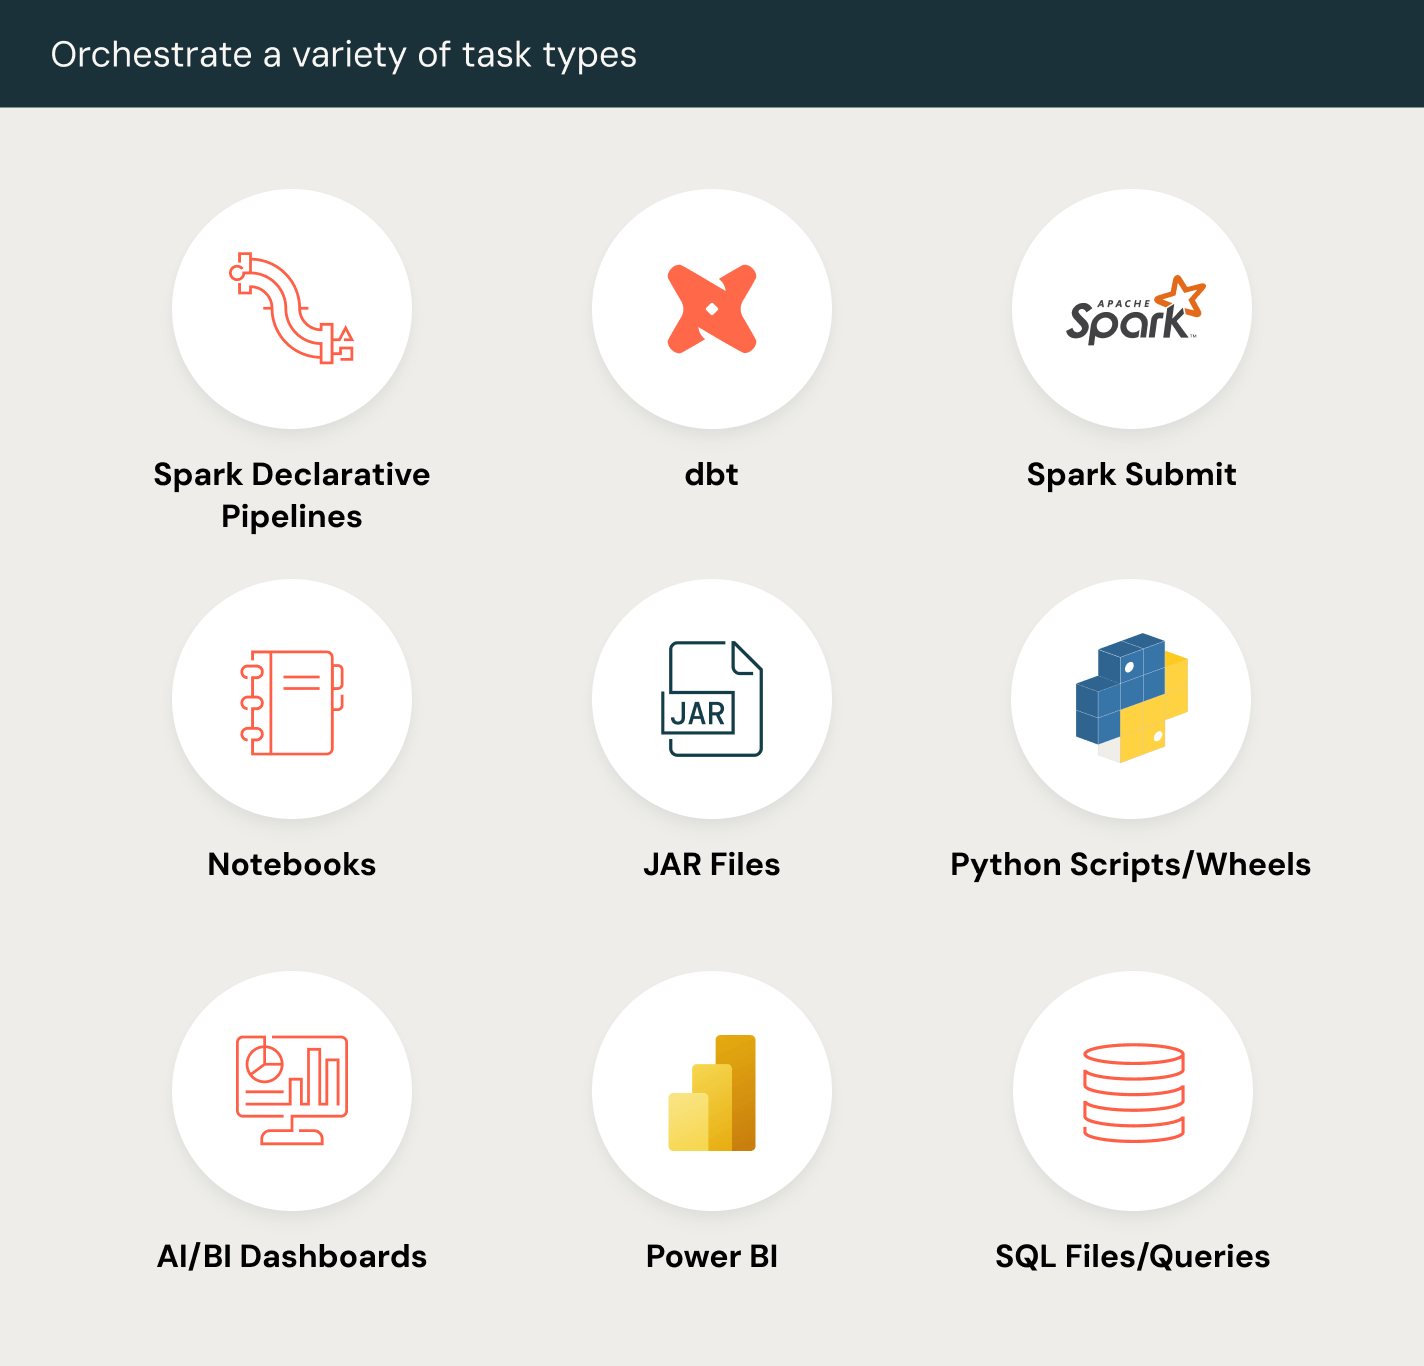
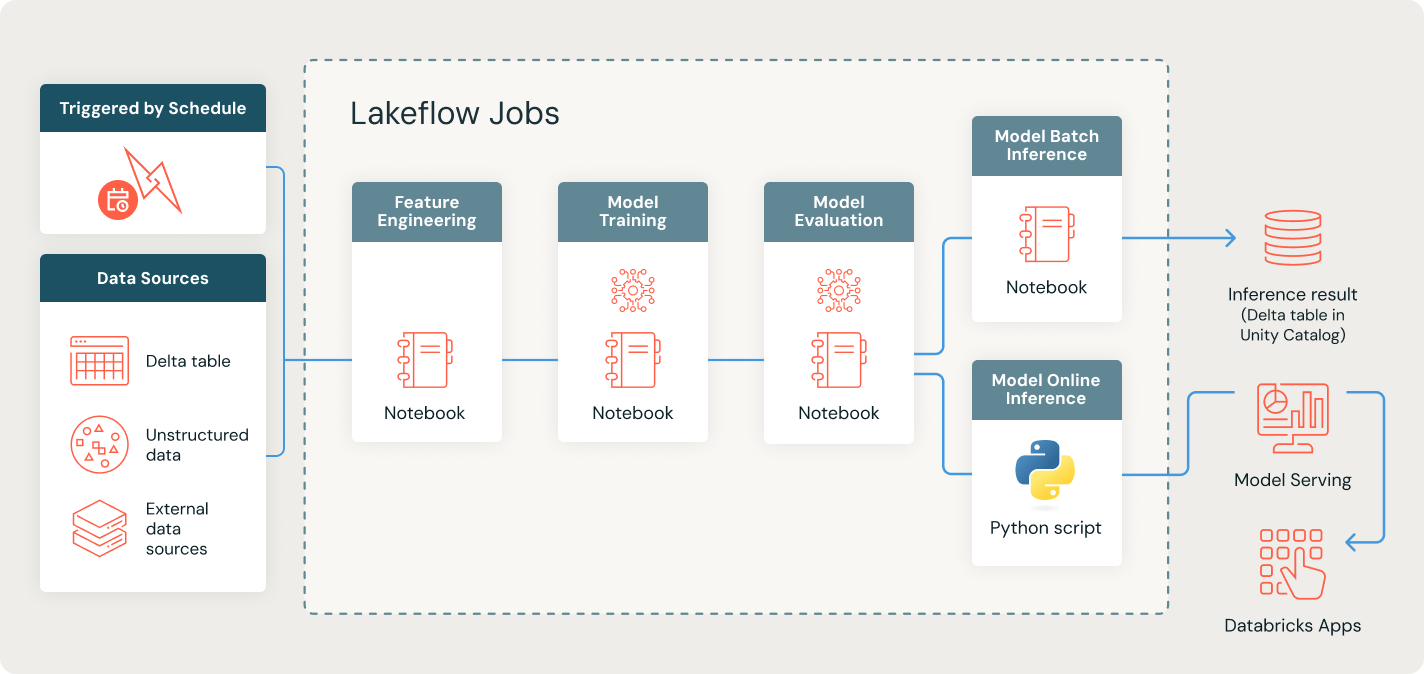
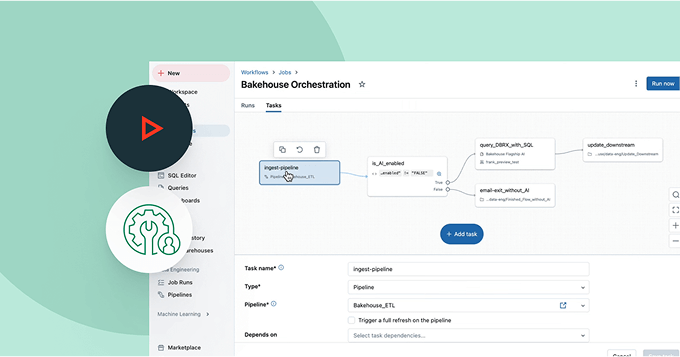
Definieren, verwalten und überwachen Sie einfach Jobs über ETL-, Analyse- und KI-Pipelines hinweg.Ermöglichen Sie eine nahtlose Orchestrierung mit vielseitigen Aufgabenarten, einschließlich Notebooks, SQL, Python und mehr, um jeden Datenworkflow zu unterstützen.
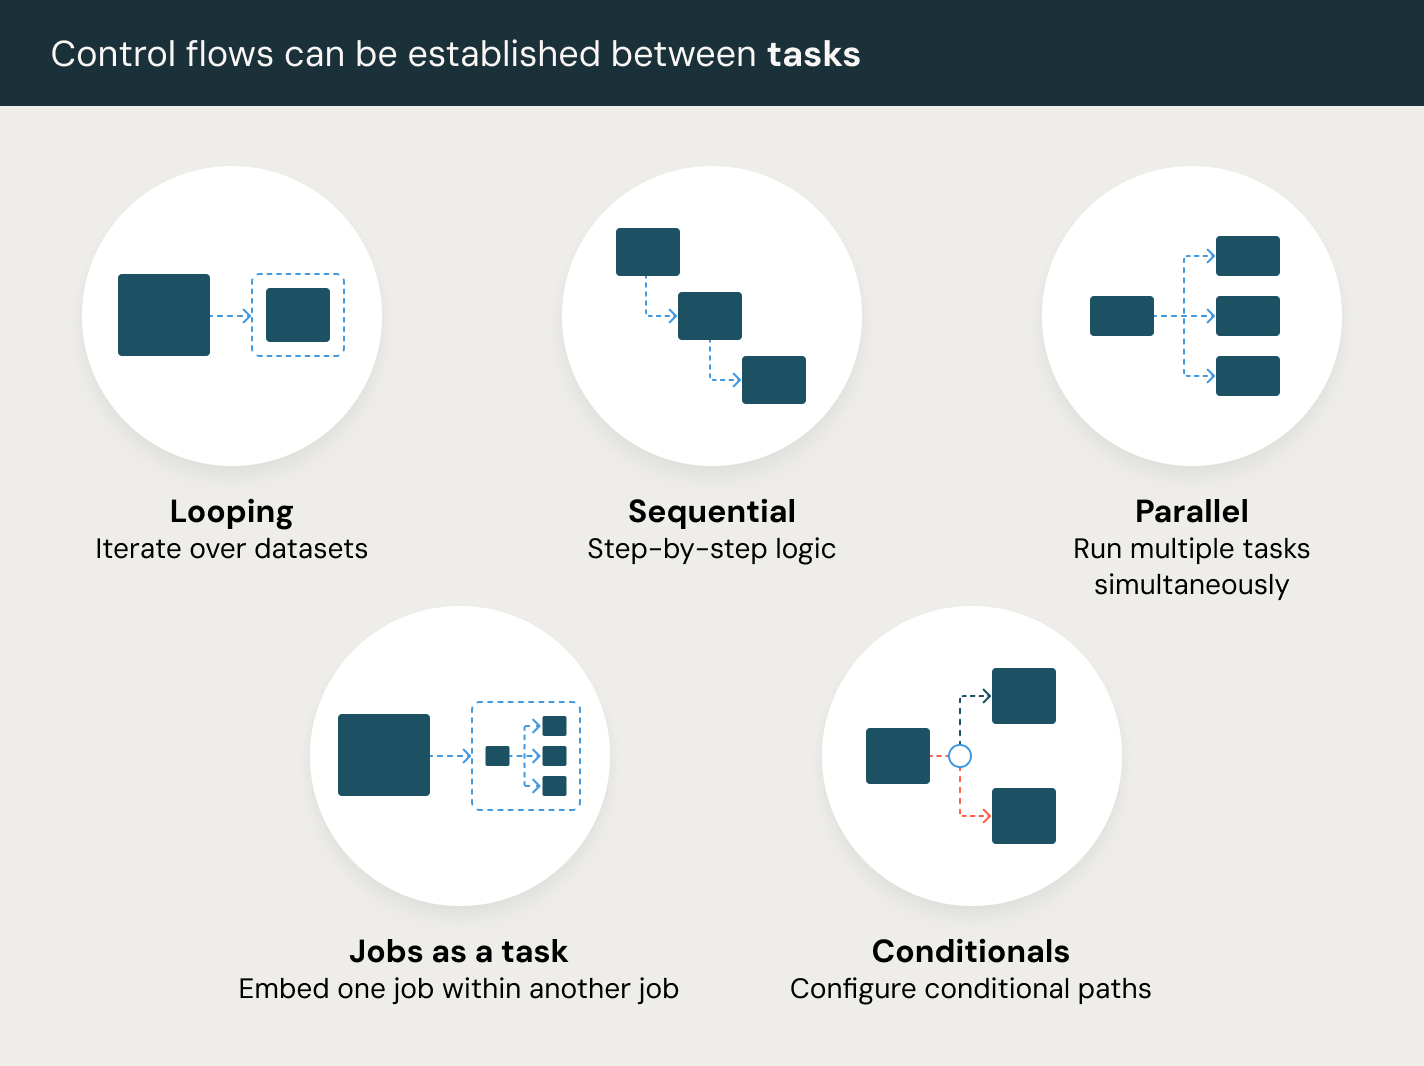
Verwalten Sie Aufgabenabhängigkeiten und fügen Sie bedingte Logik, Schleifen, Wiederholungen und mehr hinzu, um Aufträge an Ihre einzigartigen Pipeline-Anforderungen anzupassen.
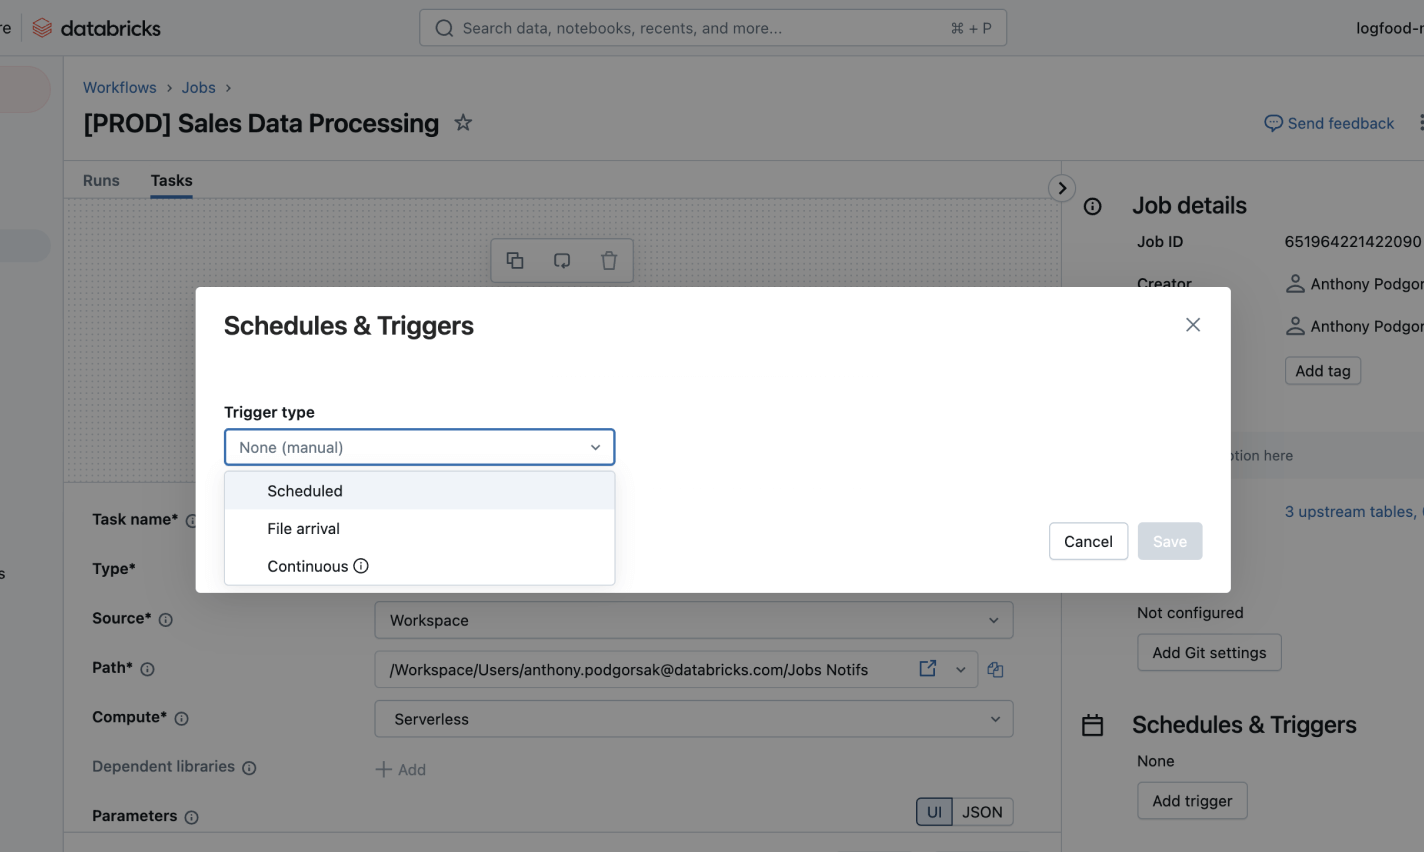
Führen Sie Jobs genau dann aus, wenn Sie sie benötigen – mit Echtzeitauslösern, vordefinierten Zeitplänen oder On-Demand-Ausführung.
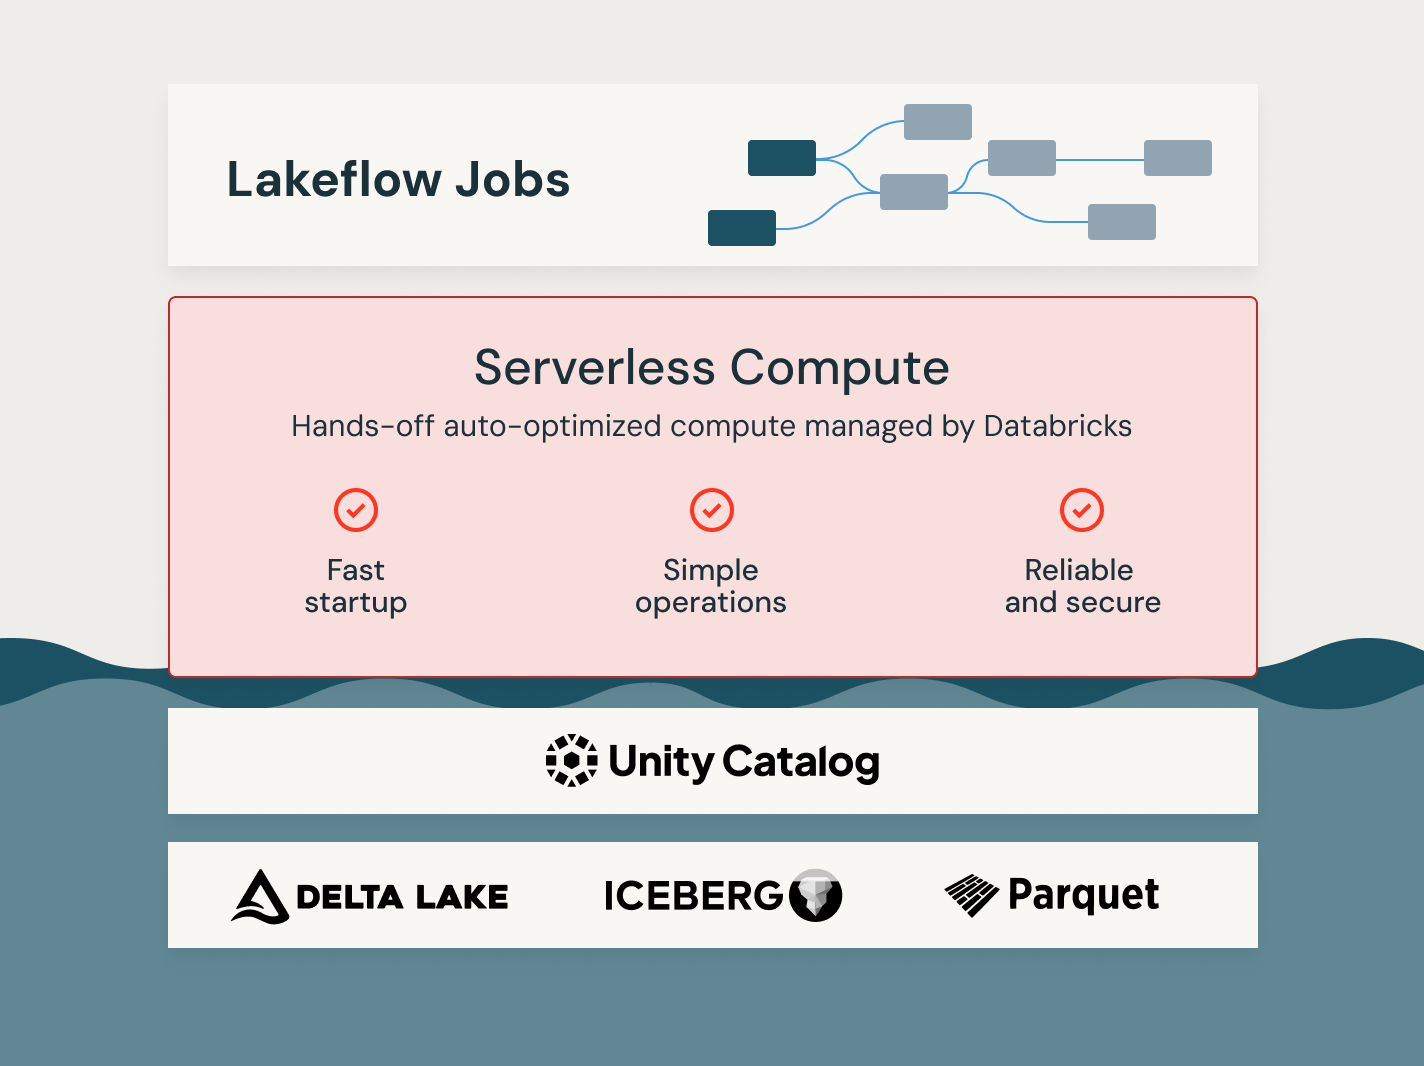
Starten Sie schnell mit vollständig verwalteter, serverloser Datenverarbeitung – ohne Einrichtung – und Pay-as-you-go-Preisen für eine sichere, skalierbare Leistung ohne Wartungsaufwand.
Verfolgen Sie den Status von Jobs in Echtzeit, diagnostizieren Sie Probleme mit detaillierten Einblicken und legen Sie Warnungen fest, um die Kontrolle zu behalten und die Leistung zu verbessern.
Zusätzliche Orchestrierungsfunktionen für Lakeflow Jobs
Lakeflow Jobs: Anwendungsfälle für ETL, ML, BI und Streaming

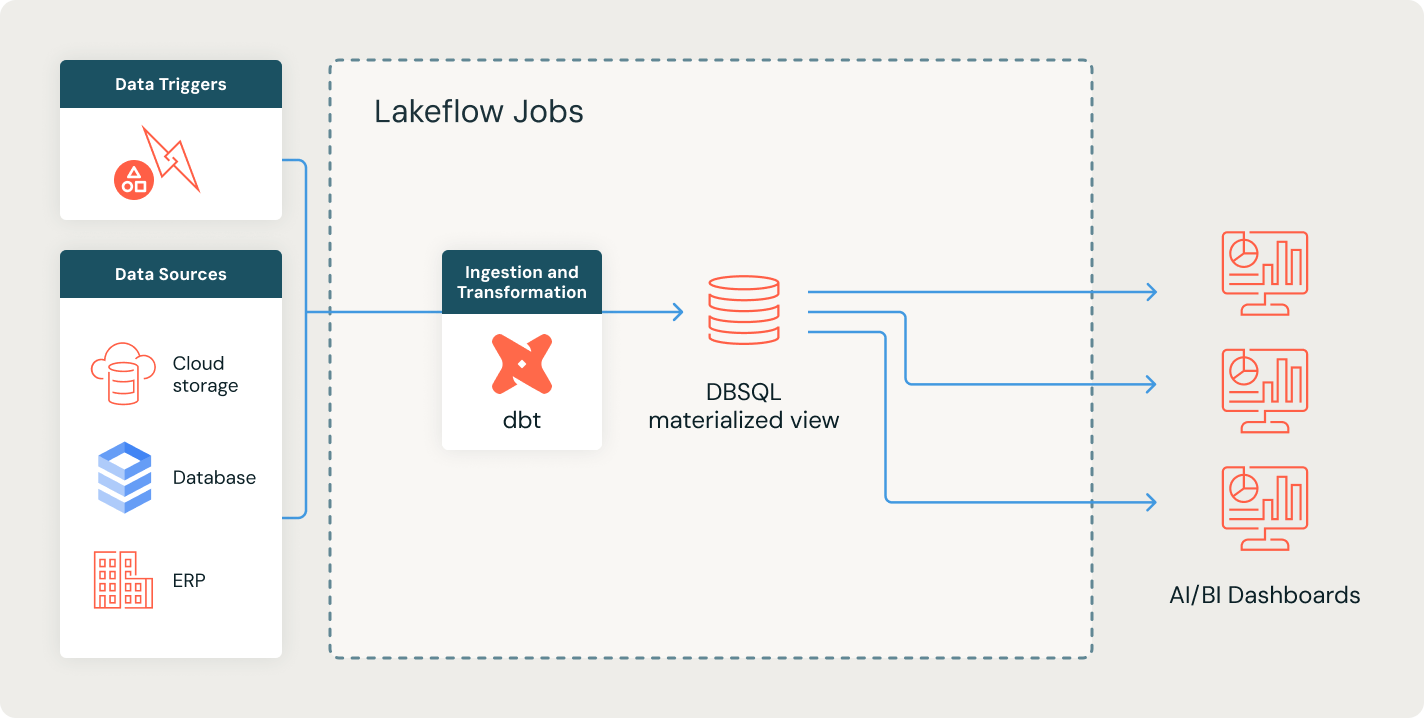
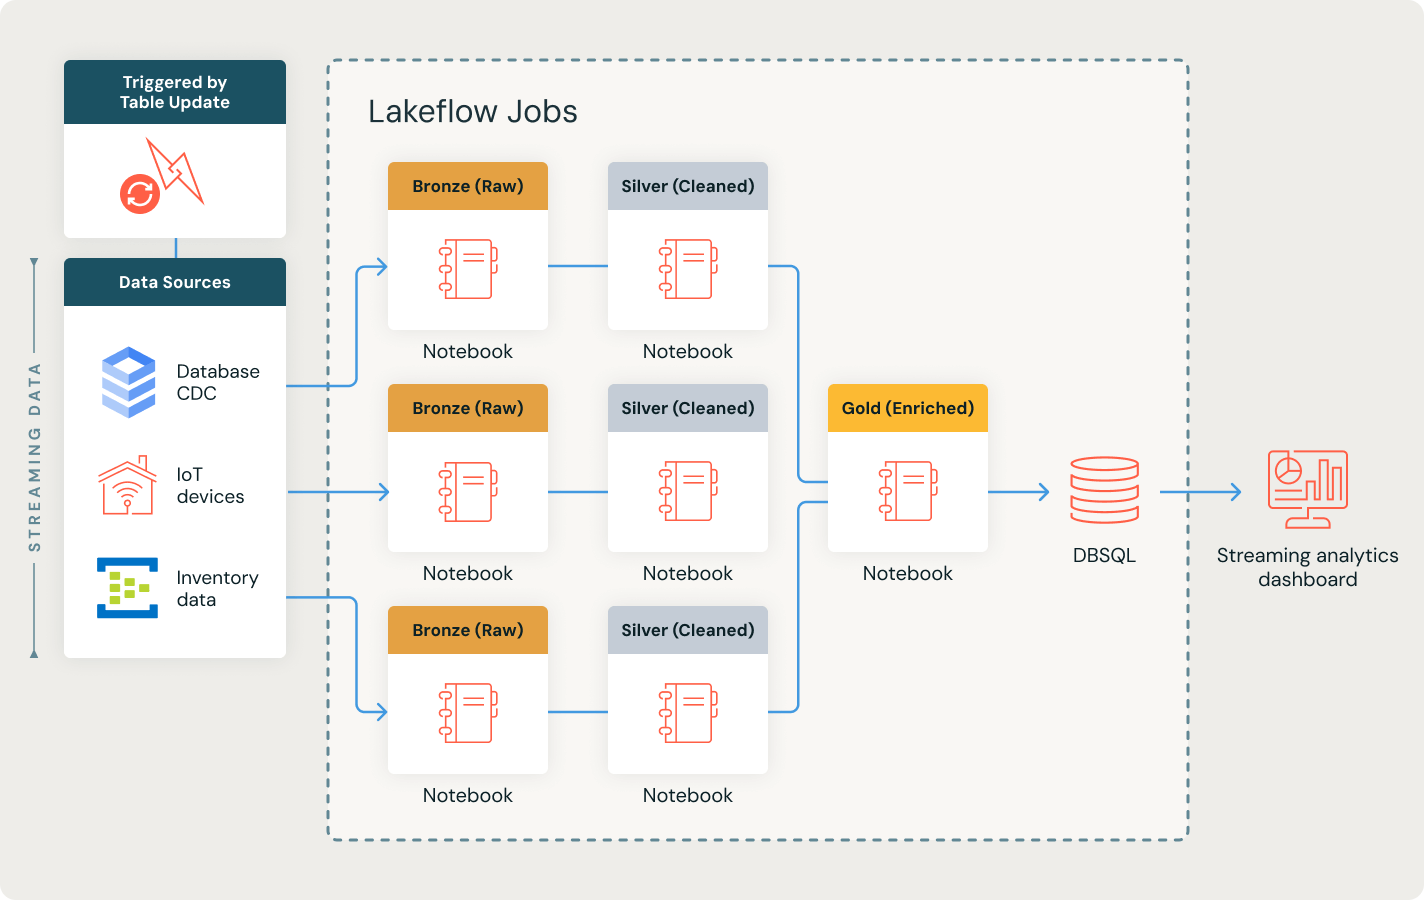
Automatisieren Sie die Datenorchestrierung für ETL-Prozesse (Extract, Transform, Load)
Automatisieren Sie die Datenaufnahme und -umwandlung aus verschiedenen Quellen in Databricks und stellen Sie so eine genaue und konsistente Datenaufbereitung für jeden Workload sicher.
Erkunden Sie die Demos für Lakeflow Jobs
Mehr entdecken
Erfahren Sie mehr darüber, wie die Databricks Data + AI Platform Datenteams bei all ihren Daten- und KI-Workloads unterstützt.
LakeFlow Connect
Effiziente Konnektoren für die Datenaufnahme aus beliebigen Quellen und native Integration mit der Data + AI Platform eröffnen einen einfachen Zugriff auf Analysen und KI mit einheitlicher Governance.

Spark Declarative Pipelines
Bietet vereinfachte, deklarative Pipelines für die Batch- und Streaming-Datenverarbeitung und sorgt für automatisierte, zuverlässige Transformationen für Analyse- und AI/ML-Aufgaben.

Databricks Assistant
Nutzen Sie KI-gestützte Unterstützung, um die Codierung zu vereinfachen, Workflows zu debuggen und Abfragen mithilfe natürlicher Sprache für schnelleres und effizienteres Data Engineering und Analysen zu optimieren.

Lakehouse-Speicherung
Vereinheitlichen Sie die Daten in Ihrem Lakehouse format- und typenübergreifend für alle Ihre Analytics- und KI-Workloads.

Unity Catalog
Regulieren Sie alle Ihre Datenressourcen nahtlos mit der branchenweit einzigen einheitlichen und offenen Governance-Lösung für Daten und KI, die in die Databricks Data + AI Platform integriert ist.
Die Data + AI Platform
Erfahren Sie, wie die Databricks Data + AI Platform Ihre Daten- und KI-Workloads unterstützt.
Wagen Sie den nächsten Schritt
Lakeflow-Jobs FAQ
Orchestrierung im Kontext von Daten, Analytics und KI bezieht sich auf die Automatisierung, Bereitstellung und Verwaltung von Workflows wie ETL-Datenpipelines und ML-Modellschulung. Die Orchestrierung ist ein wichtiger Teil der Datenvorgänge und unerlässlich, um Datenlösungen in die Produktion zu bringen. Bei der Orchestrierung geht es darum, die Abhängigkeiten zwischen Workflow-Aufgaben zu verwalten und die Ausführung dieser Aufgaben zu planen. Die Orchestrierung umfasst auch die Zuweisung von Compute-Ressourcen und das Monitoring von Workflows.
Möchten Sie ein Daten- und KI-Unternehmen werden?
Machen Sie die ersten Schritte Ihrer Datentransformation