Databricks for Good e Virtue Foundation: insieme per connettere i volontari medici ai servizi sanitari critici in 72 paesi
- La Virtue Foundation ha collaborato con Databricks for Good per sfruttare l'AI al fine di migliorare i risultati dell'assistenza sanitaria globale.
- Di conseguenza, la Virtue Foundation è ora in grado di abbinare meglio le competenze cliniche alle opportunità di volontariato nei paesi in via di sviluppo in cui sono più necessarie.
- Insieme, i team di Databricks e della Virtue Foundation stanno fornendo dataset principali aggiornati in un formato facilmente accessibile e immediatamente utilizzabile.
Introduzione
Virtue Foundation è un'organizzazione no-profit focalizzata sull'erogazione di servizi sanitari a livello globale e sulla creazione di un mercato efficiente per l'assistenza sanitaria filantropica mondiale. Ad oggi, ha fornito cure a oltre 50.000 pazienti, con un'attenzione particolare a Ghana e Mongolia. La spina dorsale di questo mercato è la cura dei dati sulle strutture sanitarie globali attraverso VF Match, una piattaforma che connette i professionisti medici con opportunità di volontariato in 72 paesi a basso e medio-basso reddito. Databricks for Good collabora strettamente con Virtue Foundation dal 2024 per sfruttare l'AI per aggregare i dati in questi paesi e renderli operativi.
Una proof of concept iniziale ha dimostrato che i LLM potevano estrarre informazioni strutturate da fonti di dati web disparate per creare una mappa delle infrastrutture sanitarie e, soprattutto, delle lacune nei servizi nelle aree con scarse risorse. Tuttavia, scalare questa funzionalità e portarla in produzione ha presentato molte sfide. Da quella prima iterazione, abbiamo creato una piattaforma basata su Databricks che ha trasformato la POC in un sistema di livello di produzione che aggrega dati provenienti da migliaia di strutture sanitarie e organizzazioni no-profit in tutto il mondo.
In questo articolo, vedremo come abbiamo migliorato il nostro lavoro precedente per consentire ulteriormente a Virtue Foundation di abbinare la propria community di volontari medici alle esigenze critiche in questi paesi.
Costruire le fondamenta: dati sanitari di 72 paesi
Il cuore di VF Match è il Foundational Data Refresh (FDR): un dataset completo di strutture sanitarie e organizzazioni no-profit creato da zero a partire da varie fonti web. Ingeriamo e aggiorniamo sistematicamente i dati di 72 paesi a basso e medio-basso reddito in tutto il mondo.
Due fonti di dati complementari alimentano questo aggiornamento:
- Overture Maps: un dataset geospaziale open source di Meta e Microsoft, che fornisce posizioni autorevoli per le strutture sanitarie.
- Bright Data: un'infrastruttura di web scraping industriale che acquisisce informazioni in tempo reale da tutto il web.
Il cuore di FDR è una pipeline di estrazione delle informazioni alimentata dai modelli GPT di OpenAI. L'elaborazione di oltre 25 milioni di pagine web tramite LLM con garanzie di produzione ha richiesto di ripensare le tradizionali pipeline di inferenza dei LLM. Invece di tentare un'estrazione one-shot, la nostra pipeline suddivide il compito in passaggi mirati: classificazione della rilevanza medica, identificazione del tipo di organizzazione (una struttura medica o una NGO) ed estrazione di specializzazioni, attrezzature e procedure.
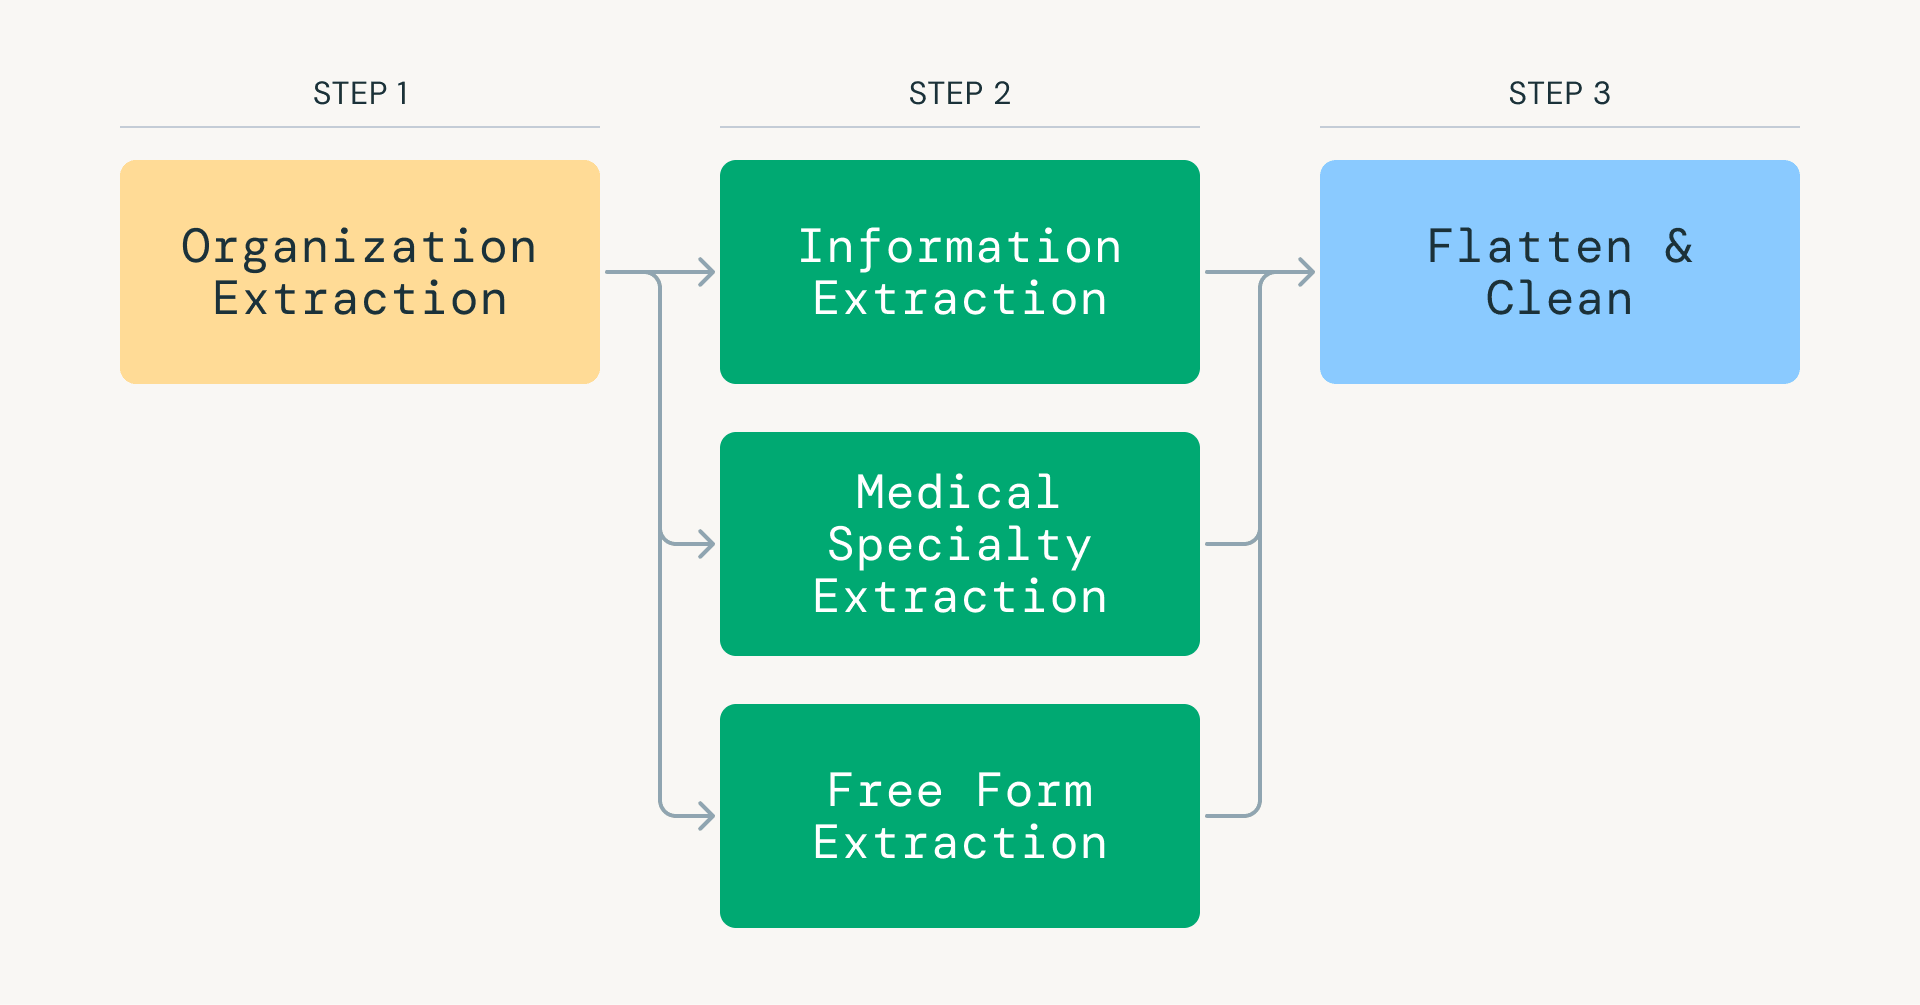
Questo approccio riduce drasticamente il consumo di token, concentrando ogni invocazione del modello su un compito specifico e ad alta precisione. Databricks e Apache Spark vengono utilizzati per orchestrare e parallelizzare in modo efficiente i dati estratti tramite scraping, distribuendo i carichi di lavoro su migliaia di executor e consentendo un'inferenza LLM ad alto throughput.
Una serie di funzionalità critiche rende questa pipeline scalabile e pronta per la produzione:
- Modellazione dei dati estensibile: i dati di ogni passaggio vengono memorizzati in uno schema a stella, semplificando l'analisi a valle e migliorando le prestazioni delle query.
- Checkpointing basato sullo stato: ogni record traccia il proprio stato di elaborazione, consentendo alle pipeline di riprendere da qualsiasi punto senza dover rielaborare le righe con costose chiamate LLM.
- Registro di estrazione configurabile: ogni metodo di estrazione è controllato da un oggetto strutturato che specifica il prompt di sistema, rendendo la logica di estrazione modulare, riproducibile ed estensibile.
- Elaborazione distribuita scalabile: il sistema elabora carichi di lavoro sbilanciati da svariati terabyte utilizzando Spark per il parallelismo, Photon per le prestazioni su scala e un'orchestrazione di livello di produzione.
Queste garanzie sono applicate tramite Lakeflow Jobs, che orchestrano più di 15 attività interdipendenti con ramificazione condizionale, esecuzione parallela e policy di retry intelligenti. Il risultato è un sistema che elabora i dati delle strutture sanitarie su scala con la precisione di esperti medici.
Risoluzione delle entità su scala
Una volta che i dati delle strutture e delle organizzazioni no-profit vengono estratti tramite scraping ed estrazione con un LLM, emerge una sfida classica: la risoluzione delle entità. La stessa struttura può apparire in più fonti di dati con variazioni del nome, indirizzi incoerenti o dettagli di contatto mancanti. La deduplicazione tradizionale fallisce in questi scenari a causa di dati disordinati, quindi utilizziamo Splink, un framework open source di record linkage probabilistico. Utilizzando le informazioni ottenute nella nostra fase di IE, Splink valuta le coppie di corrispondenze tramite confronti ponderati su campi come numero di telefono, indirizzo stradale e altro ancora. Il risultato è una chiave unificata per struttura, che garantisce agli utenti finali la visualizzazione di un unico record autorevole per ciascuna struttura medica e NGO.
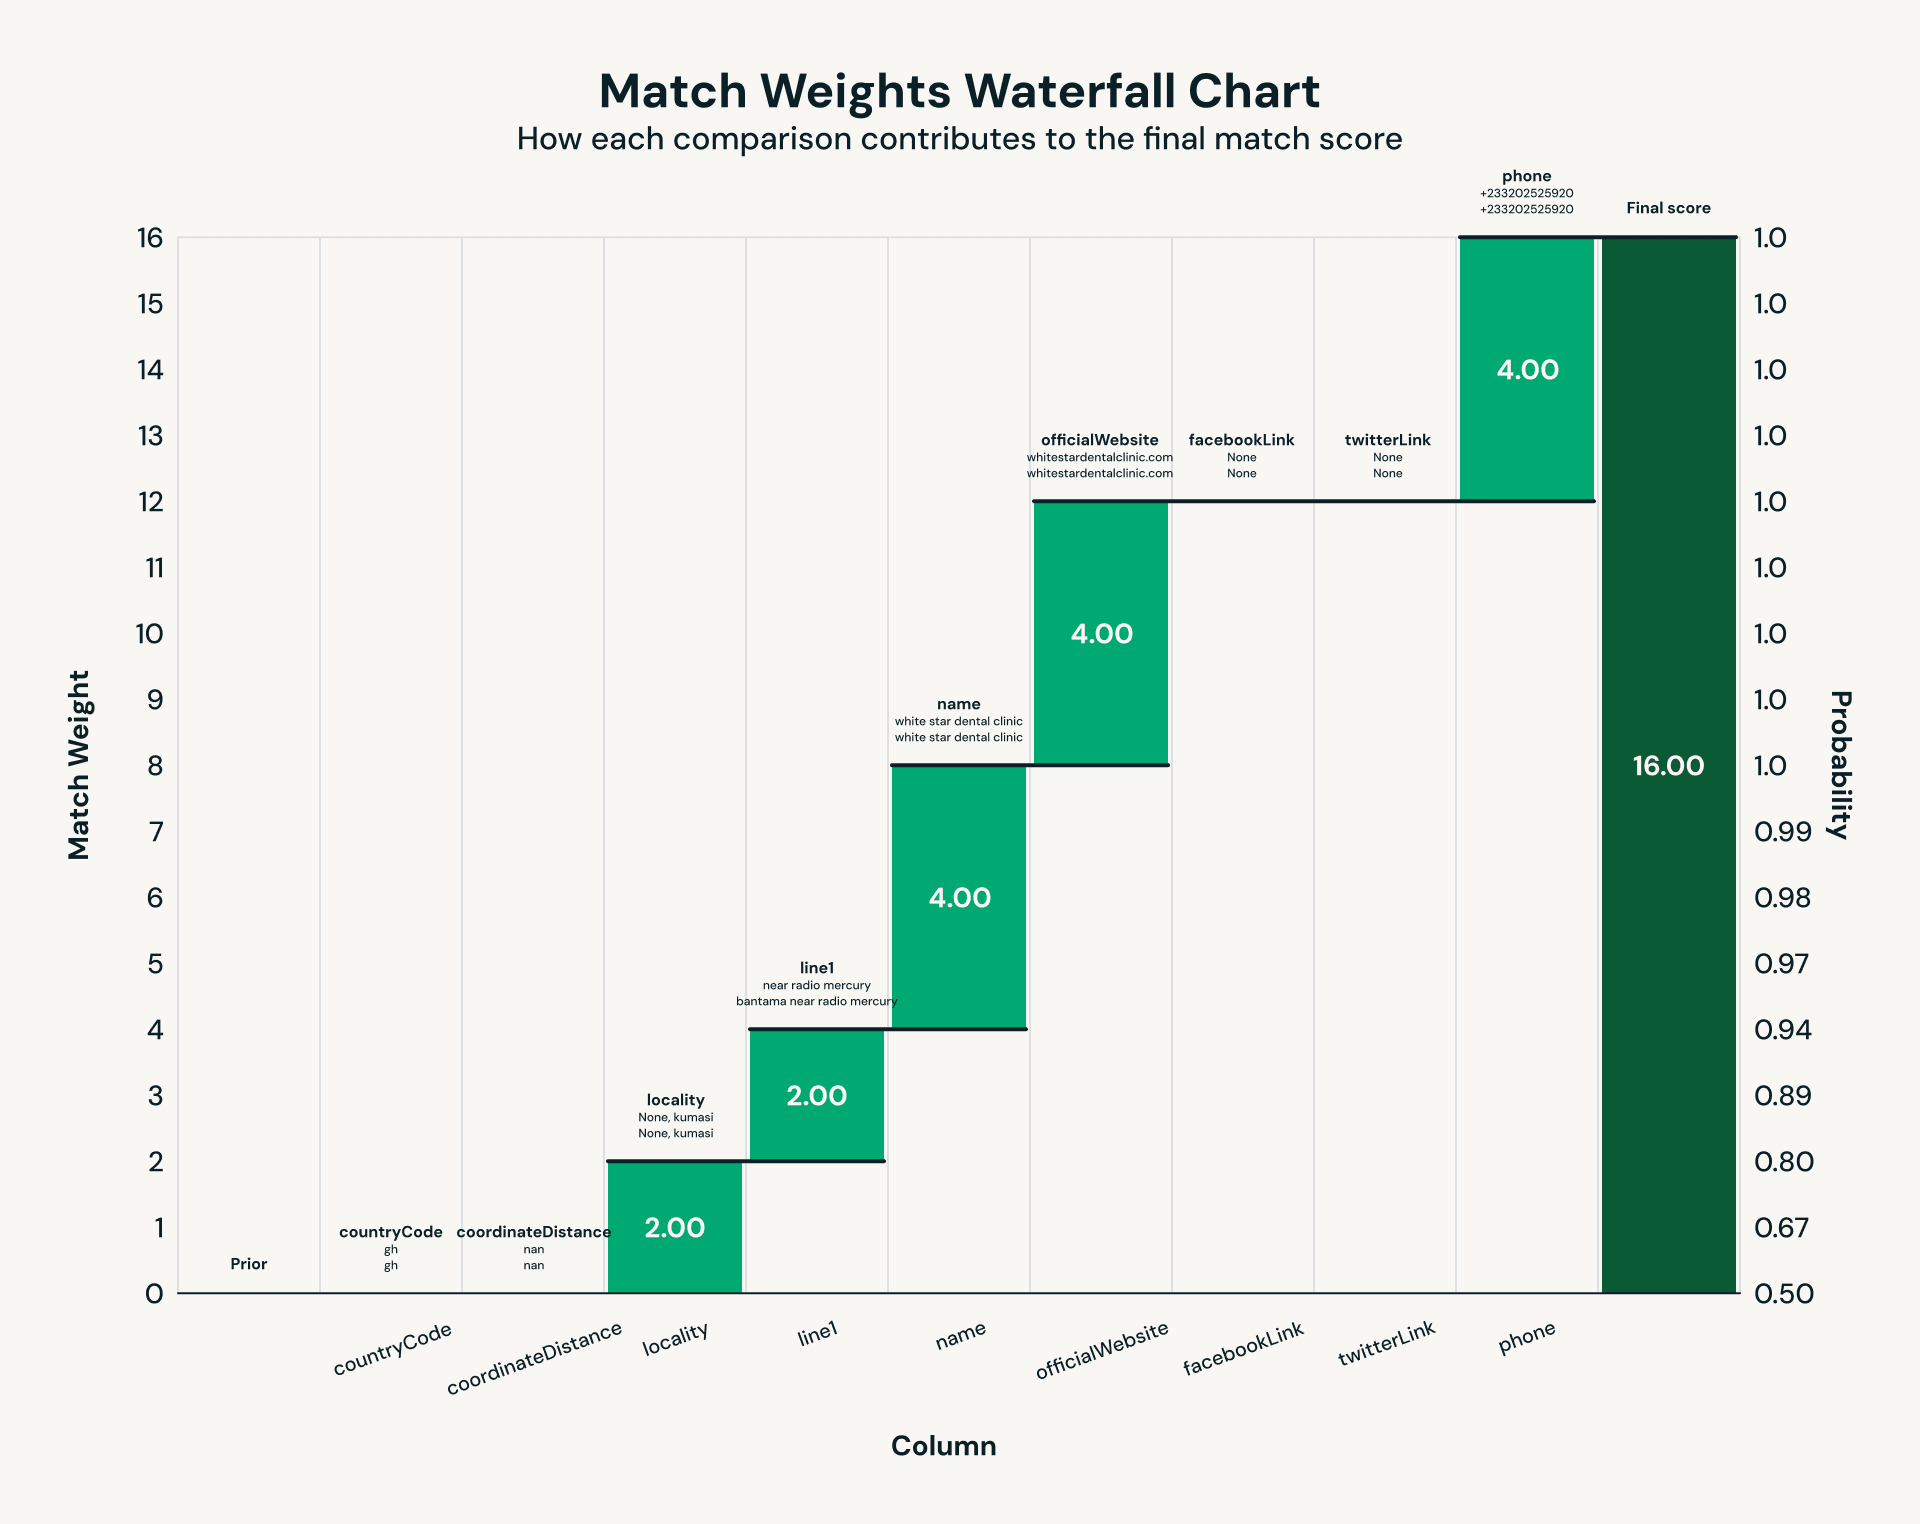
L'esecuzione del matching probabilistico su migliaia di strutture sanitarie e organizzazioni no-profit ha rivelato i classici colli di bottiglia prestazionali che emergono su scala di terabyte. Il cuore del record linkage è il confronto a coppie, che crea carichi di lavoro intrinsecamente sbilanciati: i confronti comuni producono partizioni enormi, mentre la maggior parte delle altre rimane molto più piccola. Le prime esecuzioni lo hanno reso fin troppo chiaro, con una partizione Spark in esecuzione per 30 minuti mentre la mediana completava in 52 secondi: un caso da manuale di straggler (la "maledizione dell'ultimo reducer") che compromettono le prestazioni del job. L'abilitazione di Photon, il motore di query vettorizzato di Databricks, ha ridotto le partizioni di dati nel caso peggiore da 30 minuti a circa 2 minuti: un miglioramento di 15 volte.
VF Agent: il linguaggio naturale incontra i dati sanitari
Guardando al futuro, abbiamo sviluppato un prototipo di agente che consente agli esperti di analizzare i dati utilizzando il linguaggio naturale. Utilizziamo un'architettura multi-agente basata su LangGraph e sfruttiamo Databricks Model Serving, AI Search e Genie.
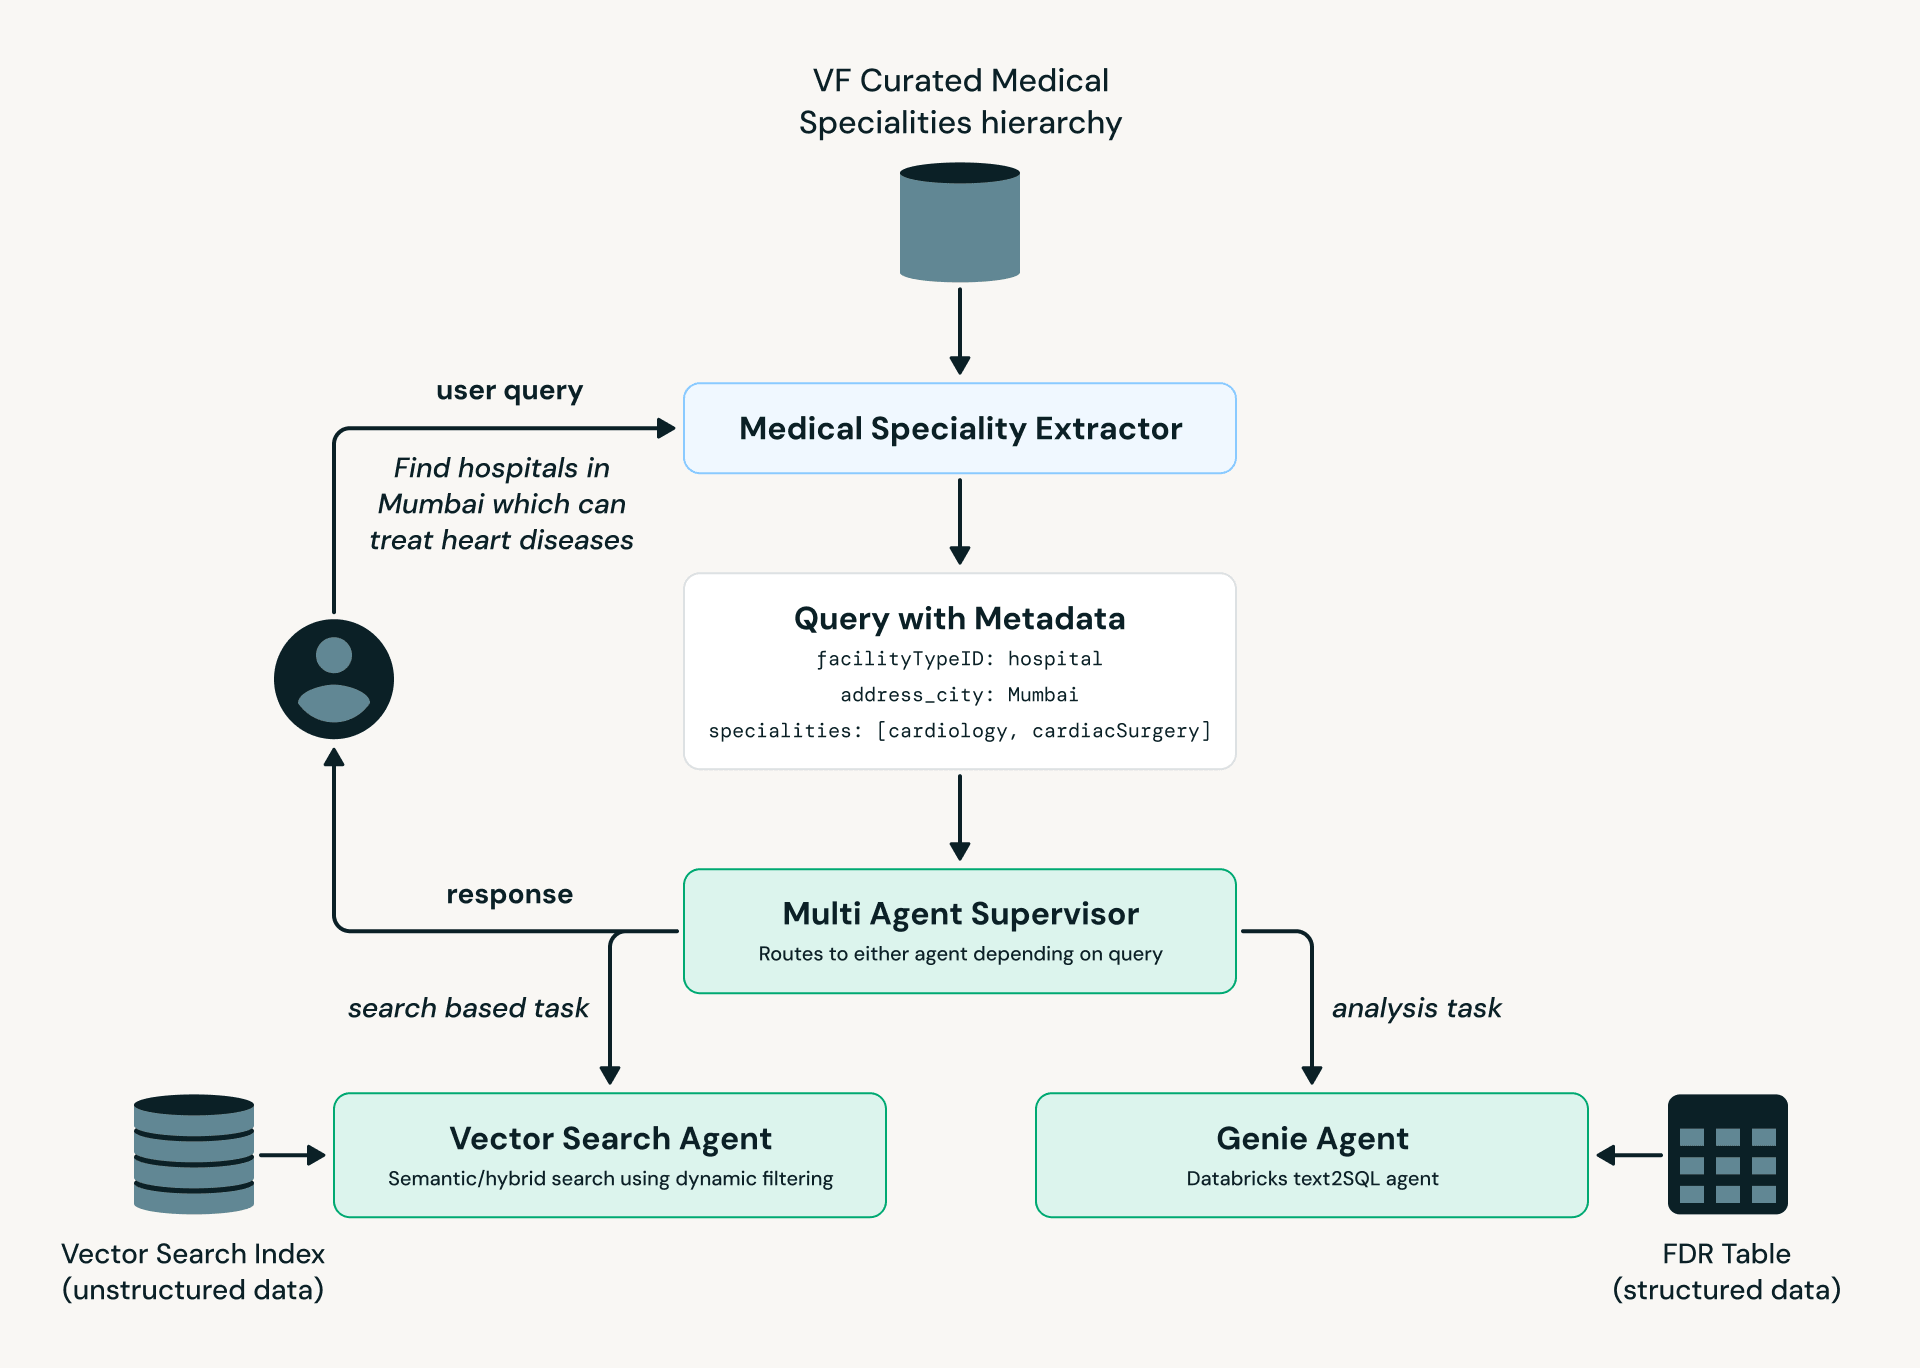
Come illustrato nel diagramma sopra, il Medical Specialty Extractor converte il linguaggio dell'utente in terminologia medica standardizzata, che viene poi passata al Multi-Agent Supervisor. In base all'intento e alla complessità della query, questa viene instradata all'AI Search Agent (scoperta e ricerca delle strutture) o al Genie Agent (query analitiche su dati strutturati).
Riepilogo
I professionisti sanitari possono ora scoprire più rapidamente opportunità aggiornate, trovare corrispondenze con le proprie specializzazioni mediche e accedere a dati globali su migliaia di strutture in tutto il mondo. Il percorso di Virtue Foundation dalla proof of concept alla produzione dimostra cosa è possibile fare quando i sistemi AI avanzati vengono abbinati a una piattaforma di dati unificata.
Il risultato finale è una visione globale dell'infrastruttura sanitaria, che mette in evidenza dove i volontari medici sono più necessari.
Se desideri saperne di più su questo progetto, consulta:
- Panoramica del progetto Databricks x Virtue Foundation - YouTube
- Intervista UN Bloomberg (YouTube) - intorno al minuto 38:00
- Video testimonianza: Bright Initiative x Virtue Foundation x Databricks
Scopri di più su alcuni degli altri nostri progetti Databricks for Good qui sotto:
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.