Databricks for Good und die Virtue Foundation: Partnerschaft zur Vermittlung von medizinischen Freiwilligen an lebenswichtige Gesundheitsdienste in 72 Ländern
von Priyanka Mehta und Shaunak Sen
- Die Virtue Foundation hat sich mit Databricks for Good zusammengeschlossen, um AI zu nutzen und die weltweite Gesundheitsversorgung zu verbessern.
- Dadurch ist die Virtue Foundation nun besser in der Lage, die Fähigkeiten von medizinischem Fachpersonal auf ehrenamtliche Einsätze in Entwicklungsländern abzustimmen, in denen diese Fachkenntnisse am dringendsten benötigt werden.
- Gemeinsam stellen die Teams von Databricks und der Virtue Foundation aktualisierte Kerndatensätze in einem leicht zugänglichen und direkt nutzbaren Format bereit.
Einführung
Die Virtue Foundation ist eine gemeinnützige Organisation, die sich auf die weltweite Gesundheitsversorgung und die Schaffung eines effizienten Marktplatzes für globale philanthropische Gesundheitsdienste konzentriert. Bis heute hat sie über 50.000 Patienten versorgt, mit einem besonderen Schwerpunkt auf Ghana und die Mongolei. Das Rückgrat dieses Marktplatzes ist die Kuratierung globaler Daten von Gesundheitseinrichtungen über VF Match, eine Plattform, die medizinisches Fachpersonal mit ehrenamtlichen Einsätzen in 72 Ländern mit niedrigem und mittlerem Einkommen verbindet. Databricks for Good arbeitet seit 2024 eng mit der Virtue Foundation zusammen, um mithilfe von AI Daten aus diesen Ländern zu aggregieren und nutzbar zu machen.
Ein erster Proof of Concept (POC) zeigte, dass LLMs strukturierte Informationen aus unterschiedlichen Webdatenquellen extrahieren können, um eine Karte der Gesundheitsinfrastruktur und vor allem der Versorgungslücken in unterversorgten Gebieten zu erstellen. Die Skalierung dieser Funktionalität und deren Überführung in die Produktion brachten jedoch viele Herausforderungen mit sich. Seit dieser ersten Iteration haben wir eine auf Databricks basierende Plattform entwickelt, die den POC in ein produktionsreifes System verwandelt hat, das Daten von Tausenden von Gesundheitseinrichtungen und gemeinnützigen Organisationen auf der ganzen Welt aggregiert.
In diesem Artikel zeigen wir, wie wir unsere frühere Arbeit verbessert haben, um die Virtue Foundation noch besser dabei zu unterstützen, ihre Community aus medizinischen Freiwilligen mit dem dringendsten Bedarf in diesen Ländern zusammenzubringen.
Das Fundament legen: Gesundheitsdaten aus 72 Ländern
Das Herzstück von VF Match ist der Foundational Data Refresh (FDR): ein umfassender Datensatz zu Gesundheitseinrichtungen und gemeinnützigen Organisationen, der von Grund auf aus verschiedenen webbasierten Quellen aufgebaut wurde. Wir erfassen und aktualisieren systematisch Daten aus 72 Ländern mit niedrigem und mittlerem Einkommen weltweit.
Zwei komplementäre Datenquellen treiben diese Aktualisierung an:
- Overture Maps: Ein Open-Source-Geodatensatz von Meta und Microsoft, der verlässliche Standorte für Gesundheitseinrichtungen liefert.
- Bright Data: Eine industrielle Web-Scraping-Infrastruktur, die Echtzeitinformationen aus dem gesamten Internet erfasst.
Das Herzstück von FDR ist eine Pipeline zur Informationsextraktion, die auf den GPT-Modellen von OpenAI basiert. Die Verarbeitung von mehr als 25 Millionen Webseiten durch LLMs mit Produktionsgarantien erforderte ein Überdenken traditioneller LLM-Inferenz-Pipelines. Anstatt eine One-Shot-Extraktion zu versuchen, unterteilt unsere Pipeline die Aufgabe in gezielte Schritte: Klassifizierung der medizinischen Relevanz, Identifizierung des Organisationstyps (entweder eine medizinische Einrichtung oder eine NGO) und Extraktion von Fachgebieten, Ausrüstung und Verfahren.
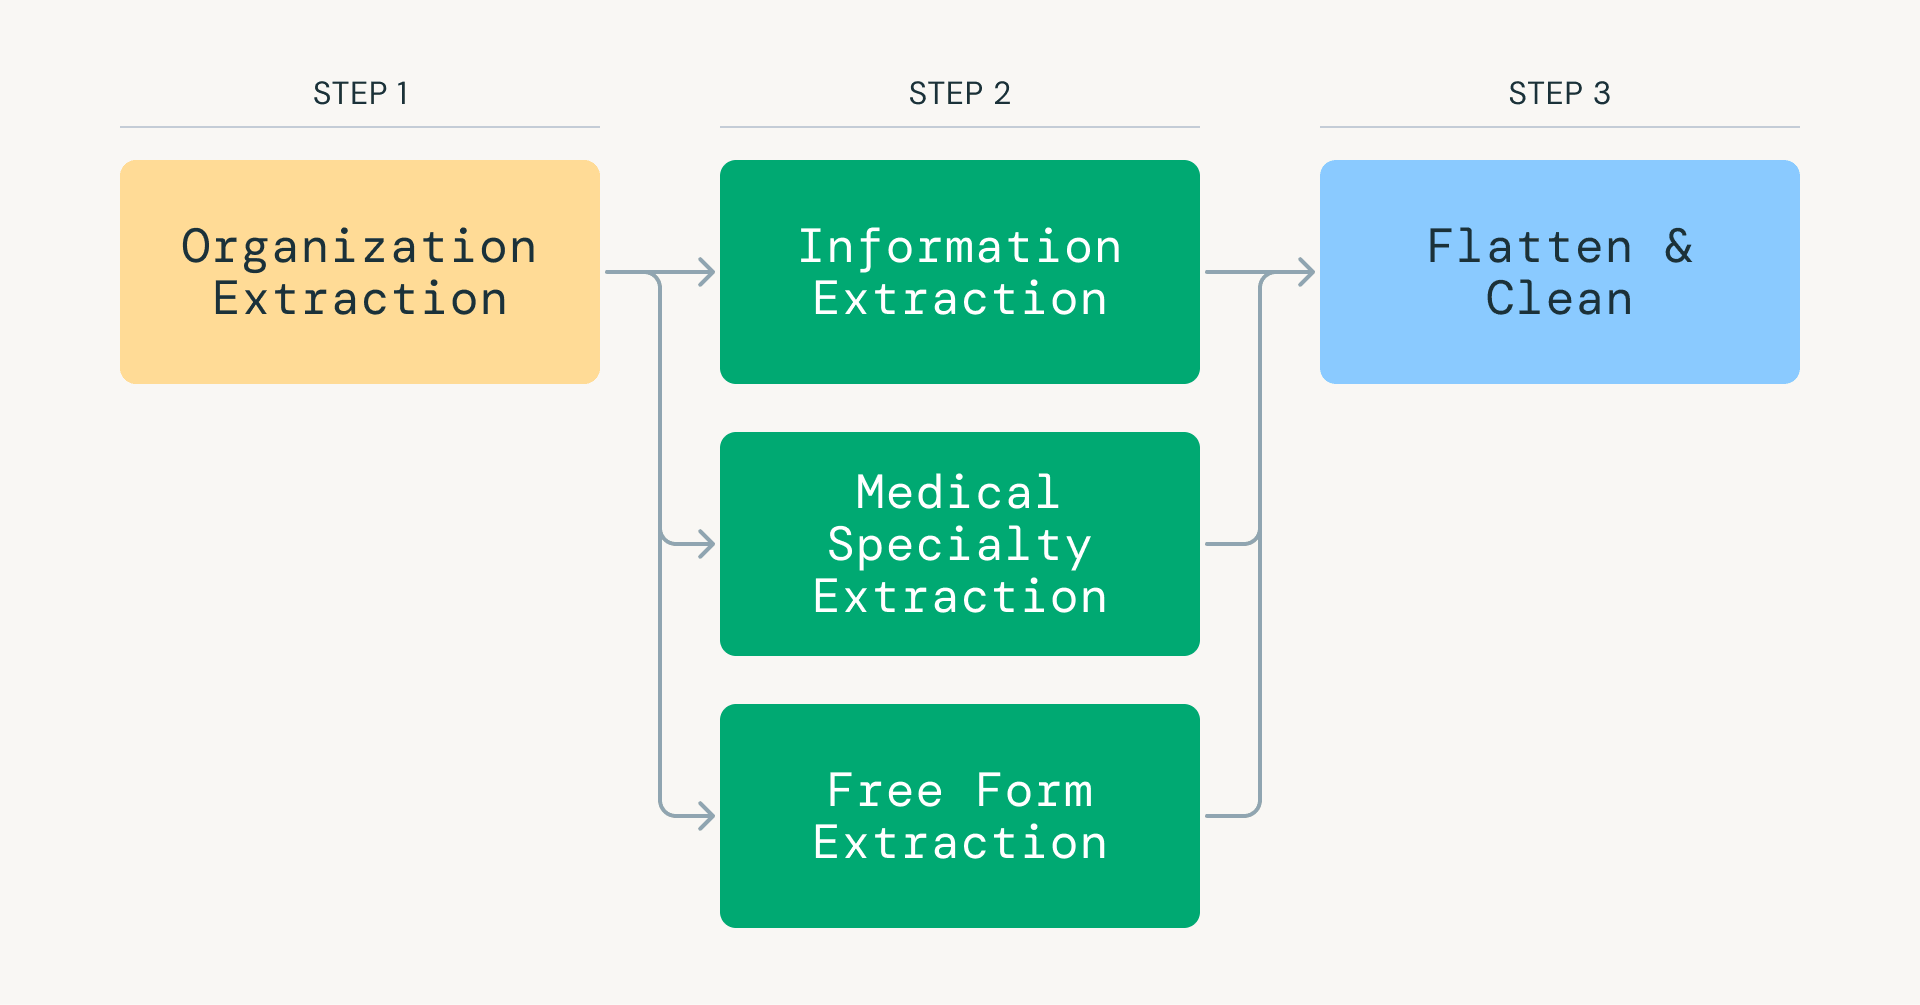
Dieser Ansatz senkt den Token-Verbrauch drastisch, während sich jeder Modellaufruf auf eine eng gefasste, hochpräzise Aufgabe konzentriert. Databricks und Apache Spark werden verwendet, um die gescrapten Daten effizient zu orchestrieren und zu parallelisieren, wodurch Workloads auf Tausende von Executors verteilt und ein LLM-Inferenz-Durchsatz mit hoher Kapazität ermöglicht werden.
Eine Reihe entscheidender Funktionen macht diese Pipeline skalierbar und produktionsreif:
- Erweiterbare Datenmodellierung: Die Daten werden bei jedem Schritt in einem Sternschema gespeichert, was nachgelagerte Analysen vereinfacht und die Abfrageleistung verbessert.
- Statusbasiertes Checkpointing: Jeder Datensatz verfolgt seinen Verarbeitungsstatus. So können Pipelines an jedem beliebigen Punkt fortgesetzt werden, ohne dass Zeilen mit teuren LLM-Aufrufen erneut verarbeitet werden müssen.
- Konfigurierbares Extraktionsregister: Jede Extraktionsmethode wird durch ein strukturiertes Objekt gesteuert, das den System-Prompt angibt. Dies macht die Extraktionslogik modular, reproduzierbar und erweiterbar.
- Skalierbare verteilte Verarbeitung: Das System verarbeitet ungleichmäßig verteilte Workloads im Terabyte-Bereich unter Verwendung von Spark für Parallelität, Photon für Leistung im großen Stil und produktionsreifer Orchestrierung.
Diese Garantien werden durch Lakeflow Jobs durchgesetzt, die mehr als 15 voneinander abhängige Aufgaben mit bedingter Verzweigung, paralleler Ausführung und intelligenten Wiederholungsrichtlinien orchestrieren. Das Ergebnis ist ein System, das Daten von Gesundheitseinrichtungen in großem Maßstab mit der Präzision von medizinischen Experten verarbeitet.
Entity Resolution im großen Stil
Sobald die Daten von Einrichtungen und gemeinnützigen Organisationen gescrapt und mithilfe eines LLM extrahiert wurden, zeigt sich eine klassische Herausforderung: die Entity Resolution. Dieselbe Einrichtung kann in mehreren Datenquellen mit unterschiedlichen Namen, inkonsistenten Adressen oder fehlenden Kontaktdaten vorkommen. Eine herkömmliche Deduplizierung scheitert in diesen Szenarien an unstrukturierten Daten. Daher verwenden wir Splink, ein Open-Source-Framework für probabilistische Datensatzverknüpfung (Record Linkage). Mithilfe der in unserem IE-Schritt gewonnenen Informationen bewertet Splink Übereinstimmungspaare durch gewichtete Vergleiche über Felder wie Telefonnummer, Adresse und mehr. Das Ergebnis ist ein einheitlicher Schlüssel pro Einrichtung, der sicherstellt, dass Endbenutzer einen einzigen, verlässlichen Datensatz für jede medizinische Einrichtung und NGO sehen.
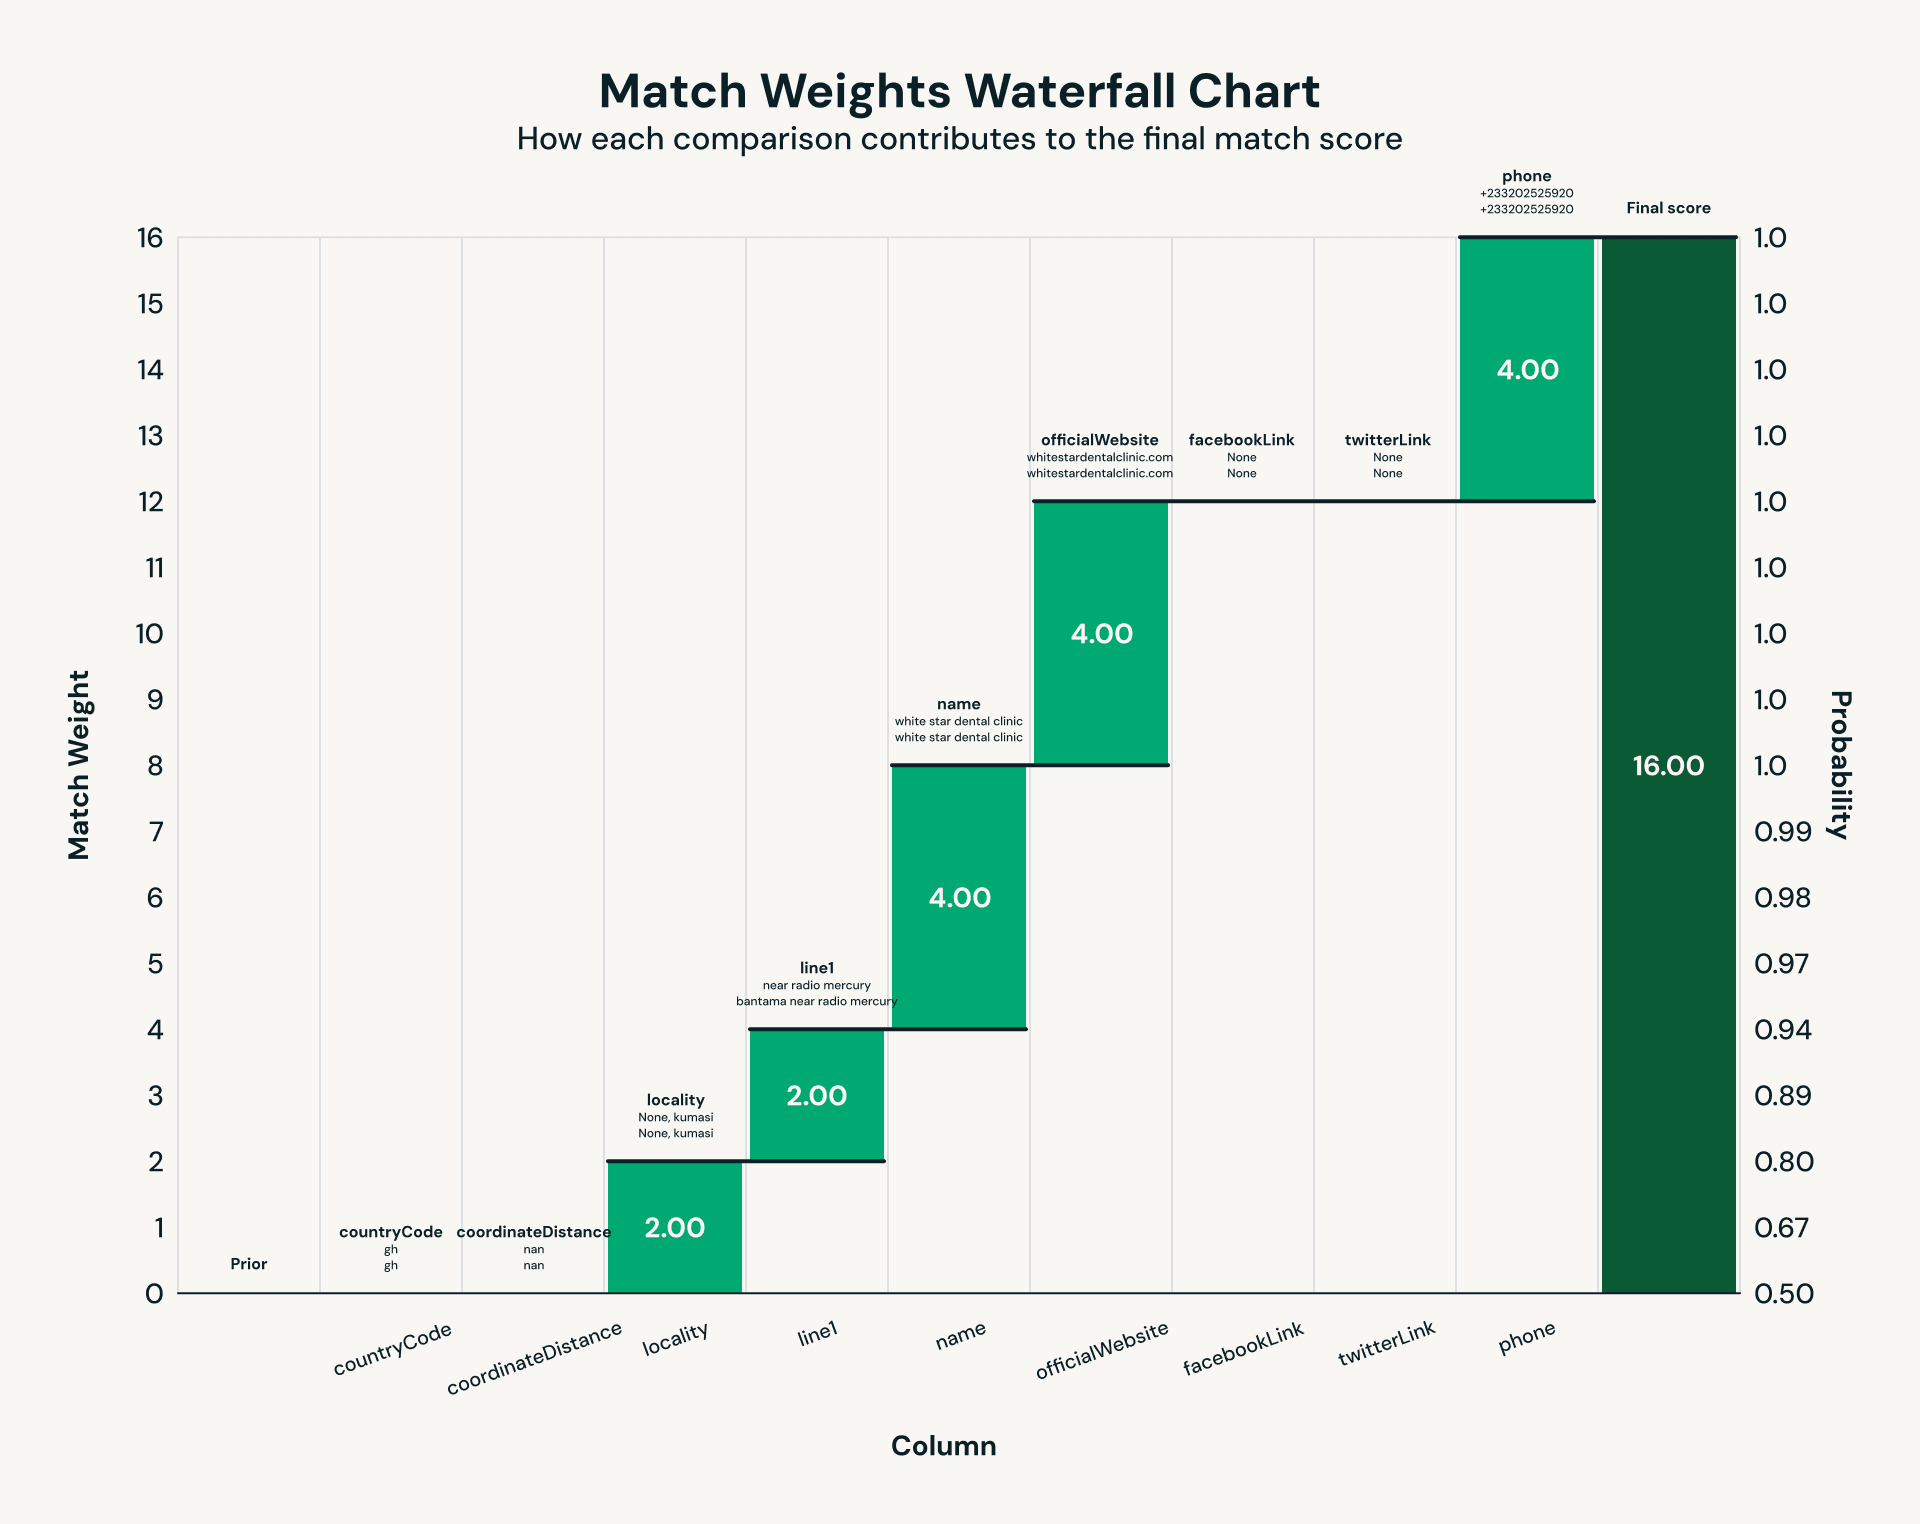
Die Durchführung des probabilistischen Abgleichs über Tausende von Gesundheitseinrichtungen und gemeinnützigen Organisationen hinweg deckte klassische Leistungsengpässe auf, die im Terabyte-Bereich auftreten. Der Kern der Datensatzverknüpfung ist der paarweise Vergleich, was von Natur aus zu ungleichmäßig verteilten Workloads führt: Häufige Vergleiche erzeugen riesige Partitionen, während die meisten anderen viel kleiner bleiben. Erste Durchläufe machten dies schmerzhaft deutlich: Eine Spark-Partition lief 30 Minuten lang, während der Median in 52 Sekunden abgeschlossen war – ein Lehrbuchbeispiel für Nachzügler (der „Fluch des letzten Reducers“), die die Jobleistung beeinträchtigen. Die Aktivierung von Photon, der vektorisierten Query Engine von Databricks, verkürzte die Verarbeitungszeit der am stärksten verzögerten Datenpartitionen von 30 Minuten auf etwa 2 Minuten: eine 15-fache Verbesserung.
VF Agent: Natürliche Sprache trifft auf Gesundheitsdaten
Mit Blick auf die Zukunft haben wir den Prototyp eines Agenten entwickelt, der es Experten ermöglicht, Daten mithilfe natürlicher Sprache zu analysieren. Wir verwenden eine in LangGraph erstellte Multi-Agenten-Architektur und nutzen Databricks Model Serving, AI Search und Genie.
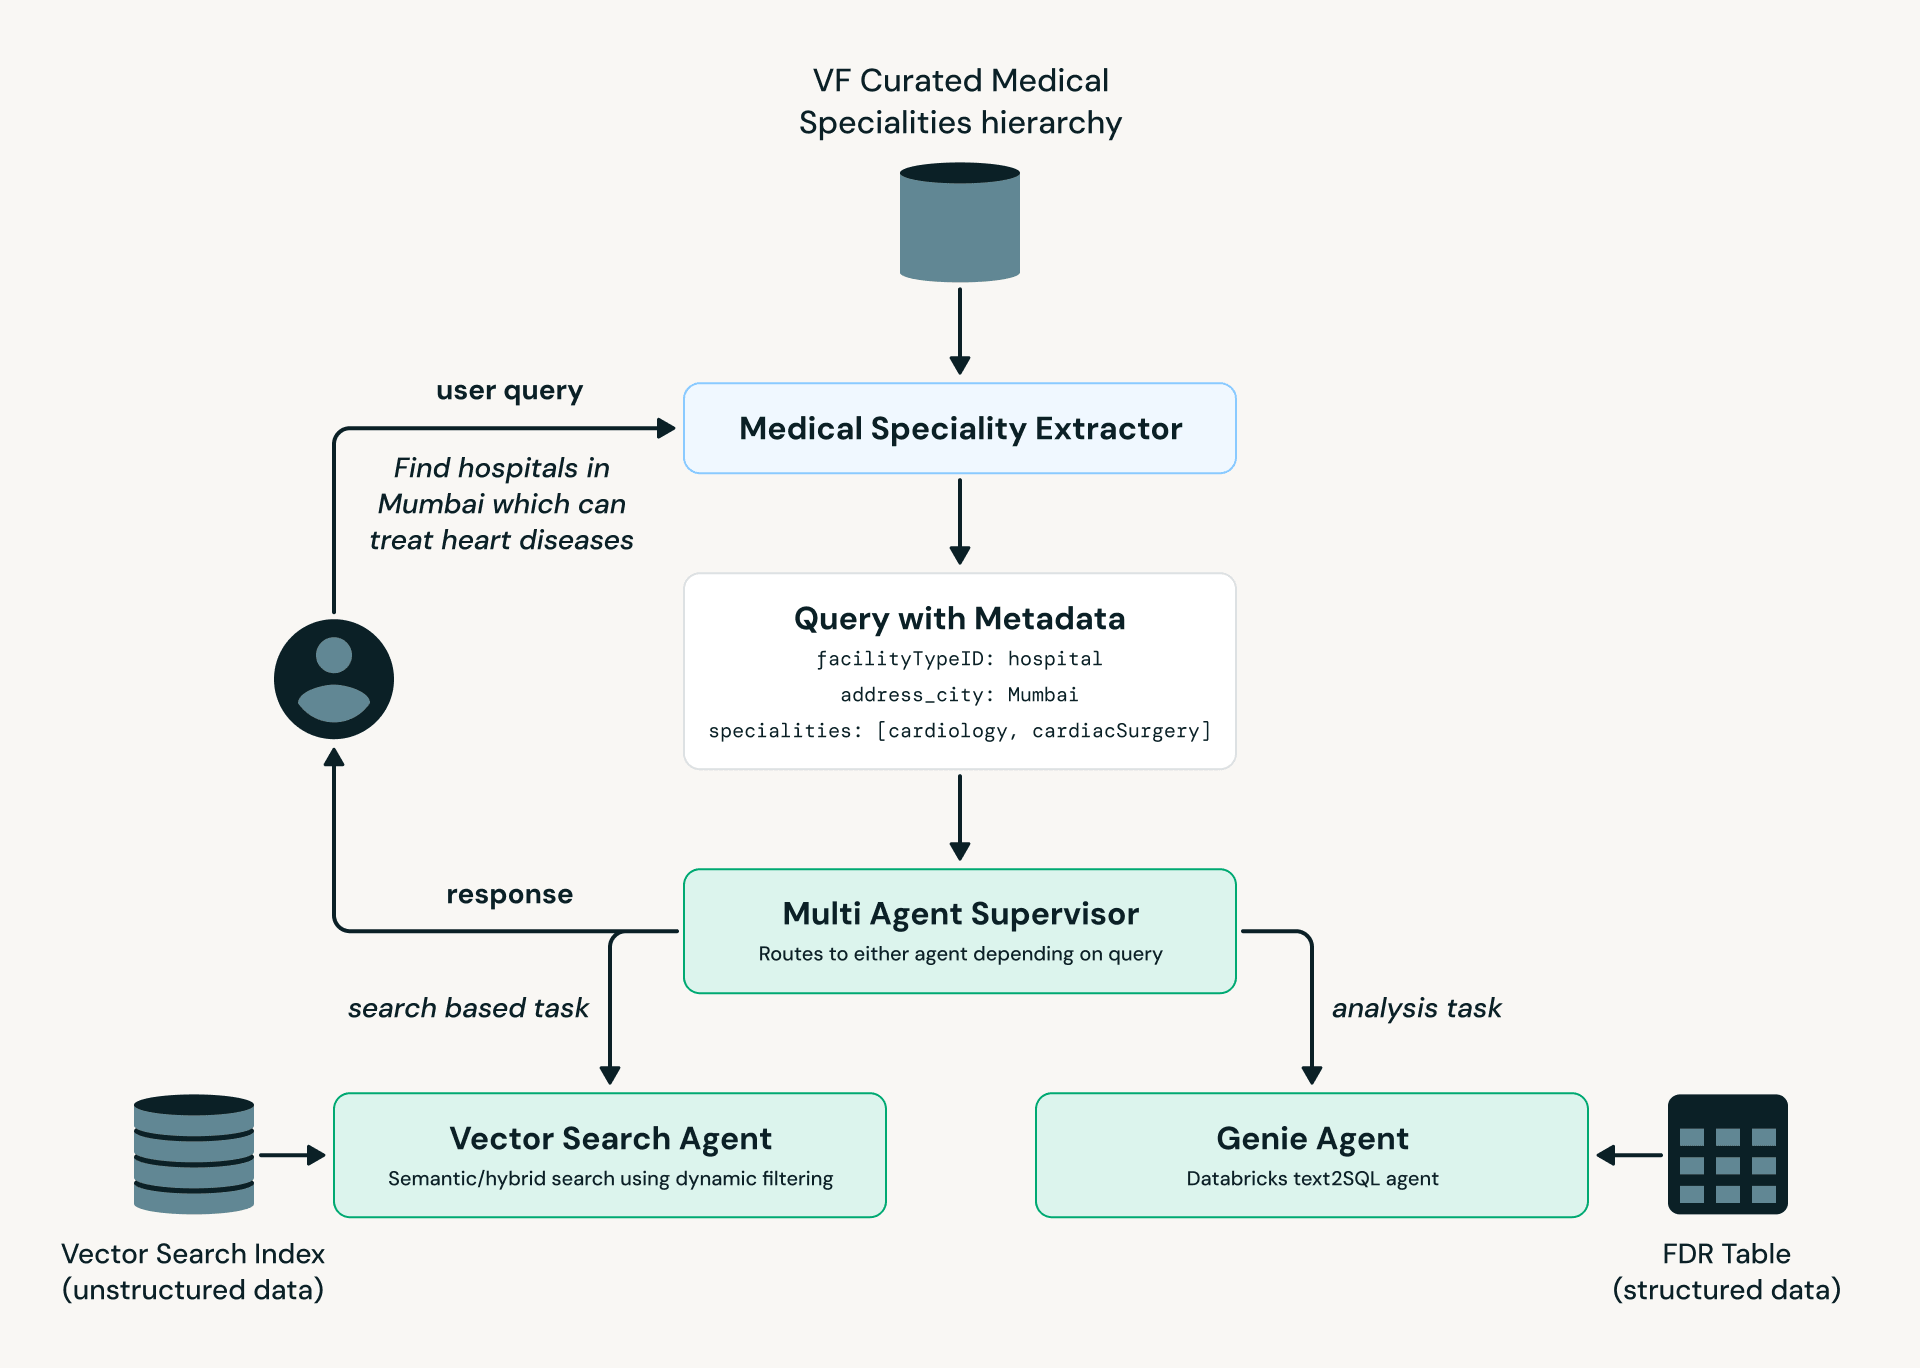
Wie im obigen Diagramm dargestellt, der Medical Specialty Extractor konvertiert die Benutzersprache in eine standardisierte medizinische Terminologie, die dann an den Multi-Agent Supervisor übergeben wird. Je nach Absicht und Komplexität der Abfrage wird diese entweder an den AI Search Agent (Suche und Entdeckung von Einrichtungen) oder den Genie Agent (analytische Abfragen auf strukturierten Daten) weitergeleitet.
Zusammenfassung
Medizinisches Fachpersonal kann jetzt schneller aktuelle Einsatzmöglichkeiten entdecken, passende Angebote für seine medizinischen Fachgebiete finden und auf globale Daten von Tausenden von Einrichtungen weltweit zugreifen. Der Weg der Virtue Foundation vom Proof of Concept bis zur Produktion zeigt, was möglich ist, wenn fortschrittliche AI-Systeme mit einer einheitlichen Datenplattform kombiniert werden.
Das Endergebnis ist eine globale Sicht auf die Gesundheitsinfrastruktur – die zeigt, wo medizinische Freiwillige am dringendsten benötigt werden.
Wenn Sie mehr über dieses Projekt erfahren möchten, lesen Sie bitte hier weiter:
- Databricks x Virtue Foundation Projektübersicht – YouTube
- UN Bloomberg Interview (YouTube) – ab Minute 38:00
- Video-Testimonial: Bright Initiative x Virtue Foundation x Databricks
Erfahren Sie unten mehr über einige unserer anderen „Databricks for Good“-Projekte:
(Dieser Blogbeitrag wurde mit KI-gestützten Tools übersetzt.) Originalbeitrag
Erhalten Sie die neuesten Beiträge in Ihrem Posteingang
Abonnieren Sie unseren Blog und erhalten Sie die neuesten Beiträge direkt in Ihren Posteingang.