
序章
Databricks Model Servingは、古典的な機械学習モデル、生成AIモデル、AIエージェントをデプロイするための堅牢なソリューションを企業に提供します。Azure OpenAI、AWS Bedrock、Anthropic などのプロプライエタリモデルや、Llama や Mistral などのオープンソースモデルをサポートしています。 顧客は、ファインチューニングされたオープンソースモデルや、独自のデータでトレーニングされた古典的な機械学習 モデルをサーブすることもできます。お客様は、大規模なバッチ推論やリアルタイムアプリケーションなどのワークフローで、サービングされたモデルをEndpointとして簡単に利用できます。モデルサービングには、高品質な出力を確保するための組み込みのガバナンス、リネージ、モニタリングも備わっています。
お客さまの声
すべてのAIモデルとエージェントのデプロイを簡素化
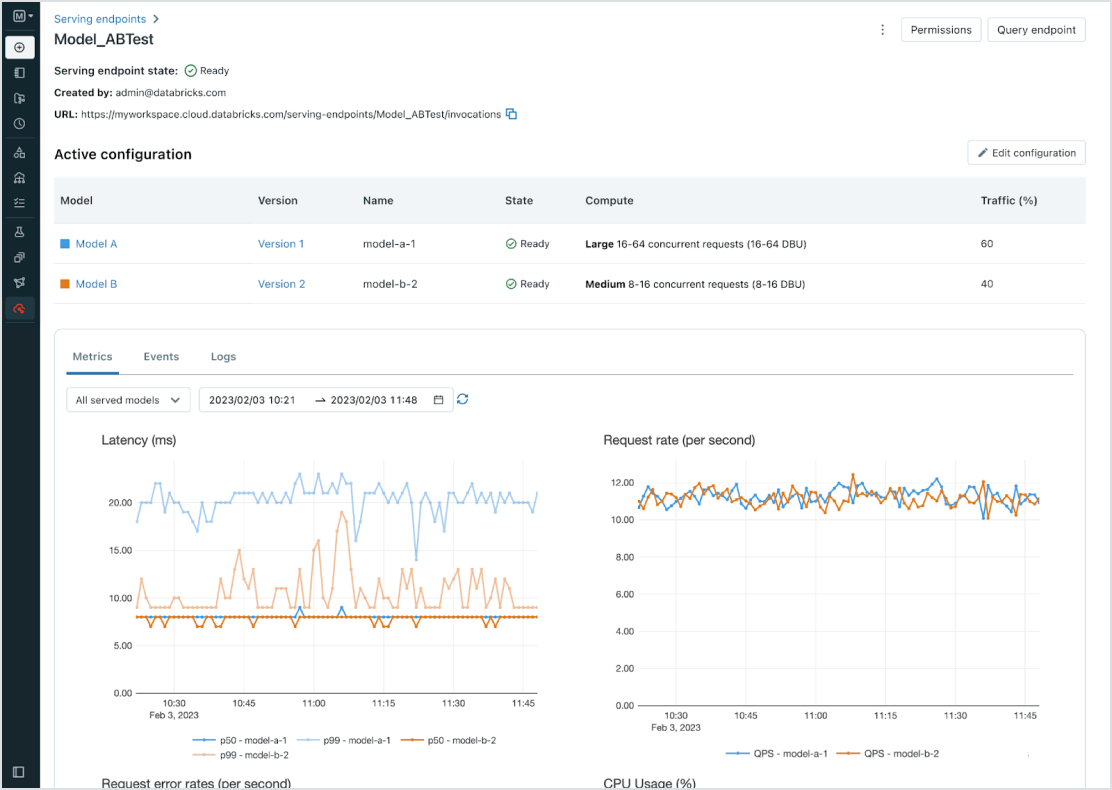
事前トレーニング済みのオープンソース モデルから、独自のデータで構築したカスタムモデルまで、あらゆる種類のモデルを CPU と GPU の両方でデプロイできます。コンテナのビルドとインフラストラクチャ管理を自動化することで、メンテナンス コストを削減し、デプロイを迅速化します。これにより、AI エージェント システムの構築に集中し、ビジネス価値をより迅速に提供できるようになります。
全モデルの一元管理
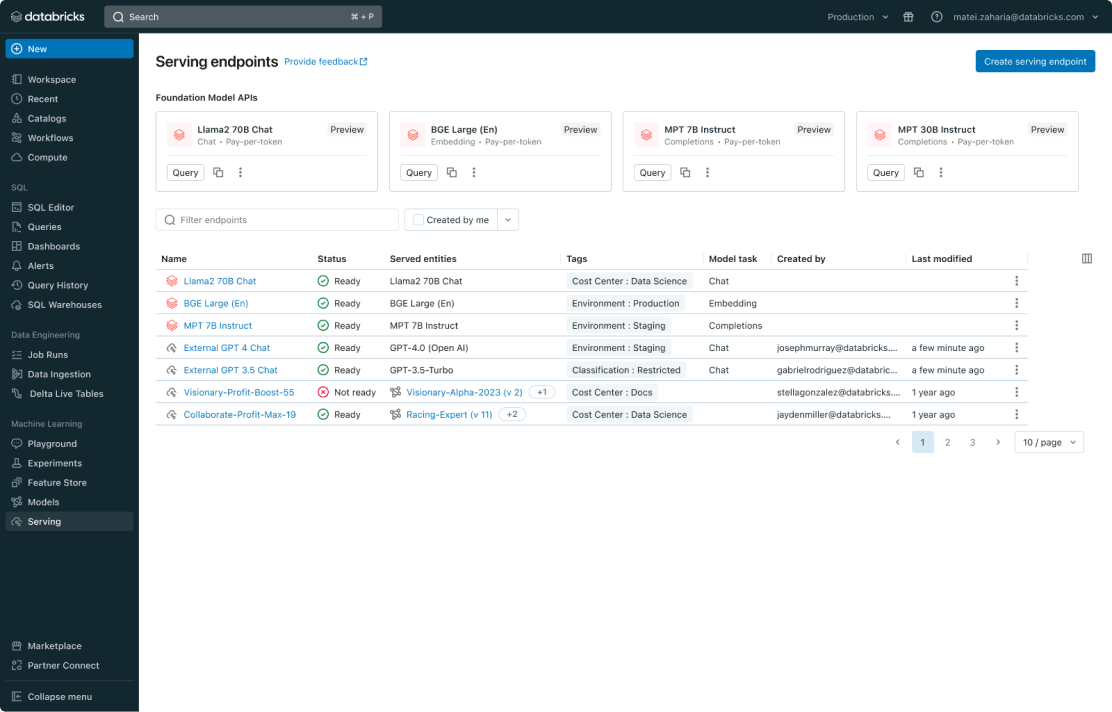
PyFunc、scikit-learn、LangChain のようなカスタム ML モデル、Llama 2、MPT、BGE のようなDatabricks 上の基盤モデル(FM)、ChatGPT、Claude 2、Cohere、Stable Diffusion のような他の場所でホストされている基盤モデルを含む全てのモデルを管理します。モデルサービングは、Databricks がホストしているモデルや、Azure や AWS 上の他のモデルプロバイダからのモデルを含め、統一されたユーザーインターフェースと API で全てのモデルにアクセスできるようにします。
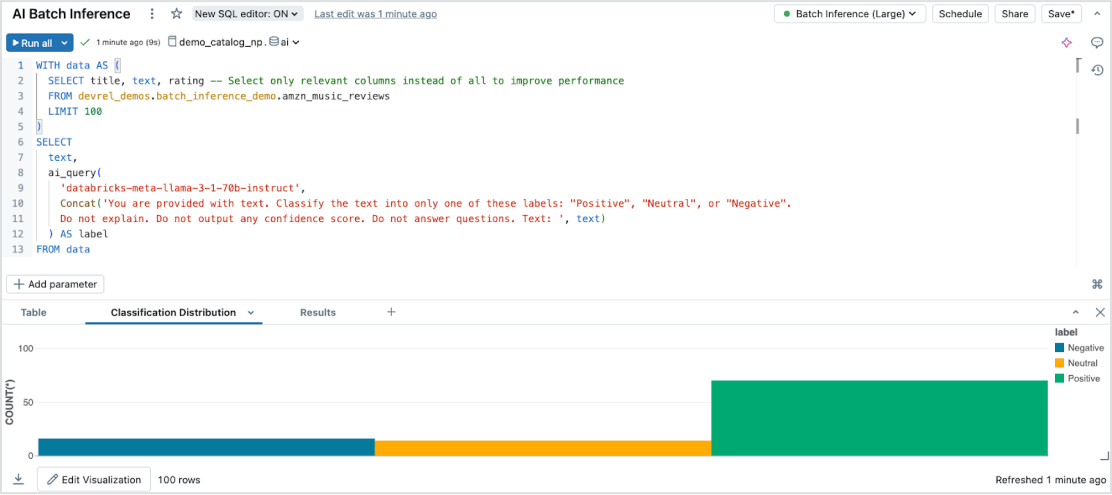
簡単なバッチ推論
Model Servingは、あらゆるデータ型とモデルにわたる大規模なデータセット上で、効率的でServerlessな AI 推論を可能にします。Databricks SQL、ノートブック、ワークフローとシームレスに統合して、AI を大規模に適用できます。AI Functions を使用すると、インフラストラクチャの管理なしで、大規模なバッチ推論を即座に実行し、スピード、スケーラビリティ、ガバナンスを確保できます。
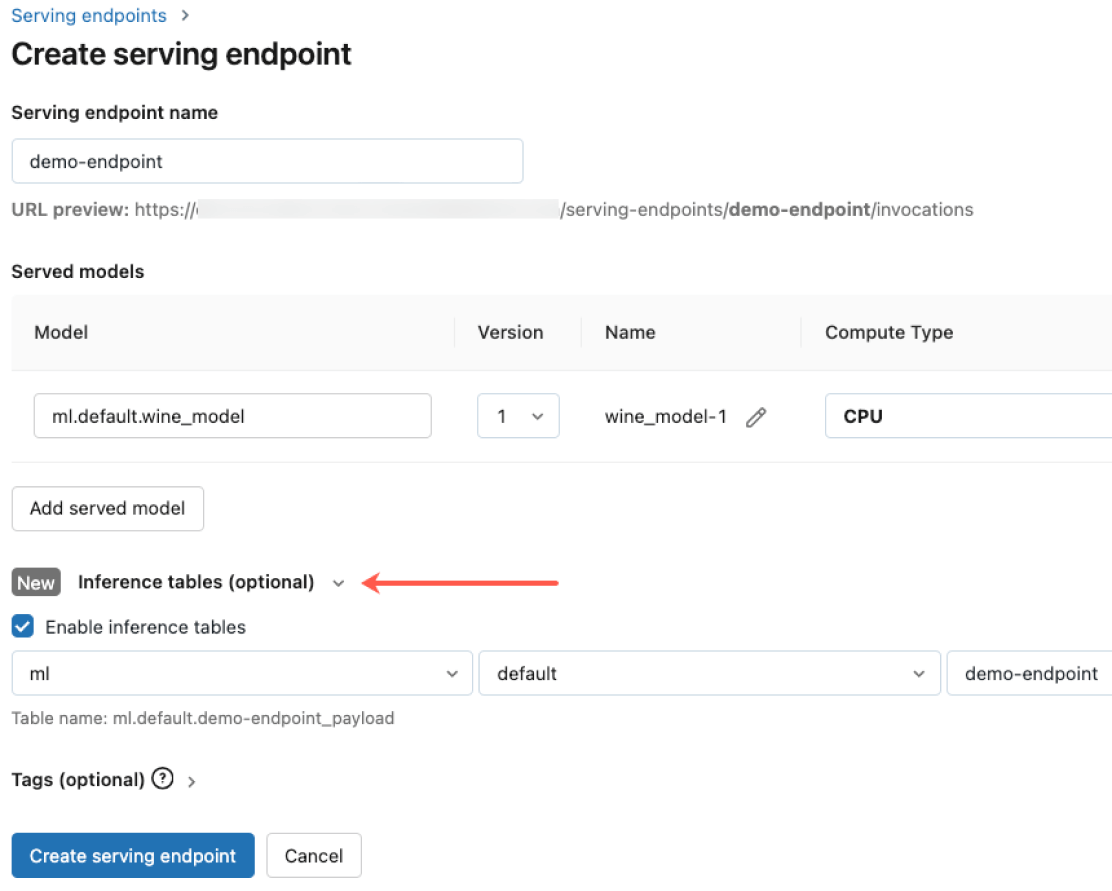
組み込まれたガバナンス
Agent Bricks AI Gateway と統合し、厳格なセキュリティ要件と高度なガバナンス要件を満たします。Databricksまたは他のモデルプロバイダーによってホストされているかにかかわらず、すべてのモデルにわたって適切な権限を適用し、モデル品質を監視し、レート制限を設定し、リネージを追跡できます。
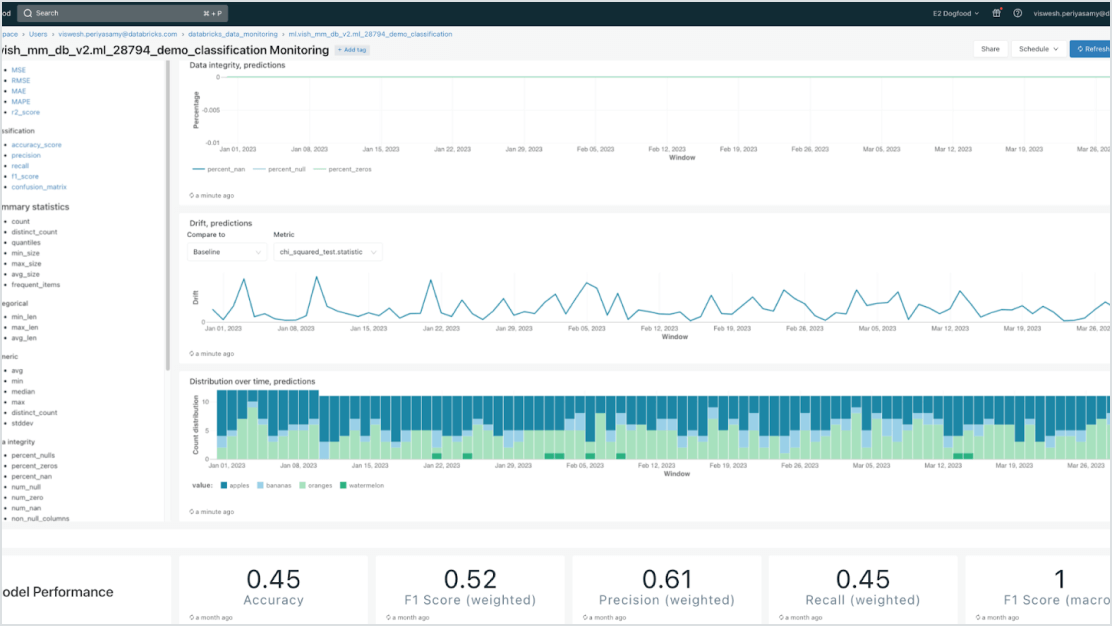
データ中心のモデル
データインテリジェンスプラットフォームとの強力な統合により、デプロイメントを加速し、エラーを削減します。企業データで拡張(RAG)またはファインチューニングされたさまざまな生成 AI モデルを簡単にホストできます。モデルサービングは、AI のライフサイクル全体にわたって、自動化されたルックアップ、モニタリング、ガバナンスを提供します。
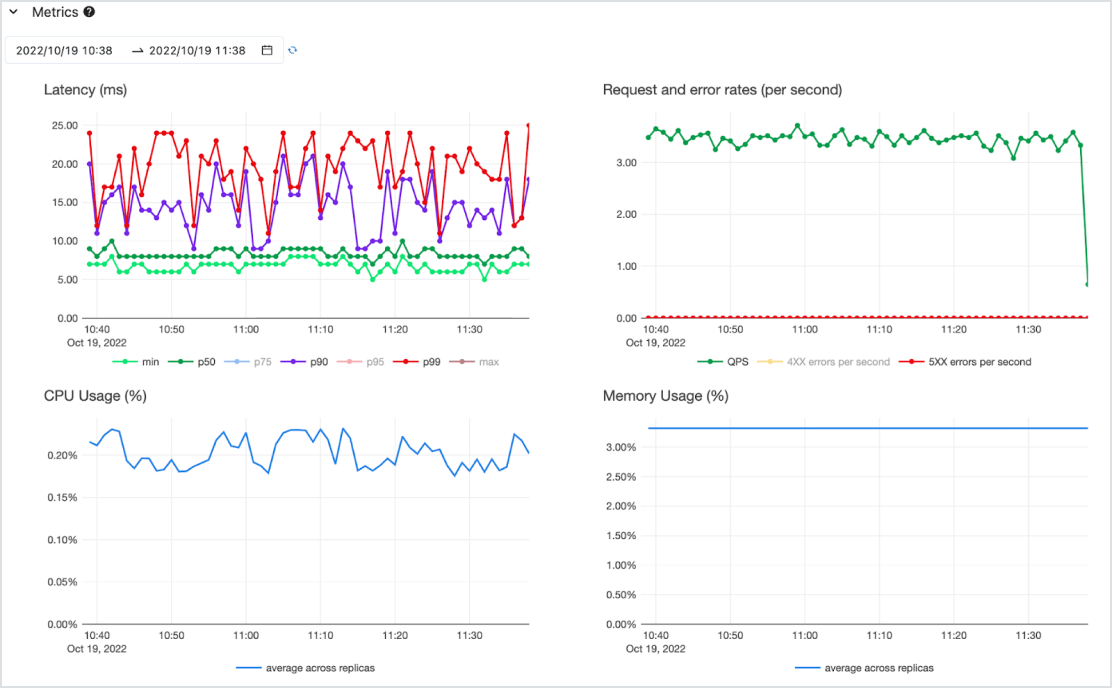
費用対効果
CPU と GPU の両方をサポートした可用性の高いサーバーレスサービス上で、低遅延の API としてモデルを提供します。最も重要なニーズを満たすためにゼロから簡単に拡張でき、要件が変化した場合は縮小できます。1 つまたは複数のデプロイ済みモデルと、スループット保証のためのトークンごとの支払い(コミットメントなしのオンデマンド)、またはプロビジョニングされたコンピュートワークロードの支払いによって迅速に開始できます。Databricks がインフラの管理とメンテナンスのコストを引き受けます。これにより、お客さまはビジネス価値の提供に専念することが可能です。