Das offene Pipeline-Framework für Agenten und Datenteams
Erstellen Sie sicher Pipelines für die agentische Skalierung mit integrierter Datenqualität, Val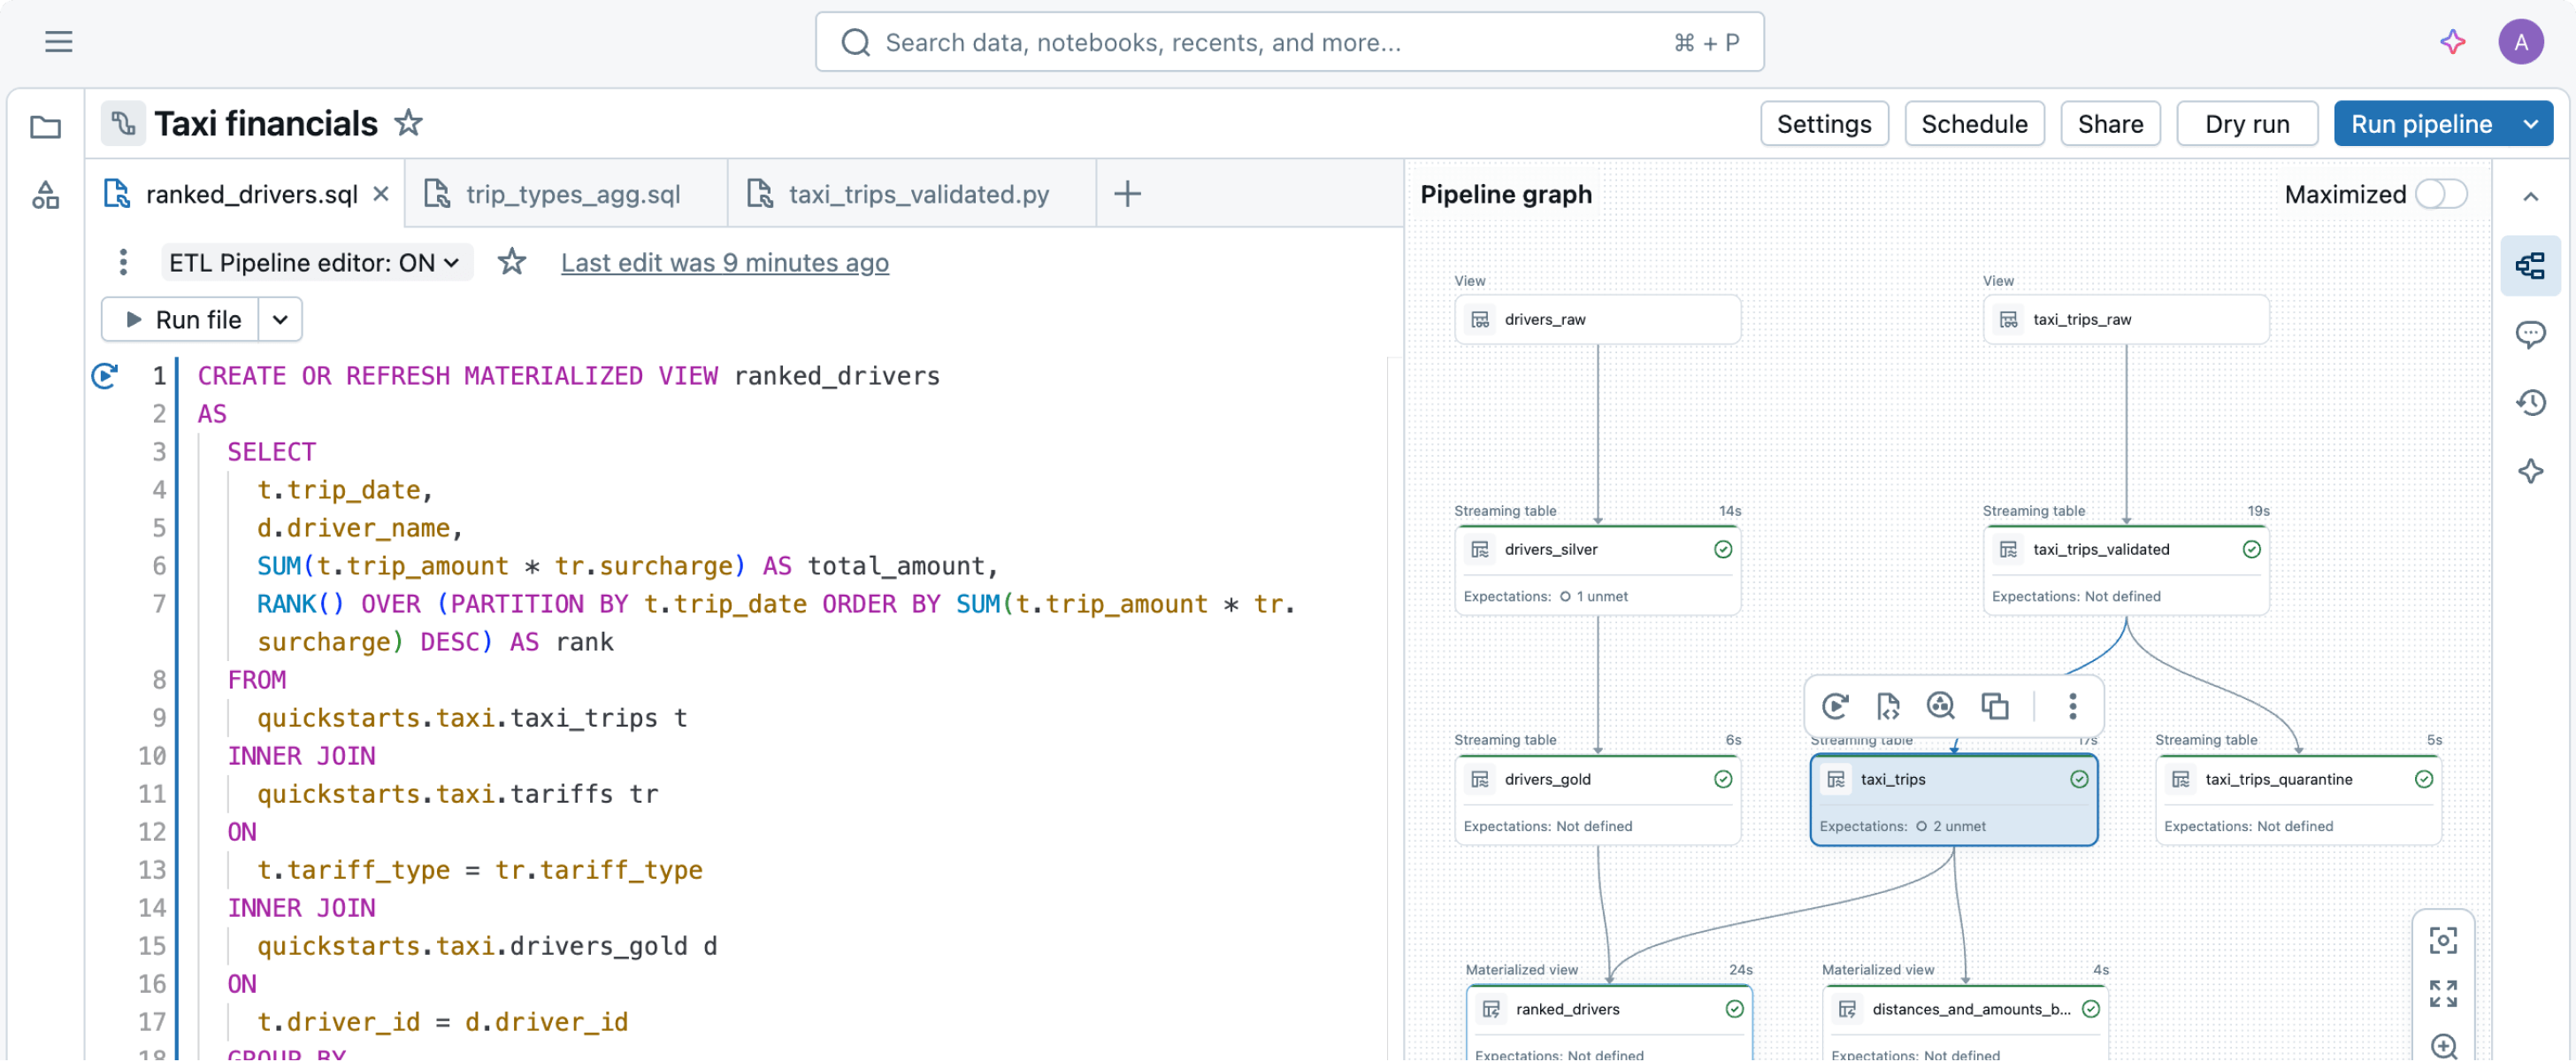
TOP TEAMS SUCCEED WITH INTELLIGENT DATA PIPELINES
Erstellen und betreiben Sie Pipelines im agentischen Maßstab mit Zuversicht
Unterstützen Sie Datenteams und KI-Agenten mit offenen Standards, automatisierten Qualitätsprüfungen und Governance auf Unternehmensebene.
Offene Standards
Der universelle offene Standard für Datenpipelines. Vereinheitlichen Sie Batch und Streaming sowie SQL und Python in Apache Spark™ – und bieten Sie eine portable Grundlage für Datenteams und KI-Agenten zur Generierung robusten Produktionscodes.

Für Agenten konzipiert
Das native Framework für Codierungsagenten. Agenten deklarieren Zieldatenergebnisse. Apache Spark™ Declarative Pipelines (SDP) löst automatisch Abhängigkeitsdiagramme auf, führt Compiler-Dry-Runs aus und setzt Qualitätsregeln durch, bevor Pipelines ausgeführt werden.

Kontrollierte Ausführung
Sichere, autonome Pipeline-Ausführung. Unity Catalog setzt strenge Kataloggrenzen und Sicherheit durch, während SDP hinter den Kulissen Zustandsverwaltung, Fehlerwiederherstellung und inkrementelle Verarbeitung übernimmt.
Zur Standardisierung der Pipeline-Entwicklung für Agenten und Menschen
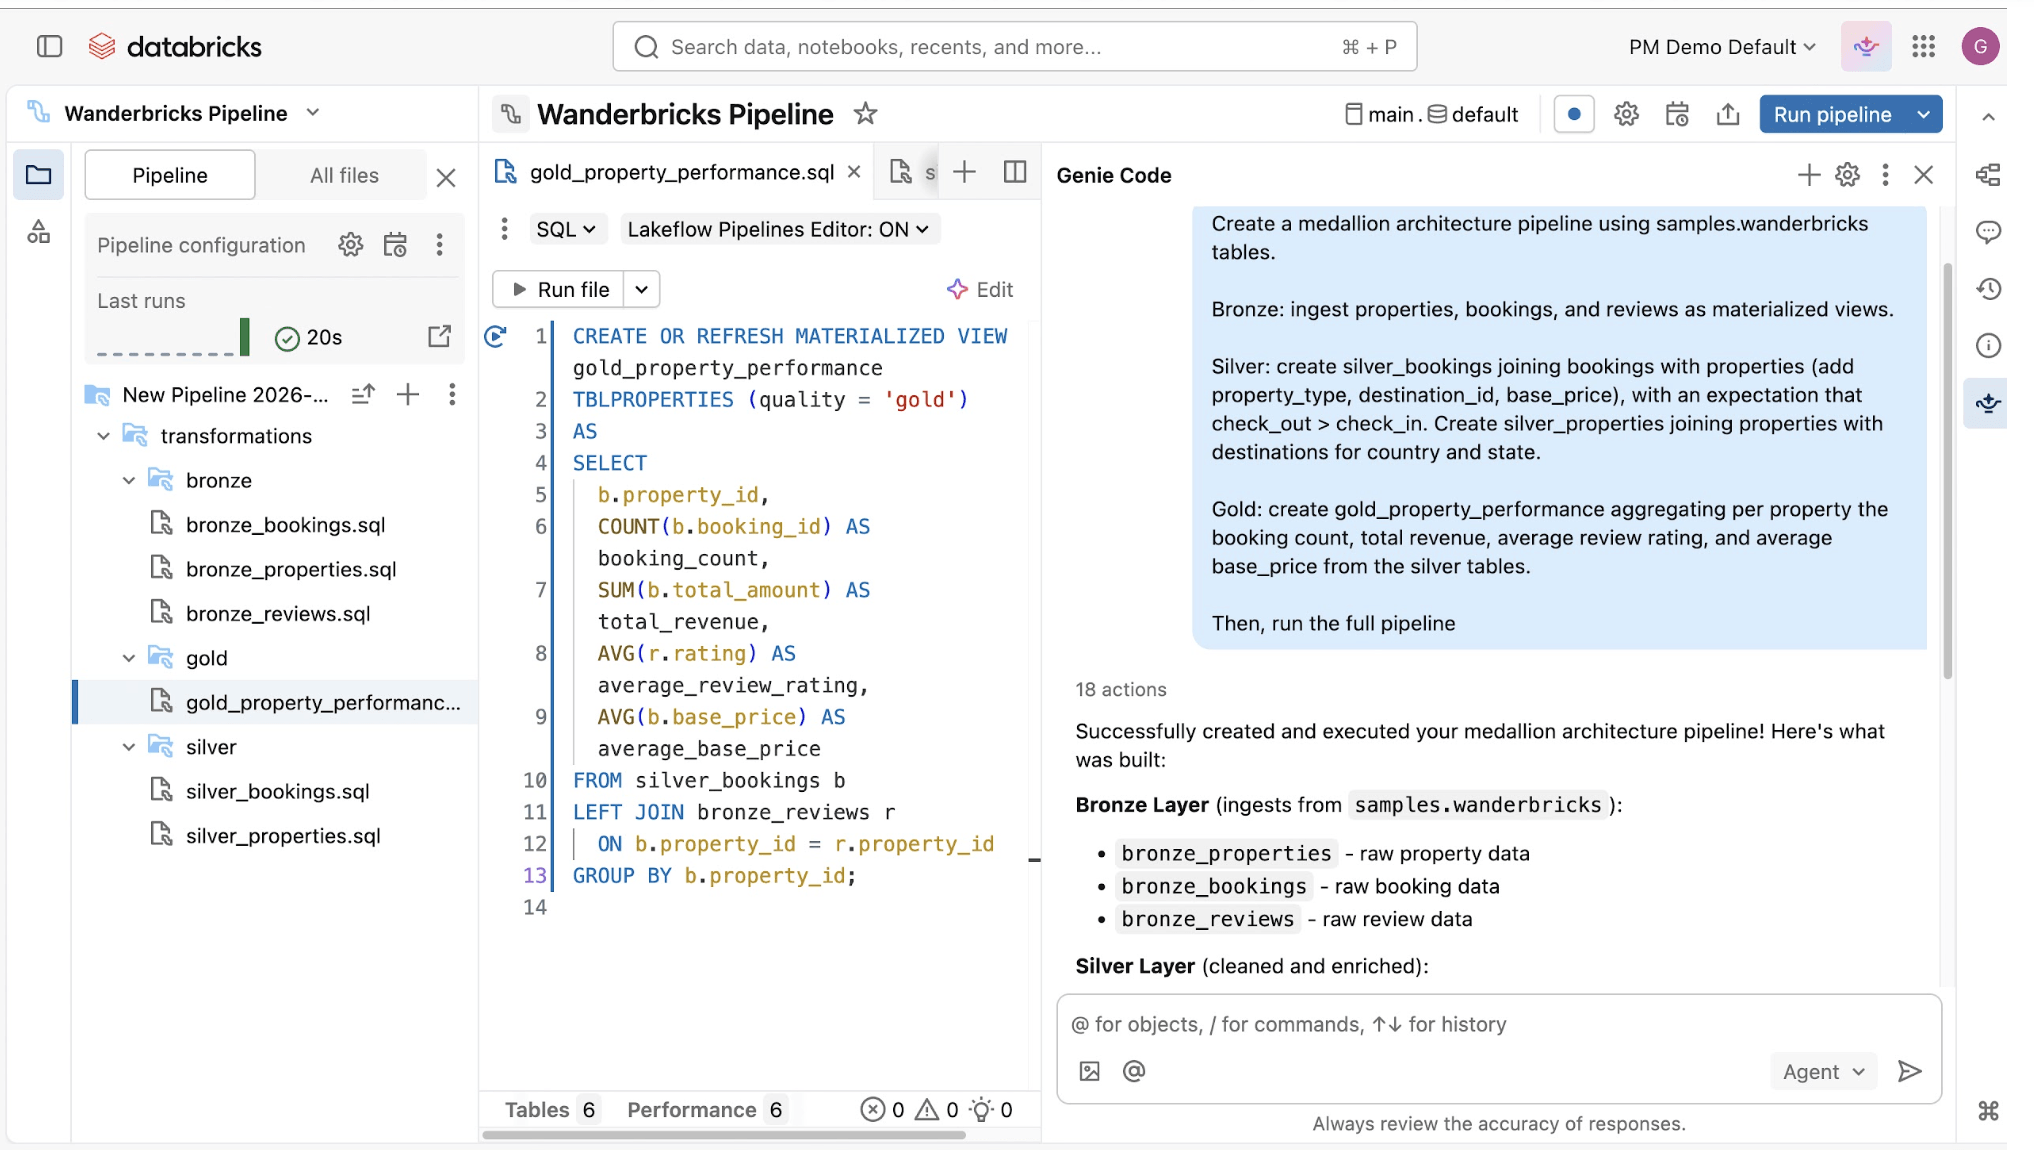
Standardisieren Sie die Pipeline-Entwicklung mit agentenfähigem Authoring und automatisierter Pattern-Handhabung sowie einem Framework für alle Teams.Erstellen, validieren und iterieren Sie deklarativ in natürlicher Sprache über Genie Code – oder über den Codierungsagenten Ihrer Wahl.
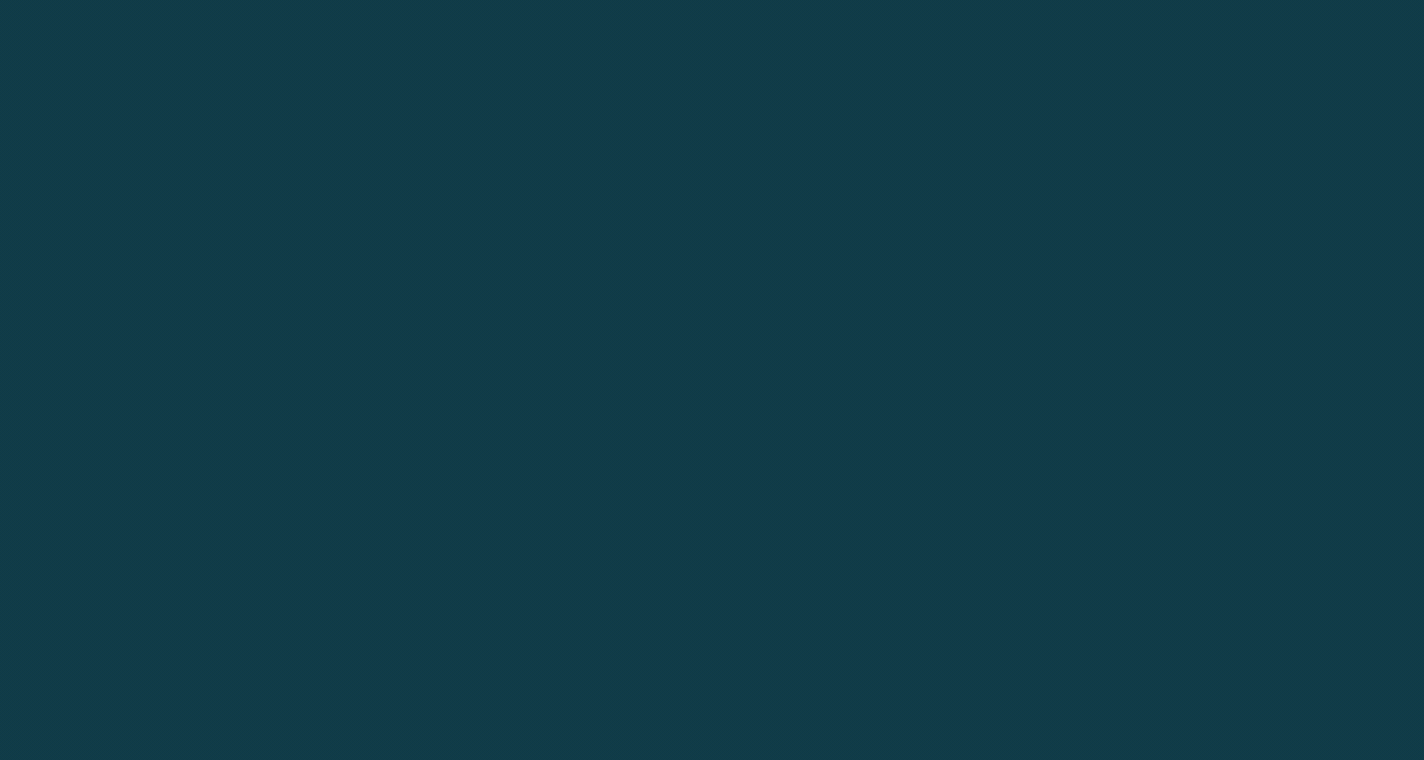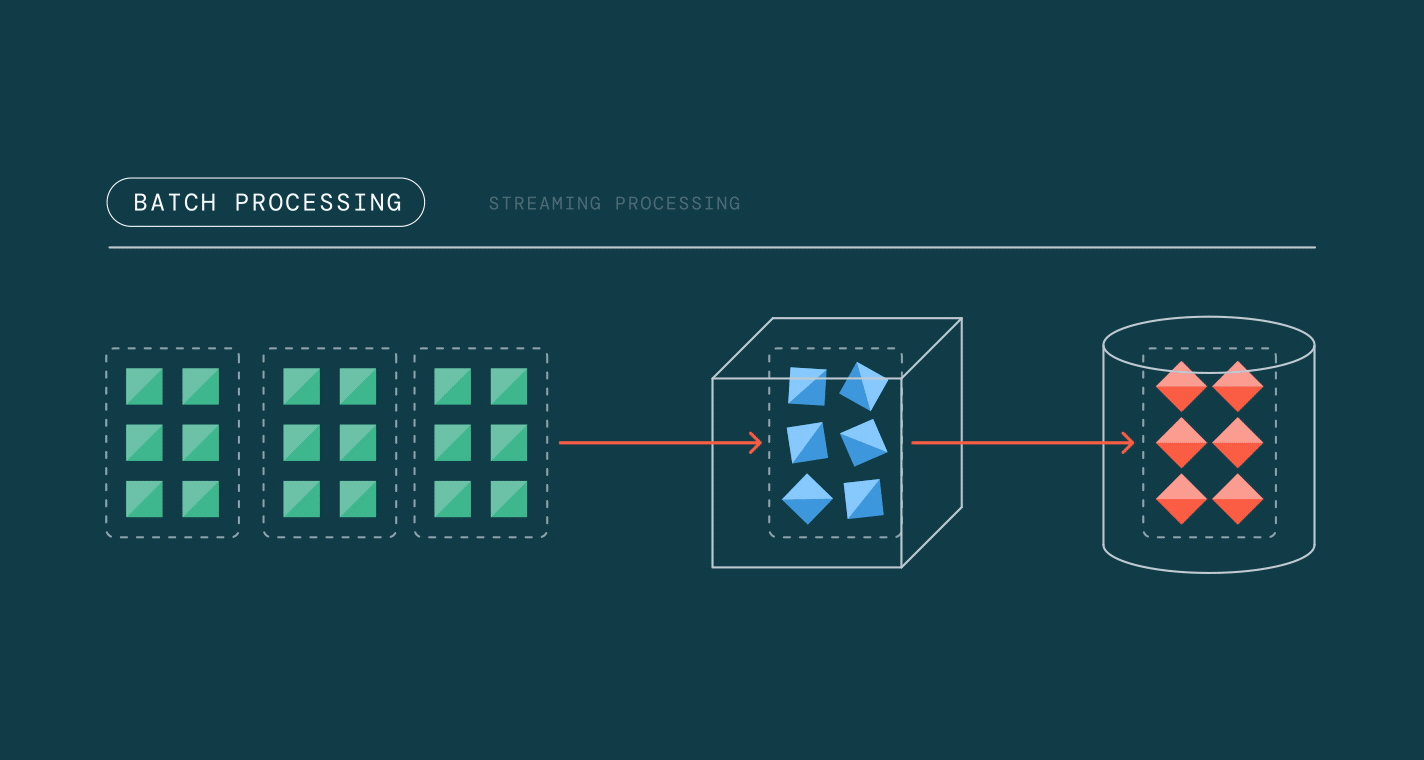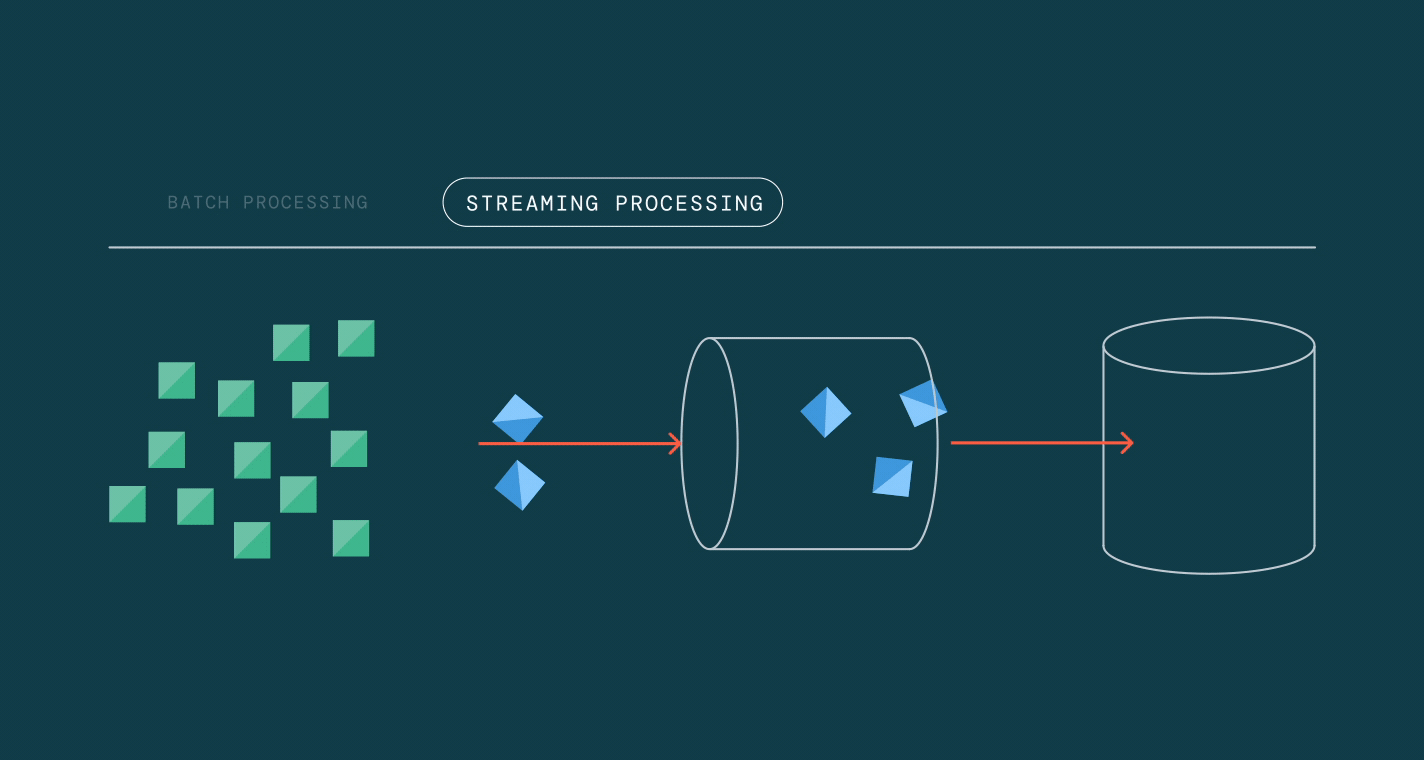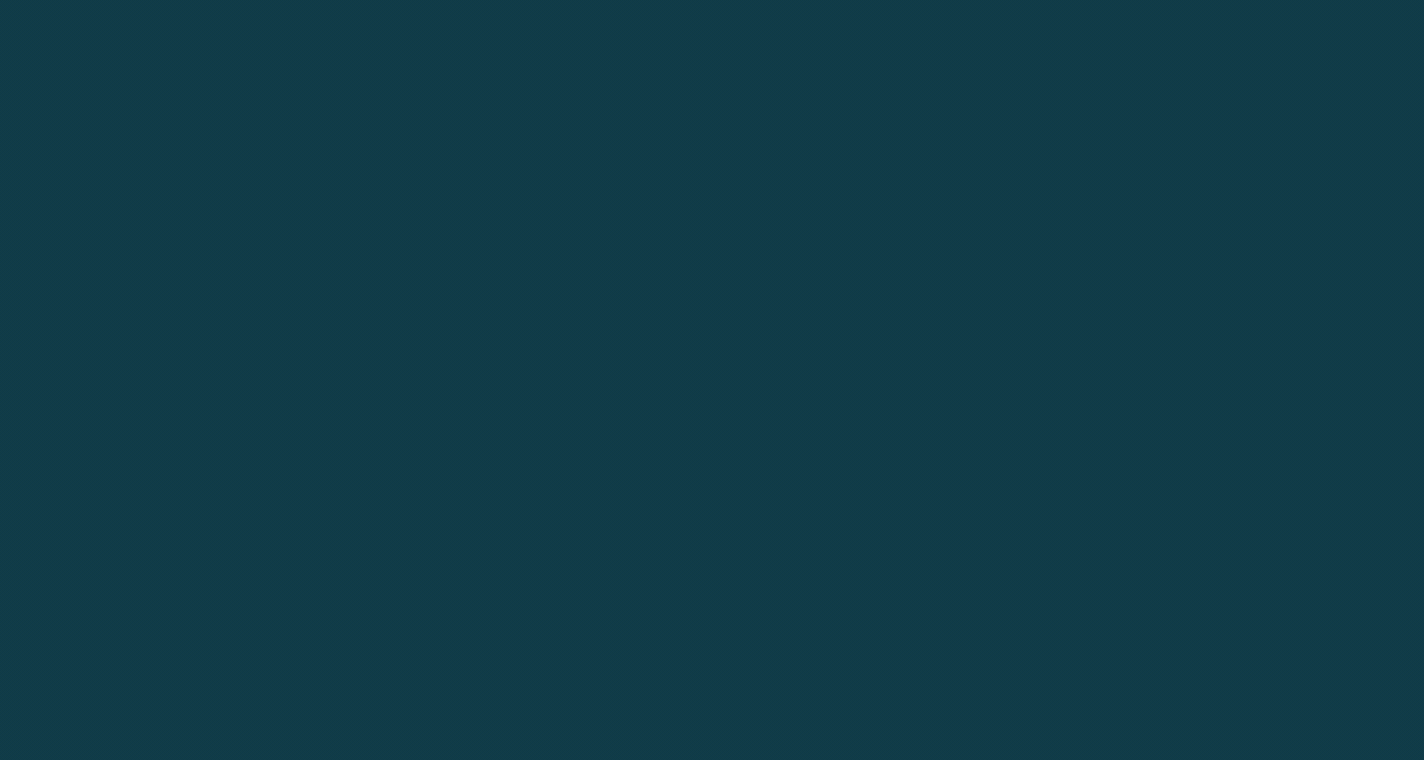
Durch die Nutzung der einheitlichen API von Spark für die Batch- und Stream-Verarbeitung können Sie mit SDP einfach zwischen den Verarbeitungsmodi wechseln.
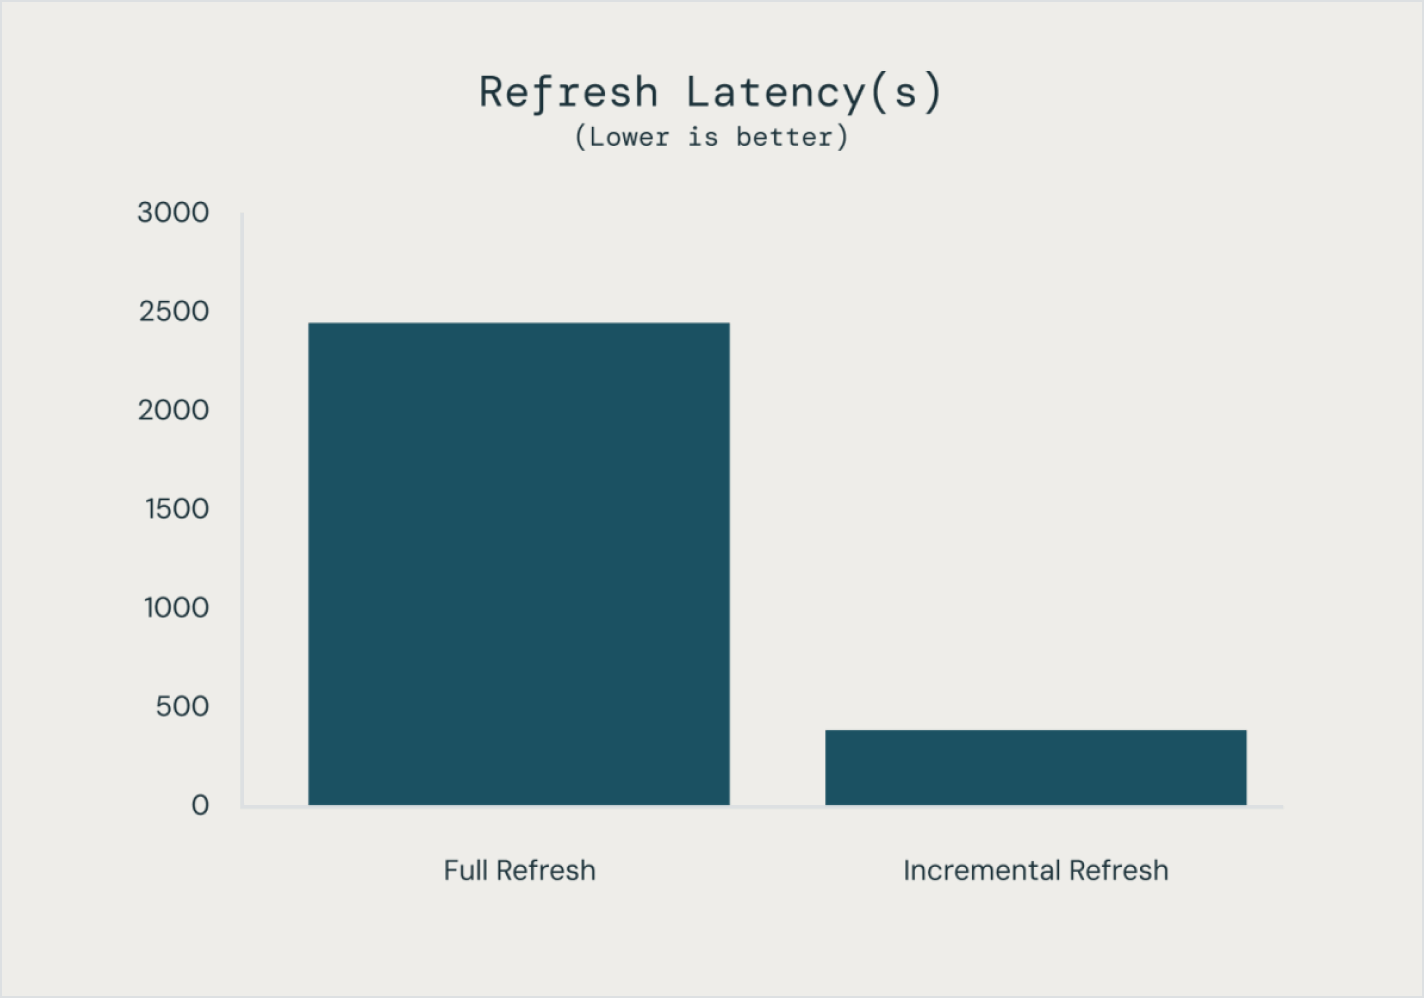
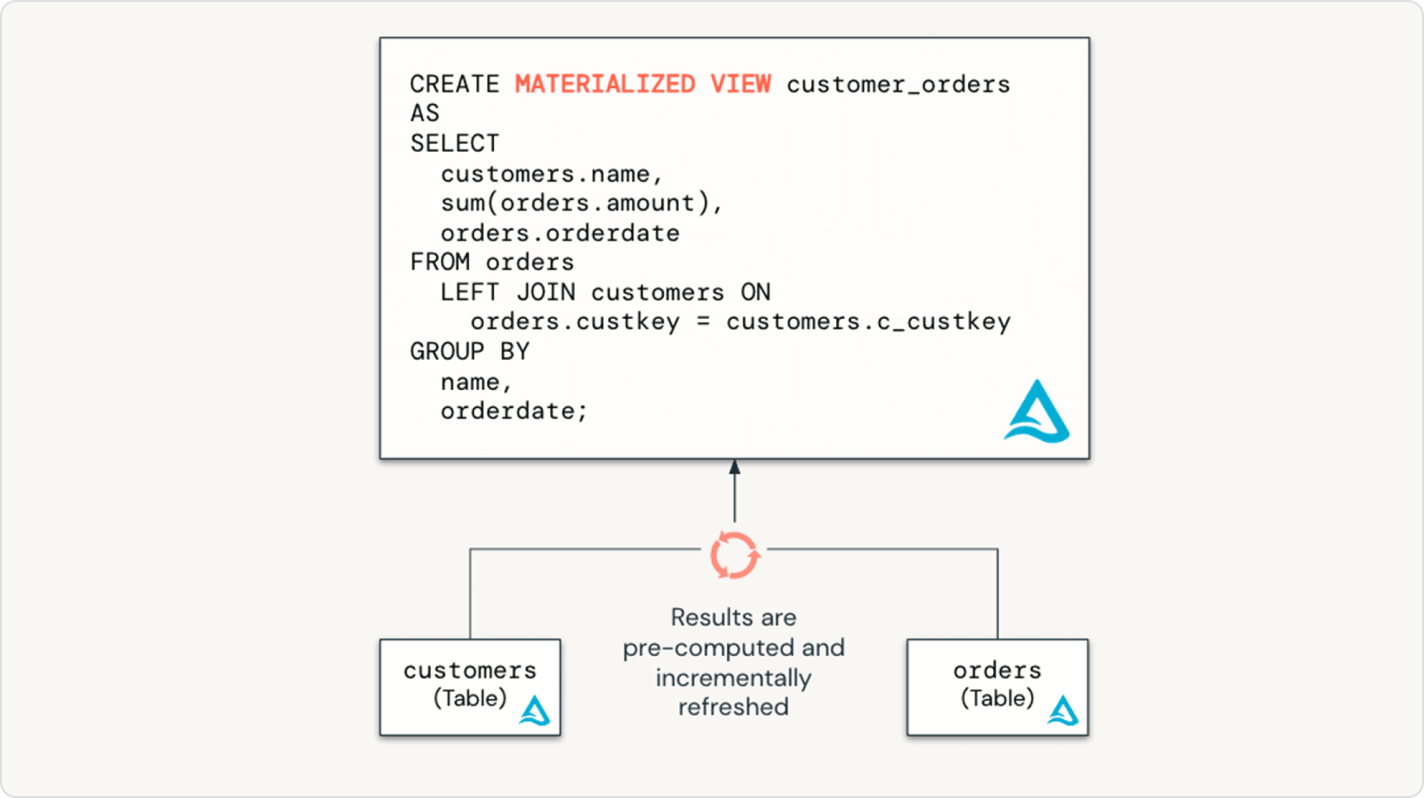
SDP erleichtert die Optimierung der Pipeline-Leistung durch Deklarieren einer gesamten inkrementellen Datenpipeline mit Tabellen und materialisierten Ansichten.
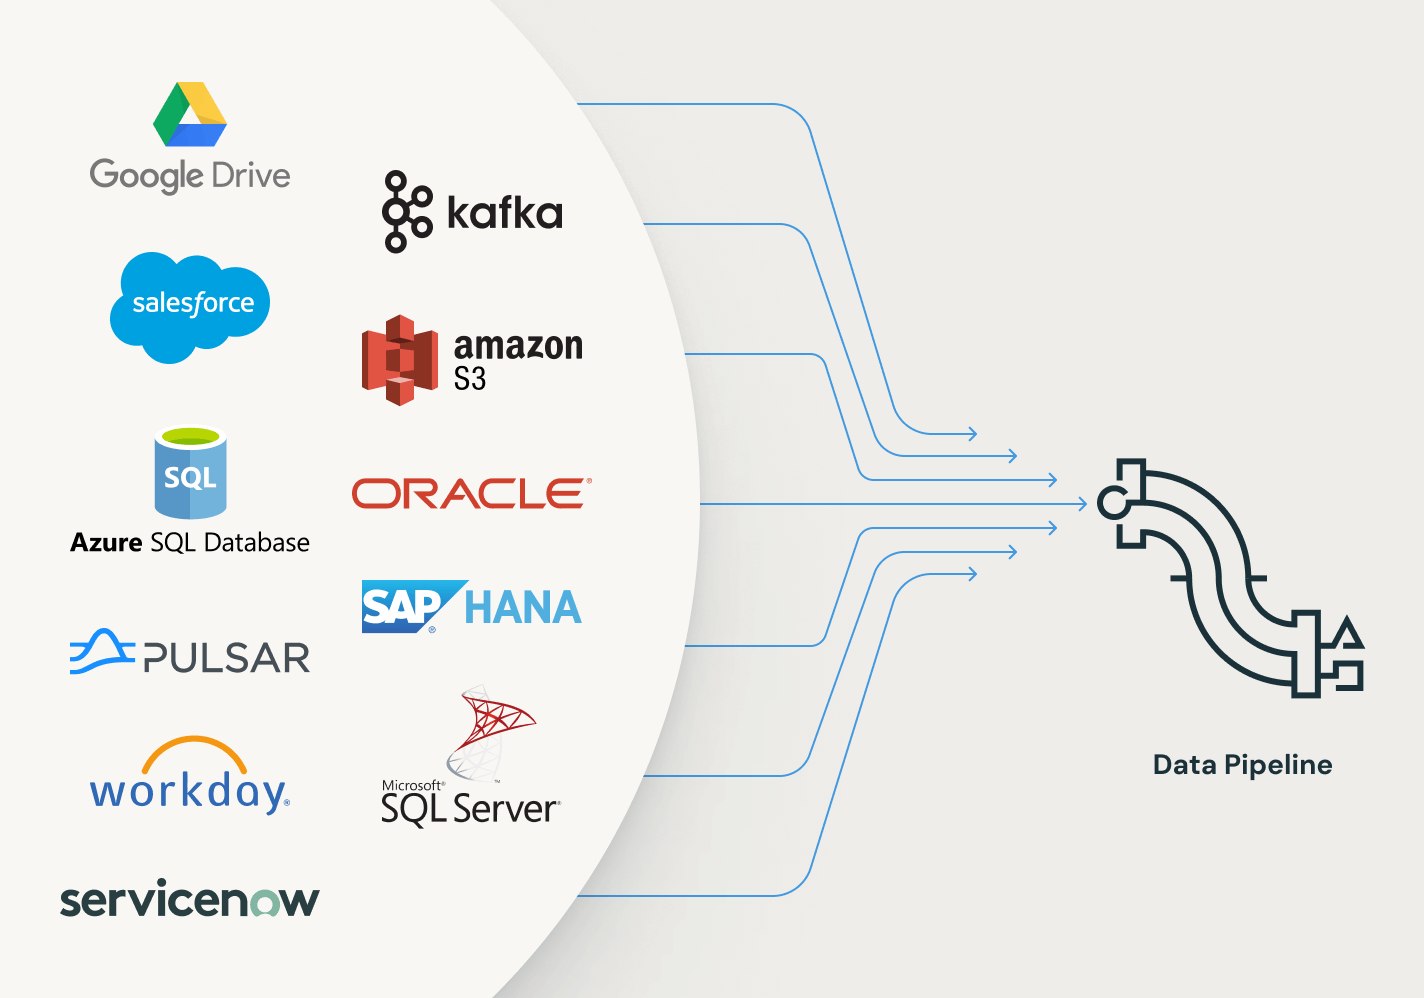
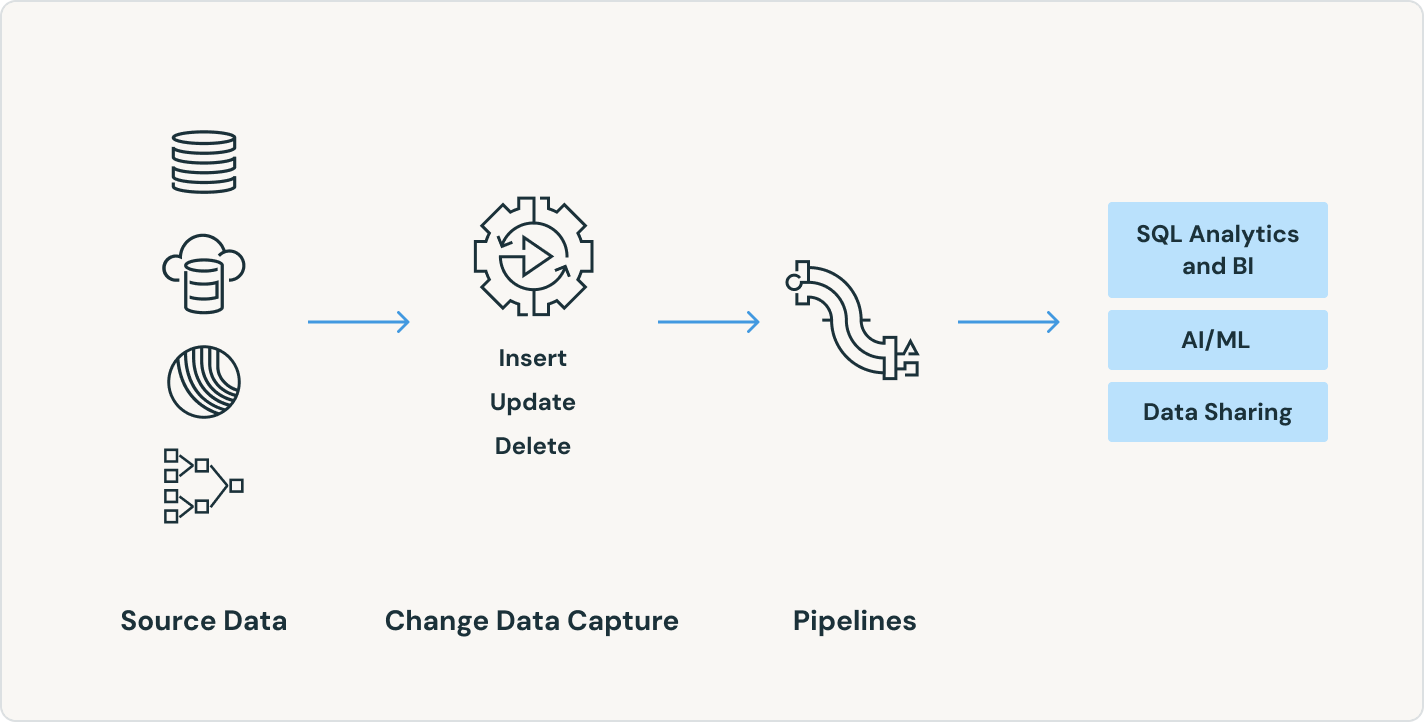
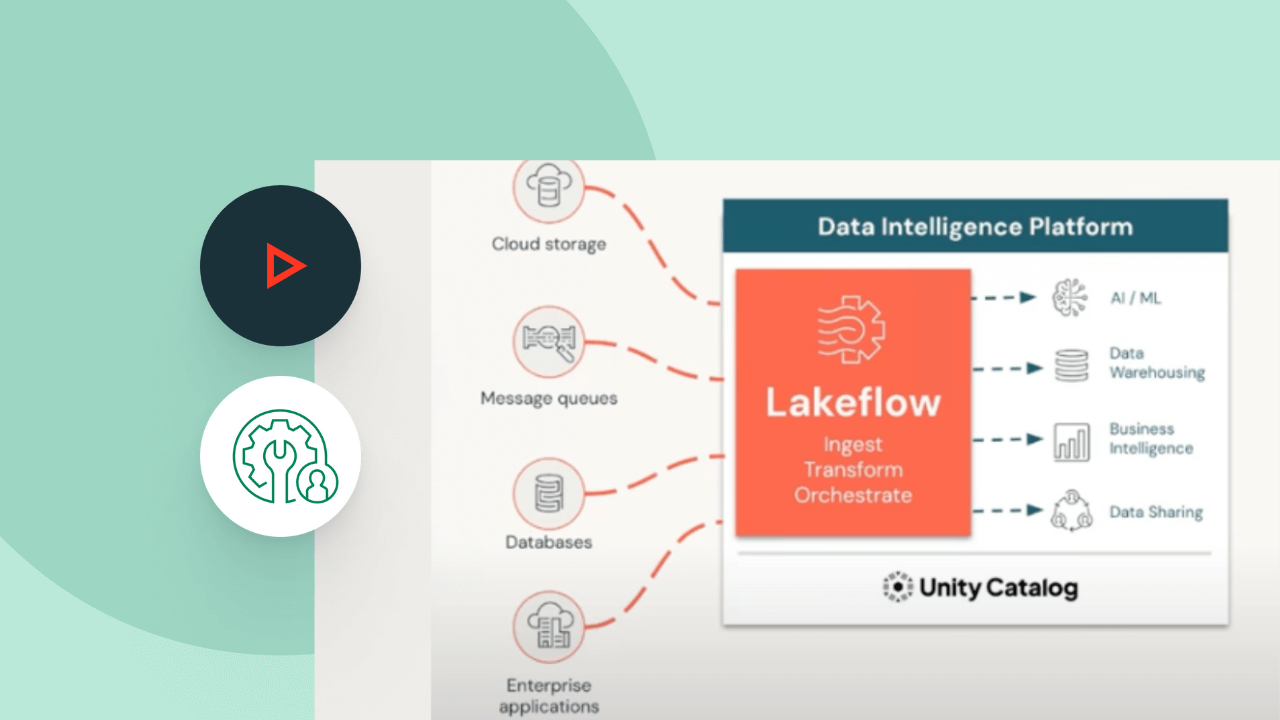
SDP unterstützt ein breites Ökosystem von Quellen und Senken. Laden Sie Daten aus jeder beliebigen Quelle, einschließlich Cloud-Speicher, Message-Bussen, Change Data Feeds, Datenbanken und Enterprise-Apps.
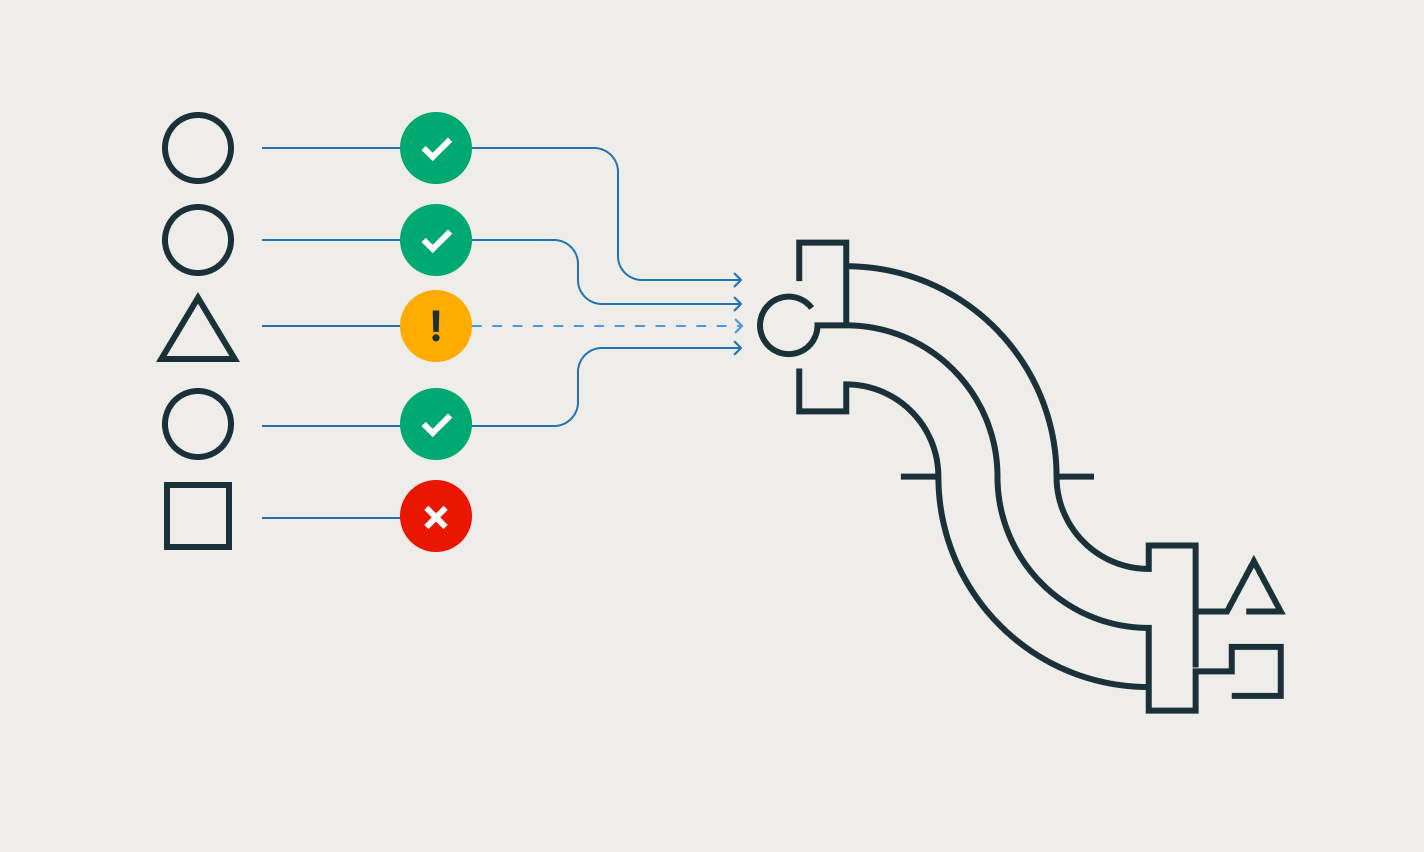
Mit Expectations können Sie sicherstellen, dass die in Tabellen eingehenden Daten die Datenqualitätsanforderungen erfüllen und bei jeder Pipeline-Aktualisierung Erkenntnisse zur Datenqualität liefern.
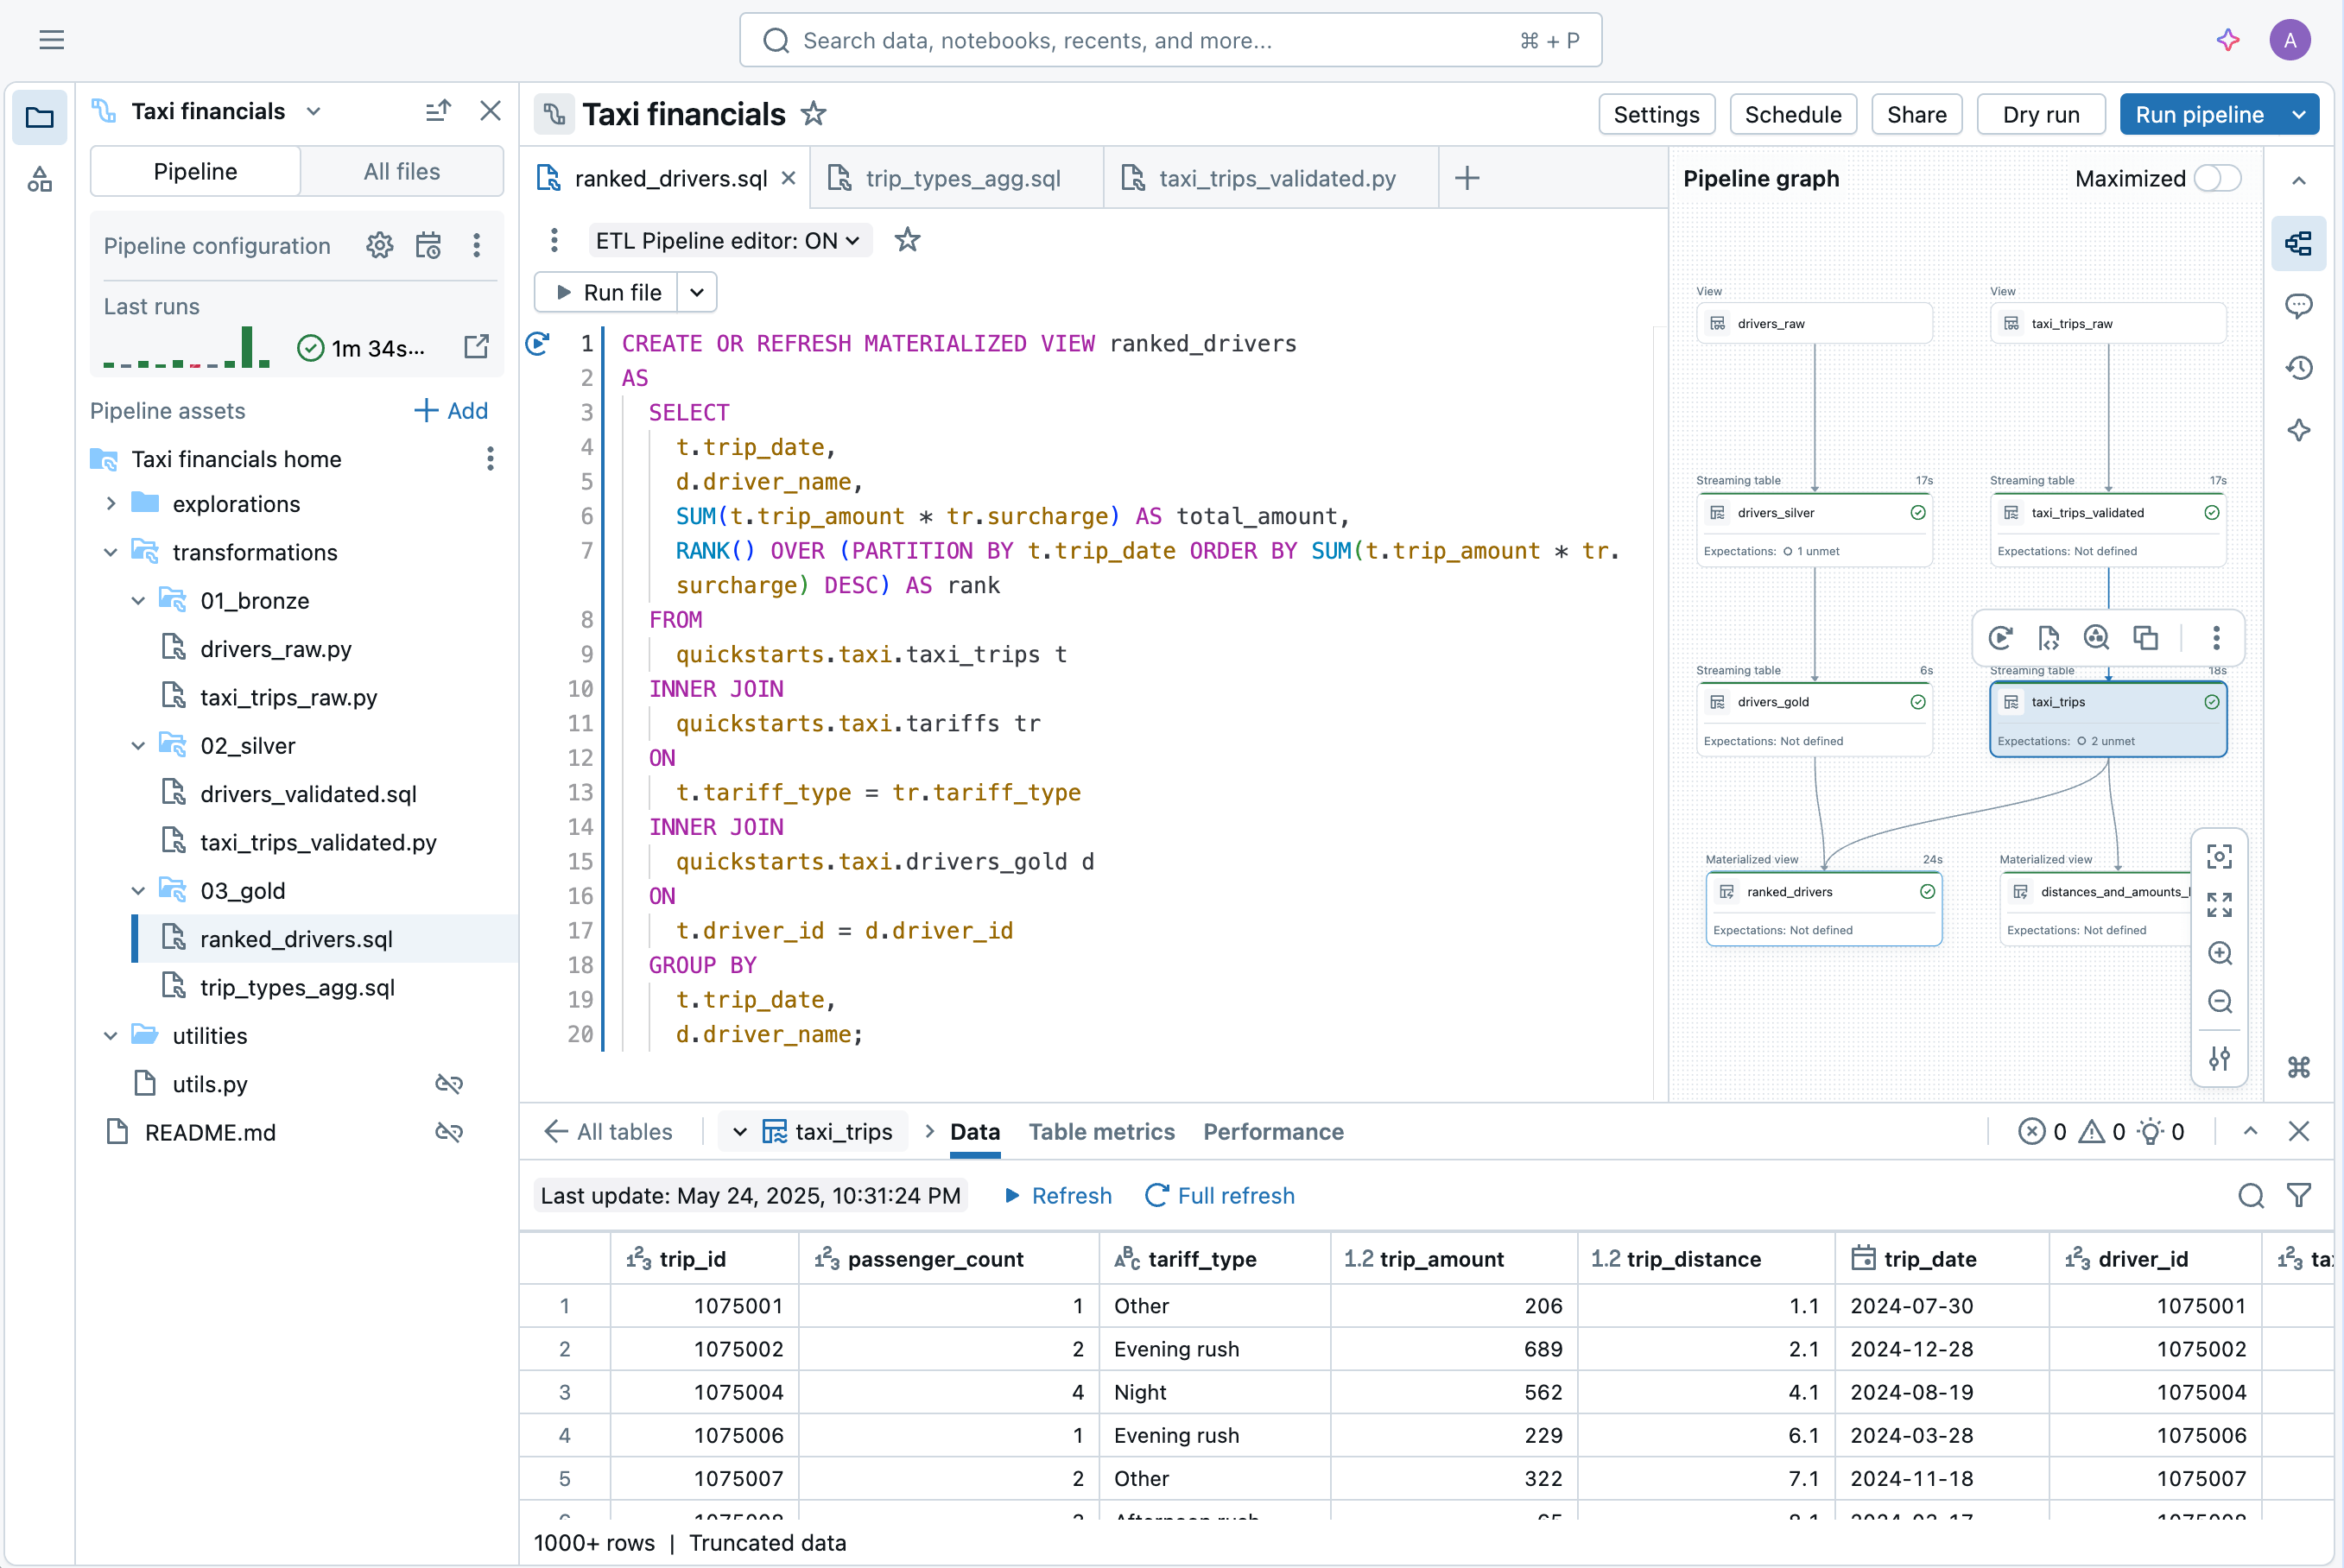
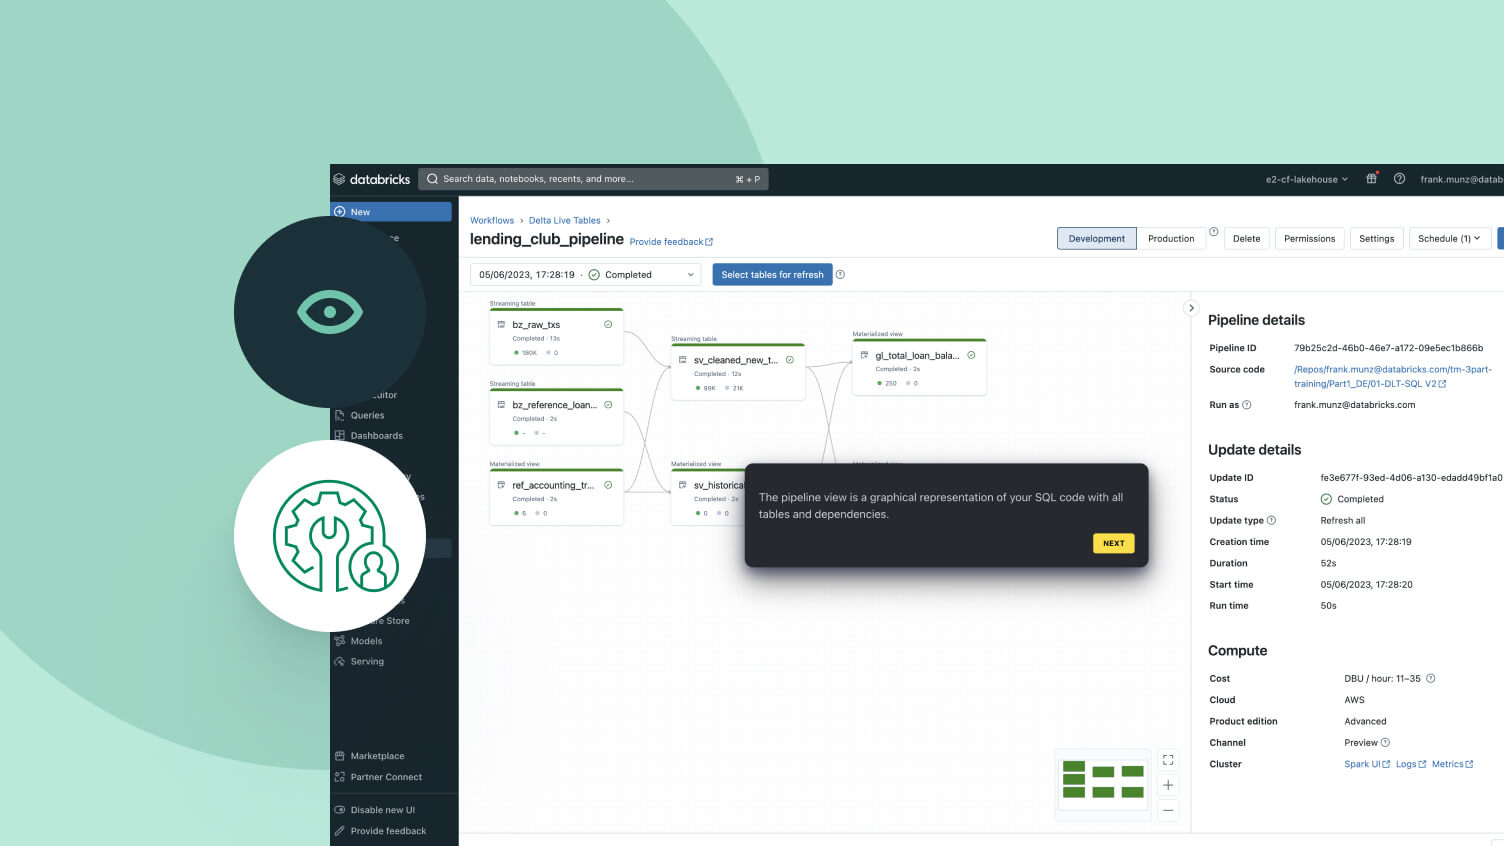
Entwickeln Sie Pipelines im Lakeflow-Pipeline-Editor – einer nativen IDE für Data Engineering – ohne jegliche Kontextwechsel. Sehen Sie den DAG, die Datenvorschau und Ausführungsdetails in einer einzigen Benutzeroberfläche. Entwickeln Sie Code einfach mit Autovervollständigung, Inline-Fehlermeldungen und detaillierten Diagnosen.
Weitere Funktionen
Datenpipelines rationalisieren

Quellen, Transformationen und Ziele vereinfachen
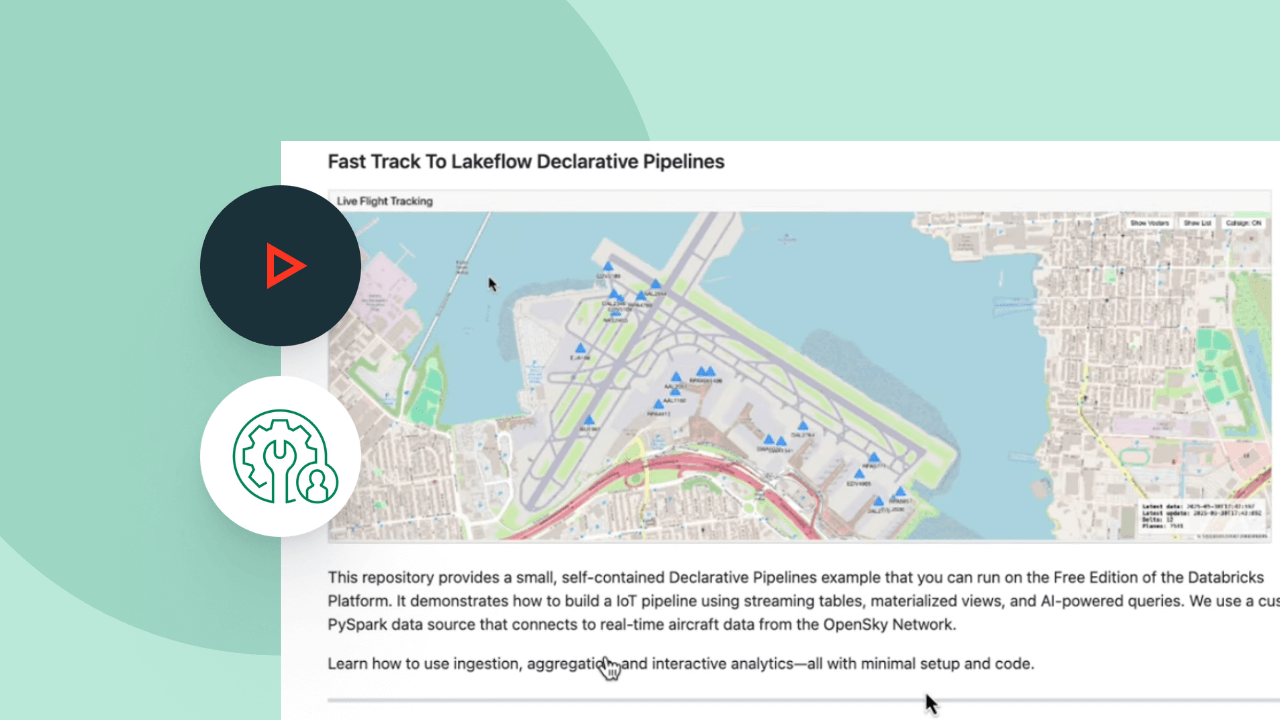
Deklarative Programmierung bedeutet, dass Sie die Leistungsfähigkeit von ETL auf der Databricks-Plattform mit nur wenigen Codezeilen nutzen können.
Vorhersehbare Ausgaben dank nutzungsbasierter Abrechnung
Sie zahlen nur für die Produkte, die Sie tatsächlich nutzen – und das sekundengenau.Mehr entdecken
Entdecken Sie weitere integrierte, intelligente Angebote auf der Databricks Data + AI Platform.
Genie Code
Ihr autonomer KI-Partner für die Datenarbeit

LakeFlow Connect
Effiziente Konnektoren für die Datenaufnahme aus beliebigen Quellen und native Integration mit der Databricks Data + AI Platform eröffnen einen einfachen Zugriff auf Analysen und KI mit einheitlicher Governance.

Lakeflow Jobs
Sie können Workflows mit mehreren Tasks für ETL-, Analytics- und ML-Pipelines unkompliziert definieren, verwalten und überwachen. Mit einer breiten Palette unterstützter Aufgabentypen, umfassenden Beobachtbarkeitsfunktionen und hoher Zuverlässigkeit sind Ihre Datenteams in der Lage, jede Pipeline besser zu automatisieren und zu orchestrieren sowie produktiver zu werden.

Lakehouse-Speicherung
Vereinheitlichen Sie die Daten in Ihrem Lakehouse format- und typenübergreifend für alle Ihre Analytics- und KI-Workloads.

Unity Catalog
Regulieren Sie alle Ihre Datenressourcen nahtlos mit der branchenweit einzigen einheitlichen und offenen Governance-Lösung für Daten und KI, die in die Databricks Data + AI Platform integriert ist.

Document Intelligence
Unternehmensdokumente in großem Maßstab analysieren, extrahieren und klassifizieren mit integrierter Governance für agentische KI.

Die Databricks Data + AI Platform
Erfahren Sie, wie die Databricks Data + AI Platform Ihre Daten- und KI-Workloads unterstützt.
Wagen Sie den nächsten Schritt
Erkunden Sie die Dokumentation zu Spark Declarative Pipelines
Alles, was Sie brauchen, um mit Spark Declarative Pipelines in AWS-, Microsoft Azure- oder Google Cloud Platform-Umgebungen zu beginnen.
Databricks kostenlos testen
Starten Sie eine kostenlose Testversion oder registrieren Sie sich einfach für die Free Edition.
Spark Declarative Pipelines FAQ
Spark Declarative Pipelines (SDP) ist ein offenes Framework, das Batch- und Streaming-Datenengineering in Apache Spark vereinfacht. Indem Datenteams und Coding-Agenten Zieldatenzustände deklarieren können, anstatt prozeduralen Code zu schreiben, löst SDP automatisch Abhängigkeiten auf, setzt Erwartungen an die Datenqualität durch und wickelt die inkrementelle Zustandsverwaltung ab.
Möchten Sie ein Daten- und KI-Unternehmen werden?
Machen Sie die ersten Schritte Ihrer Transformation